
使用指南
FLUX 3 Max 短视频:每个镜头一种模式,通过 API 批量处理
一个由文本生成视频、图片生成视频和关键帧构建的竖屏 9:16 广告活动,作为一次并行批量提交,包含真实输出和已验证的定价。
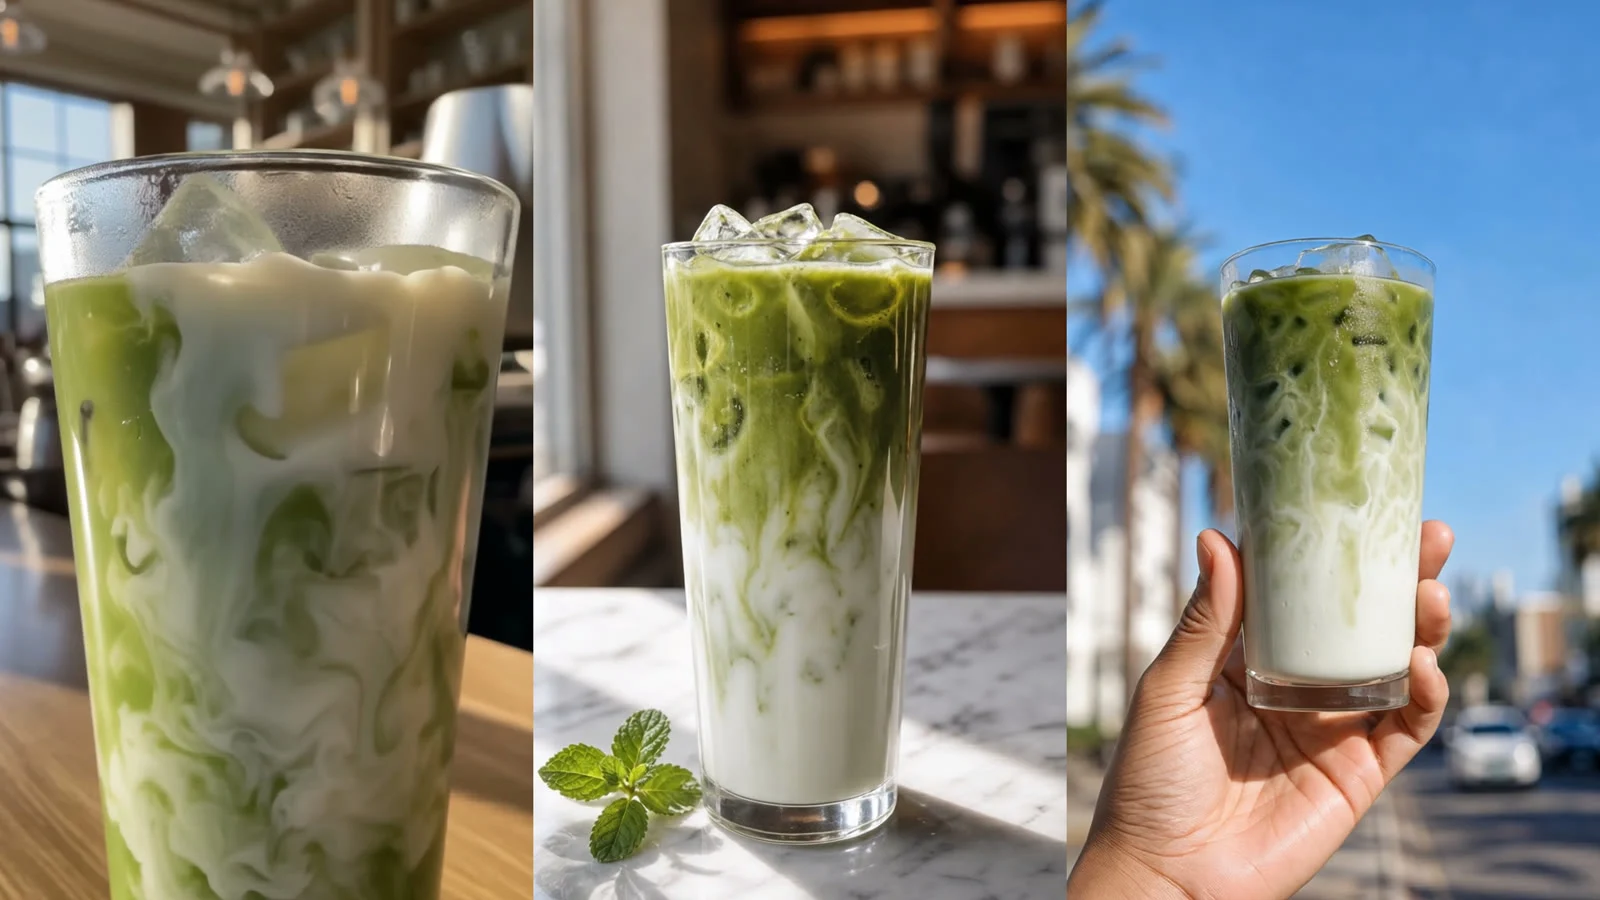
FLUX 3 Max 在 hiapi 上提供三个视频端点,对于短视频工作,有用的问题不是“哪个最好”,而是“哪个适合这个镜头”。本指南走查一个小型竖屏广告活动(为一家冰抹茶咖啡馆的帖子制作三个 9:16 片段),每个镜头使用不同模式,三个都作为一次并行批量提交,下面展示的每个片段都是真实、未经编辑的输出。
如果你需要完整的参数参考和校验错误说明,请先阅读 FLUX 3 Max API 指南。本文假设你已经能提交任务,重点讲短视频工作流。
按镜头选模式,而不是按项目选
短视频剪辑通常由钩子、产品节拍和收尾组成。这些节拍的输入不同,因此对应不同的 FLUX 3 Max id:
| 剪辑中的镜头 | 你手上有什么 | 使用 | 关键输入 |
|---|---|---|---|
| 钩子 / B-roll | 只有一个想法 | flux-3-max/text-to-video |
prompt |
| 产品节拍 | 一张已批准且不能改动的产品照片 | flux-3-max/image-to-video |
image_url(单个字符串),可选 end_image_url |
| 转场 / 收尾 | 两个你想连接起来的场景 | flux-3-max/keyframes-to-video |
keyframes: [{image_url, frame_index}] |
三者共享 duration(5–20 秒)、resolution(720p / 1080p)、aspect_ratio(竖屏设为 9:16)和 generate_audio。因为请求体几乎相同,一个批处理脚本就能发送全部三个。模型页面:文本生成视频、图片生成视频、关键帧生成视频。
镜头 1:钩子,仅用文本
钩子需要第一秒就有运动,且没有特定素材要求,所以文本生成视频是正确选择。
{
  "model": "flux-3-max/text-to-video",
  "input": {
    "prompt": "竖屏手持特写:咖啡师将冷牛奶倒入高透明玻璃杯中的冰抹茶,绿色和白色在慢动作中交织旋转,晨光透过咖啡馆窗户,浅景深,清脆的冰块碰撞声,轻柔的咖啡馆环境音。",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
返回结果:倾倒从第一帧开始,到结尾时漩涡充满玻璃杯,这正是钩子需要的。文本生成视频做不到的是匹配你的场景:我要求咖啡馆,模型选择了木质柜台,而我的产品照片(下一个镜头)用的是大理石。对于钩子来说这是可以接受的。对于必须匹配品牌资产的镜头,请使用某个图片模式。
镜头 2:产品节拍,锚定在静帧上
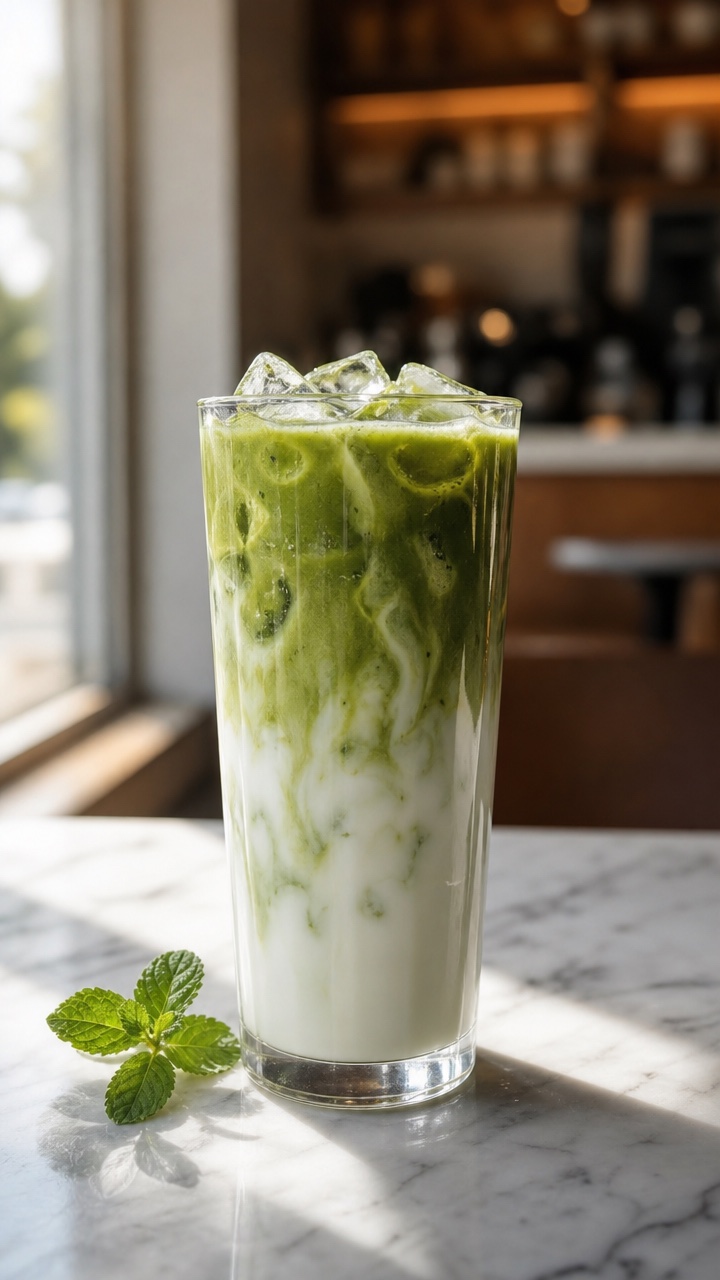
这是已批准的产品照片。它事先生成为 9:16 静帧,并作为第一帧传给模型。
{
  "model": "flux-3-max/image-to-video",
  "input": {
    "prompt": "缓慢推近玻璃杯;牛奶漩涡漂移并沉淀,冰块轻微移动,光线在大理石柜台上轻轻闪烁,薄荷叶保持不动。安静的咖啡馆环境音。",
    "image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-a.jpg",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
构图保持锁定:同样的杯子、同样的薄荷枝、同样的大理石和窗户光线从开始到结束。不过运动比较克制。我要求的推近在 5 秒内几乎看不出来,大部分运动在液体和光线中。对于产品节拍来说这是好结果,因为你希望产品镜头保持真实。如果你想要更强的运镜,给它更多秒数或在提示词中更强调,并在扩大批量前检查结果。
注意字段名:image-to-video 接受单个 image_url 字符串。传入 image_urls 数组(像其他一些 hiapi 视频模型期望的那样)会在提交时被拒绝。
镜头 3:收尾,用两个关键帧
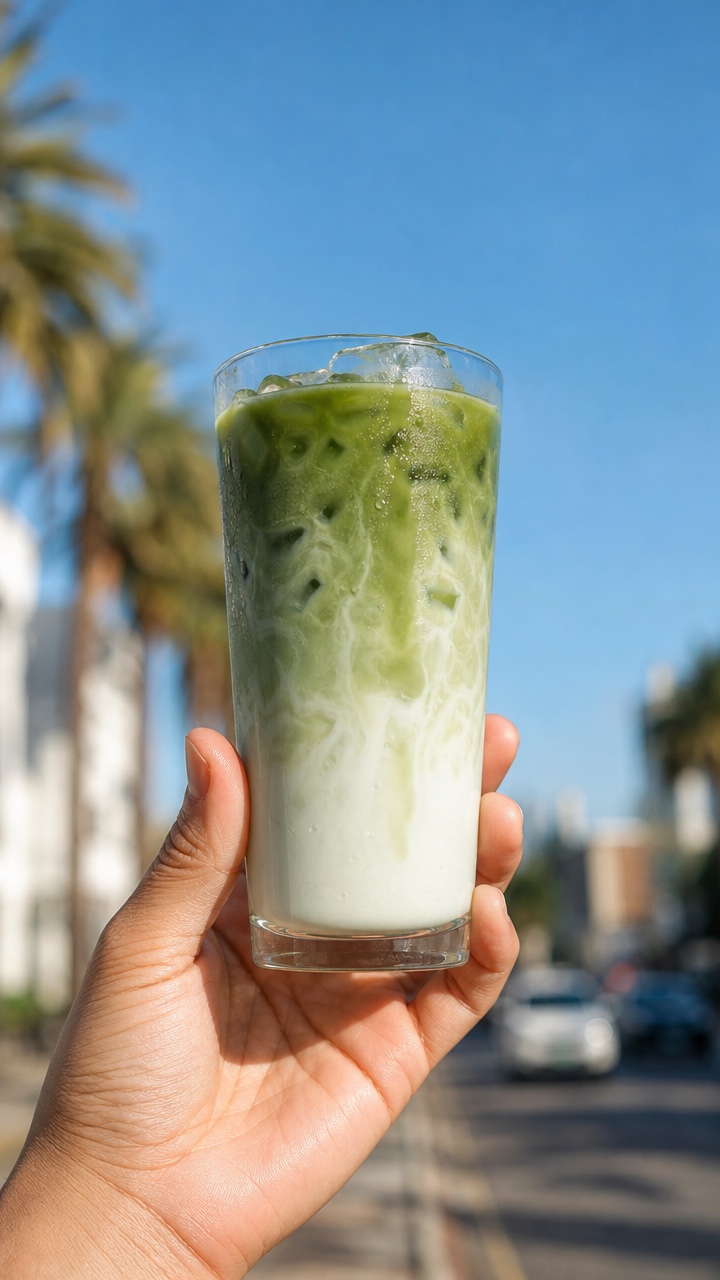
收尾连接咖啡馆和街道。我有同一杯饮料在户外举起的第二张静帧,并把两者都用作关键帧。
{
  "model": "flux-3-max/keyframes-to-video",
  "input": {
    "prompt": "连续镜头:一只手从咖啡馆柜台拿起冰抹茶并带到外面,最后在阳光明媚的街道上举向明亮的蓝天。平滑手持相机,自然光线从温暖的室内过渡到明亮的日光。",
    "keyframes": [
      {"image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-a.jpg", "frame_index": 0},
      {"image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-b.jpg", "frame_index": 120}
    ],
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
frame_index 以 24 fps 计帧,所以 5 秒片段从 0 到 120。把锚点放在 0 和 120,使片段正好从柜台镜头开始,并正好落在街道镜头上。在两者之间,模型自己发明了一个转场:片段中段,手在门口举着杯子,然后街道出现。这就是关键帧的取舍。你控制锚定的时刻,模型填充其余部分。如果中间必须是特定样子,为它添加第三个关键帧(最多允许 10 个)。
批量处理:一个脚本,三种模式,并行
短视频工作意味着大量变体,所以先提交所有内容,之后再轮询。这是我使用的脚本,已精简:
import json, os, time, requests
from concurrent.futures import ThreadPoolExecutor

API = "https://api.hiapi.ai/v1/tasks"
HEAD = {"Authorization": f"Bearer {os.environ['HIAPI_KEY']}"}
BASE = {"duration": 5, "resolution": "720p", "aspect_ratio": "9:16", "generate_audio": True}

jobs = {
    "hook":    ("flux-3-max/text-to-video",      {"prompt": HOOK_PROMPT}),
    "product": ("flux-3-max/image-to-video",     {"prompt": PRODUCT_PROMPT, "image_url": STILL_A}),
    "payoff":  ("flux-3-max/keyframes-to-video", {"prompt": PAYOFF_PROMPT, "keyframes": [
                    {"image_url": STILL_A, "frame_index": 0},
                    {"image_url": STILL_B, "frame_index": 120}]}),
}

def run(name):
    model, extra = jobs[name]
    r = requests.post(API, headers=HEAD, json={"model": model, "input": {**BASE, **extra}}).json()
    task_id = r["data"]["taskId"]          # save this before polling
    deadline = time.time() + 900
    while time.time() < deadline:
        time.sleep(10)
        d = requests.get(f"{API}/{task_id}", headers=HEAD).json()["data"]
        if d["status"] == "success":
            url = d["output"][0]["url"]
            open(f"{name}.mp4", "wb").write(requests.get(url).content)  # download now
            return name, "success"
        if d["status"] == "fail":
            return name, d.get("error")
    return name, f"timeout {task_id}"

with ThreadPoolExecutor(len(jobs)) as pool:
    for result in pool.map(run, jobs):
        print(result)
2026 年 11 月 3 日,我一次性发送全部三个时看到的情况:
- 每个
POST /v1/tasks都在 2 秒内返回taskId。 - 轮询显示每个任务都经历相同序列:
handling,然后archiving,然后success。 - 任务记录显示三个片段从
created到completed均为 20 秒。并行运行它们并不比运行一个更久。 - 每个输出都是 5.04 秒的 H.264 文件,704 × 1280,24 fps,带 AAC 音轨。注意宽度:9:16 的 720p 给出 704 px,不是 720。如果你的编辑器模板要求正好 720 × 1280,导入时请缩放或填充。
- 输出 URL 位于临时域名上,
expireAt为完成后 7 天。请立即下载并自行存储文件。
对于更大的批量(几十个钩子变体),使用任务 API 的 callback 配合 when: "final",这样无需轮询,并记录每个 taskId,以免崩溃丢失已付费的工作。
批量成本
FLUX 3 Max 按输出秒数、按分辨率计费,三种模式费率相同。截至 2026 年 11 月,定价页面列出 720p 为 $0.0608/秒,1080p 为 $0.1036/秒。模型页面说明音频和关键帧数量不影响价格。
| 方案 | 每个片段 | 三片段批量 |
|---|---|---|
| 5 秒,720p(我运行的) | $0.304 | $0.912 |
| 5 秒,1080p | $0.518 | $1.554 |
| 15 秒,1080p | $1.554 | $4.662 |
实用循环:在 5 秒和 720p 下测试提示词,保留胜出者,仅将它们以 1080p 或更长渲染。关于费率详情,请参阅 FLUX 3 Max API 定价。
短视频检查清单
- 先把剪辑写成镜头,然后用上表为每个镜头分配模式。
- 静帧也做成 9:16。图片模式会动画化你给它的帧,所以横向静帧从一开始就是构图问题。
- 在每个请求中显式设置
aspect_ratio: "9:16",而不是依赖auto。 - 保持关键帧图像视觉一致(相同产品、相同光照家族),并在提交前验证
frame_index ≤ duration × 24。错误的时间线会在提交时被接受,片刻后失败。 - 并行提交,轮询或使用回调,并立即下载。
- 草稿阶段保持音频开启。它不额外收费,你可以在剪辑中静音。
关于本次广告活动之外的提示词想法,请参阅 FLUX 3 Max 视频提示词指南。要在另一个模型上使用相同工作流,请比较 Kling 3.0 图片生成视频短视频工作流。
常见问题
FLUX 3 Max 能制作竖屏 9:16 视频吗?
能。三个端点都接受 aspect_ratio: "9:16"。在 720p 下,我得到的输出是 704 × 1280。
产品视频应该使用哪个 FLUX 3 Max 模式? 当产品照片必须完全保持批准时的样子,使用图片生成视频。在我的测试中,杯子、装饰和背景在整个片段中保持不变。当产品需要在两个场景之间移动时,使用关键帧。
生成一个 FLUX 3 Max 片段需要多长时间? 在我的运行中,三个 5 秒 720p 片段一起提交,每个从 created 到 completed 用时 20 秒。更长或 1080p 片段可能需要更久;我没有计时那些。
能在同一个批量中混合文本生成视频、图片生成视频和关键帧吗?
能。它们是同一 /v1/tasks 端点上的独立模型 id,共享相同字段,所以一个脚本可以并排提交它们。
FLUX 3 Max 短视频片段能有多长? 5 到 20 秒之间,以整秒为单位。成本随长度线性增长。
开始构建
选择你最需要的镜头,打开对应的模型页面(文本生成视频、图片生成视频或关键帧生成视频),在批量处理其余剪辑之前先运行一个 5 秒 720p 测试。
相关文章
查看全部文章 →-

使用指南
GPT Image 2.6 是什么?markup 编辑与已知规格
OpenAI API 规范里关于 GPT Image 2.6 的全部信息、新 markup 编辑参数怎么用,以及还没公布的部分。
4 -

使用指南
Vidu Q4 Preview API 多少钱?540p 每秒 $0.0515
两个模式同价,五档分辨率、3–16 秒怎么计费,$10 能跑多少条,以及和站内视频模型的价格对照。
3 -

使用指南
Recraft V4.1 Flash 电商产品图:每张 $0.01 批量目录图
在 recraft-v4.1-flash/text-to-image 上的一次真实并行批量:商品列表图与场景图、实测背景白度、耗时以及批量脚本。