
Guida all'uso
FLUX 3 Max short video: una modalità per ogni inquadratura, elaborazione in batch tramite API
Una campagna verticale 9:16 costruita con text-to-video, image-to-video e keyframe, inviata come un unico batch parallelo, con output reali e prezzi verificati.
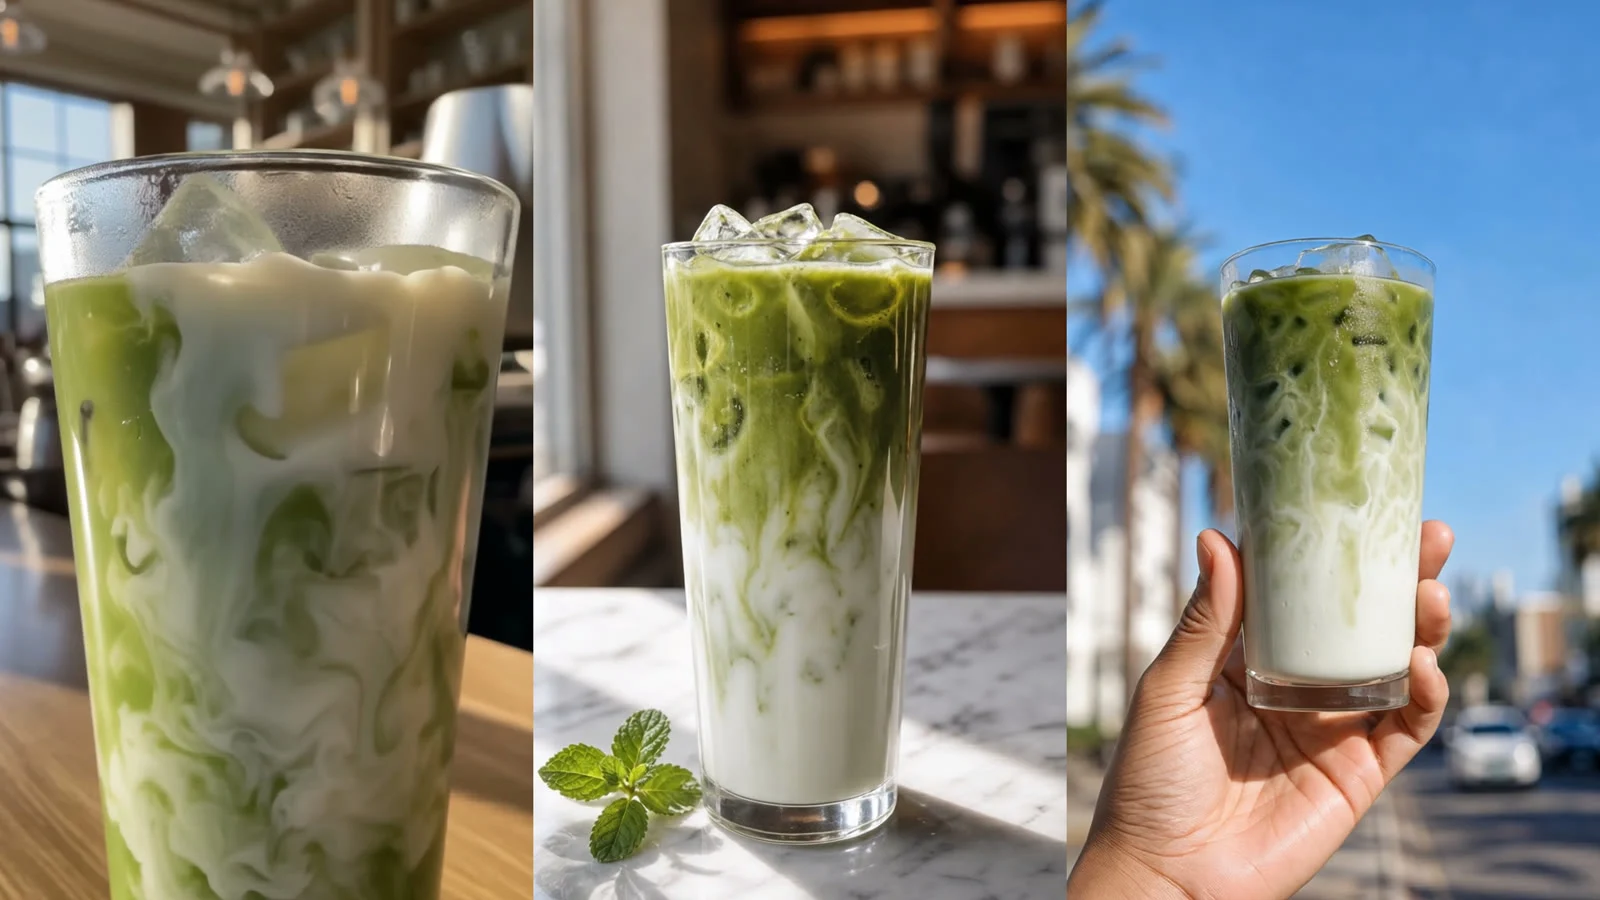
FLUX 3 Max offre tre endpoint video su hiapi, e per il lavoro sui cortometraggi la domanda utile non è "quale sia il migliore", ma "quale si adatta a questa inquadratura". Questa guida esamina una piccola campagna verticale (tre clip 9:16 per un post di un bar di matcha ghiacciato), usando una modalità diversa per ogni inquadratura, con tutte e tre inviate come un unico batch parallelo; ogni clip mostrata di seguito è un output reale e non modificato.
Se ti serve il riferimento completo dei parametri e la spiegazione degli errori di validazione, leggi prima la guida all'API di FLUX 3 Max. Questo articolo presuppone che tu sappia già inviare un task e si concentra sul workflow per i cortometraggi.
Scegli la modalità per inquadratura, non per progetto
Il montaggio di un cortometraggio è di solito composto da un hook, un beat dedicato al prodotto e una chiusura. Questi beat hanno input diversi, quindi corrispondono a diversi id di FLUX 3 Max:
| Inquadratura nel montaggio | Cosa hai in mano | Usa | Input chiave |
|---|---|---|---|
| Hook / B-roll | Solo un'idea | flux-3-max/text-to-video |
prompt |
| Beat del prodotto | Una foto del prodotto approvata e non modificabile | flux-3-max/image-to-video |
image_url (singola stringa), facoltativo end_image_url |
| Transizione / chiusura | Due scene che vuoi collegare | flux-3-max/keyframes-to-video |
keyframes: [{image_url, frame_index}] |
Tutti e tre condividono duration (5–20 secondi), resolution (720p / 1080p), aspect_ratio (imposta 9:16 per il verticale) e generate_audio. Poiché il corpo della richiesta è quasi identico, un unico script batch può inviare tutti e tre. Pagine dei modelli: text-to-video, image-to-video, keyframes-to-video.
Inquadratura 1: l'hook, solo testo
L'hook deve avere movimento fin dal primo secondo e non richiede materiali specifici, quindi text-to-video è la scelta giusta.
{
  "model": "flux-3-max/text-to-video",
  "input": {
    "prompt": "Primo piano verticale a mano: un barista versa latte freddo in un bicchiere alto e trasparente con matcha ghiacciato, il verde e il bianco si intrecciano e ruotano al rallentatore, la luce del mattino filtra dalle finestre del bar, profondità di campo ridotta, il suono cristallino dei cubetti di ghiaccio che si urtano, morbido ambiente sonoro del bar.",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
Risultato: la versata inizia dal primo frame e alla fine il vortice riempie il bicchiere, esattamente ciò che serve all'hook. Ciò che text-to-video non sa fare è adattarsi alla tua scena: ho chiesto un bar e il modello ha scelto un bancone in legno, mentre la mia foto del prodotto (l'inquadratura successiva) usa il marmo. Per un hook è accettabile. Per un'inquadratura che deve corrispondere agli asset del brand, usa una delle modalità con immagini.
Inquadratura 2: il beat del prodotto, ancorato a un fermo immagine
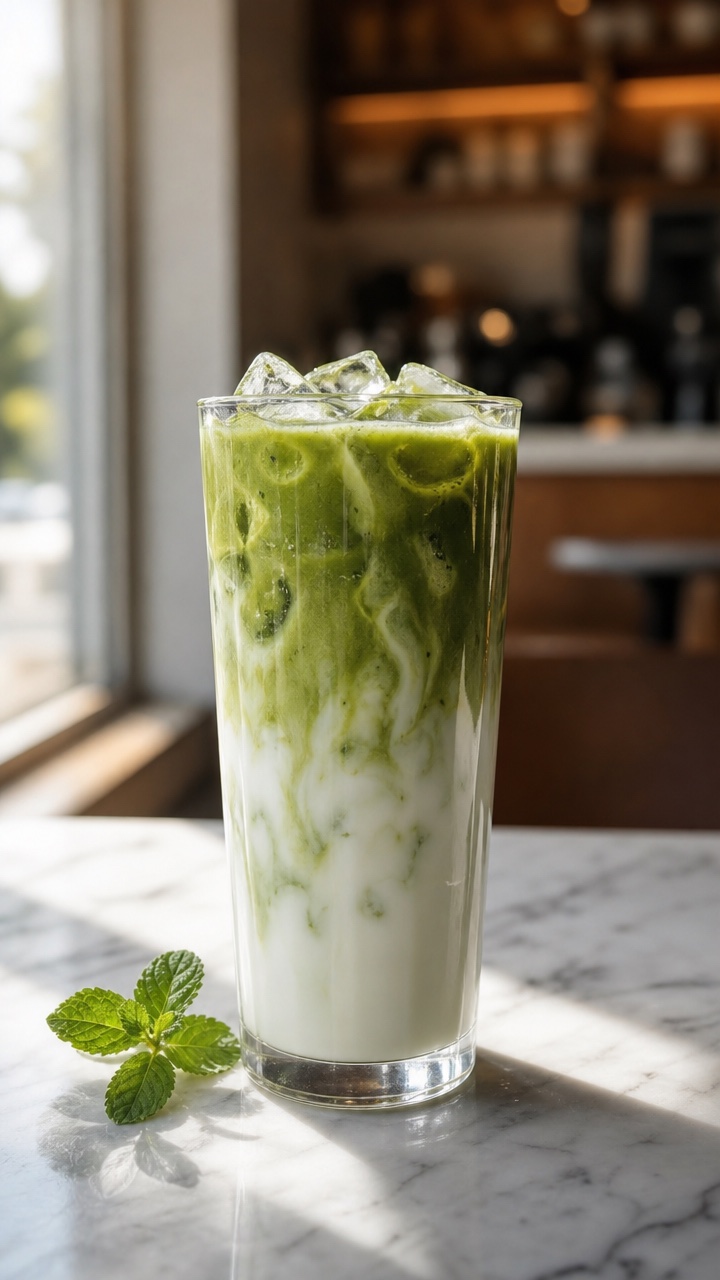
Questa è la foto del prodotto approvata. È stata generata in anticipo come fermo immagine 9:16 e passata al modello come primo frame.
{
  "model": "flux-3-max/image-to-video",
  "input": {
    "prompt": "Lento avvicinamento al bicchiere; il vortice di latte si sposta e si deposita, i cubetti di ghiaccio si muovono leggermente, la luce tremola dolcemente sul bancone di marmo, la foglia di menta resta immobile. Ambiente sonoro tranquillo del bar.",
    "image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-a.jpg",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
L'inquadratura resta bloccata: lo stesso bicchiere, lo stesso rametto di menta, lo stesso marmo e la stessa luce della finestra dall'inizio alla fine. Il movimento però è contenuto. L'avvicinamento che ho chiesto è quasi impercettibile in 5 secondi, la maggior parte del movimento è nel liquido e nella luce. Per un beat del prodotto è un buon risultato, perché vuoi che l'inquadratura del prodotto resti fedele. Se desideri un movimento di camera più forte, concedigli più secondi o sottolinealo maggiormente nel prompt, e controlla il risultato prima di ampliare il batch.
Attenzione al nome del campo: image-to-video accetta una singola stringa image_url. Passare un array image_urls (come si aspetterebbero altri modelli video di hiapi) viene rifiutato all'invio.
Inquadratura 3: la chiusura, con due keyframe
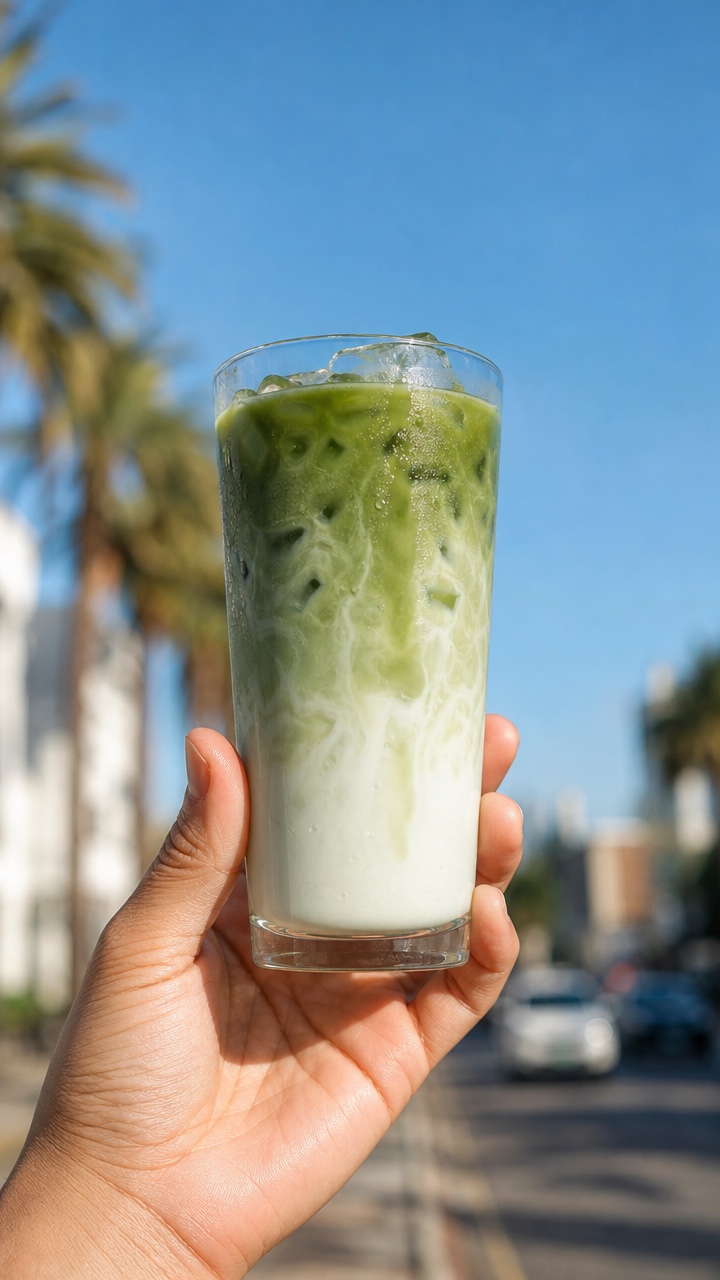
La chiusura collega il bar alla strada. Ho un secondo fermo immagine della stessa bevanda sollevata all'aperto e uso entrambi come keyframe.
{
  "model": "flux-3-max/keyframes-to-video",
  "input": {
    "prompt": "Piano sequenza: una mano prende il matcha ghiacciato dal bancone del bar e lo porta fuori, per poi sollevarlo verso il cielo azzurro luminoso in una strada soleggiata. Camera a mano fluida, luce naturale che passa dall'interno caldo alla luminosa luce diurna.",
    "keyframes": [
      {"image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-a.jpg", "frame_index": 0},
      {"image_url": "https://static.hiapi.ai/blog/flux-3-max-short-form-video/still-b.jpg", "frame_index": 120}
    ],
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "generate_audio": true
  }
}
frame_index conta i frame a 24 fps, quindi una clip di 5 secondi va da 0 a 120. Mettendo le ancore a 0 e 120, la clip inizia esattamente sull'inquadratura del bancone e termina esattamente su quella della strada. Tra le due, il modello inventa da solo una transizione: a metà clip, la mano solleva il bicchiere sulla soglia, poi appare la strada. È questo il compromesso dei keyframe. Tu controlli i momenti ancorati, il modello riempie il resto. Se il centro deve essere in un modo specifico, aggiungi un terzo keyframe (ne sono consentiti fino a 10).
Elaborazione batch: uno script, tre modalità, in parallelo
Il lavoro sui cortometraggi significa molte varianti, quindi invia tutto prima e interroga dopo. Questo è lo script che ho usato, ridotto all'essenziale:
import json, os, time, requests
from concurrent.futures import ThreadPoolExecutor

API = "https://api.hiapi.ai/v1/tasks"
HEAD = {"Authorization": f"Bearer {os.environ['HIAPI_KEY']}"}
BASE = {"duration": 5, "resolution": "720p", "aspect_ratio": "9:16", "generate_audio": True}

jobs = {
    "hook":    ("flux-3-max/text-to-video",      {"prompt": HOOK_PROMPT}),
    "product": ("flux-3-max/image-to-video",     {"prompt": PRODUCT_PROMPT, "image_url": STILL_A}),
    "payoff":  ("flux-3-max/keyframes-to-video", {"prompt": PAYOFF_PROMPT, "keyframes": [
                    {"image_url": STILL_A, "frame_index": 0},
                    {"image_url": STILL_B, "frame_index": 120}]}),
}

def run(name):
    model, extra = jobs[name]
    r = requests.post(API, headers=HEAD, json={"model": model, "input": {**BASE, **extra}}).json()
    task_id = r["data"]["taskId"]          # save this before polling
    deadline = time.time() + 900
    while time.time() < deadline:
        time.sleep(10)
        d = requests.get(f"{API}/{task_id}", headers=HEAD).json()["data"]
        if d["status"] == "success":
            url = d["output"][0]["url"]
            open(f"{name}.mp4", "wb").write(requests.get(url).content)  # download now
            return name, "success"
        if d["status"] == "fail":
            return name, d.get("error")
    return name, f"timeout {task_id}"

with ThreadPoolExecutor(len(jobs)) as pool:
    for result in pool.map(run, jobs):
        print(result)
Ecco cosa ho visto il 3 novembre 2026 inviando tutti e tre in una volta:
- Ogni
POST /v1/tasksha restituito untaskIdentro 2 secondi. - Il polling ha mostrato che ogni task attraversa la stessa sequenza:
handling, poiarchiving, poisuccess. - I record dei task indicano che tutte e tre le clip sono passate da
createdacompletedin 20 secondi. Eseguirle in parallelo non ha richiesto più tempo di una sola. - Ogni output è un file H.264 di 5,04 secondi, 704 × 1280, 24 fps, con traccia audio AAC. Nota la larghezza: il 720p in 9:16 dà 704 px, non 720. Se il tuo template dell'editor richiede esattamente 720 × 1280, ridimensiona o riempi all'importazione.
- Gli URL di output si trovano su un dominio temporaneo, con
expireAta 7 giorni dal completamento. Scarica subito i file e archiviali per conto tuo.
Per batch più grandi (decine di varianti di hook), usa callback dell'API task con when: "final", così non serve il polling, e registra ogni taskId per non perdere lavoro già pagato in caso di crash.
Costo del batch
FLUX 3 Max viene fatturato per secondi di output, per risoluzione, con la stessa tariffa per le tre modalità. Al novembre 2026, la pagina dei prezzi indica $0.0608/secondo per il 720p e $0.1036/secondo per il 1080p. La pagina del modello specifica che l'audio e il numero di keyframe non influiscono sul prezzo.
| Scenario | Per clip | Batch di tre clip |
|---|---|---|
| 5 secondi, 720p (quello che ho eseguito) | $0.304 | $0.912 |
| 5 secondi, 1080p | $0.518 | $1.554 |
| 15 secondi, 1080p | $1.554 | $4.662 |
Ciclo pratico: testa i prompt a 5 secondi e 720p, conserva i vincitori e renderizza solo quelli a 1080p o più lunghi. Per i dettagli sulle tariffe, consulta la pagina dei prezzi dell'API di FLUX 3 Max.
Checklist per i cortometraggi
- Scrivi prima il montaggio come elenco di inquadrature, poi assegna a ciascuna una modalità usando la tabella sopra.
- Crea anche i fermi immagine in 9:16. Le modalità con immagini animano il frame che gli dai, quindi un fermo immagine orizzontale è un problema di composizione fin dall'inizio.
- Imposta esplicitamente
aspect_ratio: "9:16"in ogni richiesta, invece di affidarti aauto. - Mantieni coerenti visivamente le immagini dei keyframe (stesso prodotto, stessa famiglia di illuminazione) e verifica
frame_index ≤ duration × 24prima dell'invio. Una timeline errata viene accettata all'invio e fallisce poco dopo. - Invia in parallelo, interroga o usa i callback, e scarica subito.
- Nella fase di bozza tieni l'audio attivo. Non costa extra e puoi silenziarlo nel montaggio.
Per idee di prompt oltre questa campagna, consulta la guida ai prompt video di FLUX 3 Max. Per usare lo stesso workflow su un altro modello, confronta il workflow per cortometraggi image-to-video di Kling 3.0.
Domande frequenti
FLUX 3 Max può creare video verticali 9:16?
Sì. Tutti e tre gli endpoint accettano aspect_ratio: "9:16". A 720p, l'output che ho ottenuto è 704 × 1280.
Quale modalità di FLUX 3 Max dovrei usare per un video di prodotto? Usa image-to-video quando la foto del prodotto deve restare esattamente come approvata. Nei miei test, il bicchiere, la decorazione e lo sfondo sono rimasti invariati per tutta la clip. Usa i keyframe quando il prodotto deve spostarsi tra due scene.
Quanto tempo serve per generare una clip con FLUX 3 Max? Nelle mie esecuzioni, tre clip da 5 secondi a 720p inviate insieme sono passate ciascuna da created a completed in 20 secondi. Clip più lunghe o a 1080p potrebbero richiedere più tempo; non le ho cronometrate.
Si possono combinare text-to-video, image-to-video e keyframes nello stesso batch?
Sì. Sono id di modello distinti sullo stesso endpoint /v1/tasks, condividono gli stessi campi, quindi un unico script può inviarli fianco a fianco.
Quanto può durare una clip breve di FLUX 3 Max? Tra 5 e 20 secondi, in secondi interi. Il costo cresce linearmente con la durata.
Inizia a costruire
Scegli l'inquadratura che ti serve di più, apri la pagina del modello corrispondente (text-to-video, image-to-video o keyframes-to-video) ed esegui un test da 5 secondi a 720p prima di elaborare in batch il resto del montaggio.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Cos'è GPT Image 2.6? Modifica markup e specifiche note
Tutte le informazioni su GPT Image 2.6 nella specifica dell'API OpenAI, come usare il nuovo parametro di modifica markup, e cosa non è ancora stato annunciato.
-

Guida all'uso
Quanto costa l'API di Vidu Q4 Preview? $0,0515 al secondo a 540p
Stesso prezzo per le due modalità, come viene fatturato con cinque livelli di risoluzione e durata da 3 a 16 secondi, quanti video si possono fare con $10 e il confronto prezzi con gli altri modelli video della piattaforma.
-

Guida all'uso
Immagini prodotto e-commerce con Recraft V4.1 Flash: immagini catalogo in batch a $0,01 ciascuna
Un vero batch parallelo su recraft-v4.1-flash/text-to-image: immagini di listino e di scena, bianco dello sfondo misurato, tempi e script batch.