
使用指南
Ideogram v4.5 提示词配方:可直接复制粘贴的排版提示词与真实输出
大多数图像模型能画出漂亮的海报,却把标题拼写错误。Ideogram 的整份声誉恰恰相反:它能把字母写对。ideogram-v4.5/text-to-image 是 hiapi 上最新的 Ideogram 文生图模型,并且与其他所有模型一样运行在统一的 task API 上。本页是一个你可以直接拿来用的提示词库——六个配方,涵盖 logo、海报、横幅和包装,每个都附上我实际发送的提示词和它实际返回的图片。下文每一张输出都是用 hiapi 上的 ideogram-v4.5/text-to-image 生成的;没有一张是库存素材,也没有一张经过修图。
它还回答了这些配方反复引出的一个问题:quality 档位。v4.5 按三个档位计费——low、medium、high——价格差异很大,所以我把同一个提示词和同一个种子分别跑过三档,并对比了实际的文字渲染效果。结果和你猜的不一样,详见下文的质量档位部分。
范围:这里是基础的文生图端点。v4.5 还有一个独立的图生图/编辑路由(
ideogram-v4.5/image-to-image),支持蒙版和参考图——那是另一套 schema,另写一篇文章。
v4.5 实际接受的 schema(比你想象的少)
在看配方之前,先说输入契约——因为 v4.5 的接口面与 ideogram-v4 的并不相同。我对着线上 API 逐字段探测过。全部所需就这五个:
| 字段 | 类型 | 说明 |
|---|---|---|
prompt |
string,必填 | 把要渲染的文字放进双引号里(见下一节)。 |
quality |
low / medium / high |
价格档位。默认行为等同于 medium。 |
num_images |
整数 1–8 | 一个任务可以返回一整组图。 |
seed |
整数 | 固定它以便公平比较两个提示词(或两个档位)。 |
image_size |
枚举 | 取值之一:square_hd、square、portrait_4_3、portrait_16_9、landscape_4_3、landscape_16_9。 |
让我意外的是:没有 aspect_ratio,也没有 resolution 字段。 v4 接受 aspect_ratio 字符串和 rendering_speed;v4.5 把两者都去掉了。你只能从六个 image_size 预设中选一个形状,这就是唯一的尺寸控制——API 会直接以 additional properties not allowed 拒绝 aspect_ratio、resolution、rendering_speed、magic_prompt、style_type 和 negative_prompt。所以如果你要从 v4 请求迁移,请删掉这些字段,否则每次调用都会 400。
价格来自 hiapi 线上定价页,按图计费,随档位变化:
quality |
每张图片价格 |
|---|---|
low |
$0.043 |
medium |
$0.086 |
high |
$0.3145 |
下面是最小请求——创建任务,然后轮询直到完成:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ideogram-v4.5/text-to-image",
    "input": {
      "prompt": "A clean wordmark logo, the text \"NORTHWIND ROASTERS\" in an elegant high-contrast serif, cream background, centered",
      "quality": "medium",
      "image_size": "square",
      "num_images": 1
    }
  }'
# -> {"data":{"taskId":"tk-..."}}
import os, time, requests

BASE = "https://api.hiapi.ai/v1/tasks"
H = {"Authorization": f"Bearer {os.environ['HIAPI_KEY']}"}

task = requests.post(BASE, headers=H, json={
    "model": "ideogram-v4.5/text-to-image",
    "input": {
        "prompt": 'A clean wordmark logo, the text "NORTHWIND ROASTERS" '
                  'in an elegant high-contrast serif, cream background, centered',
        "quality": "medium",
        "image_size": "square",
        "num_images": 1,
    },
}).json()
tid = task["data"]["taskId"]

while True:                                   # poll to a terminal state
    d = requests.get(f"{BASE}/{tid}", headers=H).json()["data"]
    if d["status"] in ("success", "fail"):
        break
    time.sleep(5)

print(d["output"][0]["url"])                  # temp URL — download it right away
output[0].url 是一个大约一周后过期的临时链接,所以要立刻下载字节——不要把它热链到生产环境。
决定每个配方成败的唯一规则
下文所有内容都建立在一个习惯上:把你要渲染的确切文字放进双引号里,不要让你在意的文案交给模型去编。
Ideogram 会扩展你的提示词。要一张音乐节海报,它会乐于加上你从未写过的演出阵容、日期和票价——做真实效果图时很好,但如果这些细节必须正确就有风险。在测试中,我引用的每一个短字符串都拼写完美;模型自己编出来的文字才是错别字出现的地方。所以:给品牌名、标题、按钮文字、日期加引号。只有在你不介意模型说什么时,才把装饰性填充交给它。
掌握了这条规则,下面是配方。
配方 1——文字标识 logo
A clean minimalist wordmark logo for a specialty coffee brand, the text "NORTHWIND ROASTERS" set in an elegant high-contrast serif, a small compass-rose icon integrated above the letter N, warm cream background, centered, flat vector-style design, generous negative space
image_size: square · quality: medium
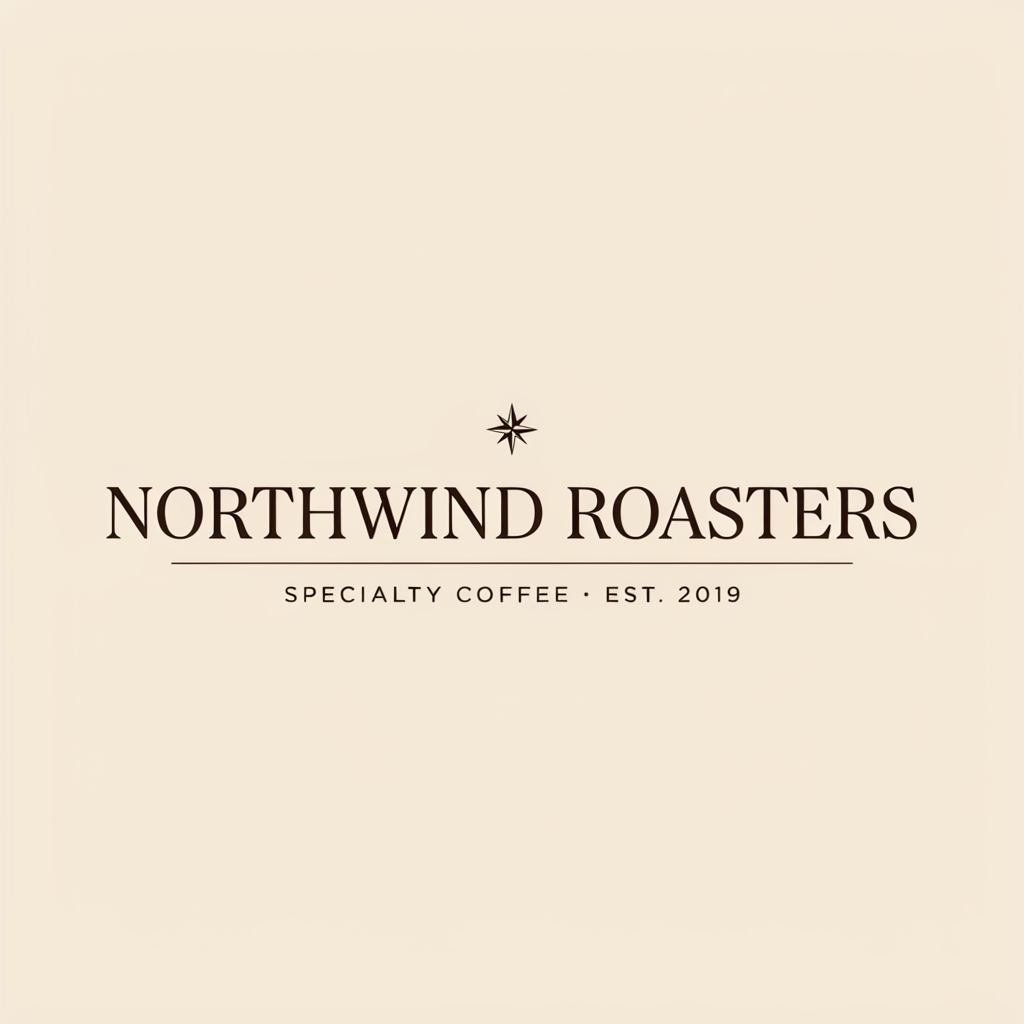
“NORTHWIND ROASTERS” 完全正确,衬线字体确实优雅,负空间看起来像真实的品牌标志。两点诚实的说明:模型把罗盘玫瑰放在了整个文字标识的上方居中处,而不是“字母 N 上方”——v4.5 把空间指令当作建议,而不是坐标——而且它自作主张加了一句我从未要求的标语“SPECIALTY COFFEE · EST. 2019”。这种扩展就是上面那条规则所说的行为:这里很方便,但如果你真实的标语不同,请明确用引号写出来,而不是让模型去猜。
配方 2——活动海报
A vertical concert poster for an indie music festival, large headline text "ECHO VALLEY FEST" across the top, below it two lines reading "AUGUST 14-16" and "RIVERSIDE PARK", retro 1970s psychedelic palette of orange, magenta and teal, layered sunburst background, bold condensed type, high detail
image_size: portrait_4_3 · quality: medium
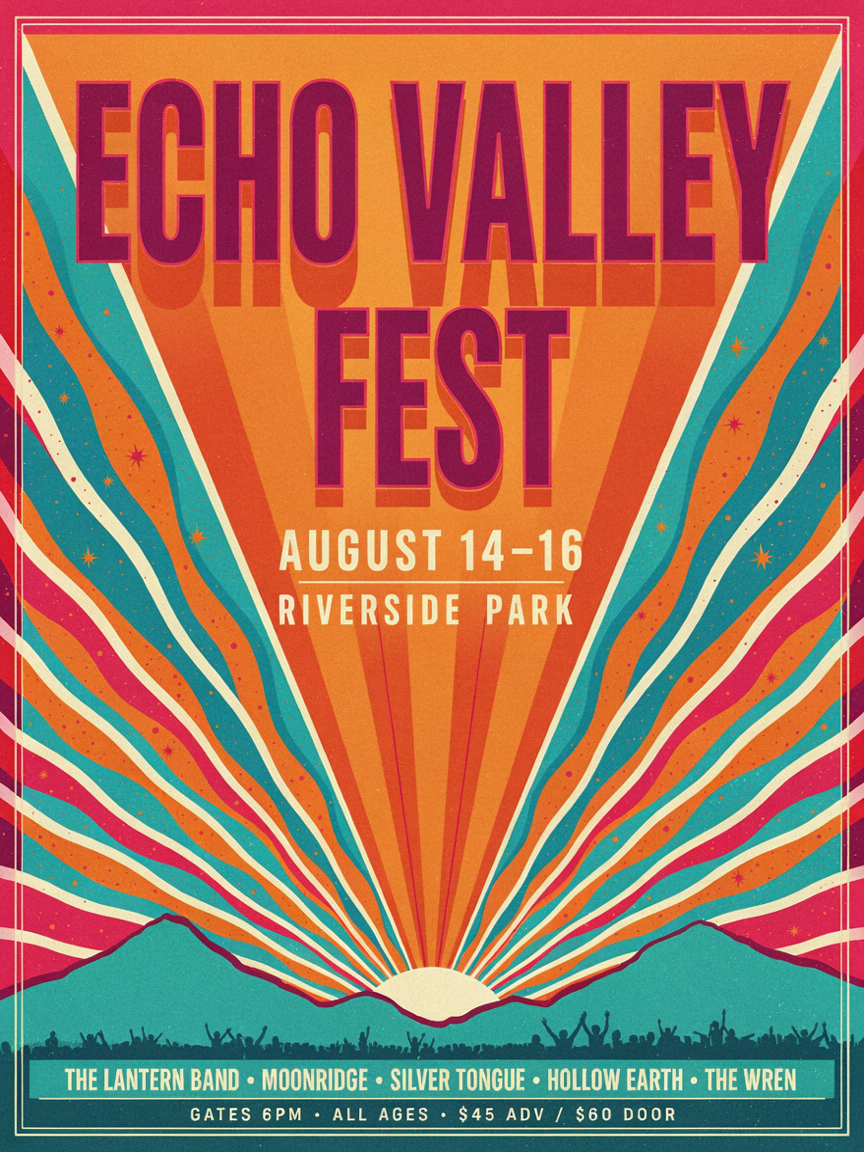
所有三个带引号的字符串——“ECHO VALLEY FEST”、“AUGUST 14-16”、“RIVERSIDE PARK”——都渲染得很干净,portrait_4_3 形状让标题有呼吸空间。模型还自行填入了可信的乐队阵容,以及“GATES 6PM · ALL AGES · $45 ADV / $60 DOOR”的页脚。对于提案效果图来说这是礼物;对于实际海报,请把这些编造的行重新打回提示词,这样你就能控制它们。
配方 3——社交广告横幅
A horizontal social media ad banner for a fitness app, left-aligned headline text "MOVE MORE." in heavy bold uppercase, a smaller line reading "Start your 7-day free trial", and a rounded call-to-action button with the text "GET THE APP", energetic gradient from lime green to deep blue, clean modern UI style
image_size: landscape_16_9 · quality: medium
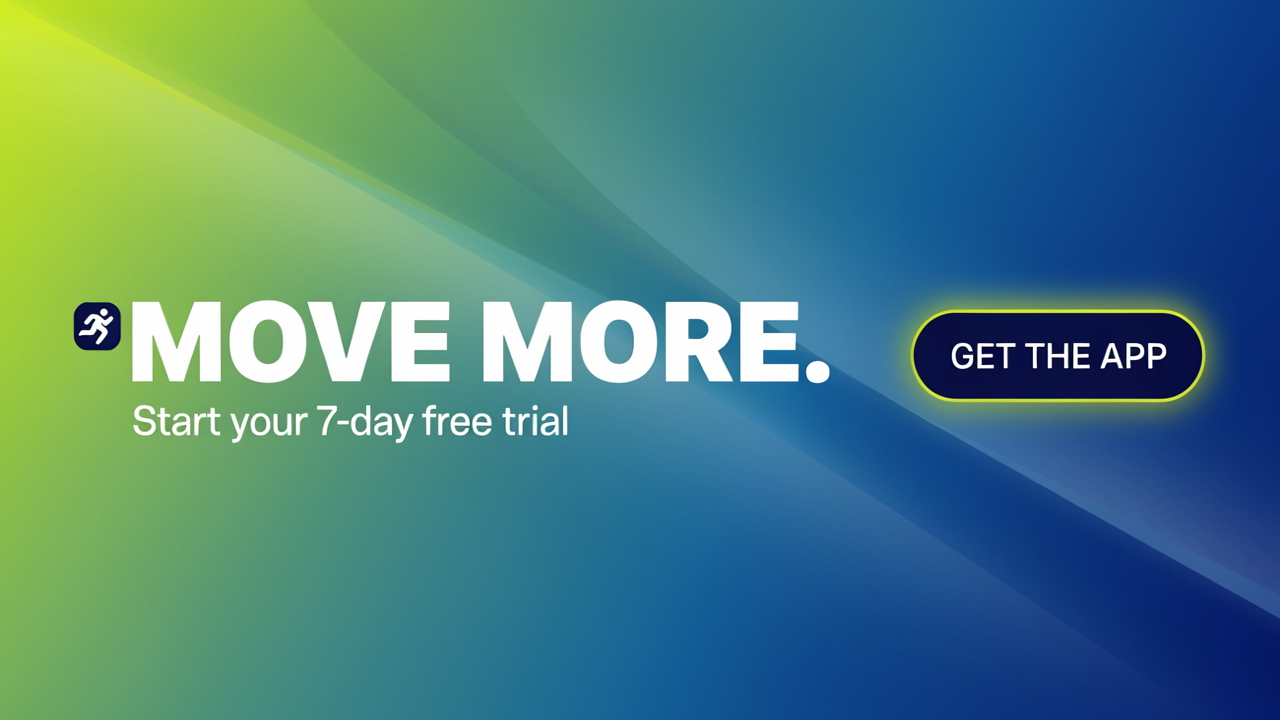
这是 v4.5 的最佳表现:三个独立的短字符串——标题、副标题和按钮文字——都放在不同的 UI 角色中,而且全部拼写正确,包括“MOVE MORE.”里的句号。landscape_16_9 预设是你在需要宽横幅或缩略图时该用的。简短、明确、带引号的文案正是这个模型所擅长的。
配方 4——产品包装标签
A product label for a bottle of artisanal hot sauce, brand name "EMBER & ASH" in a vintage woodcut serif, product line "SMOKED HABANERO" below it, a small badge reading "SMALL BATCH - 150ML", kraft-paper texture background with charcoal and ember-orange ink, symmetrical layout
image_size: square_hd · quality: medium
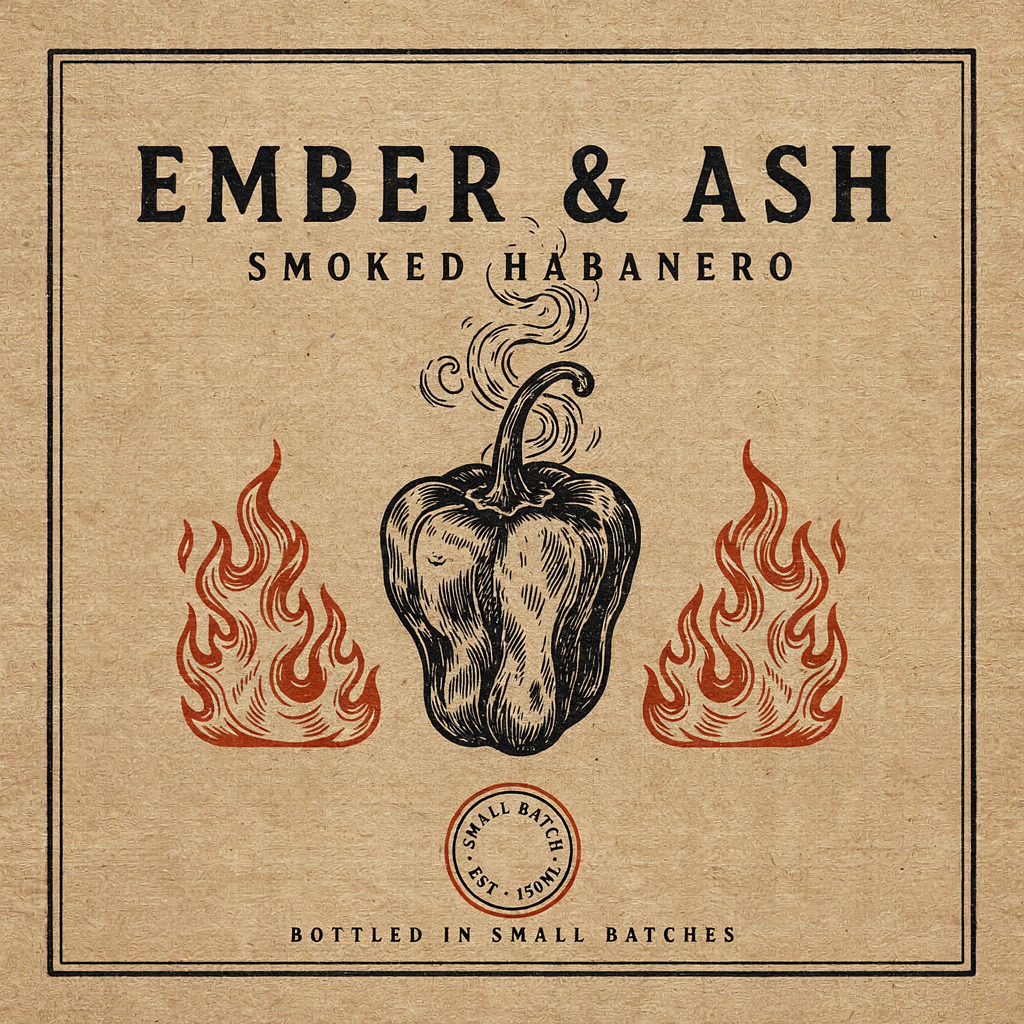
包装是最难的文字测试——小字号、特殊字符、徽章——而 v4.5 通过了关键部分。“EMBER & ASH” 正确渲染了 & 符号(一个经典失败点),“SMOKED HABANERO” 很干净,木刻风格哈瓦那辣椒是未经提示的妙笔。小徽章跑偏了:我要的是“SMALL BATCH - 150ML”,得到的却是“SMALL BATCH · EST · 150ML”外加一行“BOTTLED IN SMALL BATCHES”。手册的教训依然成立——字号越小,模型越会即兴发挥,所以对于要付印的标签,请保持微型文案简短,并逐次核对每一版渲染。
质量档位实测:low vs medium vs high
这些配方都在 medium 下运行。但 v4.5 对 low / medium / high 分别收费 $0.043 / $0.086 / $0.3145——上下相差 7 倍——所以值得了解钱买到了什么。我用一个刻意文字密集的提示词(一张密集的信息图海报)在三个档位下运行,使用同一个种子,这样只有 quality 发生变化:
A dense informational poster titled "CITY TRANSIT GUIDE" with three labeled columns headed "BUS", "METRO" and "TRAM", a short line of body text under each heading, clean Swiss grid layout, red and black ink on off-white paper, flat vector infographic style
low — $0.043
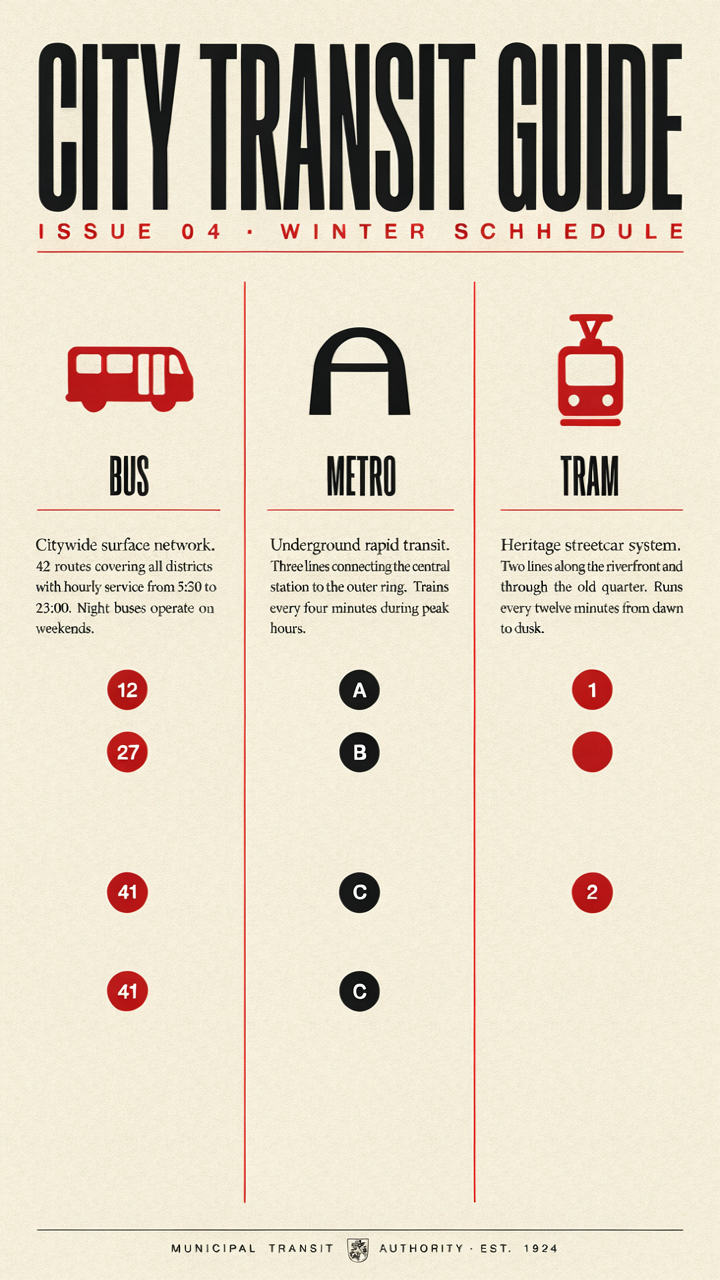
布局和“CITY TRANSIT GUIDE”大标题很清晰。但模型编造了一个副标题并拼错了——“WINTER SCHHEDULE”多了一个 H——还重复了一个线路徽章(“41”出现两次)。带引号的标题(BUS/METRO/TRAM)没问题;它添加的未加引号的文案才是出错的地方。
medium — $0.086
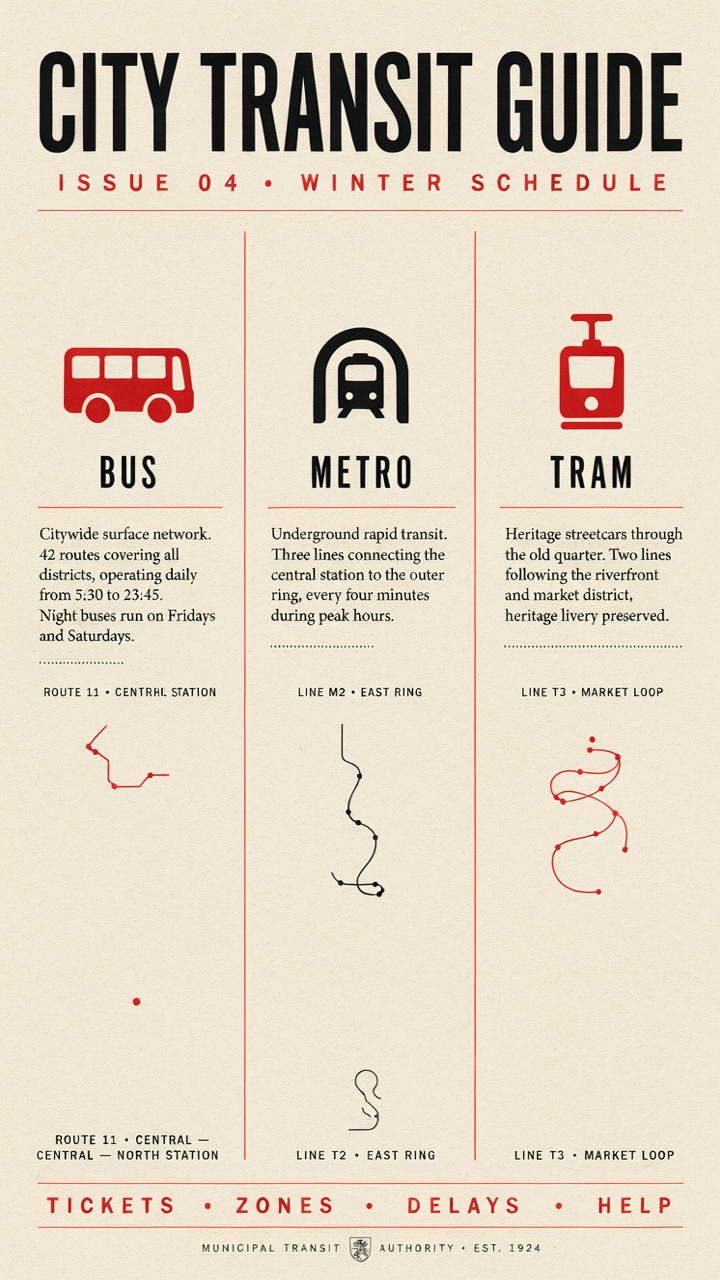
同样的种子,升一档,副标题自行修正为“WINTER SCHEDULE。”三段正文清晰可读,页脚导航(“TICKETS · ZONES · DELAYS · HELP”)很干净。还有一个小说明文字故障(“CENTRHL”而非“CENTRAL”),但对于如此文字密集的布局,这显然是三者中最干净的。
high — $0.3145
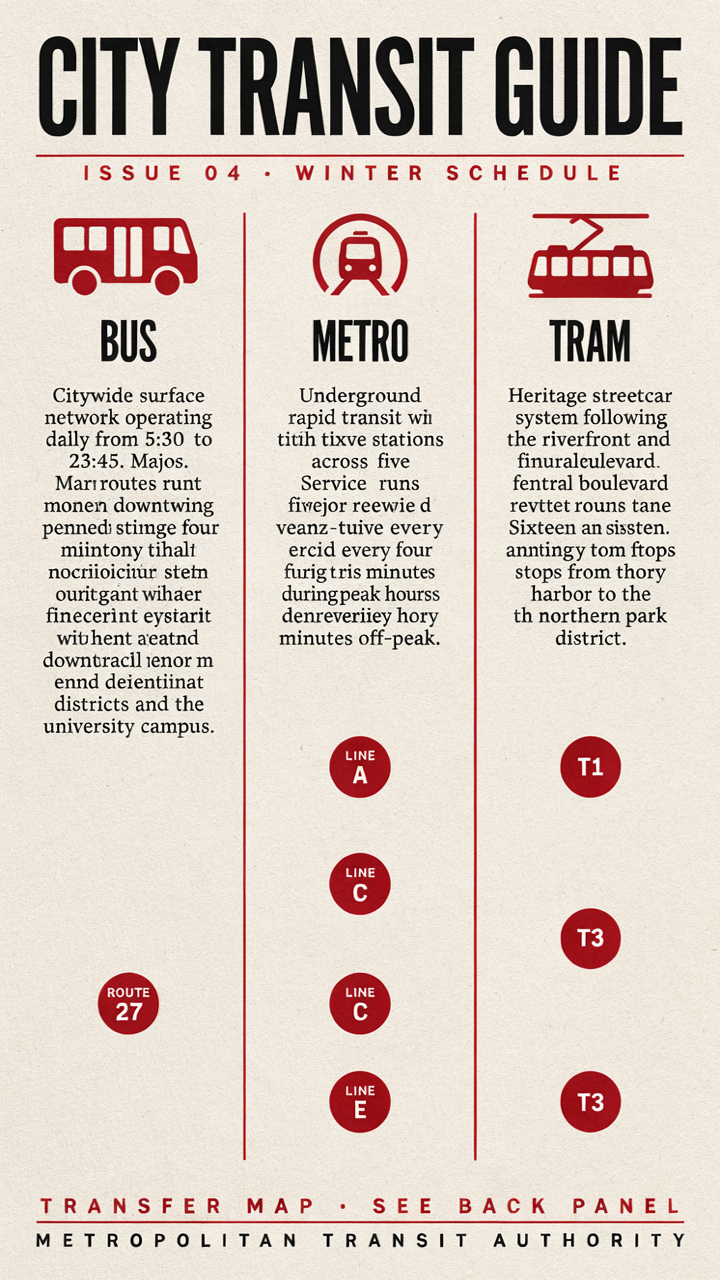
这是反直觉的部分。high 渲染的展示字体——大标题、BUS/METRO/TRAM 标签——是三档中最锐利的。但密集的正文段落坍缩成自信的乱码(“Mari routes runt monen downtwing...”、“tith tixve stations across five...”)。在价格是 medium 的 3.6 倍时,它在这个布局上产生的正文更差,而不是更好。
结论是实用的,而不是贬低模型:quality 档位提高的是 v4.5 渲染它选定字体的精细程度,但它不会让模型更擅长编造你没写过的长段文案——在 high 下,它只是编得更精细,也更错误。所以:
- 把
medium作为默认。 对于任何有真实文字的东西,它都是最佳平衡点,而且它修正了low引入的错别字。 - 保留
high给主要是大型、指定字体的作品——logo、单行标题海报——它的额外锐度在那里值得,而且没有段落供它产生幻觉。 low适合粗略草稿和缩略图,个别错字不重要。- 无论哪个档位,永远不要依赖模型来拼写长正文。 给必须正确的文字加引号;其余当作占位符。
FAQ
我能设置 1080×1920 或精确像素尺寸吗? 不能。v4.5 t2i 只接受六个 image_size 预设——square_hd、square、portrait_4_3、portrait_16_9、landscape_4_3、landscape_16_9。没有宽度/高度或 aspect_ratio 字段。选择最接近的预设,如果需要精确比例就裁剪。
这与 ideogram-v4 有何不同? 输入契约不同。v4 使用 aspect_ratio 加上 rendering_speed(turbo/balanced/quality);v4.5 用 image_size 预设和 quality 价格档位取代了两者。如果你需要 v4 的请求形状,ideogram-v4 操作指南有覆盖,而如果你还在选择排版模型,ideogram-v4 vs Nano Banana 2 会有帮助。
它能编辑现有图片吗? 在这个端点上不能。文生图是 ideogram-v4.5/text-to-image;编辑(提示词编辑、蒙版、参考图)是单独的 ideogram-v4.5/image-to-image 路由。
文字总是正确的吗? 短的、带引号的字符串——品牌名、标题、按钮文字——在本文每个配方中都可靠。模型自行编造的长文案则不然;每次渲染都要校对,尤其是小徽章和说明文字。
如何快速生成变体? 在单个任务中将 num_images 设为最多 8 以一次返回一组,或固定 seed 并改一个词,在同等条件下比较提示词。
自己运行这些
上面的每个提示词都可以直接复制粘贴——把带引号的字符串换成你自己的品牌、标题或日期然后发送。从 ideogram-v4.5/text-to-image 模型页获取实时 schema,打开定价页选择你的 quality 档位,如果这是你第一次调用 task API,快速开始会带你获取密钥并轮询第一个任务。给你的文字加引号,默认用 medium,每次渲染在上线前都要校对。


