
教程
在 hiapi 上用 Nano-Banana 保持角色一致性:一套可用于分镜和电商的工作流
角色圣经(character bible)技术让同一张脸、同一套服装和同一种气质在截然不同的场景中保持稳定——通过 hiapi 的异步 /v1/tasks 端点在 Nano-Banana 上端到端演示,当前预估预算为 $0.41。
摘要
如果你曾经尝试生成一个反复出现的角色——分镜吉祥物、品牌代言人、电商试穿模特——你早已知道失败模式:每次渲染都是“一个差不多看起来一样的人”,而一旦把两帧并排放,差异就刺眼地暴露出来。hiapi 上的 Nano-Banana 系列正是为这个问题而调优的。本文就是我实际使用的工作流:
- hiapi 上的三个 Nano-Banana 模型,全都带有角色一致性标签:
nano-banana(固定 $0.05)、nano-banana-2(1K / 2K / 4K 分别为 $0.036 / $0.057 / $0.086),以及nano-banana-pro(1K 和 2K 为 $0.057,4K 为 $0.10)。这三个都是POST /v1/tasks背后的异步任务。 - 技巧是角色圣经,而不是参考图。一段密集、可重复、确定性的描述字符串,作为前缀拼接到每个逐场景提示词上。不用图生图,不用微调,不用 LoRA。它能经受模型升级,并且极易在源码控制中做版本管理。
- 本文两个演示,都通过 hiapi 实时渲染:一个四图分镜序列,同一个角色(“Mira”)出现在截然不同的光线和地点中;以及一个三图电商序列,同一个模特(“Aria”)完成一次换装。
- 全部七张 Nano-Banana 渲染成本为 $0.35。为并排比较质量额外渲染一张 Pro 档的 Mira 为 $0.057。本文总预估预算:$0.41。
“角色一致性”在实践中到底意味着什么
一致性不是单一属性——它是一小簇属性的集合,这些属性必须在多次渲染中同时成立,结果才会让人觉得是同一个人:
- 面部几何。眼距、鼻长、下颌宽度、脸颊体积。
- 皮肤和头发标记。色调、雀斑或美人痣、发色和发质。
- 服装与配饰。那件特定的夹克、那顶特定的毛线帽、那条特定的工具腰带。
- 气质。姿态和表情库——这个角色展现自己的方式。
当提示词足够密集时,hiapi 上的 Nano-Banana 模型能很好地处理第 1、2、3 点。第 4 点则要靠你——作者——在角色圣经中写入姿态和表情线索,而不仅仅是外貌。
hiapi 上的三个 Nano-Banana 模型
摘自撰写时实时的 /api/pricing 目录:
| 模型 | 分辨率档位 | 价格(美元/张) | 选择理由 |
|---|---|---|---|
nano-banana |
仅宽高比,无分辨率参数 | 固定 $0.05 | 快速迭代。用来起草角色的模型。 |
nano-banana-2 |
1K / 2K / 4K | $0.036 / $0.057 / $0.086 | 4K 输出,小字渲染能力强得多。在当前政策下 2K 档比 1K 更贵。 |
nano-banana-pro |
1K / 2K / 4K | $0.057 / $0.057 / $0.10 | 细节更锐利、微观特征更深,在剧烈场景变化中身份保持最顽强。 |
三者都接受 input.prompt 加 input.aspect_ratio。Pro 和 -2 变体还额外接受 input.resolution(1K / 2K / 4K 之一)。固定价格的 nano-banana 会以 400 拒绝 resolution 字段——只有当你选择了分档模型时才设置它。
我的经验法则:
- 在
nano-banana-2的 1K 档迭代圣经——$0.036 现在是三者中最便宜的。 - 在
nano-banana-2的 1K 或 2K 档渲染生产批次。2K 时价格为 $0.057,与 Pro 相同,所以如果你反正需要 2K,Pro 值得一试。 - 主视觉镜头——最终登上首页、媒体资料包、印刷版 lookbook 的那一帧——用
nano-banana-pro。
角色圣经技术
角色圣经是一段密集的段落,你把它作为前缀拼接到该角色的每个提示词上。它需要足够具体,让模型无处游移,但又不能过于规定性,以至于你没有场景发挥空间。
这是我为本文分镜角色写下的确切圣经:
MIRA = (
    "Mira, a 28-year-old field engineer of mixed Filipina–Polish "
    "heritage, warm olive skin, narrow oval face, dark almond eyes "
    "with light crow's-feet, thick straight black eyebrows, a small "
    "mole on the right cheek, shoulder-length wavy black hair tied "
    "loosely behind, rust-orange beanie with a small embroidered "
    "antenna patch, dust-faded denim jacket over a graphite grey "
    "t-shirt, dark cargo trousers, scuffed brown leather work boots, "
    "a battered yellow toolbelt, friendly determined expression. "
    "Cinematic photography, 35mm lens look, natural film grain, "
    "neutral colour grade."
)
这段圣经有六个刻意的设计:
- 给她起名。“Mira”给模型一个稳定的句柄。即使名字不出现在图像中,提示词里有名字似乎也能锚定身份。
- 混血背景明确,且两半都点名。“一个女人”或“亚洲人”是模糊的。“菲律宾–波兰”迫使模型落到一个具体的面部融合上。
- 眼睛、眉毛、头发、皮肤都单独描述。不要依赖“漂亮”或“自然”。把几何写清楚。
- 一个独特的面部标记。右脸颊上的痣。即使它偶尔移动,有这个标记也能把模型推入特定的身份空间。
- 服装是点名而非松散描述的。“带小刺绣天线补丁的锈橙色毛线帽”可重复。“帽子”不行。
- 末尾一个摄影风格印章。“Cinematic photography, 35mm lens look, natural film grain, neutral colour grade.”这能让原本截然不同的场景之间的光线语言保持一致。
那么逐场景提示词就只是:圣经 + 分隔符 + 一段简短场景段落。我用 " | Scene: " 作为分隔符。它在日志中读起来清晰,模型会把后半部分当作新请求。
调用 hiapi 异步任务端点
hiapi 上所有图像模型都走相同的异步模式:POST /v1/tasks 创建,GET /v1/tasks/{taskId} 轮询,成功后读取 data.output[0].url 获取渲染图像。输出 URL 是短时效的(带有 expireAt),所以请立即把字节下载到你的存储。
import os, json, subprocess, time

API = "https://api.hiapi.ai/v1/tasks"
TOKEN = os.environ["HIAPI_TOKEN"]


def submit(model: str, prompt: str, aspect_ratio: str,
           resolution: str | None = None) -> str:
    payload = {
        "model": model,
        "input": {"prompt": prompt, "aspect_ratio": aspect_ratio},
    }
    # Only nano-banana-pro and nano-banana-2 accept `resolution`.
    # The flat-priced nano-banana returns 400 on the extra field.
    if resolution and model in ("nano-banana-pro", "nano-banana-2"):
        payload["input"]["resolution"] = resolution

    r = subprocess.run(
        ["curl", "-s", "-X", "POST", API,
         "-H", f"Authorization: Bearer {TOKEN}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, timeout=70,
    )
    data = json.loads(r.stdout)
    return data["data"]["taskId"]


def wait(task_id: str, timeout_s: int = 600) -> str:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        r = subprocess.run(
            ["curl", "-s", f"{API}/{task_id}",
             "-H", f"Authorization: Bearer {TOKEN}"],
            capture_output=True, text=True, timeout=40,
        )
        task = json.loads(r.stdout)["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]
        if task["status"] == "fail":
            raise RuntimeError(task["error"])
        time.sleep(6)
    raise RuntimeError(f"timeout: {task_id}")


def render(model, scene, ratio, bible, resolution=None):
    prompt = f"{bible} | Scene: {scene}"
    return wait(submit(model, prompt, ratio, resolution))
对于 Nano-Banana 来说,6 秒的轮询间隔是合适的默认值——在状态良好的一天,单张图像大约 10–60 秒落地。轮询更紧只会浪费往返。
演示 A —— 一个四镜头分镜,同一角色
分镜的全部意义在于:故事是面板之间变化的东西——主角是常量。我将生成一张角色设定表和两张场景镜头,全部使用完全相同的 Mira 圣经。
步骤 1 —— 可视化圣经
在把圣经提交到仓库之前,先用它渲染一张角色设定表。这是找出圣经是否足够锚定的最便宜方式。
sheet = render(
    "nano-banana", aspect_ratio="3:2", bible=MIRA, scene=(
        "a character model sheet on a clean white studio background, "
        "three views of Mira side by side — three-quarter view facing "
        "left, full profile facing right, three-quarter back view — "
        "same outfit, same hairstyle, same toolbelt, even neutral "
        "studio lighting, no shadows, no text labels."
    ),
)
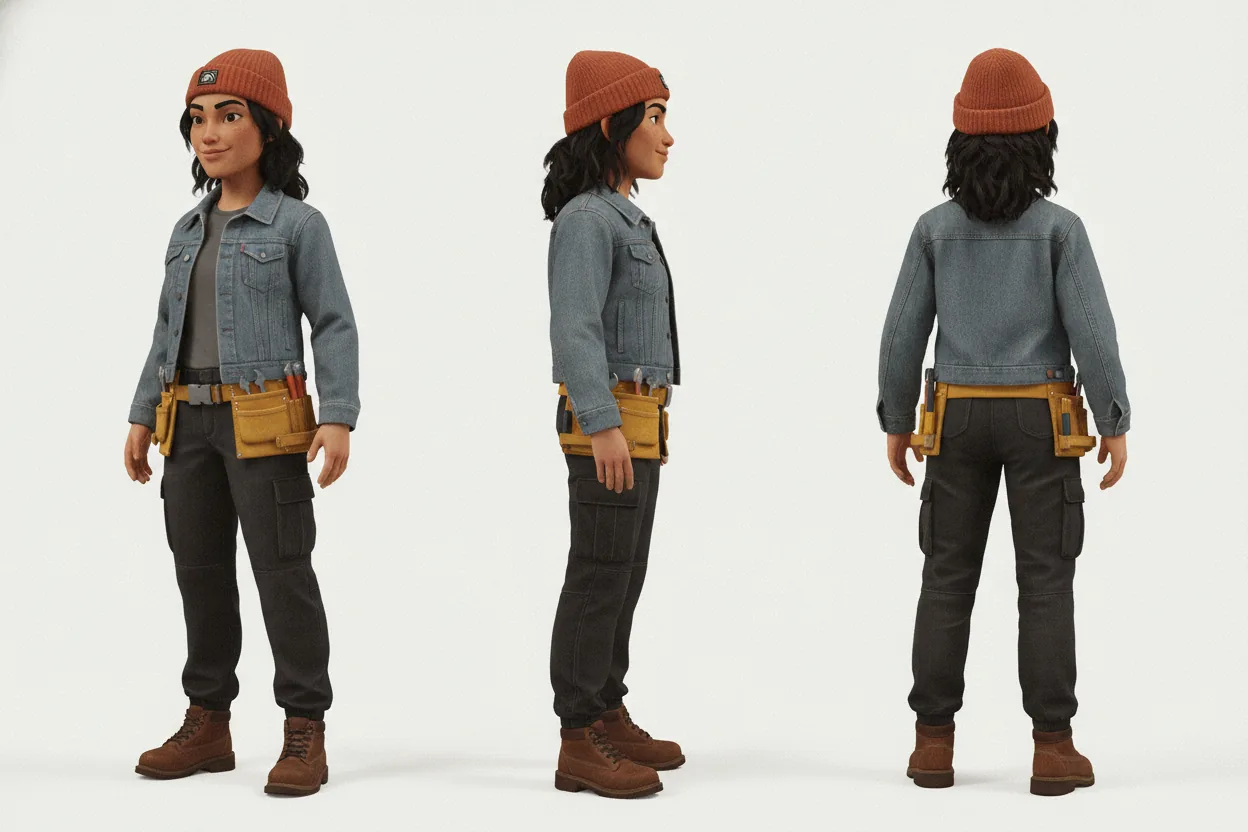
这里发生了一件值得注意的事:尽管圣经明确写了“Cinematic photography, 35mm lens look”,模型却产出了一张 3D 卡通设定表。这是要求“model sheet”或“character sheet”时最常见的失败模式——这些 token 会把美学拖向训练集中的动画行业参考。有两种处理方式:
- 接受它。设定表是圣经的参考文档,不是发布交付物的一部分。服装、配饰和大致比例可见,这正是你实际需要的。
- 在场景片段中用
"shot on Kodak Portra 400, full-frame DSLR, no illustration, no toon, no 3D render"推回去——通常足以把它拉回照片写实。
我这里选择了方案 1,因为接下来的两张场景镜头才是生产帧。
步骤 2 —— 把同一个 Mira 放进两个完全不同的环境
workshop = render("nano-banana", "3:2", MIRA, scene=(
    "Mira in a cluttered repair workshop, leaning over a wooden "
    "workbench under a single warm hanging bulb, reading a circuit "
    "schematic on tablet, soldering iron beside her, walls lined "
    "with scavenged parts, late evening, focused expression."
))

rooftop = render("nano-banana", "3:2", MIRA, scene=(
    "Mira on a city rooftop in cold overcast morning light, kneeling "
    "to bolt a small antenna mast to a ledge, wind moving her hair, "
    "distant grey buildings, breath barely visible, concentrated "
    "working expression."
))
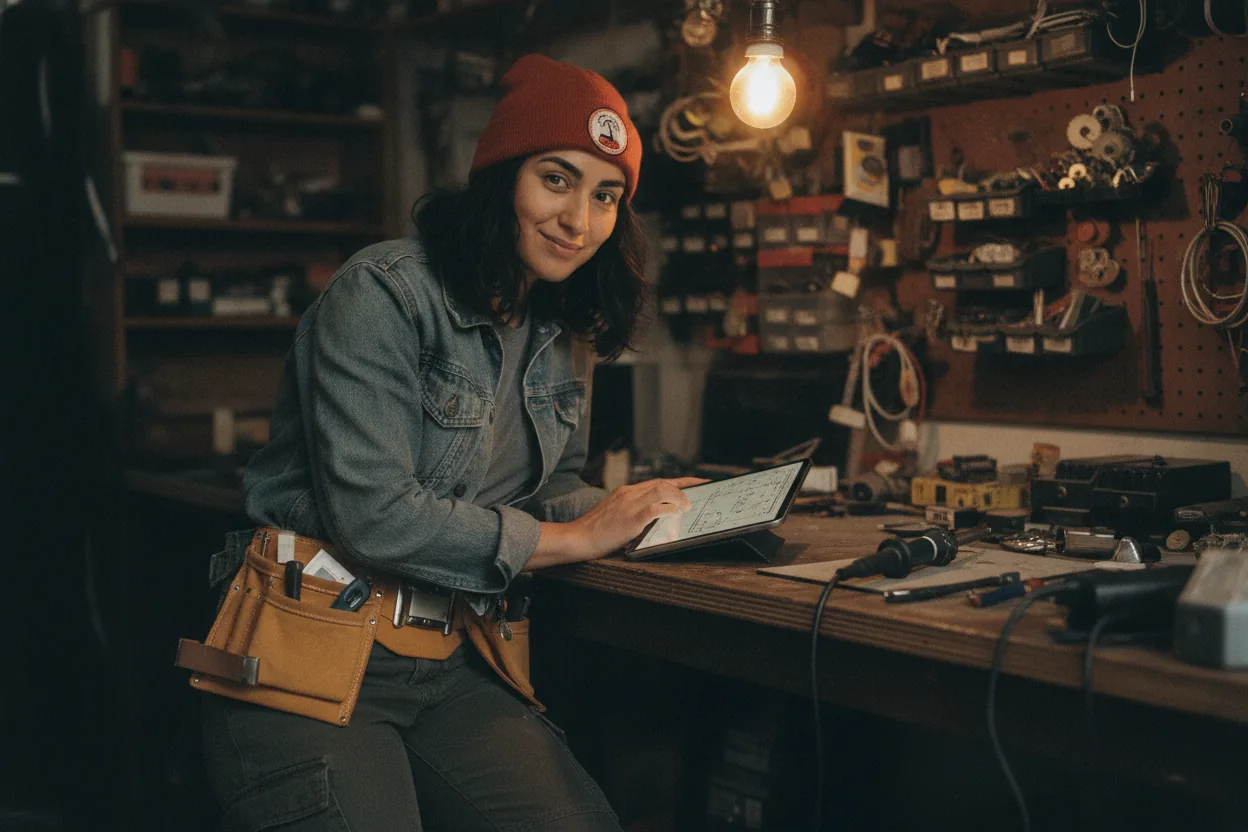
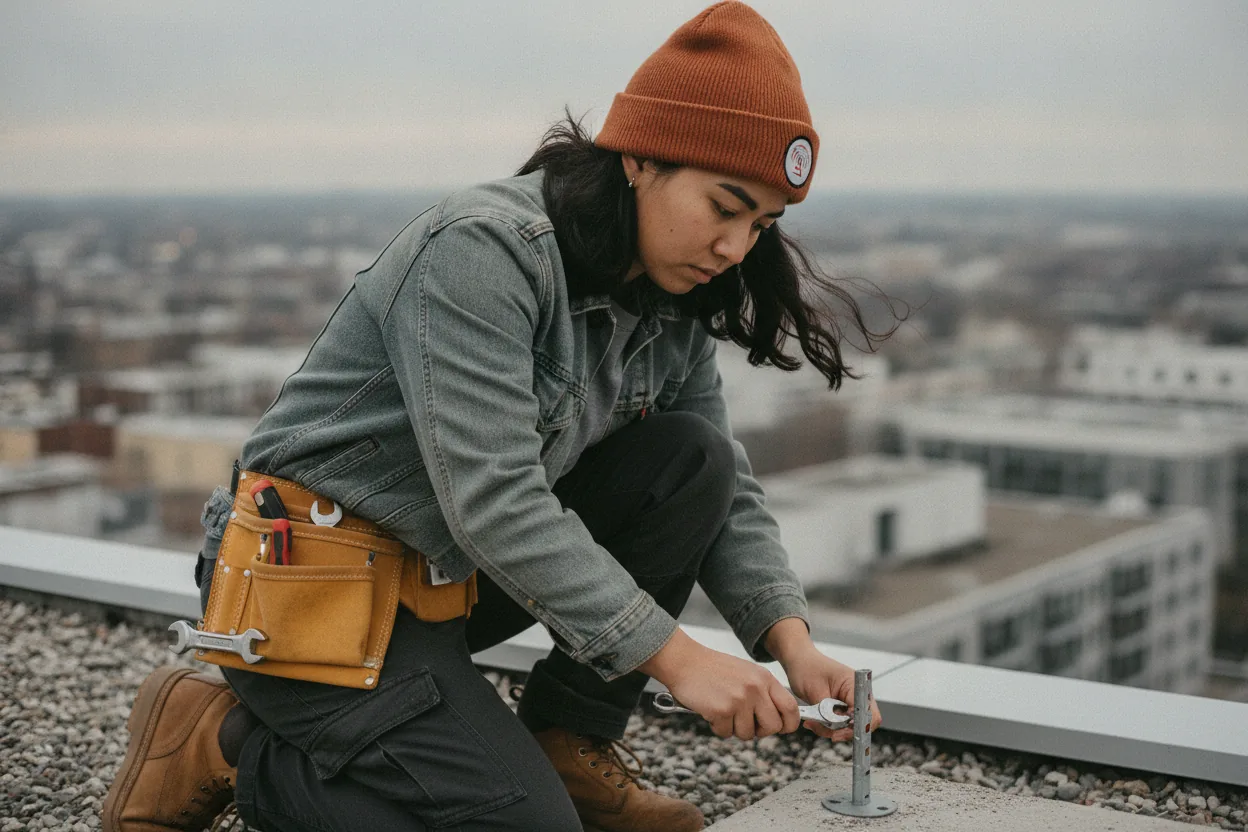
两个场景在环境上毫无共同之处——狭小室内空间中的温暖钨丝灯光,对比开阔屋顶上的寒冷日光。但带天线补丁的锈色毛线帽一样,牛仔夹克一样,工具腰带一样,脸在两张图里读起来都是同一个年轻女性。这就是圣经在发挥作用。
场景之间变了什么(以及什么没变)
| 属性 | 工作坊 | 屋顶 |
|---|---|---|
| 光温 | 暖钨丝 | 冷阴天 |
| 姿势 | 坐着,俯身 | 跪着 |
| 背景 | 杂乱室内 | 开阔城市屋顶 |
| 一天中的时间 | 深夜 | 清晨 |
| 毛线帽 | ✅ 同样的锈橙色 + 补丁 | ✅ 相同 |
| 牛仔夹克 | ✅ 同样的水洗 | ✅ 相同 |
| 工具腰带 | ✅ 同样的黄色皮革 | ✅ 相同 |
| 面部几何 | ✅ 相同 | ✅ 相同 |
| 美人痣 | 位于右脸颊 | 存在(略淡) |
最后一行最重要。在两种完全不同的光照情况下,那颗小痣都留在右脸颊。这正是你想要的信号。
演示 B —— 一个三镜头电商序列,同一模特
电商是本文两个演示中更难的那个。模特在多个角度和换装之间必须看起来字面上完全一致,因为品牌的顾客会在产品详情页上在脑中 A/B 这些照片。即使很小的漂移也会打破幻觉。
这是 Aria 的圣经:
ARIA = (
    "Aria, a 26-year-old fashion catalogue model of Korean descent, "
    "soft warm undertone skin, oval face with slightly defined "
    "cheekbones, thin straight black eyebrows, dark brown almond "
    "eyes, small natural lips with a faint warm pink, a single "
    "beauty mark just below the left eye, centre-parted glossy "
    "black hair falling straight to mid-back, ears pierced with a "
    "single small gold stud each side, no other jewellery, calm "
    "neutral expression, even soft studio lighting from front-left, "
    "clean light grey seamless paper backdrop, full-body framing, "
    "50mm portrait lens look, neutral colour balance, slight matte "
    "film finish."
)
这段圣经做了三件 Mira 圣经没有做的事:
- 它锁定了光线和背景。目录模特必须住在干净灰色背景和扁平左前影棚光中。把两者都写进圣经,每次渲染都从这里开始。
- 它指定了构图。“Full-body framing, 50mm portrait lens look”在三张图中都能一致复现。
- 它钉死了负空间。“No other jewellery”是一小句短语,防止 Nano-Banana 在一半渲染中即兴加入链子或手表。
步骤 1 —— 正面主图
frontal = render("nano-banana", "3:4", ARIA, scene=(
    "full-body straight-on frontal e-commerce shot, Aria standing "
    "relaxed with arms at sides, wearing a structured rust-olive "
    "wool blazer (single-breasted, two buttons, notch lapel, no "
    "pattern) over a plain ivory crew-neck t-shirt and straight-leg "
    "dark indigo denim jeans, simple white leather sneakers, clean "
    "look-book composition."
))
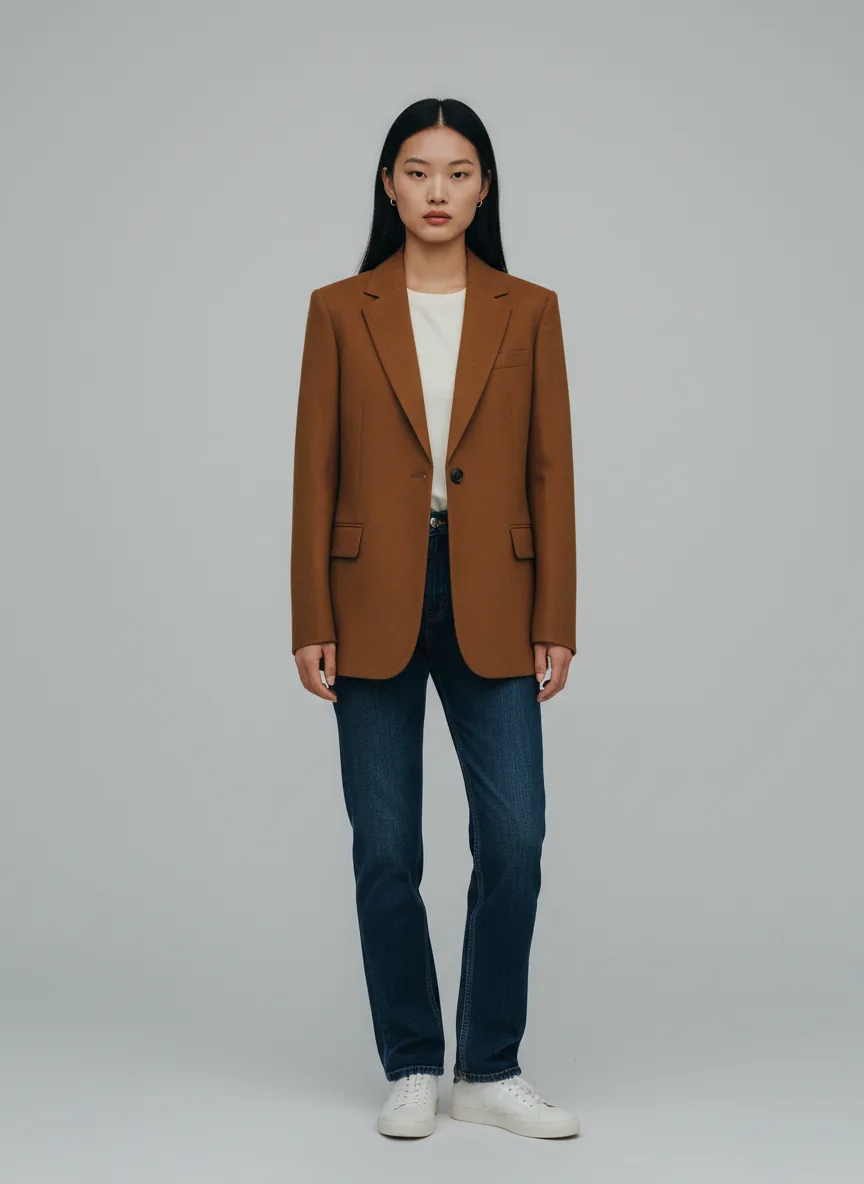
关于渲染夹克的一句实话说明:提示词要求的是锈橄榄色,Nano-Banana 把它解析成了暖烟草棕。Pantone 风格的特定颜色名(“rust-olive”、“burnt sienna”、“ultramarine”)在生成中不能可靠复现。如果你需要品牌准确的色彩,先渲染基础图,然后在色彩专门化的模型上跑一次图生图——或者只在主图时刻用 nano-banana-pro 购买一张色彩准确的样本图,并接受价格。
步骤 2 —— 四分之三角度,同一服装
side = render("nano-banana", "3:4", ARIA, scene=(
    "full-body three-quarter angle from her right, Aria standing "
    "relaxed, wearing the same structured rust-olive wool blazer "
    "(single-breasted, two buttons, notch lapel, no pattern) over "
    "a plain ivory crew-neck t-shirt and straight-leg dark indigo "
    "denim jeans, simple white leather sneakers, hands by her "
    "sides, look-book lighting."
))
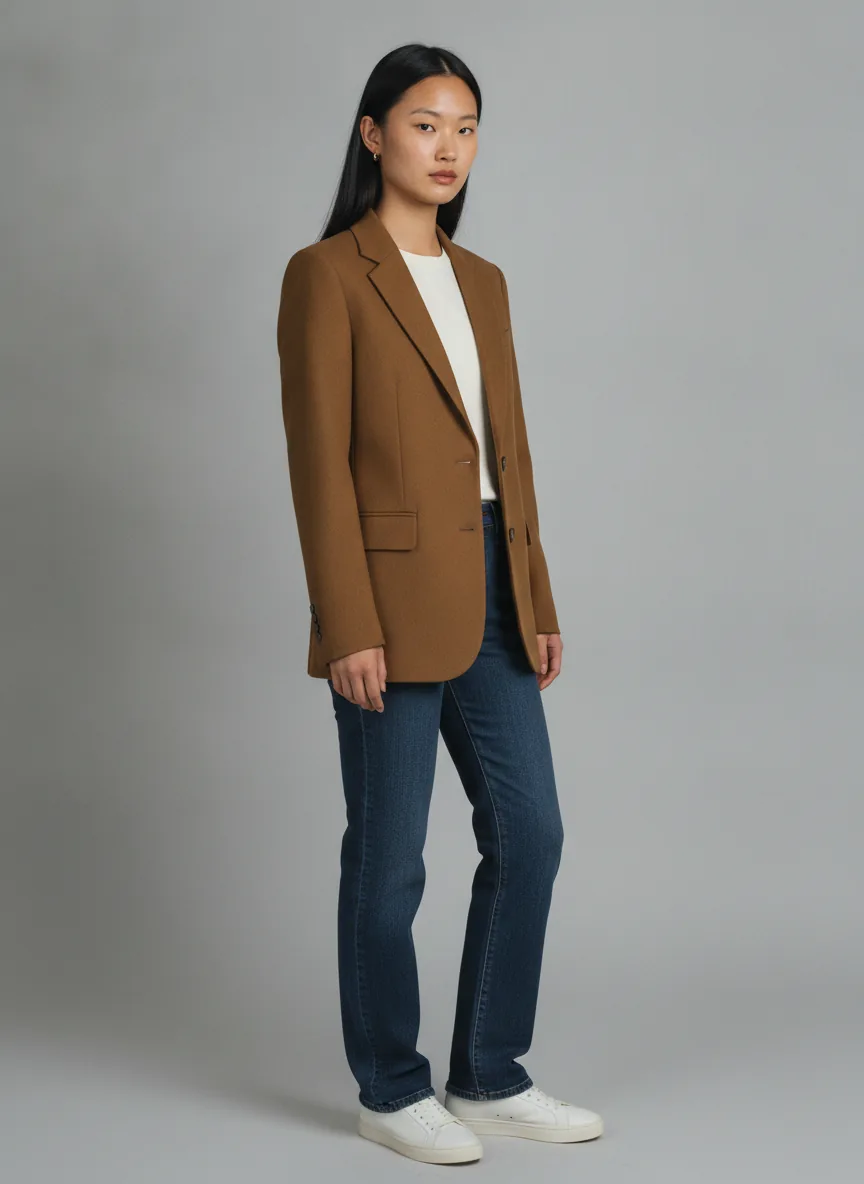
这正是角色一致性演示中总是翻车的部分:同一个人,旋转。脸必须保持一致,发型必须保持一致,服装在她身上的穿着方式也必须一致。并排看,两张照片读起来像同一场拍摄——同一个模特、同一张通告单、同一把化妆椅。这就是你需要的结果。
步骤 3 —— 同一模特,完全不同的服装
swap = render("nano-banana", "3:4", ARIA, scene=(
    "full-body straight-on frontal e-commerce shot, Aria standing "
    "relaxed with arms at sides, now wearing an oversized "
    "camel-coloured double-breasted wool overcoat (mid-thigh length, "
    "wide lapels, large mother-of-pearl buttons) over a black "
    "turtleneck and straight-leg charcoal trousers, black ankle "
    "boots, look-book lighting."
))
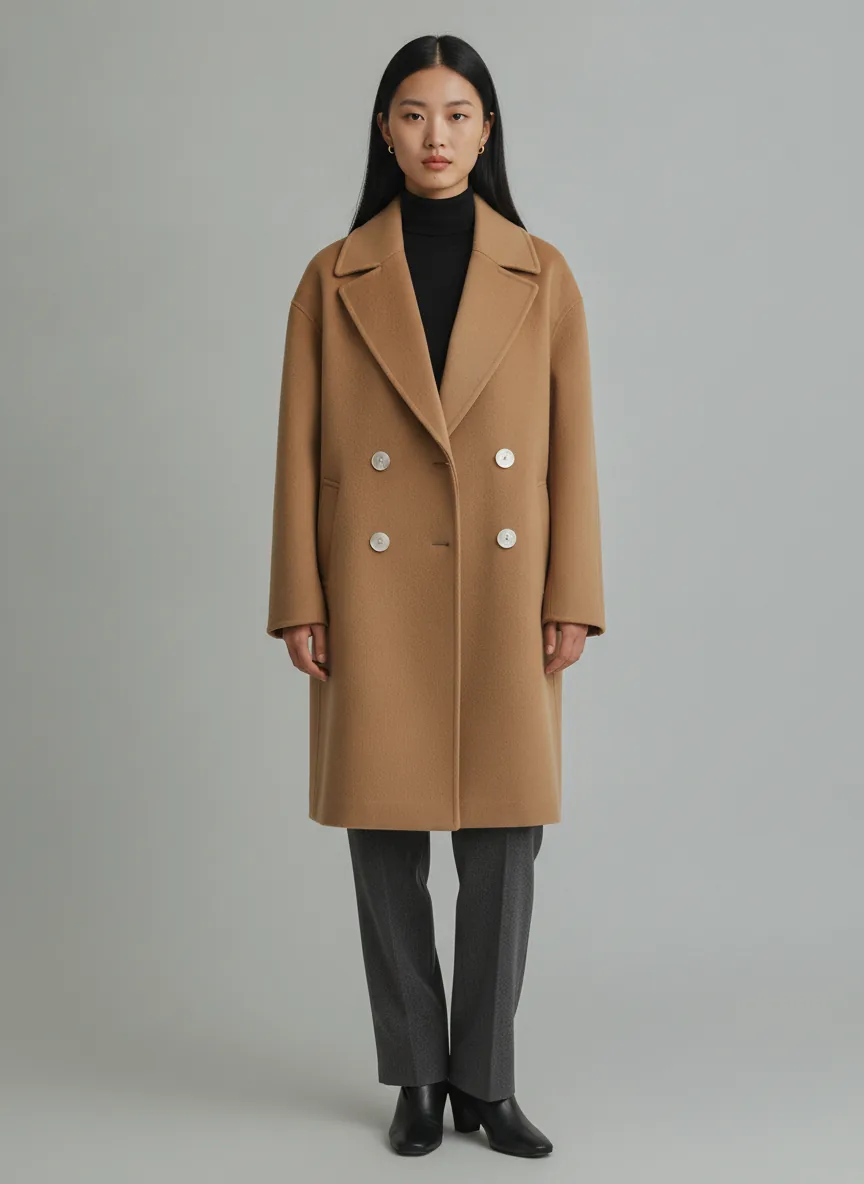
这就是为 Nano-Banana 赢得角色一致性标签的演示。同样的脸、左眼下方同样的美人痣、同样的发长和分缝、同样的金色耳钉、同样的姿态语汇——只有服装和轮廓改变。如果你正在构建虚拟试穿流程、自动 lookbook 生成器或批量生产的 PDP 拍摄,这正是你会运行几千次的变换。
什么时候该用 Nano-Banana-Pro
我额外在 nano-banana-pro 的 1K 档渲染了一张 Mira,当前估计:$0.057,只是为了锚定成本与质量的权衡:
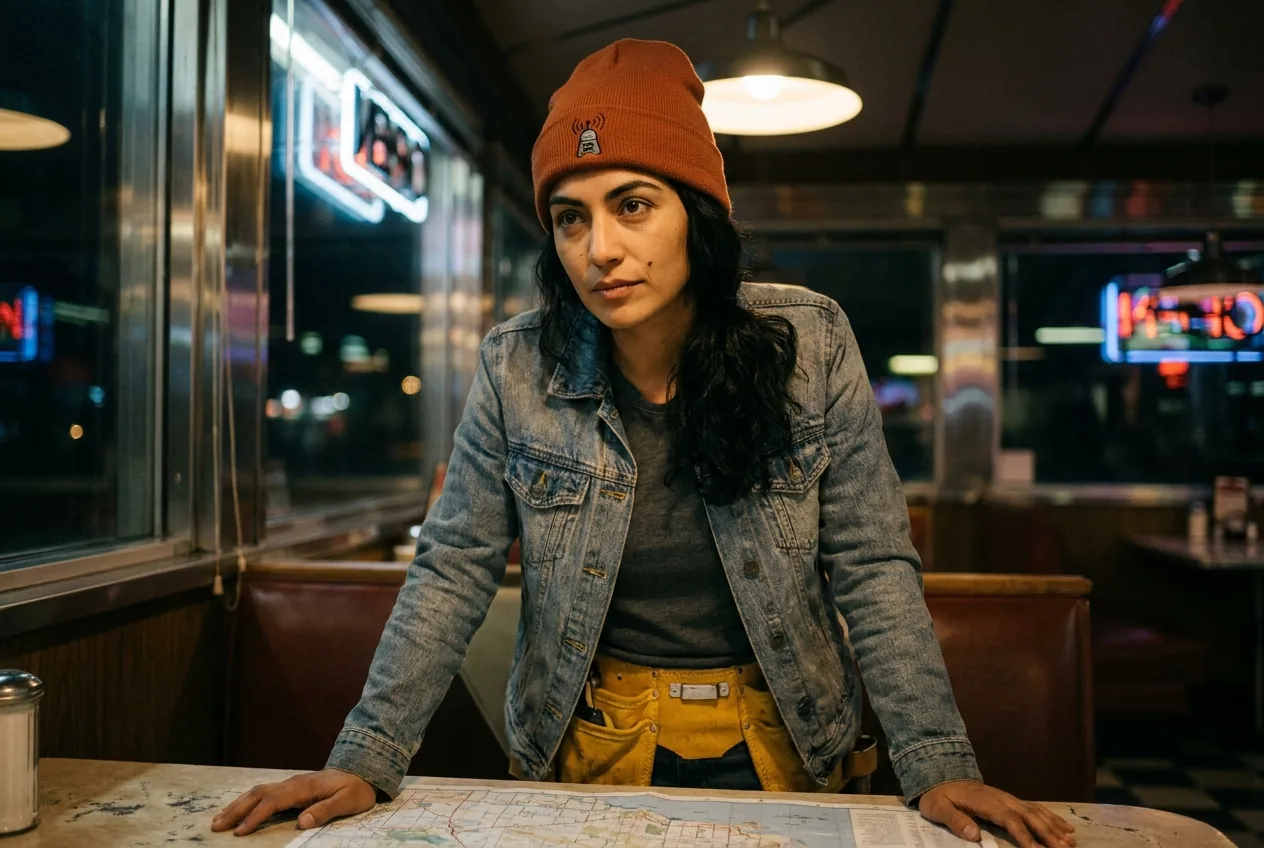
同样的 Mira 圣经。同样的 " | Scene: " 分隔符。只改了模型名。你为每张图多付 $0.007(Pro 的 $0.057 对比固定 Nano-Banana 的 $0.05)实际得到的是:
- 更锐利的微观细节——单根头发、牛仔织纹、毛线帽上的刺绣补丁。
- 对不太显眼的身份标记保持得更好——眼形和眉坡读起来更像 Mira 系列的其余部分。
- 更好的小字渲染。如果你的场景需要一个招牌、标签或标志在缩略图尺寸下可读,Pro 就是你想要的。
对于高用量场景(比如每天数百帧的分镜或程序化目录生成),nano-banana-2 的 1K 档 $0.036 是合适的默认值。Pro 在 1K 和 2K 都是 $0.057,与 nano-banana-2 的 2K 相同,所以在你需要 2K 或主图帧的地方用它——封面图、lookbook 主图、营销单页。
本文当前预估预算
| 渲染 | 模型 | 档位 | 当前估计 |
|---|---|---|---|
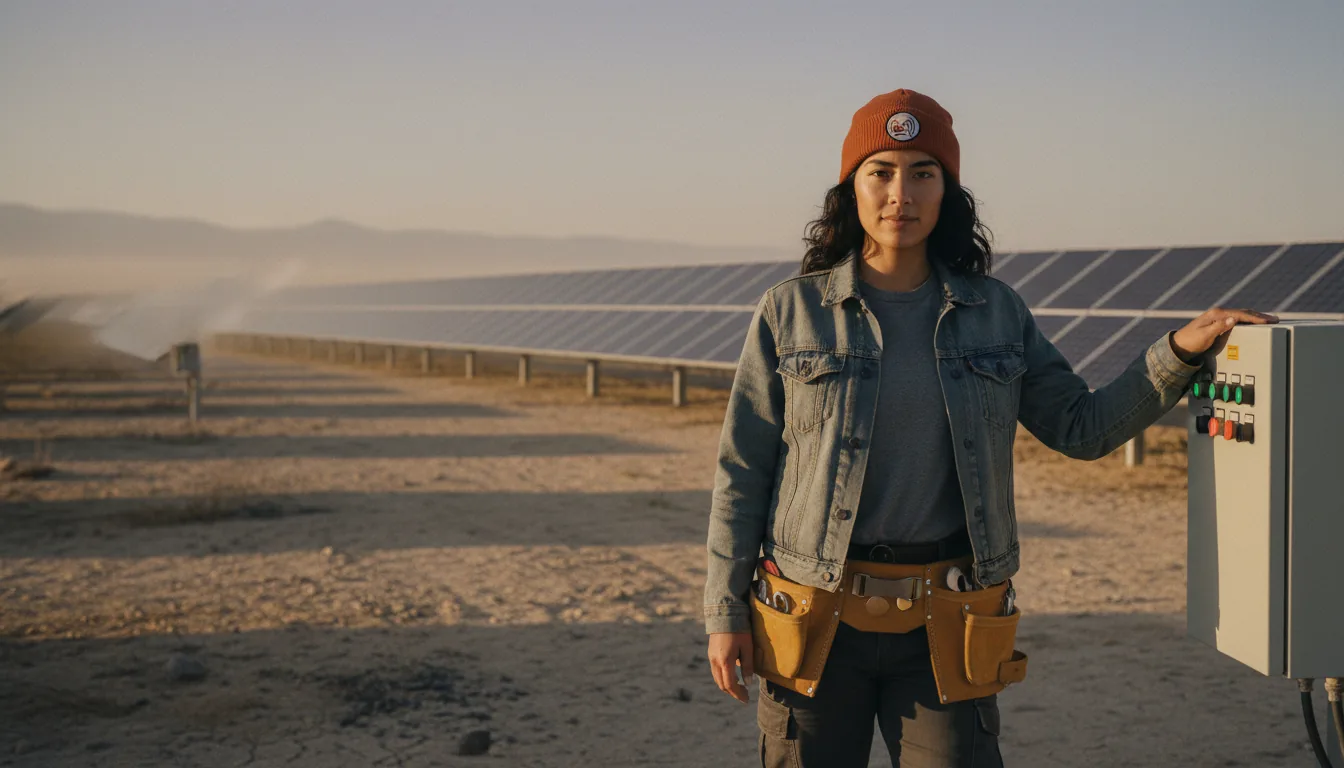
| 封面(Mira 太阳能电站) | Nano-Banana | 16:9 固定 | $0.05 |
| 角色设定表 | Nano-Banana | 3:2 固定 | $0.05 |
| 分镜 1 —— 工作坊 | Nano-Banana | 3:2 固定 | $0.05 |
| 分镜 2 —— 屋顶 | Nano-Banana | 3:2 固定 | $0.05 |
| 电商 —— 正面 | Nano-Banana | 3:4 固定 | $0.05 |
| 电商 —— 侧面 | Nano-Banana | 3:4 固定 | $0.05 |
| 电商 —— 换装 | Nano-Banana | 3:4 固定 | $0.05 |
| Pro 对比图 | Nano-Banana-Pro | 3:2,1K | $0.057 |
| 总计 | $0.41 |
八张图、一个 Bearer token、一个 HTTP 端点,无需组装 SDK,无需管理上游账户——这就是 hiapi 的用途。
我反复回归的实用规则
- 只写一次圣经,放在源码控制中,放在常量模块里。把它当作任何其他配置字符串。给它做版本管理。
- 每个圣经一个名字。“Mira”、“Aria”。即使模型从不显示名字,提示词里有它就是一个稳定句柄。
- 选三个身份标记并狠狠依赖它们。对 Mira 是带天线补丁的毛线帽、黄色工具腰带和那颗小痣。对 Aria 是美人痣、中分头发、金色耳钉。如果这三者在一次渲染中存活,角色就存活了。
- 不要信任 Pantone 风格的颜色名。“Rust-olive”漂移成了烟草棕。如果颜色重要,先渲染再下游校正,或用 Pro 并有意拍摄品牌样本图。
- 把摄影风格印章放在圣经的末尾。“Cinematic 35mm”或“50mm portrait lens, slight matte film finish”——放在最后能让它在长提示词截断中存活。
- 先渲染角色设定表,并预期它会漂向卡通。这很正常。设定表是给你自己的,不是用于发布。生产镜头使用同一圣经加场景内提示词片段,保持照片写实。
- 草稿和量产用
nano-banana-2的 1K($0.036),主图镜头和任何需要 2K 的东西用nano-banana-pro(1K 或 2K 均为 $0.057)。在客户端构建一个小调度器,从quality参数选择模型并转发正确的分辨率。 - 固定价格的
nano-banana拒绝resolution。在客户端按模型名门控该字段。这是血泪教训换来的 400。
这就是工作流。拿一份圣经,选三个身份标记,构建场景片段,通过 POST /v1/tasks 触发,同一个人就会从每次渲染的另一端走出来。
比起文本圣经,更喜欢参考图路线?Ideogram 3.0 Character 改为从一张上传的参考图锁定角色,它的提示词指南展示了吉祥物、故事书页面和蒙版编辑上的同样技巧。


