
flux-3-video 分镜概念:文字驱动的三帧故事板
演示 FLUX 3 Video 的故事板输入能力:用同一段文字场景拆分出的三张关键画面,按均匀时间点钉入生成序列,再由模型在帧与帧之间补全运动、镜头与同步音频。schema 中 images 数组在 3–10 张时被视为等时距故事板,本作只放三张,足以观察「起—承—合」的结构化叙事,而不是让模型自由发挥。 构成:三张参考图分别对应雨夜街道的建立镜头、人物回头的动作节点、霓虹灯下的收束特写;base 中固定 prompt、时长 8 秒、1080p、开启原生音频、画幅 16:9。音画在单一模型中联合生成,因此脚步声、雨声与画面动作天然对齐,无需后期配音流程。 适用场景:广告与影视的前期预演、把已有分镜草图快速转成动态镜头、以及为多语言版本批量复用同一套构图。注意单次片段上限约 20 秒,更长的叙事需要分段生成并用 start_video 续写拼接。
风格 Storyboard · 电影感 · Text-to-Video
模型 FLUX 3 Video
参考输入
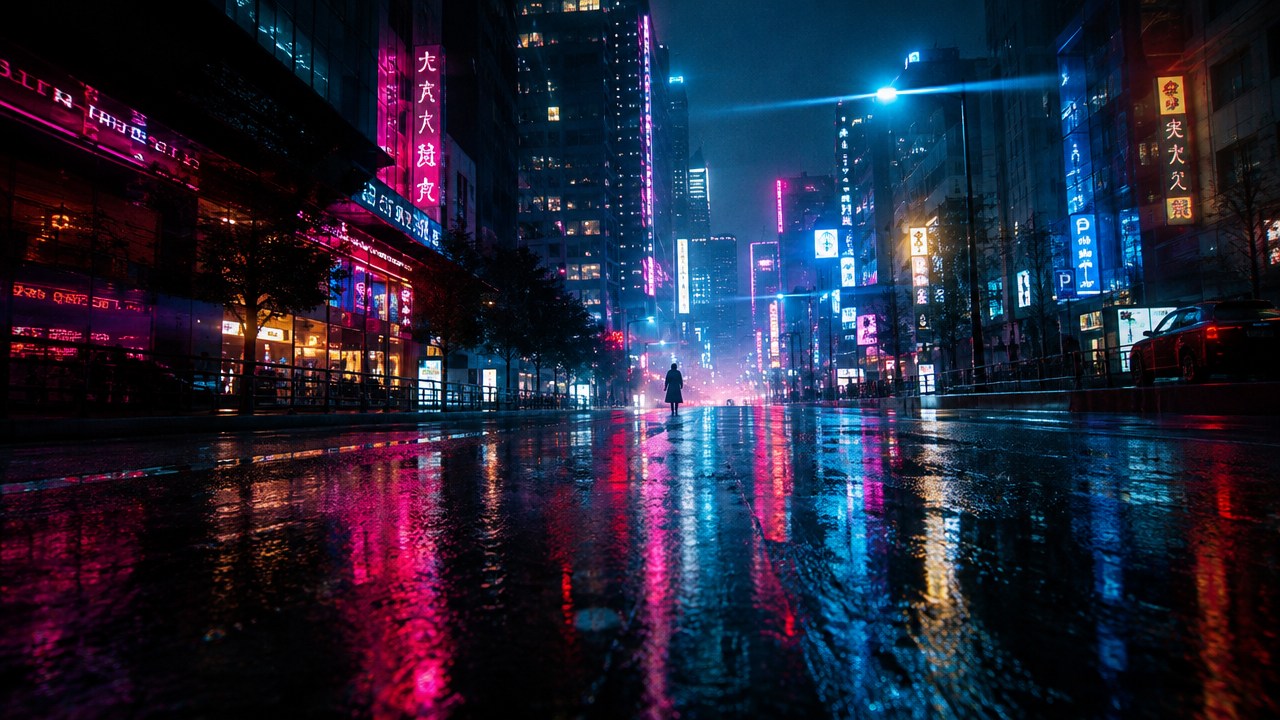
参考图像
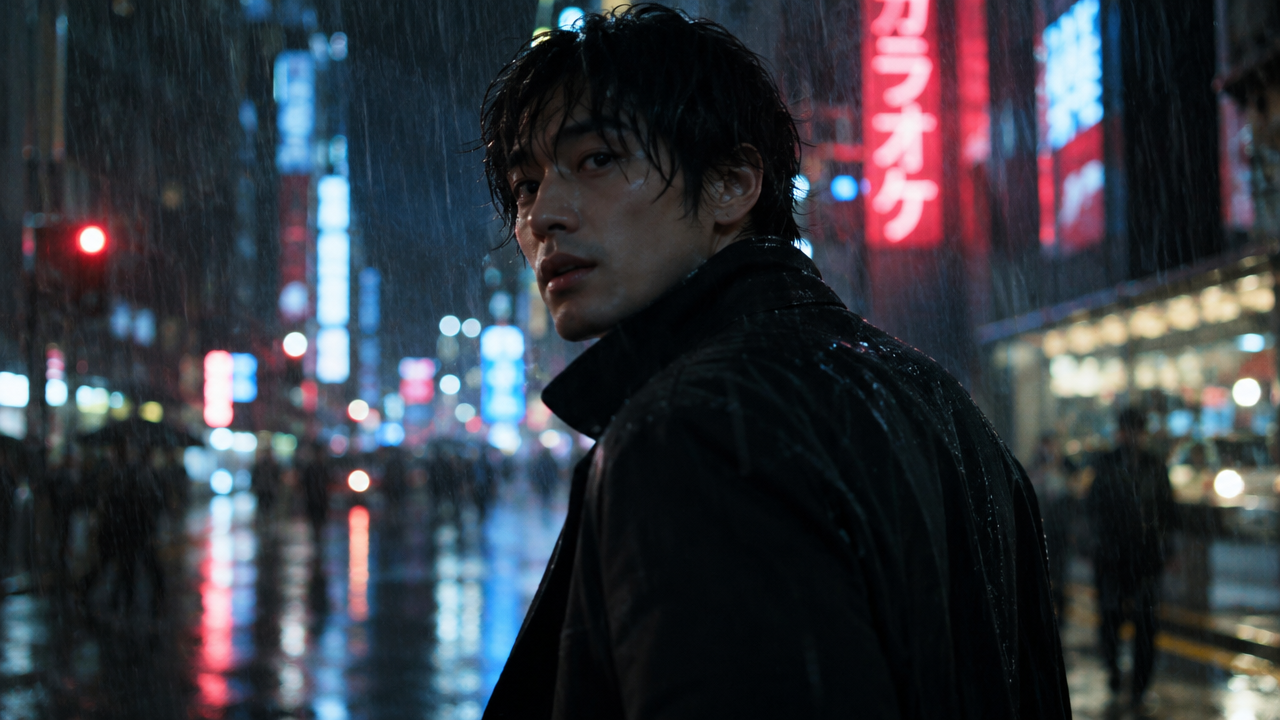
参考图像
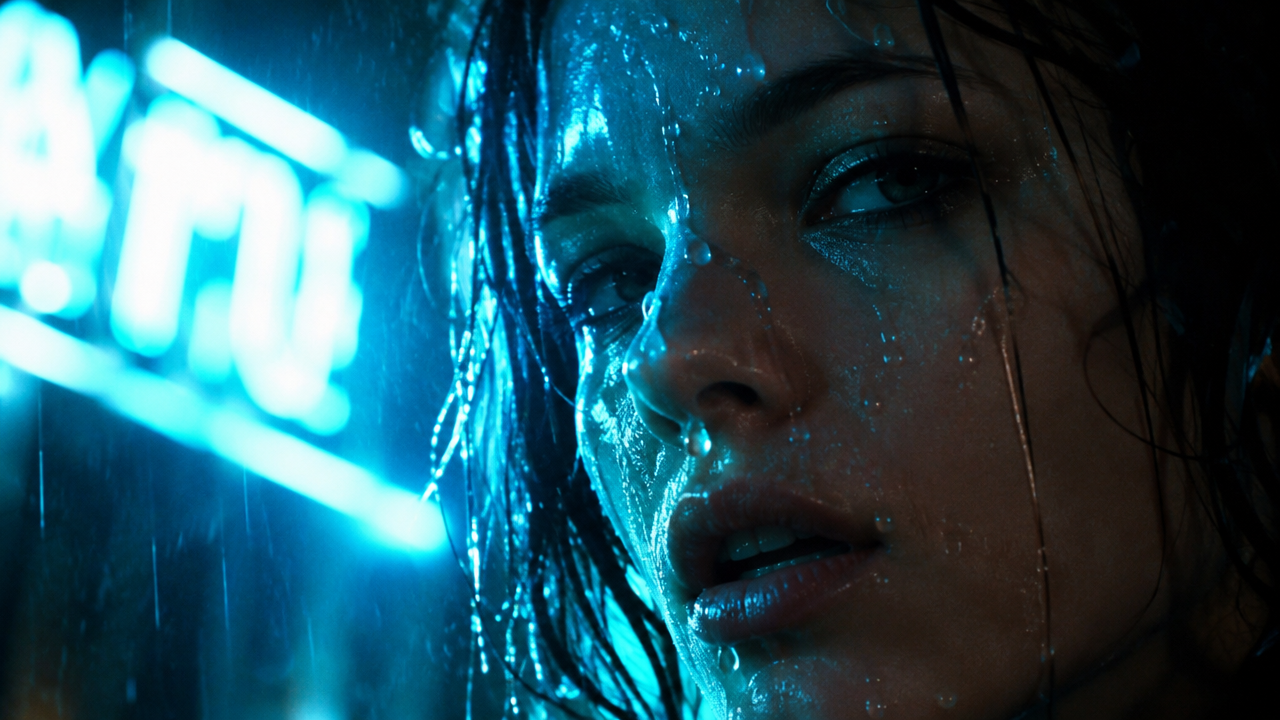
参考图像
提示词
电影感三段式分镜序列,雨夜霓虹弥漫的城市街道。镜头 1:大全景定场镜头,低机位贴近湿漉漉的沥青路面,品红与青色招牌的倒影向地平线延伸,缓慢向前推进。镜头 2:中景,一个身穿深色外套的身影停下脚步,转头望向镜头,雨丝掠过浅景深画面,细微的手持漂移。镜头 3:闪烁霓虹灯下的特写,水滴顺着被摄者的脸庞滑落,背后勾勒出轮廓光,镜头缓缓推近。三个段落保持一致的镜头质感与调色风格,变形宽银幕耀斑,高对比高光,深沉阴影,自然运动模糊,同步的环境雨声与远处城市低鸣。
复制完整提示词,改成你自己的生成任务。
标签