
从一句场景描述到多镜头分镜:Seedance 2.0 文生视频示例
本作品演示 Seedance 2.0 的 text-to-video 路径:只用一段结构化的英文场景描述作为输入,让模型自行完成镜头拆分、运镜设计与氛围建立,输出带同步音频的电影感多镜头短片。 输入侧保持最小化——base 中只保留 prompt 与 aspect_ratio 两个必填字段,并显式指定 duration 与 resolution,便于开发者看清「文本到画面」这一转化过程里,模型真正接收到的信息量。参考素材仅用一张首帧图锚定画面基线(色调、光线方向、主体剪影),其余镜头间的一致性交由模型的多镜头能力处理,而非堆叠参考图。 适用场景:广告与品牌短片的创意预演、叙事短视频的分镜草案、需要在没有实拍素材时快速验证镜头节奏的团队。由于单次生成时长有限,本示例选择 8 秒、16:9,作为可复用片段嵌入更大剪辑中的单元。
风格 multi-shot · 电影感 · Storyboard
模型 Seedance 2.0
参考输入
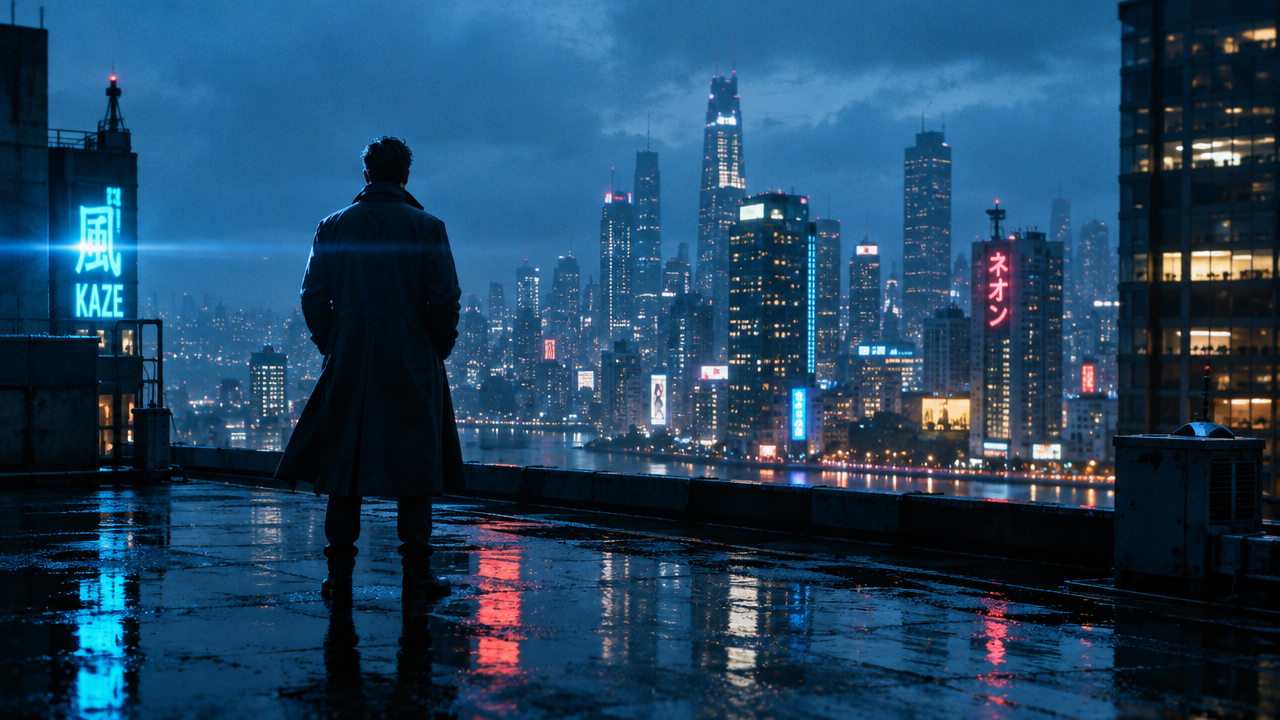
首帧图片
提示词
一个连续的电影镜头序列,展开为三个相互衔接的镜头。镜头1:蓝调时刻被雨水打湿的屋顶,霓虹招牌倒映在浅浅的积水中,镜头缓慢推近一个身穿长外套的孤独身影,从背后拍摄。镜头2:切换到更近的四分之三角度,人物转向天际线,摄影机横向漂移,带有微妙的手持浮动感,轮廓光勾勒出外套边缘。镜头3:拉远并升高至密集城市网格的广角航拍揭示,温暖的窗灯散布在冷蓝色的雾霭中。所有镜头中人物服装和光线方向保持一致,变形宽银幕构图,浅景深,自然主义调色,环境雨声与远处城市嗡鸣与画面同步。
复制完整提示词,改成你自己的生成任务。
标签