
Benutzerhandbuch
HeyGen Avatar IV oder Avatar V wählen? Eigenes Foto oder vorgefertigter Digitaler Mensch
Mit eigenem Foto wählen Sie Avatar IV; für transparenten Hintergrund, SRT-Untertitel oder 4K wählen Sie Avatar V. Beide kosten $0.15 pro Sekunde. Mit echten Beispielvideos beider Seiten und einer Auswahltabelle nach Anwendungsfall.
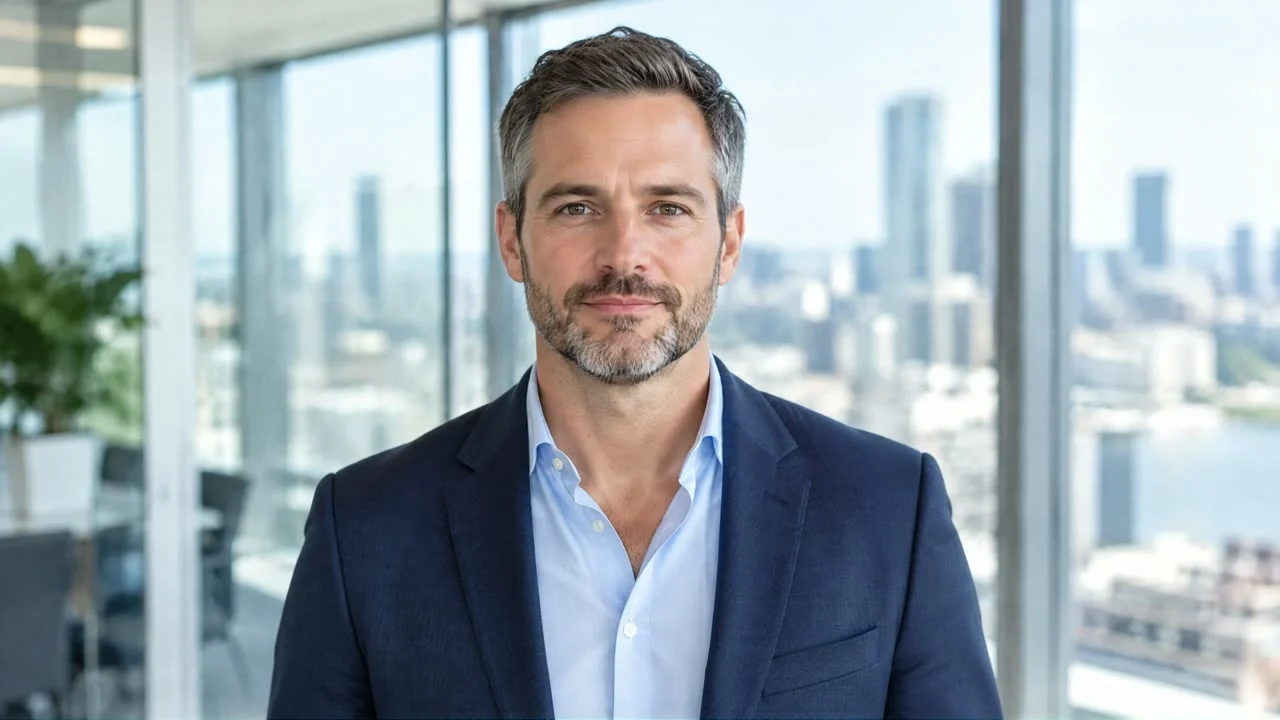
Wenn Sie ein eigenes Foto haben und "diese Person" im Bild erscheinen soll, wählen Sie HeyGen Avatar IV; wenn Sie keine eigene Erscheinung benötigen und stattdessen transparenten Hintergrund, SRT-Untertitel oder 4K wollen, wählen Sie HeyGen Avatar V. Beide kosten $0.15 pro Sekunde – die Wahl beeinflusst Ihr Budget nicht.
HeyGen Avatar IV ist bereits auf HiAPI verfügbar. Öffnen Sie die Modellseite, laden Sie ein Porträtfoto hoch, schreiben Sie einen Text und schon wird ein sprechendes Video generiert.
Die Unterschiede auf einen Blick
| Avatar IV | Avatar V | |
|---|---|---|
| Woher die Person im Bild kommt | Ein von Ihnen hochgeladenes Foto (image_url) |
Auswahl aus 497 vorgefertigten Digitalen Menschen (avatar) |
| Ansteuerung | Text + 102 Stimmen oder Audio | Wie links (dasselbe Set von 102 Stimmen) |
| Auflösung | 720p / 1080p | 720p / 1080p / 4k |
| Seitenverhältnis | 16:9, 9:16, 4:5, 5:4, 1:1, auto | Wie links |
| Hintergrund | Auffüllen des freien Rands (Volltonfarbe oder Bild), wenn Seitenverhältnis und Foto abweichen | Volltonfarbe oder Bildhintergrund, remove_background entfernt den Originalhintergrund, fit wählt contain / cover |
| Transparenter Hintergrund | — | output_format: webm |
| Untertitel | — | caption: true liefert zusätzlich eine SRT-Datei |
| Textlänge | 5000 Zeichen | 5000 Zeichen |
| Preis | $0.15 / Sekunde | $0.15 / Sekunde |
Was die Wahl wirklich entscheidet, ist die erste Zeile: Stammt die Person im Bild aus Ihrem eigenen Upload oder wurde sie aus der Bibliothek ausgewählt? Die folgenden Zeilen zeigen, was Avatar V bei der Nachbearbeitung zusätzlich bietet.
Woher kommt die Person im Bild?
Avatar IV braucht nur ein Foto. Wer auf dem Foto zu sehen ist, ist auch im Video zu sehen – Kleidung, Frisur und Raum bleiben unverändert. Das folgende Querformat-Video, 9 Sekunden, 1080p, 16:9, Stimme: Cute Chloe - Friendly:
Lippensynchronität, Blinzeln und leichtes Nicken folgen der Stimme. Der Text (sinngemäß: Ich bin Lin. Mit einem Foto und einem kurzen Text kann ich Ihr Produkt vorstellen oder eine Lektion aufnehmen):
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
Text ist bereits eingetragen, laden Sie Ihr Foto hoch und generieren Sie → Seitenverhältnis 16:9, Auflösung 1080p wählen.
Avatar V benötigt kein Foto – wählen Sie einfach einen von 497 vorgefertigten Digitalen Menschen. Unten die vorgefertigte Figur Brandon Business Standing Front, Stimme Jack Sterling - Broadcaster, 1080p, 16:9:
Die Anforderungen an das Foto gelten nur bei Avatar IV: Am zuverlässigsten funktionieren Einzelporträts mit frontalem Gesicht, unverdeckten Gesichtszügen, gleichmäßiger Beleuchtung und natürlich geschlossenem Mund. Illustrationen und 3D-Charaktere funktionieren ebenfalls, solange ein klares Gesicht erkennbar ist.
Derselbe Satz, einmal mit jedem Modell generiert
Beide Gruppen verwenden denselben Text, dieselbe Stimme, 1080p und 16:9 – einmal mit Avatar IV, einmal mit Avatar V. Da Stimme und Text identisch sind, ist auch die Videolänge identisch, also sind die Kosten gleich.
Erste Gruppe: Produktvorstellung (Stimme Cute Chloe - Friendly, 9 Sekunden, $1.35)
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
Avatar IV: Im Bild ist das hochgeladene Porträt im Pullover zu sehen – Raum, Frisur und Kleidung stimmen mit dem Foto überein, bewegt werden Lippen, Blinzeln und leichtes Nicken.
Avatar V: Die gewählte vorgefertigte Figur ist Abigail Office Front – eine real gefilmte Moderatorin steht vor einem Bücherregal und einem Konferenztisch und gestikuliert während des Sprechens.
Mit diesem Text generieren → Der Text ist bereits eingetragen, laden Sie Ihr Foto hoch und generieren Sie.
Zweite Gruppe: Kundenpräsentation (Stimme Dexter - Professional, ca. 8 Sekunden, $1.20)
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
Avatar IV: Halbporträt eines Beraters, hinter ihm raumhohe Fenster und eine Skyline – die Person behält Anzug und Position aus dem Foto bei.
Avatar V: Vorgefertigte Figur Brandon Office Sitting Front, sitzend hinter einem Schreibtisch in einem offenen Bürobereich, ein Laptop vor sich.
Mit diesem Text generieren → Der Text ist bereits eingetragen, laden Sie Ihr Foto hoch und generieren Sie.
Beide Gruppen im Vergleich: Wenn im Bild genau die von Ihnen bestimmte Person zu sehen sein soll, verwenden Sie IV; wenn nur eine professionelle Moderatorin den Text klar vortragen soll, wählen Sie V und eine vorgefertigte Figur.
Wie bringt man die Figur zum Sprechen?
Das ist bei beiden vollkommen identisch. Schreiben Sie den Text und wählen Sie eine Stimme aus demselben Set von 102 vorgefertigten Stimmen; oder laden Sie direkt eine Audioaufnahme hoch, die die Lippenbewegungen steuert. Die Textlänge ist jeweils auf 5000 Zeichen begrenzt, Chinesisch und Englisch sind beide möglich.
Derselbe Text und dieselbe Stimme funktionieren also beim Modellwechsel ohne Umschreiben. Der Unterschied liegt nur bei der Person im Bild: Avatar IV erhält einen Foto-Link, Avatar V einen Figurnamen.
Wie werden Bild und Hintergrund behandelt?
Der Hintergrund von Avatar IV ist der Hintergrund des Fotos selbst. Nur wenn sich das Ausgabe-Seitenverhältnis vom Foto unterscheidet und freie Ränder entstehen, kommt background zum Einsatz: Übergeben Sie #RRGGBB für eine Volltonfarbe oder ein Bild zum Auffüllen. Unten ein Querformat-Lehrerfoto in einem 9:16-Hochformat, oben und unten mit einem Tafelbild aufgefüllt, 11 Sekunden:
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
Text ist bereits eingetragen, laden Sie Ihr Foto hoch und generieren Sie → Seitenverhältnis 9:16 wählen, als Hintergrund ein Bild wählen und Ihr Hintergrundbild hochladen.
Avatar V kann beim Hintergrund mehr: remove_background entfernt den Originalhintergrund und ersetzt ihn durch eine Volltonfarbe oder ein Bild; fit legt fest, ob die Person vollständig per contain eingepasst oder per cover flächendeckend eingefügt wird; output_format: webm gibt direkt einen transparenten Hintergrund aus, den Sie in der Schnittsoftware auf beliebige Bilder legen können.
Auswahltipp: Die real gefilmten vorgefertigten Figuren von Avatar V bringen ihren Aufnahmehintergrund mit (etwa das Büro hinter Brandon oben). Wenn Sie Videos mit einheitlichem Hintergrund benötigen, testen Sie zunächst mit einem kurzen Text, bestätigen den Hintergrundeffekt und generieren dann in Serie.
Untertitel und Auflösung
Bei Avatar V liefert caption: true zusätzlich zum Video eine separate SRT-Untertiteldatei; das Bild selbst bleibt sauber, und der Untertitelstil lässt sich in der Nachbearbeitung frei festlegen. Das folgende Hochformat-Produktvideo hat Untertitel aktiviert:
Bei der Auflösung bietet Avatar IV 720p / 1080p, Avatar V zusätzlich eine 4k-Stufe. Für große Displays oder 4K-Lieferungen verwenden Sie Avatar V; für mobile Endgeräte und Web-Ausspielung reicht 1080p.
Wie groß ist der Preisunterschied?
Kein Unterschied – beide kosten $0.15 pro Sekunde, die Auflösung beeinflusst den Preis nicht.
| Dauer | Avatar IV | Avatar V |
|---|---|---|
| 10 Sekunden | $1.50 | $1.50 |
| 30 Sekunden | $4.50 | $4.50 |
Beide werden nach den tatsächlichen Sekunden des generierten Videos abgerechnet; der Preis hängt nur von der Textlänge ab. Detaillierte Preistabellen nach Dauer und Monatsbudgets finden Sie unter HeyGen Avatar IV API-Preise.
Wie wählen Sie je nach Anwendungsfall?
| Anwendungsfall | Auswahl |
|---|---|
| Markenbotschafter, Dozent oder Gründer selbst im Bild | Avatar IV |
| Eine Illustration oder 3D-Figur soll sprechen | Avatar IV |
| Kein passendes Foto, erst einmal mit einer Figur das Video erstellen | Avatar V |
| Zum Einbetten in den Schnitt, transparenter Hintergrund erforderlich | Avatar V |
| Separate Untertiteldatei erforderlich | Avatar V |
| 4K-Video erforderlich | Avatar V |
Häufige Fragen
Kosten beide Modelle gleich viel? Ja. Beide kosten $0.15 pro Sekunde, 10 Sekunden $1.50, 30 Sekunden $4.50.
Kann Avatar IV meine eigene Audioaufnahme verwenden?
Ja. Übergeben Sie audio_url; Lippenbewegungen und Pausen folgen der Aufnahme, das Audio darf maximal 600 Sekunden lang sein. Avatar V unterstützt ebenfalls die Audio-Steuerung.
Kann Avatar IV transparenten Hintergrund oder Untertitel ausgeben? Für transparenten Hintergrund oder SRT-Untertitel verwenden Sie Avatar V. Die Stärke von Avatar IV ist die Erscheinung mit Ihrem eigenen Foto.
Welches Modell für Cartoon- oder 3D-Figuren? Verwenden Sie Avatar IV und laden Sie einfach das Charakterbild hoch – ein klares Gesicht genügt.
Lassen Sie zuerst Ihre eigene Figur sprechen
Sie haben ein Illustrations- oder 3D-Charakterbild zur Hand? Der folgende Kochtext ergibt auf Avatar IV ein 8-Sekunden-Video:
Tonight's special is a slow-roasted tomato soup. It's simple, warm, and ready in twenty minutes. Let's cook!
Text ist bereits eingetragen, laden Sie Ihr Charakterbild hoch und generieren Sie → Wenn Sie eine Figur aus den vorgefertigten Digitalen Menschen wählen möchten, öffnen Sie die Modellseite von HeyGen Avatar V.
Weiterführende Artikel
- HeyGen Avatar IV Modellseite: Foto hochladen und online generieren
- Wie viel kostet die HeyGen Avatar IV API: Preistabelle nach Sekunden und Monatsbudget
- HeyGen Avatar IV Beispielsammlung: Fotos, Texte und Videos für 7 Anwendungsfälle
- So verwenden Sie die HeyGen Avatar IV API: vollständige Integration vom Foto zum sprechenden Video
- HeyGen Avatar IV API-Dokumentation
- HeyGen Avatar V API-Dokumentation: Parameter wie avatar, remove_background, caption u. a.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte