
Alibaba
Qwen Image 3.0
qwen-image-3.0/text-to-image
Das Bildgenerierungs- und -bearbeitungsmodell der dritten Alibaba-Generation zeichnet sich durch dichte Typografie und mehrsprachiges Text-Rendering bei langen Prompts aus und unterstützt die Bearbeitung anhand von Referenzbildern
qwen-image-3.0/text-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image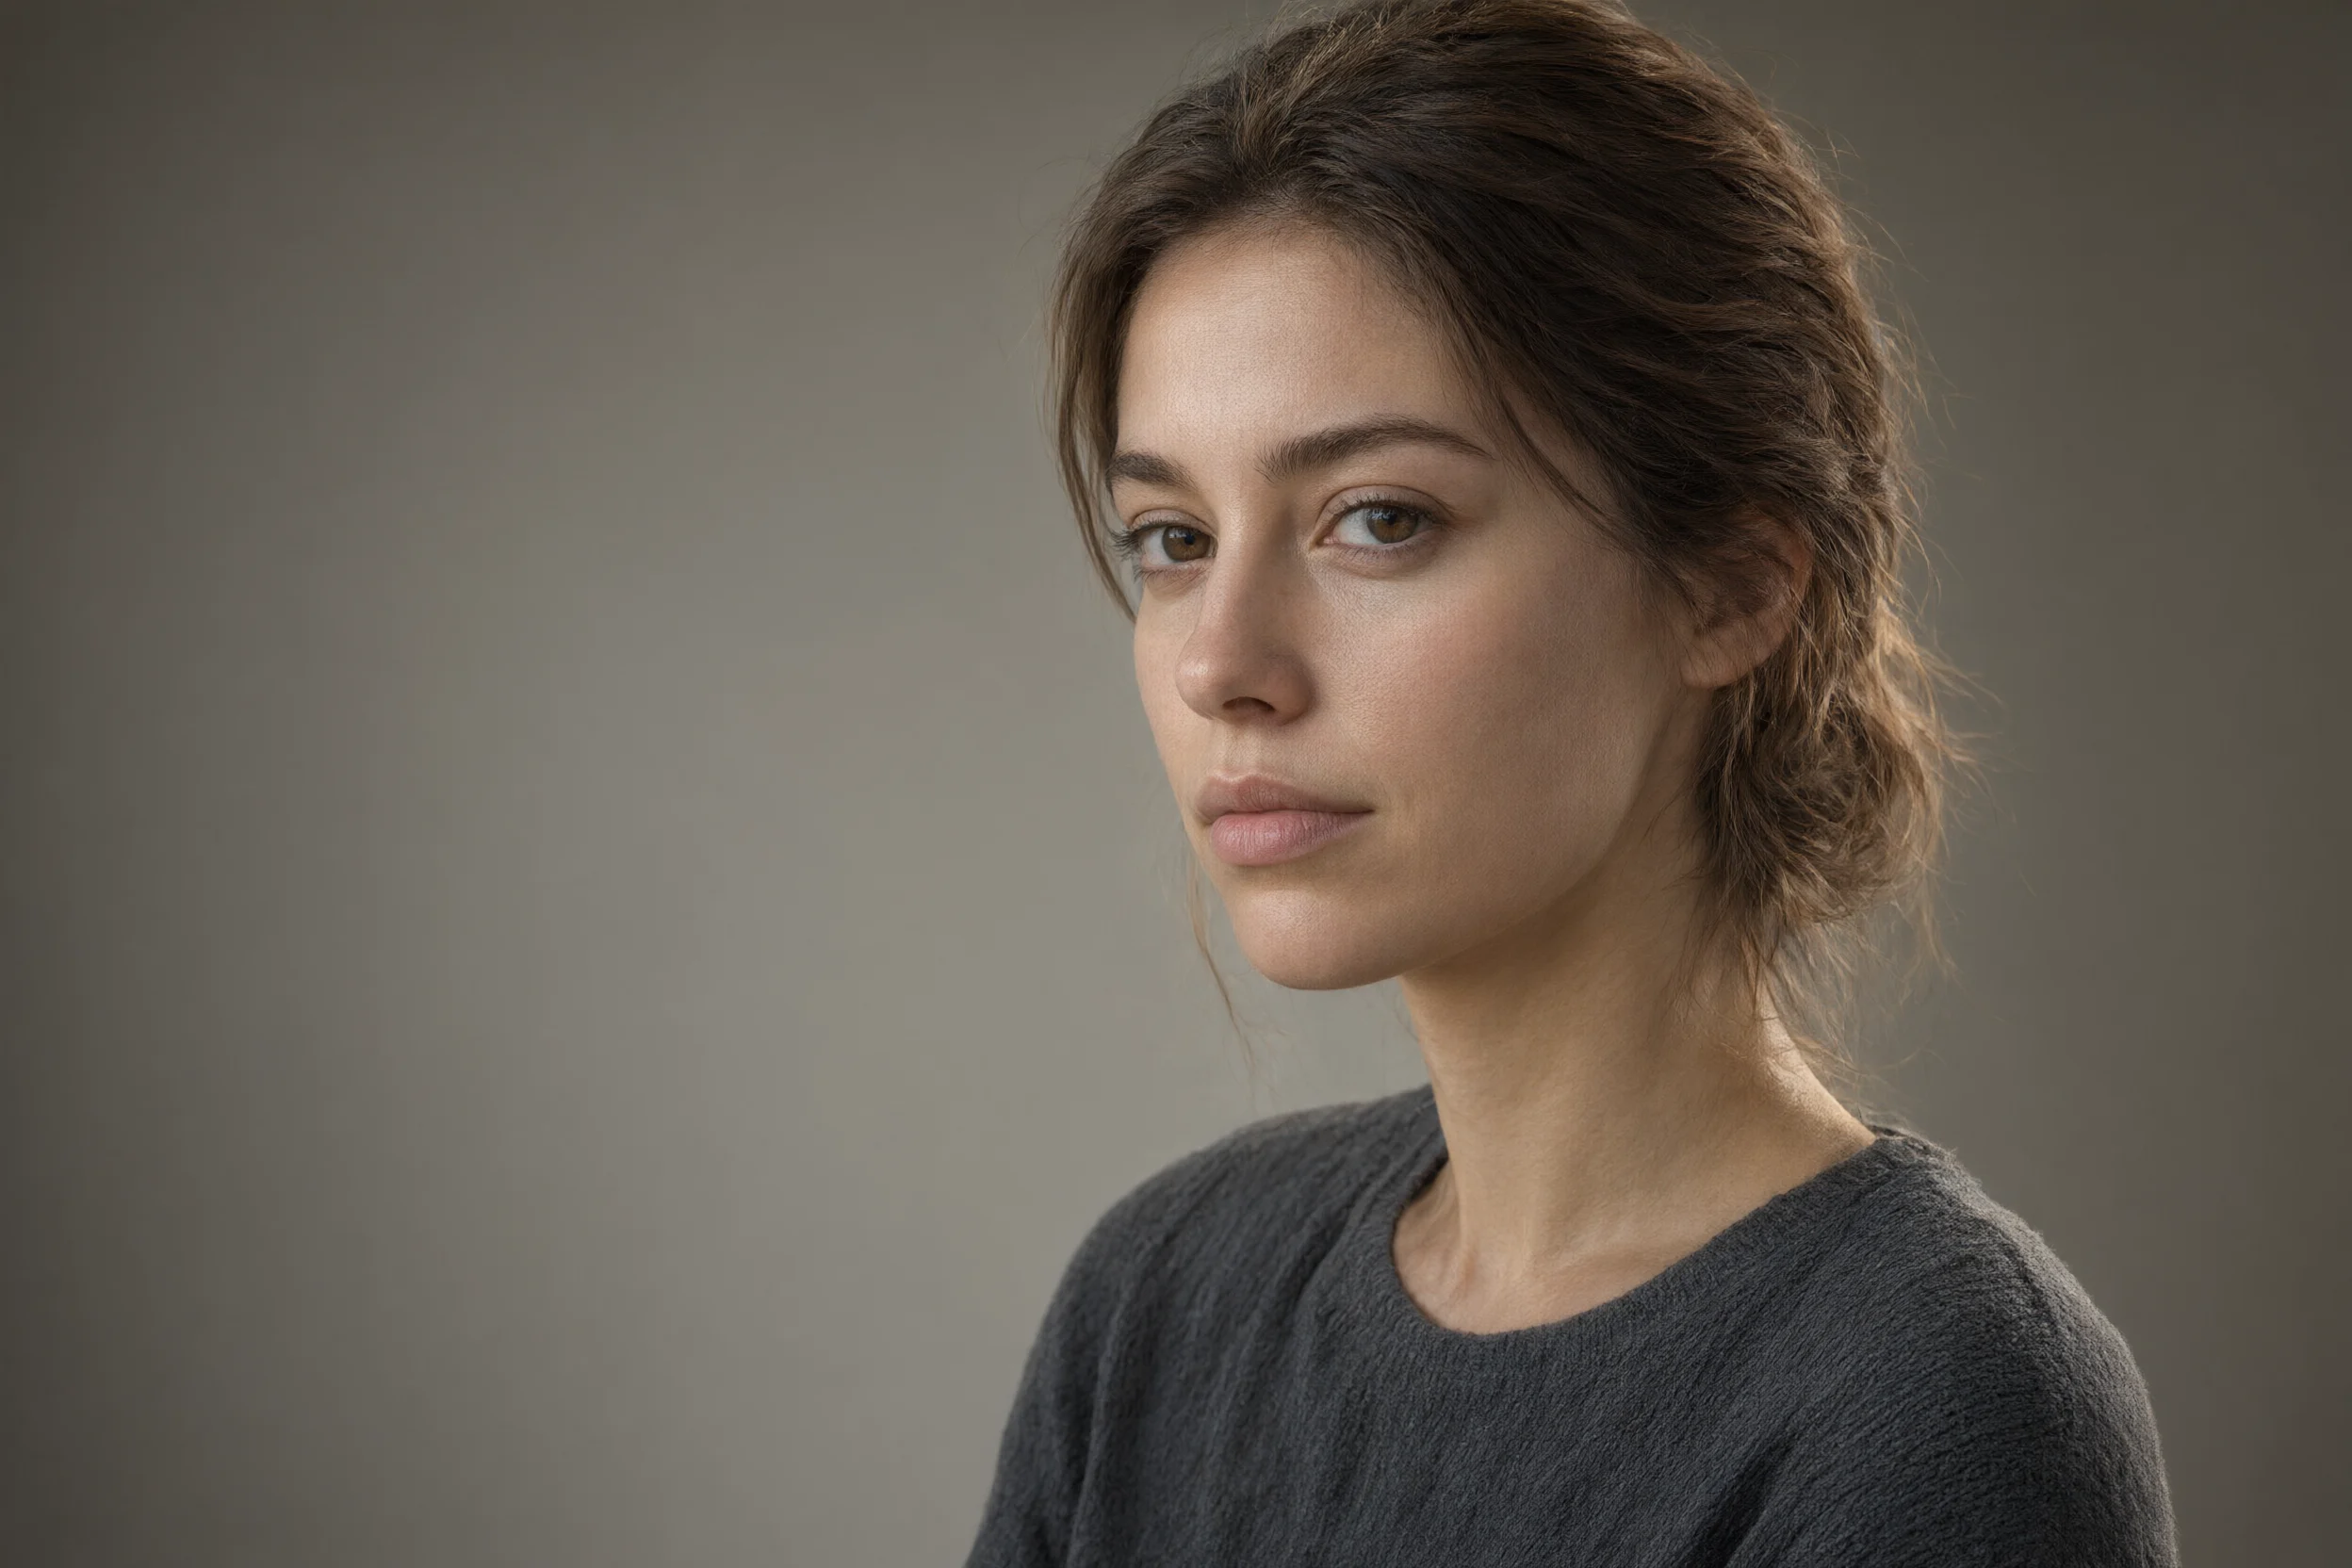
Qwen-Image-3.0 Porträt-Doppelstil-Demo: Realistisch und künstlerisch
Stil Porträt und Fotografie · Fotorealistisch · Text zu Bild
Prompt
Realistische Nahaufnahme-Porträt einer jungen Frau, nahe dreißig Jahre alt, Dreiviertelprofil, leicht nach links gewandt, weiches Fensterlicht von der rechten Kameraseite, feine Konturhighlights an Wangenknochen und Haaransatz, natürliche Hauttextur, sichtbare Poren, feine Härchen und einzelne Haarsträhnen im Licht klar erkennbar, ruhiger Ausdruck, entspannte Lippen, sehr dezentes Make-up, trägt ein schlichtes Oberteil aus Strick in Anthrazit, geringe Schärfentiefe, Hintergrund ist ein weich unscharfer warmgrauer Studiorahmen, Anmutung eines 85-mm-Objektivs, weiches Übergangslicht, natürlich entsättigte Farben, detailreiche Augen und Augenbrauen, keine starke Retusche, 16:9-Querformat, Person auf der rechten Drittellinie platziert
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
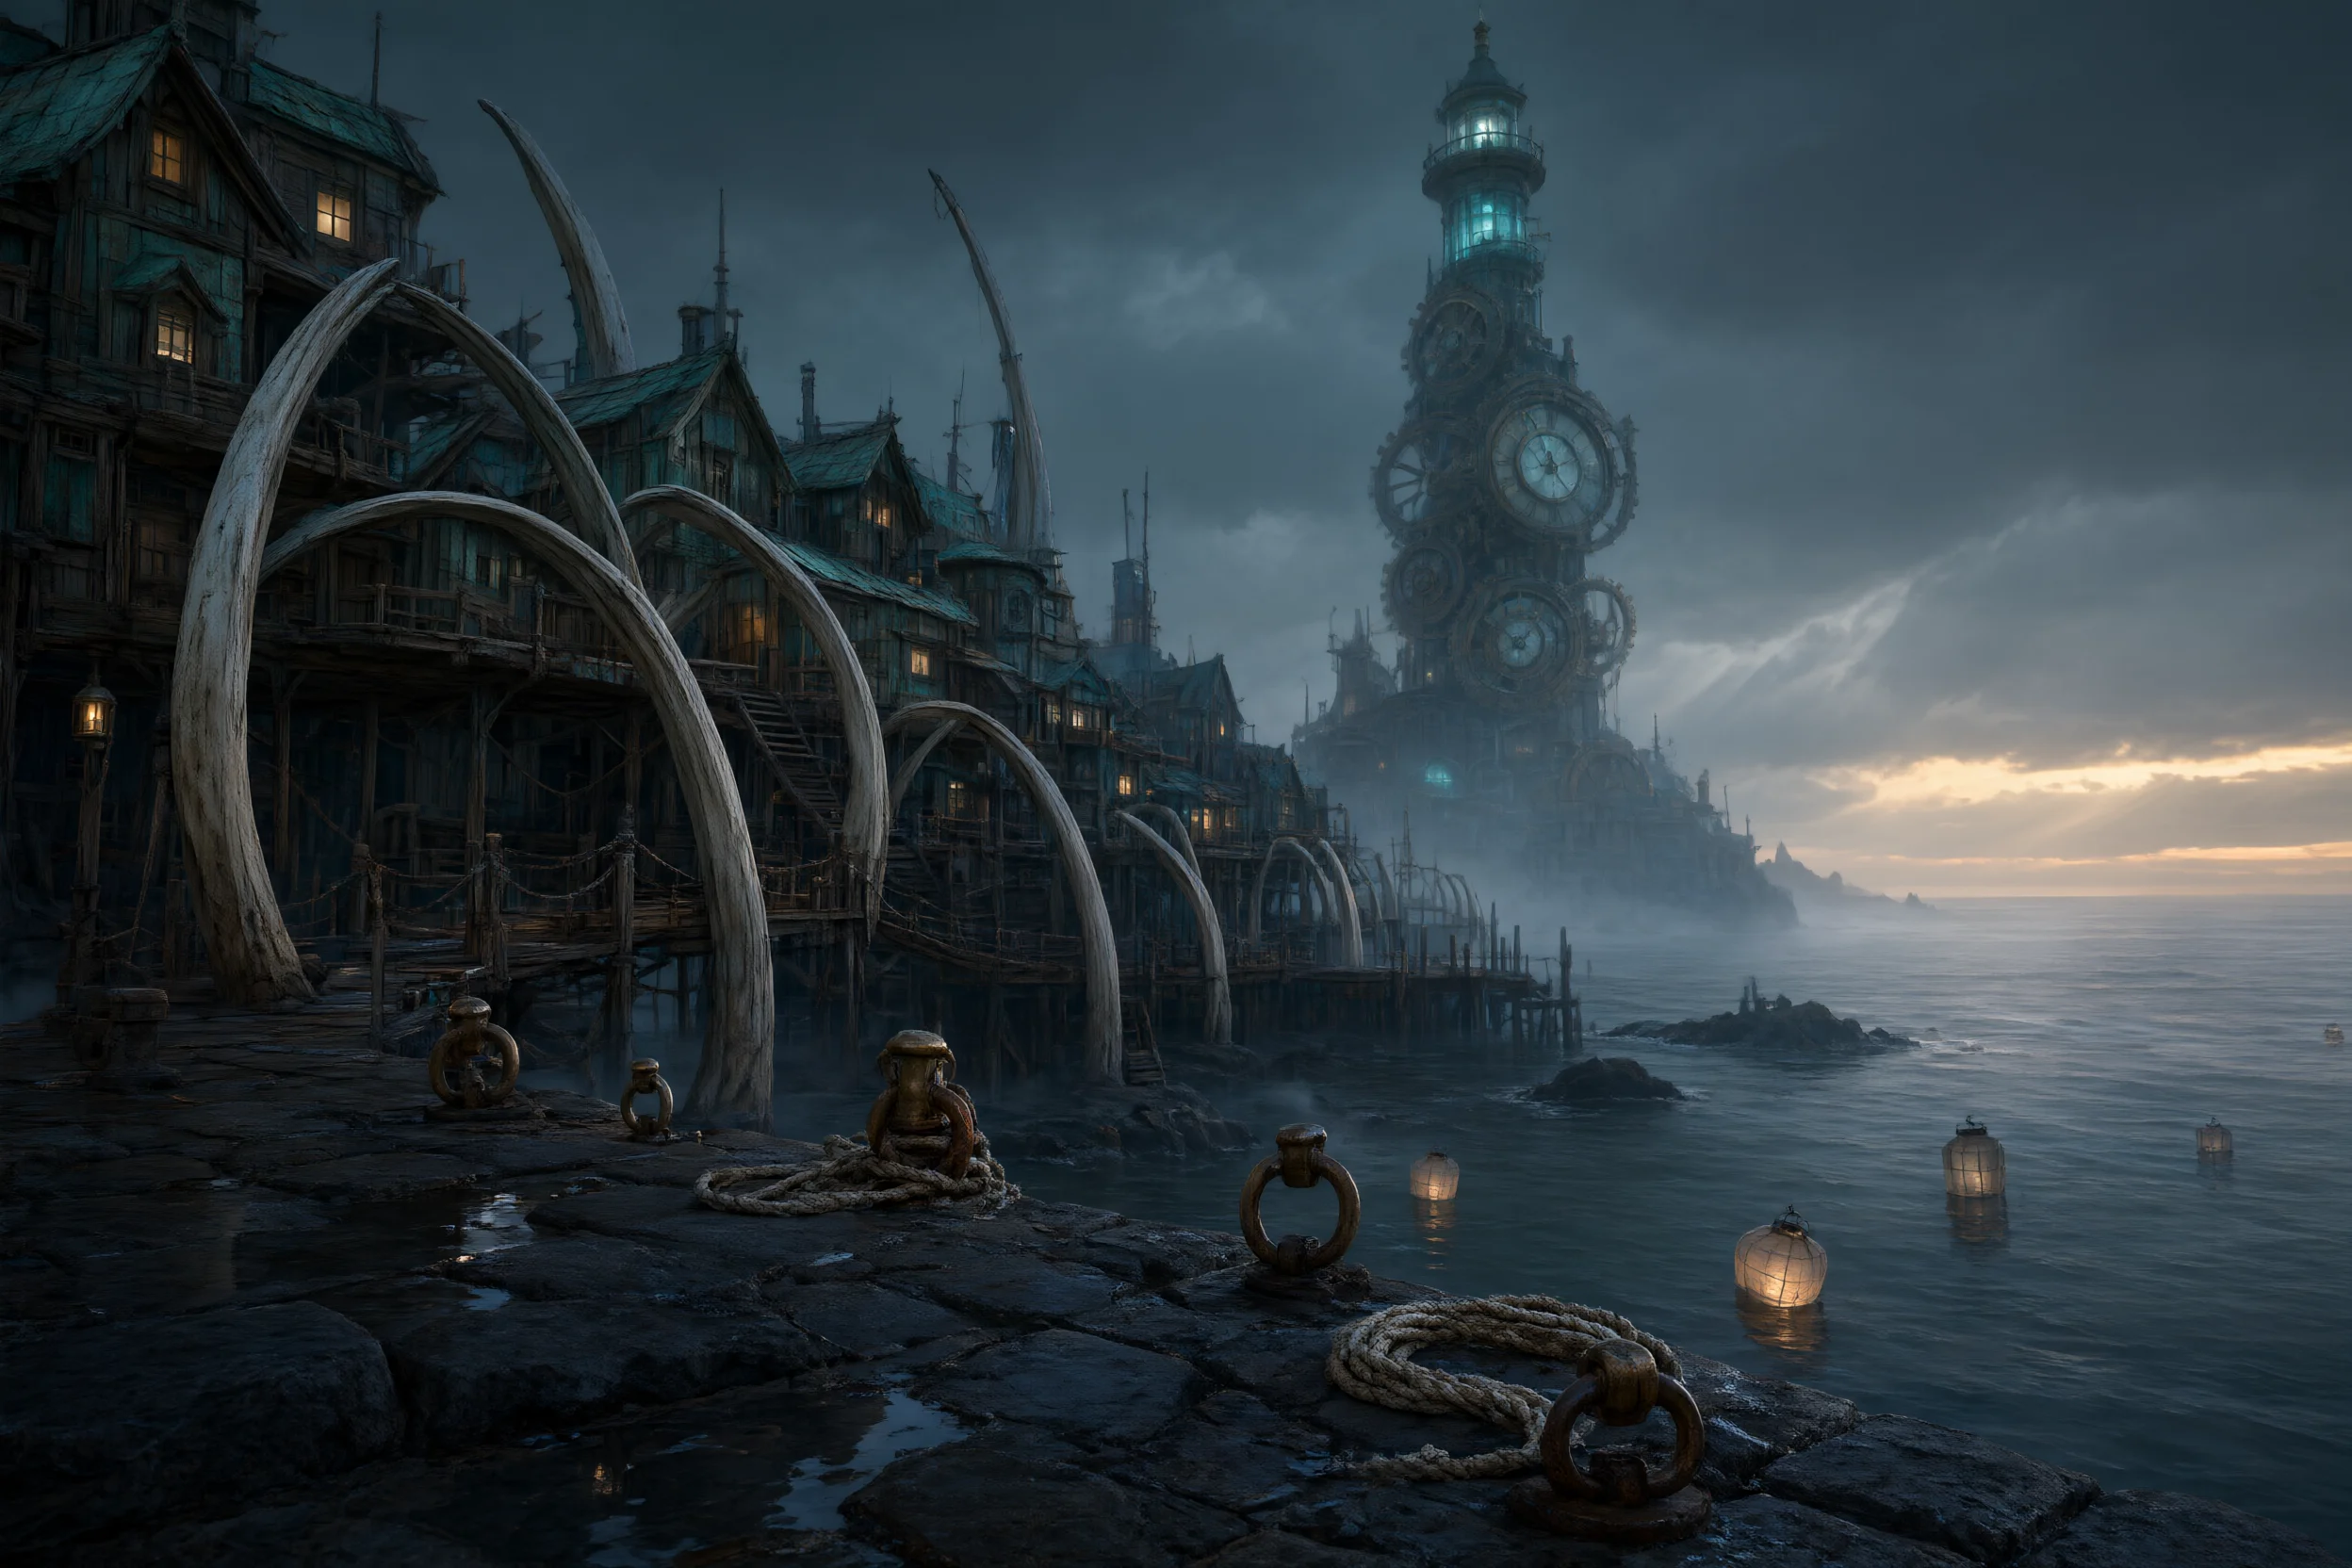
qwen-image-3.0 Szenen-Konzeptbild: Visuelle Erkundung der Atmosphäre einer Welt
Stil Konzeptkunst · Weltbau · Filmisch
Prompt
Ein filmisches Weitwinkel-Konzept-Art-Keyframe, das eine Welt namens Gezeiten-Erinnerungshafen in der blauen Stunde kurz nach einem Sturm darstellt. Vordergrund: feuchte schwarze Basaltkai-Steine mit flachen Spiegelungspfützen, rostigen Messingfestmacherringen, aufgerollten, salzverkrusteten Seilen und einigen schwimmenden Papierlaternen, die halb im Wasser versunken sind. Mittelgrund: eine Reihe geschwungener Pfahlbauten aus recyceltem Bootsholz und oxidierten Kupferplatten, gestützt von riesigen Walrippenbögen, die sich über schmale Stege spannen; kleine Fenster lassen warmes Licht durchscheinen und deuten auf Bewohner hin; Holztreppen und Seilbrücken verbinden die Ebenen. Hintergrund: ein gigantischer turmartiger Leuchtturm aus gestapelten Zahnrädern von Gezeitenuhren und gläsernen Wasserspeichern, der ein schwaches zyanfarbenes Leuchten aussendet und aus der ruhigen grauen See aufsteigt, während am Horizont ferne Gewitterwolken zu einem schmalen bernsteinfarbenen Lichtband aufreißen. Atmosphäre: niedriger Meernebel rollt zwischen den Gebäuden, feiner Nieselregen, Volumenlicht dringt von rechts durch den Nebel, kühle blaugrüne und schieferblaue Farbpalette mit sparsamen bernsteinfarbenen Akzenten, entsättigte filmische Farbkorrektur, subtile chromatische Aberration an den Bildrändern. Stil: malerischer Realismus verschmilzt mit architektonischem Konzeptdesign, hohe Materialtreue bei feuchtem Stein, verwitterter Holzmaserung und rostigem Metall, sanfte Schärfentiefe hält den Mittelgrund klar, hochdetaillierter Negativraum im Himmel für spätere Textplatzierung. 16:9-Komposition, Horizont im unteren Drittel, die Führungslinien des Stegs lenken den Blick zum Turm.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
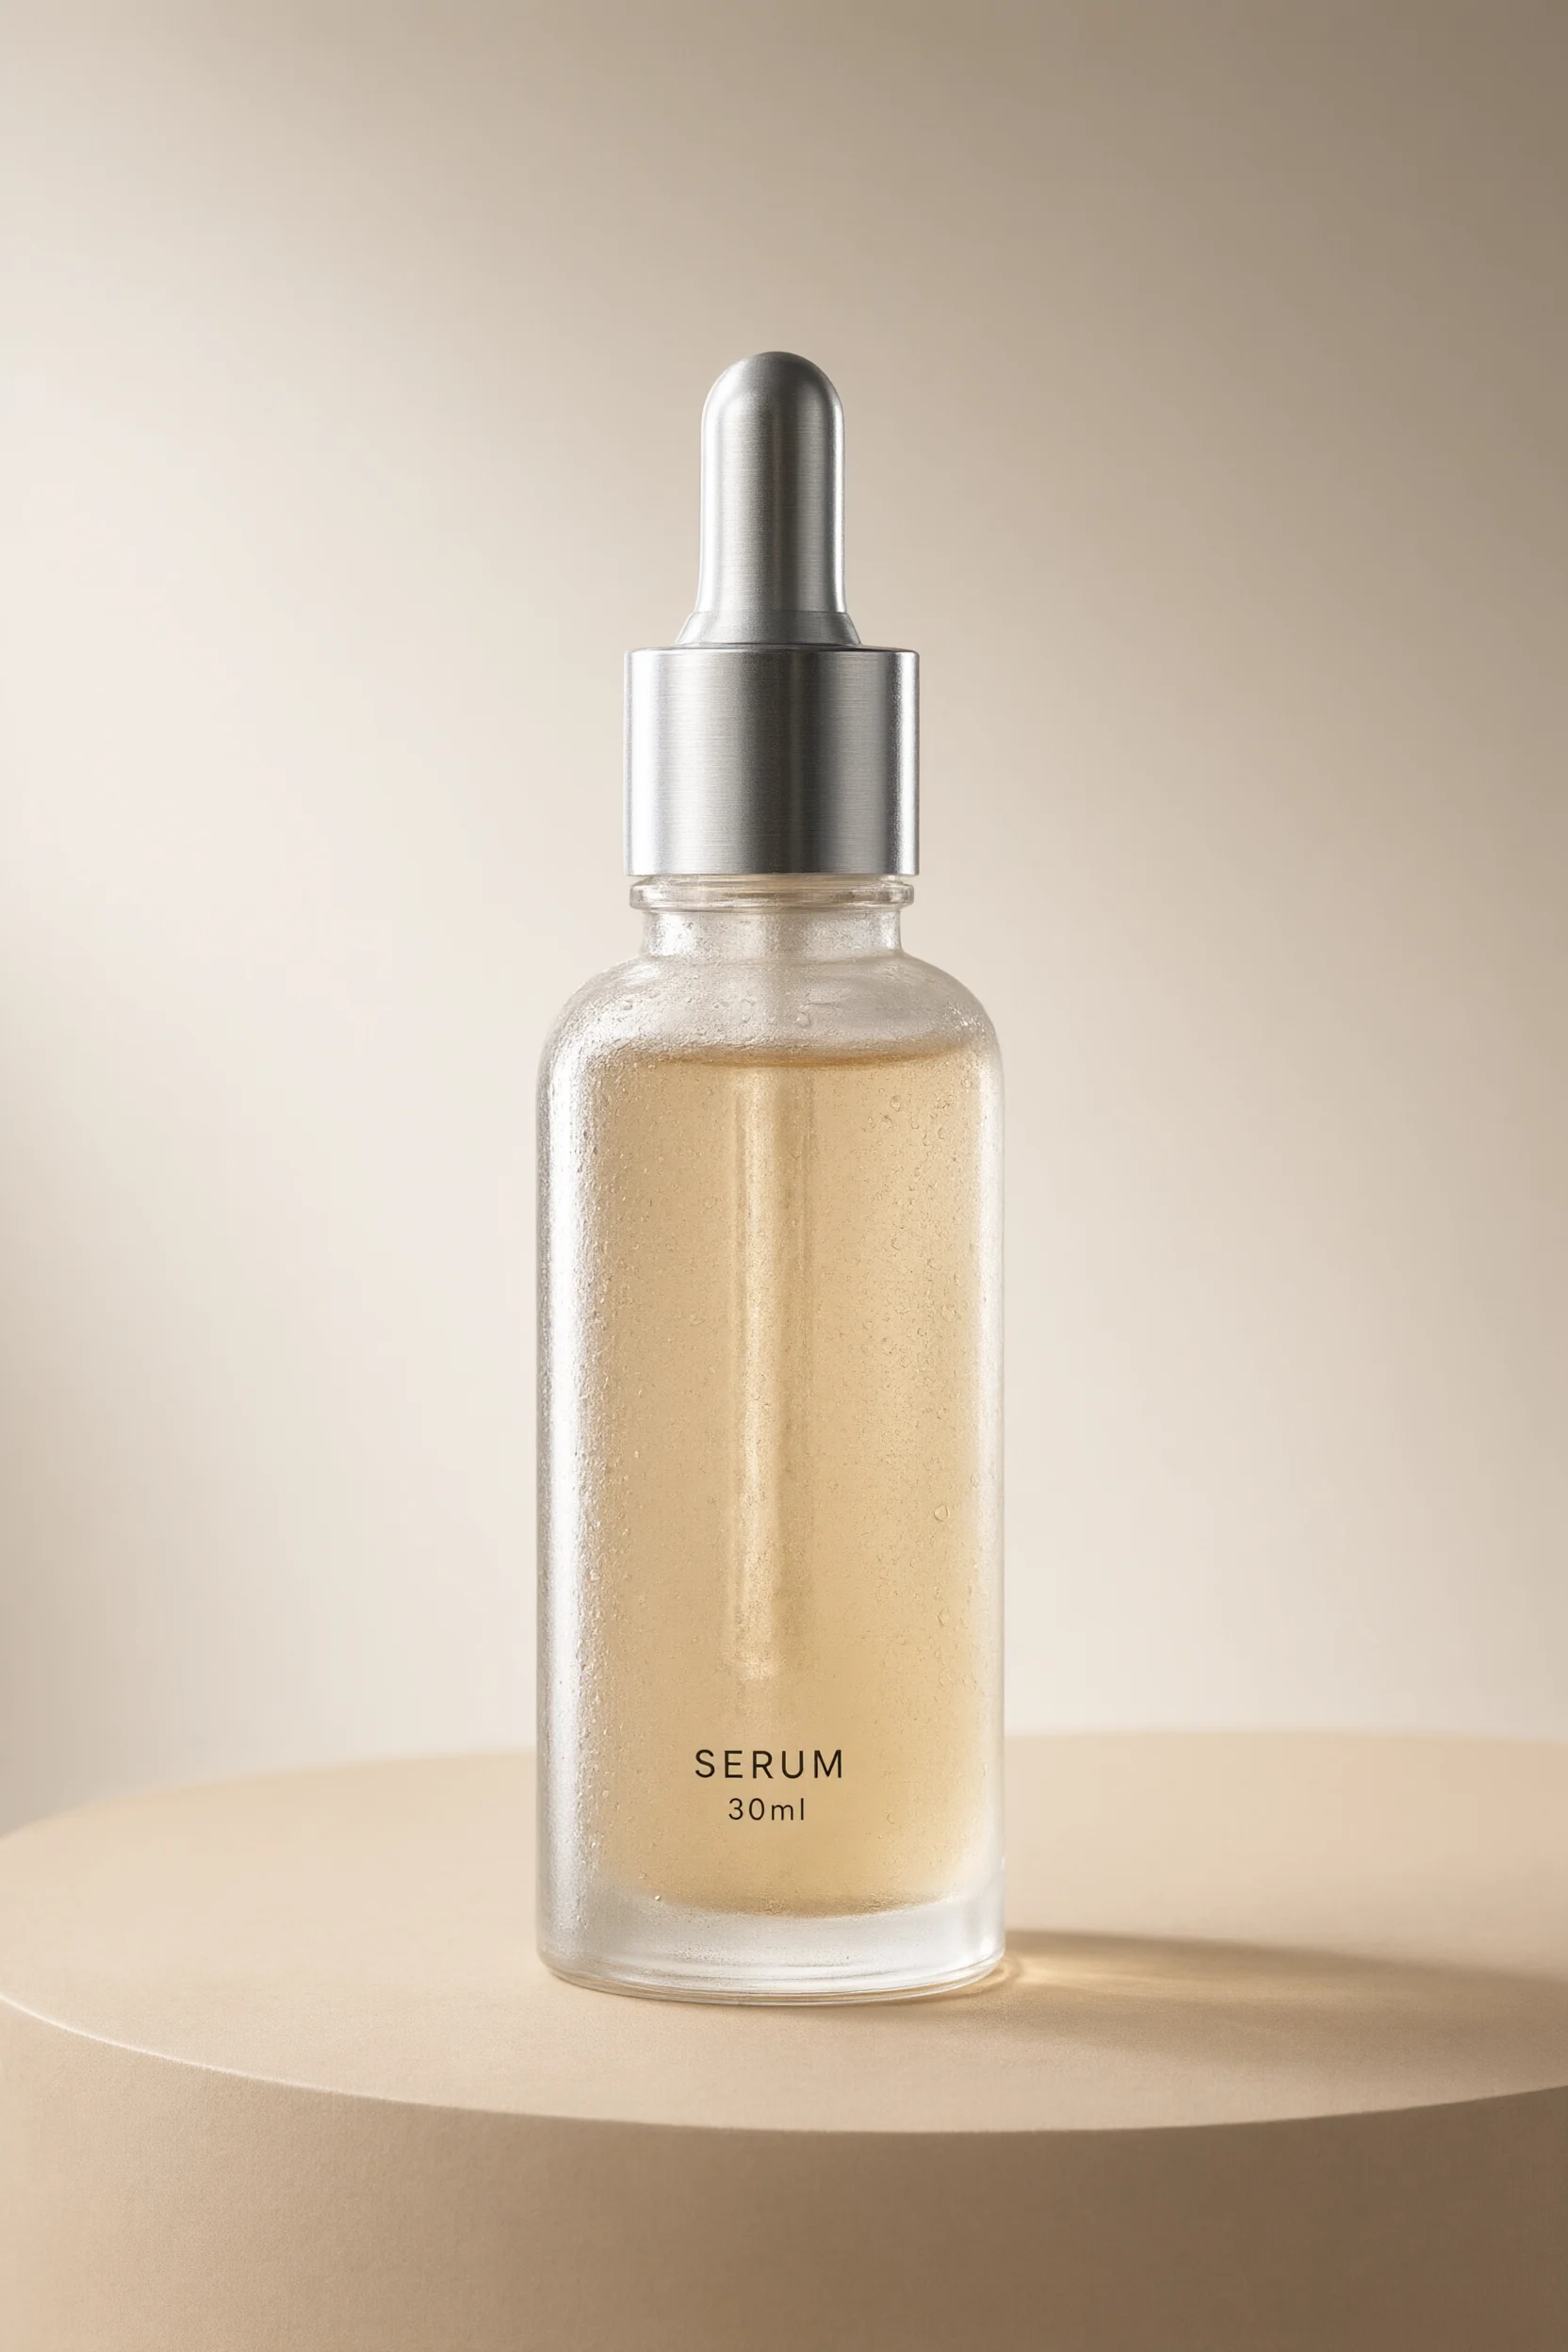
Produktfotografie in E-Commerce-Qualität: Beispiele für die Bilderzeugung mit Qwen-Image-3.0
Stil Produktbild · ecommerce · Studiobeleuchtung
Prompt
Studio-Produktfotografie einer einzelnen Flasche Hautpflegeserum aus mattiertem Glas, mit Tropferkappe aus gebürstetem Aluminium, mittig platziert auf einer matten, warmbeigen Präsentationsfläche, Hintergrund als weicher Verlauf von Creme bis zu hellem Graubraun. Dreipunkt-Studiobeleuchtung: Eine große Softbox oben links erzeugt einen sauberen, schlanken Glanzstreifen am linken Glasrand, rechts ergänzt ein feines Konturlicht die Silhouette, sanftes Aufhelllicht bewahrt die Schattendetails. Auf der Glasoberfläche sind feine Kondenswassertröpfchen sichtbar, die Flüssigkeit hat einen feinen Bernsteinton, der Flaschenboden zeigt realistische Glasdicke und Brechungseffekte. Auf der Flasche klebt ein minimalistisches kleines Etikett mit der Aufschrift "SERUM 30ml" in einer schlichten serifenlosen Schrift, vollkommen waagerecht und klar lesbar. Geringe Schärfentiefe, Anmutung eines 85-mm-Makroobjektivs, weiche Unschärfe zum Hintergrund hin, keine störenden Gegenstände, rechts großzügiger Negativraum zum Einblenden von Text. Kommerzielle E-Commerce-Katalogqualität, Verschlusskappe und Flaschenschulter scharf fokussiert, neutrale Farbabstimmung, materialgetreue Wiedergabe, fotorealistisches Rendering.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
qwen-image-3.0/text-to-image per image
| Einzelpreis | $0.0358 |
|---|
Positionierung und Kurzprofil
Der Text-zu-Bild-Pfad von qwen-image-3.0 ist das Bildgenerierungsmodell der dritten Generation aus der Qwen-Reihe von Alibaba und richtet sich an Entwicklungs-Szenarien, in denen Bilder echte Informationen tragen sollen. Es akzeptiert Prompts mit bis zu 18000 Zeichen und ist besonders gut darin, informationsdichte Kompositionen mit Text zu erzeugen, etwa Infografiken, Zeitungslayouts, UI-Konzeptentwürfe und Produktraster. Unterstützt werden zwei Auflösungsstufen (1K/2K), acht Seitenverhältnisse, PNG-/JPEG-Ausgabe sowie zufällige Seeds – damit eignet es sich als Produktivitätswerkzeug für Designmaterialien, Interface-Prototypen und Marketing-Assets.
Zentrale Highlights
- Lange Prompts für komplexe Layouts – Das Prompt-Limit von 18000 Zeichen erlaubt es, mit einer einzigen Beschreibung gleichzeitig Mehrblock-Layouts, Elemente und Textinhalte festzulegen.
- Satz und Text für informationsorientierte Visuals – Gezielt optimiert für dichte Typografie, kleine Schriftgrade und mehrsprachiges Rendering, sodass erzeugte Layouts und Interface-Entwürfe näher an direkt nutzbaren Assets liegen.
- Kontrollierbare Ausgabespezifikationen – Auflösung, Seitenverhältnis, Dateiformat und zufälliger Seed lassen sich vorgeben; zusammen mit Negativ-Prompt und automatischer Prompt-Optimierung eignen sie sich für die Batch-Erzeugung stilistisch konsistenter Bilder.
Funktionsbeschreibung
Komplexe Bildgenerierung auf Basis langer Texte: Ein einzelner Prompt kann bis zu 18000 Zeichen umfassen; mit einer ausführlichen Beschreibung lassen sich Komposition, Stil und Informationsebenen festlegen, was die Kosten für mehrfaches Nachbessern von Prompts reduziert.
Textdichte Layouts und Interface-Entwürfe: Geeignet für Bilder, in denen Elemente und Text nebeneinanderstehen, etwa Infografiken, Zeitungslayouts, Poster und UI-Konzeptbilder – die Ergebnisse liegen näher an realen Arbeitsmaterialien als an rein ästhetischen Bildern.
Präzise steuerbare Ausgabespezifikationen: Wählbar sind 1K- oder 2K-Auflösung, insgesamt acht Seitenverhältnisse von 1:1 bis 21:9, PNG- oder JPEG-Format; über den zufälligen Seed lassen sich Ergebnisse reproduzieren oder feinjustieren.
Prompt-Anreicherung und negative Vorgaben: prompt_extend ist standardmäßig aktiv und ergänzt bzw. optimiert den Prompt automatisch; negative_prompt dient zum Ausschließen unerwünschter Elemente und erhöht die Kontrollierbarkeit der Bildausgabe.
Anwendungsfälle
- Layout-Assets für Design- und Content-Teams – Texte und Layoutbeschreibungen für Infografiken, Zeitungsseiten oder Poster eingeben und Bilder erhalten, die direkt als Layoutreferenz oder als Bebilderung für Veröffentlichungen dienen können.
- UI-Konzeptentwürfe für Produkt- und Frontend-Teams – Mit Prompts die Struktur von Web-, Spiel- oder Livestream-Oberflächen beschreiben und Konzeptbilder für High-Fidelity-Prototypen-Diskussionen und Design-Reviews erzeugen.
- Produkt- und Marketingbilder für den E-Commerce – Produktinformationen und Darstellungsanforderungen als Eingabe nutzen und Produktrasterbilder sowie Marketing-Assets als Entwürfe für Detail- und Aktionsseiten erzeugen.
- Bebilderung für Bildung und Dokumentation – Ausgehend von erklärenden Inhalten Materialien mit gemischtem Text-Bild-Layout oder Dokumentationsbilder erzeugen, als visuelle Ergänzung für Kursunterlagen, Erklärseiten und interne Dokumente.
Einschränkungen und Auswahlhinweise
Dieser Pfad unterstützt ausschließlich Text-zu-Bild; für die Bearbeitung von Bildern anhand von Referenzbildern muss auf den Bild-zu-Bild-Pfad derselben Familie ausgewichen werden. Die Angaben zu den Modellfähigkeiten stammen überwiegend aus Herstellerankündigungen und Third-Party-Präsentationsseiten; unabhängige öffentliche Benchmark-Evaluierungen fehlen, daher empfiehlt sich vor dem Produktivbetrieb eine Validierung mit kleinen Stichproben anhand eigener Geschäfts-Prompts. Lange Prompts und dichte Textlayouts stellen hohe Anforderungen an die Beschreibungspräzision; die Bildqualität hängt von Typografiedichte und Sprache ab, weshalb sich die Kombination aus zufälligem Seed und mehrfacher Generierung zur Ergebnisauswahl anbietet. Wer lediglich übliche ästhetische Bebilderung benötigt, kann zur Kostenkontrolle ein leichteres Text-zu-Bild-Modell einsetzen.
Neuigkeiten
Changelog ansehen →- Neues Modell Neues Modell verfügbar: qwen-image-3.0-pro/text-to-image
- Neues Modell qwen-image-3.0-pro Bild-zu-Bild-Modell ist verfügbar
- Neues Modell Neu: qwen-image-3.0/text-to-image…
Häufige Fragen
Alle Fragen ansehen →-
Wie viele Referenzbilder unterstützt die Bildbearbeitung mit Qwen Image 3.0?
Unterstützt 1 bis 3 Referenzbilder. Mindestens eines ist erforderlich, das API-Feld lautet input.image_urls.
-
Was ist der Unterschied zwischen der Standardversion und der Pro-Bildbearbeitung?
Die Standardversion legt den Schwerpunkt auf geringere Kosten und schnelle Iterationen; Pro eignet sich besser für präzisen Textaustausch, komplexe Materialien und das finale Layout.
-
Wie werden 1K, 2K und Referenzbilder abgerechnet?
1K und 2K verwenden dieselbe Ausgabestufe; für jedes Referenzbild wird ein zusätzlicher Aufpreis berechnet. Die genauen Beträge richten sich nach dem tagesaktuellen Preis auf dieser Seite.
-
Wie lassen sich Drift von Motiv, Layout oder Text reduzieren?
Liste im Prompt getrennt auf, welche Inhalte geändert werden sollen und welche Motive, Texte, Positionen, Materialien, Kamerawinkel und Lichtverhältnisse beibehalten werden müssen; wenn exakter Text benötigt wird, schreibe den Zieltext in Anführungszeichen.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: qwen-image-3.0/text-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für qwen-image-3.0/text-to-image und Route default — siehe Parametertabelle unten.
seedintegerOptionalmin 0max 2147483647Zufälliger Startwert zur Steuerung der Zufälligkeit der Generierungsergebnisse; als Ganzzahl angeben. Bei gleichem Startwert und ansonsten identischen Parametern lassen sich ähnliche Ergebnisse reproduzieren; wird er nicht übergeben, generiert der Server ihn zufällig.
promptstringPflichtminLength 1maxLength 18000Positiver Prompt, beschreibt in Textform Inhalt, Stil und Bildkomposition des gewünschten Bildes und ist die Haupteingabe für die Text-zu-Bild-Generierung.
resolutionstringOptionalStandard: "1K"Ausgabauflösungsstufe, gibt als Zeichenkette die Klarheitsstufe des generierten Bildes an, Standard 1K.
1K2Kaspect_ratiostringOptionalStandard: "1:1"Seitenverhältnis (Breite zu Höhe) des Ausgabebildes, als Verhältnis-Zeichenkette angegeben, Standard 1:1.
1:13:22:34:33:416:99:1621:9output_formatstringOptionalStandard: "png"Dateiformat des generierten Bildes, als Zeichenkette angegeben, Standard png.
pngjpegprompt_extendbooleanOptionalStandard: trueGibt an, ob der Prompt automatisch optimiert werden soll, boolescher Wert; bei Aktivierung erweitert und verstärkt der Server den Prompt, Standard true.
negative_promptstringOptionalStandard: ""maxLength 500Negativer Prompt, beschreibt Inhalte, die nicht im Bild erscheinen sollen; die Standard-Zeichenkette ist leer, was bedeutet, dass keine Ausschlussbeschränkung angewendet wird.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-3.0/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-3.0/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Krea 2 Medium Turbo Krea $0.021 /Bild
-
 FASHN Tryon v1.6 FASHN $0.107 /Bild
-
 BRIA Eraser Bria $0.058 /Bild
-
 Recraft Creative Upscale Recraft $0.357 /Bild
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /Bild
-
 Qwen Image 2.1 Alibaba $0.020 /Bild
-
 Ideogram V3 Character Ideogram $0.090 /Bild
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /Bild
-
 Recraft Crisp Upscale Recraft $0.004 /Bild
-
 GPT Image 2.5 OpenAI $0.017 /Bild
-
 Wan 2.7 Image Alibaba $0.035 /Bild
-
 Ideogram V4.5 Ideogram $0.011 /Bild
Gleicher Anbieter
-
 Wan 2.7 Video Alibaba $0.100 /Sekunde
-
 Wan 2.6 Flash Alibaba $0.043 /Sekunde
-
 Qwen Image 2.0 Alibaba $0.042 /Bild
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 Zeichen
- Qwen Image 2.1 Alibaba $0.020 /Bild
-
 HappyHorse 1.1 Alibaba $0.160 /Sekunde
-
 HappyHorse 1.0 Alibaba $0.168 /Sekunde
-
 Z-Image Alibaba $0.008 /Bild
-
 Wan 3.0 Video Alibaba $0.040 /Sekunde
- Wan 2.7 Image Alibaba $0.035 /Bild
-
 Qwen Image 3.0 Alibaba $0.036 /Bild