
Guide d'utilisation
Tarifs de l'API Claude Opus 5.5 : la moitié du tarif standard officiel, calculé clairement par tâche
Prix par million de tokens, coût de quatre types de tâches courantes, impact du cache et de l'effort sur la facture, et comment l'appeler.
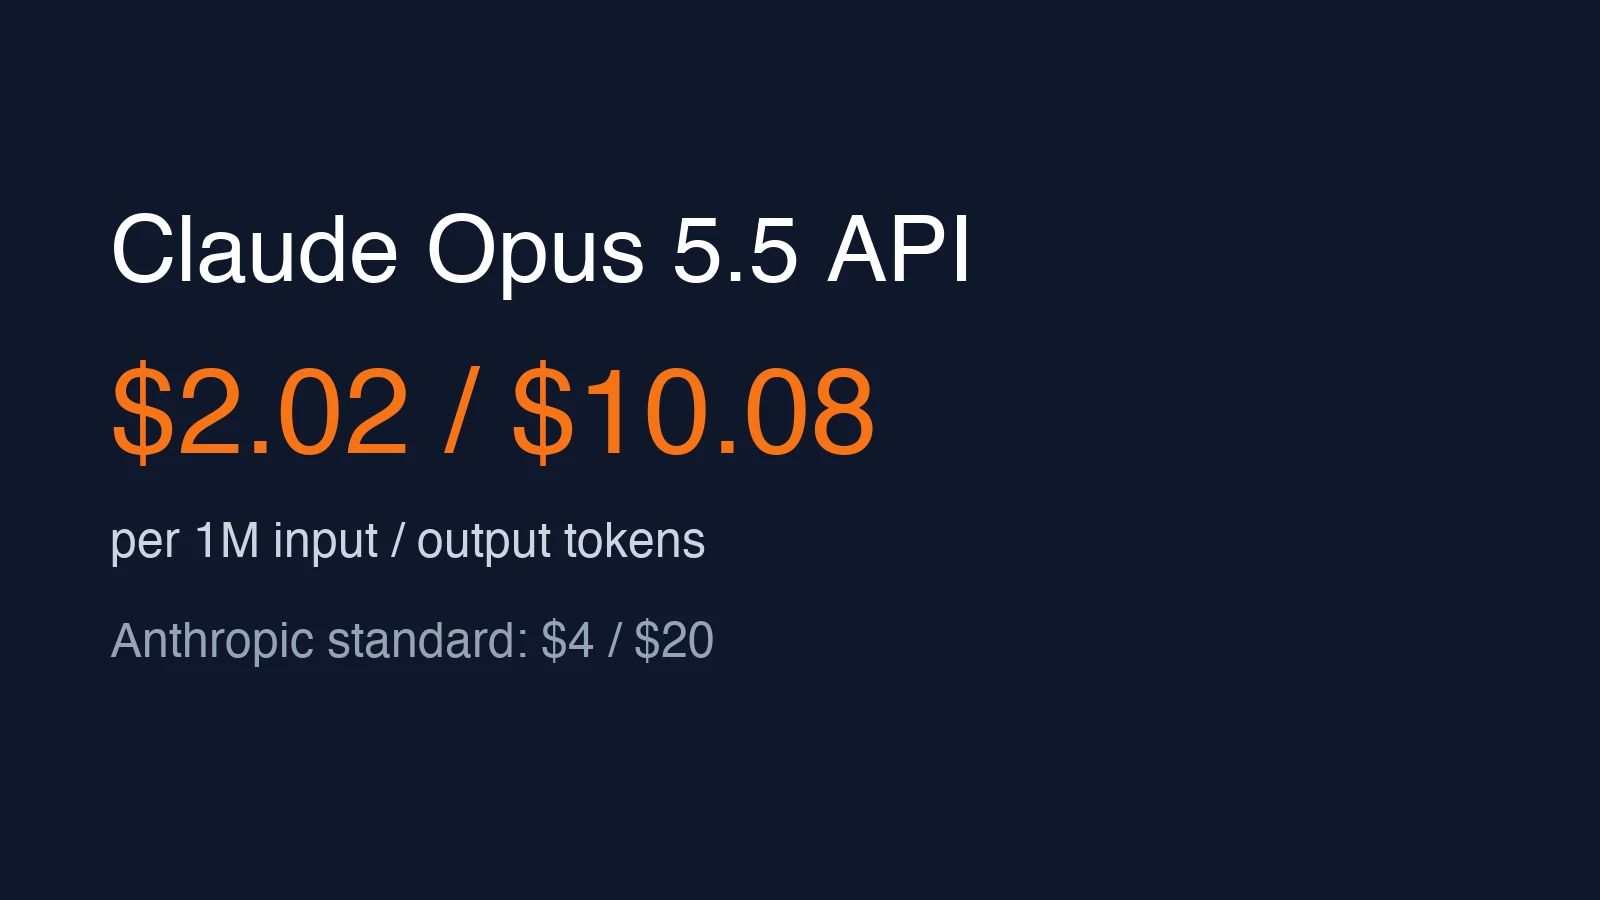
Le prix de Claude Opus 5.5 sur HiAPI est de 2,02 $ par million de tokens d'entrée et 10,08 $ par million de tokens de sortie, soit la moitié du tarif standard officiel d'Anthropic (4 $ / 20 $). Le modèle est également claude-opus-5-5, avec également un contexte de 1M de tokens et jusqu'à 128K tokens de sortie, appelé via une interface compatible OpenAI.
| Claude Opus 5.5, par million de tokens | Tarif standard officiel Anthropic | HiAPI |
|---|---|---|
| Entrée | $4.00 | $2.02 |
| Sortie (réflexion incluse) | $20.00 | $10.08 |
| Écriture de cache 5 minutes | $5.00 | $2.52 |
| Lecture de cache | $0.20 | $0.10 |
| Contexte / sortie maximale | 1M / 128K | 1M / 128K |
Les tarifs officiels proviennent de la page de tarification d'Anthropic, les prix HiAPI proviennent du barème en temps réel de HiAPI, tous deux vérifiés le 6 octobre 2026.
Combien coûte une tâche
Le calcul par token n'est pas intuitif ; voici le coût calculé pour quatre types de tâches courantes. Les nombres de tokens correspondent à des tailles typiques pour chaque type de tâche ; votre consommation réelle variera, mais le rapport de prix entre les deux restera inchangé.
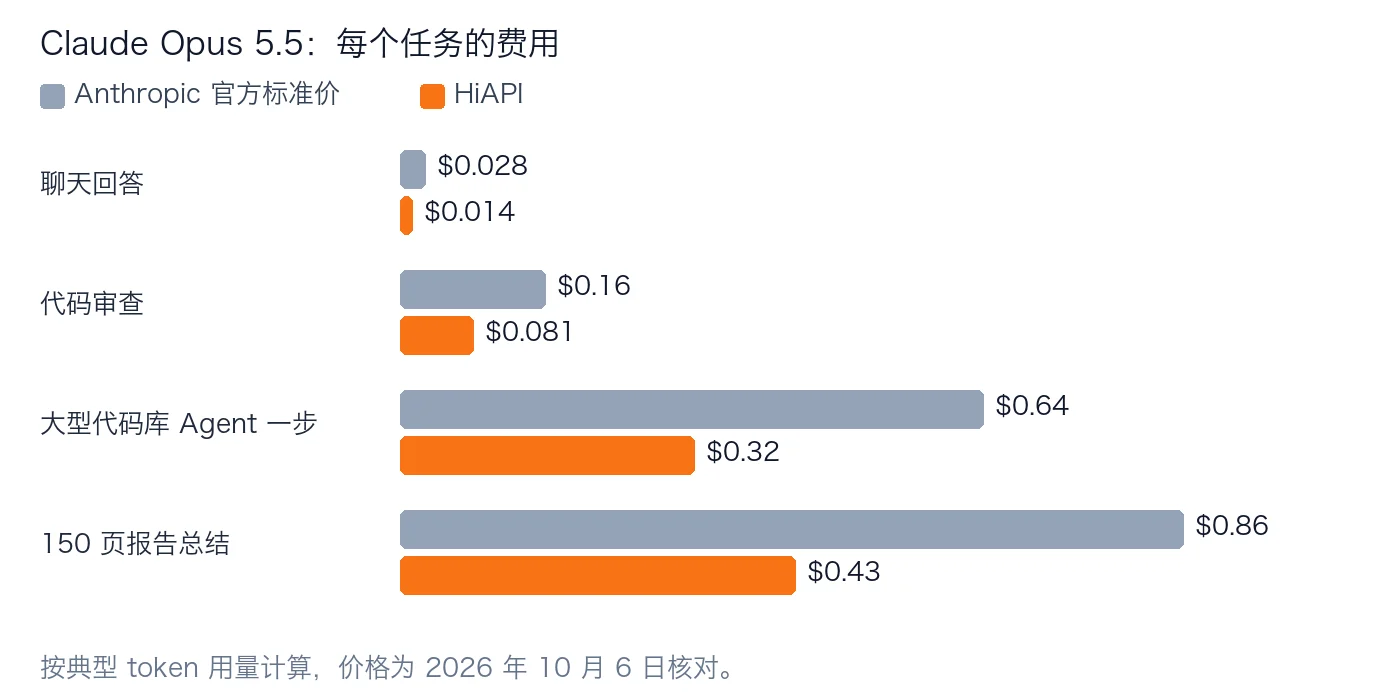
| Tâche | Tokens d'entrée | Tokens de sortie | Tarif standard officiel Anthropic | HiAPI |
|---|---|---|---|---|
| Réponse de chat | 2,000 | 1,000 | $0.028 | $0.014 |
| Revue de code (une PR) | 20,000 | 4,000 | $0.160 | $0.081 |
| Une étape d'Agent dans une grande base de code | 120,000 | 8,000 | $0.640 | $0.323 |
| Résumé d'un rapport de 150 pages | 200,000 | 3,000 | $0.860 | $0.434 |
Le calcul pour chaque ligne est : tokens d'entrée × prix unitaire d'entrée + tokens de sortie × prix unitaire de sortie. Si vous révisez 1 000 PR par mois, le tarif standard officiel est de 160 $, et HiAPI de 80,72 $.
Deux choses coûtent plus cher que la plupart des gens ne le pensent :
- La réflexion est aussi facturée comme sortie. Opus 5.5 réfléchit avant chaque réponse, et ces tokens de réflexion sont facturés au prix de sortie. Plus
effortest élevé, plus il réfléchit, et plus il y a de tokens de sortie. - Pour les longs documents, l'argent part dans l'entrée. Le résumé d'un rapport de 150 pages ne produit que 3 000 tokens, mais rien que la lecture de 200 000 tokens en fait la tâche la plus chère du tableau.
Ce que vous obtenez pour cet argent : un exemple de revue
Voici la réponse que vous obtenez en payant. Nous donnons à Claude Opus 5.5 une courte fonction de paiement et lui demandons une revue de code :
def apply_discount(cart, code):
    discounts = {"SAVE10": 0.10, "SAVE20": 0.20}
    rate = discounts.get(code.upper())
    total = sum(item["price"] * item["qty"] for item in cart)
    if rate:
        total = total - total * rate
    return round(total, 2)
Avis de revue de Claude Opus 5.5 :
code.upper()plante si aucun code de réduction n'est fourni. SicodevautNone, cela lève uneAttributeError; remplacez par(code or "").strip().upper().- Les montants utilisent des nombres flottants. Avec beaucoup d'articles, l'erreur d'arrondi de
price * qtypeut décaler d'un centime, etround()applique un arrondi bancaire. Stockez les prix en entiers de « centimes », ou utilisezDecimal. - Les codes de réduction invalides sont silencieusement ignorés. Une faute de frappe comme
SAVE01fait payer le prix plein sans aucun avertissement. Il faudrait renvoyer ou lever un résultat que la page de paiement peut afficher à l'utilisateur. - La table des réductions est codée en dur. Deux codes, ça va, mais avant que l'équipe marketing en ajoute un troisième, déplacez-la dans la configuration.
Pour une telle revue, le contenu visible fait quelques centaines de tokens ; avec la réflexion, on se situe entre la « réponse de chat » et la « revue de code » du tableau ci-dessus : sur HiAPI, entre 1 et 8 cents.
Économisez encore avec le cache
Si de nombreuses requêtes partagent le même long préfixe, par exemple un prompt système, des consignes de style ou un résumé de base de code, mettez-le en cache. La lecture du cache Opus 5.5 ne coûte que 5 % du prix normal d'entrée.
Par exemple : un prompt système de 30 000 tokens réutilisé par 100 requêtes, chaque requête ayant par ailleurs 1 000 nouveaux tokens d'entrée et 1 000 tokens de sortie :
| 100 requêtes | Tarif standard officiel Anthropic | HiAPI |
|---|---|---|
| Sans cache | $14.40 | $7.27 |
| Avec cache 5 minutes | $3.14 | $1.58 |
Sur HiAPI, il suffit d'ajouter cache_control au message system. L'écriture de cache 5 minutes est actuellement prise en charge ; l'écriture de cache 1 heure n'est pas encore disponible.
{
  "model": "claude-opus-5-5",
  "messages": [
    {
      "role": "system",
      "content": [
        {
          "type": "text",
          "text": "Answer as a concise architecture reviewer. ...",
          "cache_control": {"type": "ephemeral", "ttl": "5m"}
        }
      ]
    },
    {"role": "user", "content": "Review this design: ..."}
  ],
  "output_config": {"effort": "medium"}
}
Le champ usage renvoyé à chaque fois indique combien de tokens de cache ont été écrits ou lus.
Contrôlez les coûts avec effort
La réflexion d'Opus 5.5 ne peut pas être désactivée, mais output_config.effort permet de décider combien il réfléchit : low, medium (par défaut), high, xhigh, max. Plus l'effort est élevé, plus il y a de tokens de réflexion, facturés au prix de sortie.
- Utilisez
lowpour la classification, l'extraction d'informations et la réécriture de textes courts. - Pour la plupart des tâches de codage et de rédaction, gardez
medium. - Pour le débogage difficile, les longs plans et les tâches d'Agent à plusieurs étapes, utilisez
highou plus. - Utilisez
max_tokenspour fixer une limite stricte, qui limite à la fois la réflexion et la réponse visible.
Appeler sur HiAPI
HiAPI fournit Opus 5.5 via POST https://api.hiapi.ai/v1/chat/completions, c'est-à-dire au format OpenAI Chat Completions. Le code existant utilisant le SDK OpenAI fonctionne en changeant simplement l'URL de base, la clé et le nom du modèle :
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key="YOUR_HIAPI_KEY")

reply = client.chat.completions.create(
    model="claude-opus-5-5",
    messages=[{"role": "user", "content": "Review this function for bugs: ..."}],
    extra_body={"output_config": {"effort": "medium"}},
    max_tokens=4096,
)
print(reply.choices[0].message.content)
print(reply.usage)
Avant de basculer, il faut connaître quelques différences avec l'API officielle Anthropic :
- Paramètres de réflexion : ne transmettez pas
thinkingni de budget de réflexion, utilisez uniquementoutput_config.effort. - Appels d'outils : utilisez
tool_choice: "auto"; forcer un outil spécifique provoquera une erreur. - Cache : seule l'écriture de cache 5 minutes est prise en charge.
- Batch API et fast mode : ces deux fonctionnalités sont exclusives à Anthropic officiel. La Batch API officielle est aussi à 50 % de réduction ($2 / $10), mais les résultats sont renvoyés de manière asynchrone : la plupart des lots se terminent en moins d'une heure, mais cela peut prendre jusqu'à 24 heures ; le prix HiAPI est celui des requêtes temps réel normales.
Pour un exemple curl, la sortie en streaming et la gestion des erreurs, voir Démarrage rapide avec l'API Claude Opus 5.5 (en anglais). Pour essayer d'abord un prompt dans le navigateur, ouvrez la page du modèle Claude Opus 5.5.
Questions fréquentes
Combien coûte l'API Claude Opus 5.5 ?
Le tarif standard officiel d'Anthropic est de 4 $ par million de tokens d'entrée et 20 $ par million de tokens de sortie. Sur HiAPI, c'est 2,02 $ et 10,08 $, soit la moitié du tarif standard officiel.
Claude Opus 5.5 est-il moins cher qu'Opus 5 ?
Oui, moins cher. Anthropic a réduit le prix de 5 $ / 25 $ pour Opus 5 à 4 $ / 20 $ pour Opus 5.5, et la lecture de cache est passée de 0,50 $ à 0,20 $. Sur HiAPI, Opus 5.5 est à 2,02 $ / 10,08 $.
Les tokens de réflexion sont-ils facturés ?
Oui, au prix des tokens de sortie. Opus 5.5 réfléchit toujours ; baisser effort permet de réduire les tokens de réflexion.
Quel est l'ID du modèle Claude Opus 5.5 ?
claude-opus-5-5, identique pour l'API officielle Anthropic et HiAPI.
Quelle est la taille du contexte de Claude Opus 5.5 ?
1 million de tokens en entrée et jusqu'à 128 000 tokens en sortie. Les entrées longues et courtes sont facturées au même prix unitaire.
Peut-on désactiver la réflexion de Claude Opus 5.5 ?
Non, la réflexion est toujours activée. Pour qu'il réfléchisse le moins possible, utilisez output_config.effort: "low".
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax