
Guia de uso
Preço da API do Claude Opus 5.5: metade do preço padrão oficial, calculado por tarefa
Preço por milhão de tokens, quanto custam quatro tipos comuns de tarefa, como o cache e o effort afetam a fatura, e como chamar.
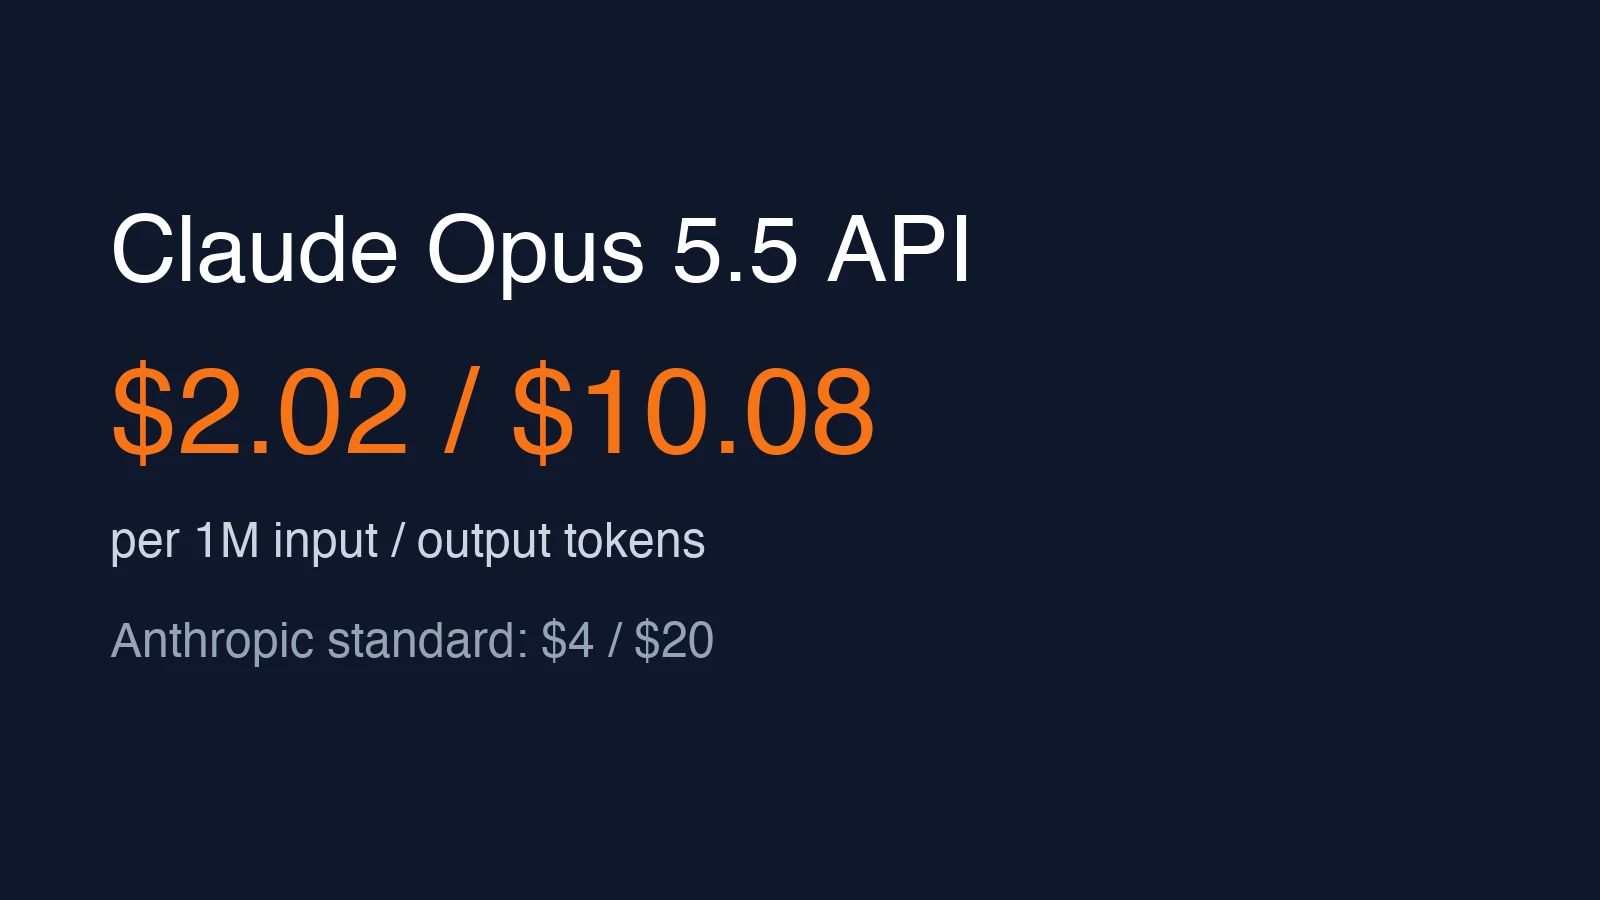
O preço do Claude Opus 5.5 na HiAPI é $2.02 por milhão de tokens de entrada e $10.08 por milhão de tokens de saída, metade do preço padrão oficial da Anthropic ($4 / $20). O modelo também é claude-opus-5-5, também com contexto de 1M tokens e saída de até 128K tokens, chamado por meio da interface compatível com OpenAI.
| Claude Opus 5.5, por milhão de tokens | Preço padrão oficial da Anthropic | HiAPI |
|---|---|---|
| Entrada | $4.00 | $2.02 |
| Saída (incluindo raciocínio) | $20.00 | $10.08 |
| Gravação de cache de 5 minutos | $5.00 | $2.52 |
| Leitura de cache | $0.20 | $0.10 |
| Contexto / saída máxima | 1M / 128K | 1M / 128K |
Os preços oficiais vêm da página de preços da Anthropic, e os preços da HiAPI vêm da tabela de preços em tempo real da HiAPI, ambos verificados em 6 de outubro de 2026.
Quanto custa uma tarefa
Cobrar por token não é intuitivo, então abaixo calculamos o custo de quatro tipos comuns de tarefa. As contagens de tokens usam o tamanho típico de cada tipo de tarefa; seu uso real pode variar, mas a proporção de preço entre os dois lados não muda.
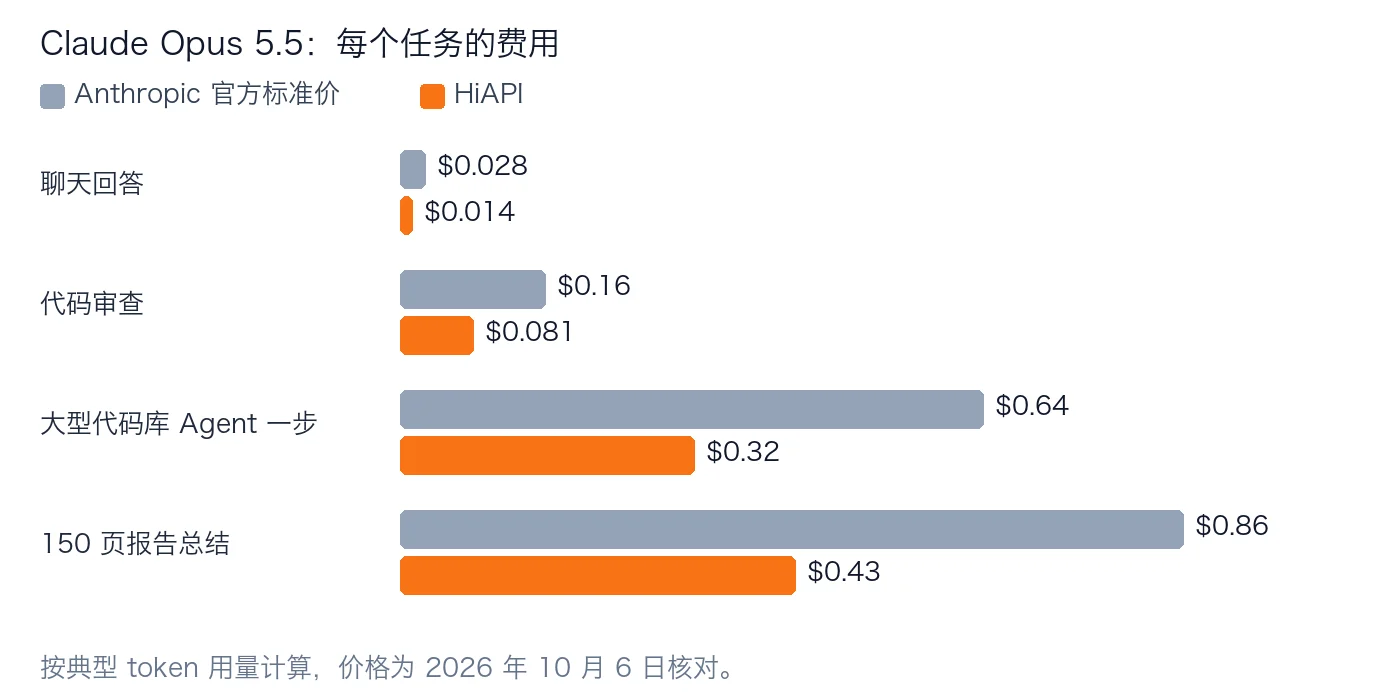
| Tarefa | Tokens de entrada | Tokens de saída | Preço padrão oficial da Anthropic | HiAPI |
|---|---|---|---|---|
| Resposta de chat | 2,000 | 1,000 | $0.028 | $0.014 |
| Revisão de código (um PR) | 20,000 | 4,000 | $0.160 | $0.081 |
| Um passo de Agent em um grande repositório de código | 120,000 | 8,000 | $0.640 | $0.323 |
| Resumo de relatório de 150 páginas | 200,000 | 3,000 | $0.860 | $0.434 |
O cálculo de cada linha é: tokens de entrada × preço unitário de entrada + tokens de saída × preço unitário de saída. Se você revisar 1.000 PRs por mês, o preço padrão oficial é $160 e a HiAPI é $80.72.
Duas coisas custam mais caro do que a maioria das pessoas imagina:
- O raciocínio também é cobrado como saída. O Opus 5.5 raciocina antes de cada resposta, e esses tokens de raciocínio são cobrados pelo preço de saída. Quanto mais alto o
effort, mais raciocínio e mais tokens de saída. - Documentos longos gastam o dinheiro na entrada. O resumo de um relatório de 150 páginas escreve apenas 3.000 tokens, mas só ler 200.000 tokens já o torna a tarefa mais cara da tabela.
O que esse dinheiro compra: um exemplo de revisão
Abaixo está a resposta que você recebe pelo que paga. Damos ao Claude Opus 5.5 uma função curta de checkout e pedimos uma revisão de código:
def apply_discount(cart, code):
    discounts = {"SAVE10": 0.10, "SAVE20": 0.20}
    rate = discounts.get(code.upper())
    total = sum(item["price"] * item["qty"] for item in cart)
    if rate:
        total = total - total * rate
    return round(total, 2)
Os comentários de revisão do Claude Opus 5.5:
code.upper()quebra quando nenhum código de desconto é informado. QuandocodeéNone, lançaAttributeError; altere para(code or "").strip().upper().- Os valores usam ponto flutuante. Com muitos itens, o erro de ponto flutuante de
price * qtypode gerar diferença de um centavo, eround()ainda usa arredondamento bancário. Armazene preços como inteiros em "centavos" ou useDecimal. - Códigos de desconto inválidos são ignorados silenciosamente. Digitar errado como
SAVE01faz o checkout cobrar o preço cheio, sem nenhum aviso. Deveria retornar ou lançar um resultado que a página de checkout possa mostrar ao usuário. - A tabela de descontos está fixa no código. Dois códigos ainda vão bem, mas antes que o time de operações adicione um terceiro, mova para configuração.
Uma revisão assim, com algumas centenas de tokens de conteúdo visível, mais o raciocínio, fica entre "Resposta de chat" e "Revisão de código" na tabela acima: de 1 a 8 centavos de dólar na HiAPI.
Economize mais com cache
Se muitas requisições compartilham o mesmo prefixo longo, como prompt de sistema, guia de estilo ou resumo do repositório de código, coloque-o em cache. A leitura de cache do Opus 5.5 custa apenas 5% do preço normal de entrada.
Exemplo: um prompt de sistema de 30.000 tokens reutilizado por 100 requisições, cada uma com mais 1.000 tokens de entrada nova e 1.000 tokens de saída:
| 100 requisições | Preço padrão oficial da Anthropic | HiAPI |
|---|---|---|
| Sem cache | $14.40 | $7.27 |
| Com cache de 5 minutos | $3.14 | $1.58 |
Na HiAPI, basta adicionar cache_control à mensagem system. Atualmente há suporte a gravação de cache de 5 minutos; a gravação de cache de 1 hora ainda não está disponível.
{
  "model": "claude-opus-5-5",
  "messages": [
    {
      "role": "system",
      "content": [
        {
          "type": "text",
          "text": "Answer as a concise architecture reviewer. ...",
          "cache_control": {"type": "ephemeral", "ttl": "5m"}
        }
      ]
    },
    {"role": "user", "content": "Review this design: ..."}
  ],
  "output_config": {"effort": "medium"}
}
O campo usage retornado em cada chamada mostra quantos tokens de cache foram gravados ou lidos.
Controle o custo com effort
O raciocínio do Opus 5.5 não pode ser desativado, mas você pode usar output_config.effort para decidir quanto ele raciocina: low, medium (padrão), high, xhigh, max. Quanto maior o effort, mais tokens de raciocínio, cobrados pelo preço de saída.
- Use
lowpara classificação, extração de informações e reescrita de textos curtos. - Mantenha
mediumpara a maioria da codificação e escrita. - Use
highou acima para depuração difícil, planos longos e tarefas de Agent com várias etapas. - Use
max_tokenspara definir um limite rígido, que também limita o raciocínio e a resposta visível.
Chamar na HiAPI
A HiAPI oferece o Opus 5.5 via POST https://api.hiapi.ai/v1/chat/completions, ou seja, no formato OpenAI Chat Completions. O código existente com o SDK da OpenAI funciona bastando trocar a base URL, a Key e o nome do modelo:
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key="YOUR_HIAPI_KEY")

reply = client.chat.completions.create(
    model="claude-opus-5-5",
    messages=[{"role": "user", "content": "Review this function for bugs: ..."}],
    extra_body={"output_config": {"effort": "medium"}},
    max_tokens=4096,
)
print(reply.choices[0].message.content)
print(reply.usage)
Antes de migrar, conheça alguns pontos diferentes da API oficial da Anthropic:
- Parâmetros de raciocínio: não passe
thinkingnem orçamento de raciocínio; use apenasoutput_config.effort. - Chamada de ferramentas: use
tool_choice: "auto"; forçar uma ferramenta específica gera erro. - Cache: há suporte apenas a gravação de cache de 5 minutos.
- Batch API e fast mode: esses dois são recursos exclusivos da Anthropic oficial. A Batch API oficial também tem 50% de desconto ($2 / $10), mas o resultado é retornado de forma assíncrona: a maioria dos lotes é concluída em até 1 hora, podendo levar até 24 horas; o preço da HiAPI é o de requisições em tempo real normais.
Para exemplos com curl, saída em streaming e tratamento de erros, consulte Início rápido da API do Claude Opus 5.5 (em inglês). Para testar prompts primeiro no navegador, abra a página do modelo Claude Opus 5.5.
Perguntas frequentes
Quanto custa a API do Claude Opus 5.5?
O preço padrão oficial da Anthropic é $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída. Na HiAPI é $2.02 e $10.08, metade do preço padrão oficial.
O Claude Opus 5.5 é mais barato que o Opus 5?
Sim. A Anthropic baixou o preço de $5 / $25 do Opus 5 para $4 / $20 no Opus 5.5, e a leitura de cache também caiu de $0.50 para $0.20. Na HiAPI, o Opus 5.5 é $2.02 / $10.08.
Tokens de raciocínio são cobrados?
Sim, são cobrados como tokens de saída. O Opus 5.5 sempre raciocina; reduzir o effort pode diminuir os tokens de raciocínio.
Qual é o ID do modelo Claude Opus 5.5?
claude-opus-5-5, tanto na API oficial da Anthropic quanto na HiAPI.
Qual é o contexto do Claude Opus 5.5?
Entrada de 1 milhão de tokens, saída de até 128 mil tokens. Entradas longas e curtas são cobradas pelo mesmo preço unitário.
É possível desativar o raciocínio do Claude Opus 5.5?
Não, o raciocínio está sempre ativado. Para que ele raciocine o mínimo, use output_config.effort: "low".
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores