
Guide d'utilisation
GLM 5.3 en pratique pour l'extraction structurée : chaque champ JSON adossé à un extrait du texte source
Extraction de champs en mode objet JSON : valeurs manquantes, citations et validation métier pour bloquer les erreurs avant l'insertion en base

Sur cette page
Pourquoi la sortie structurée a encore besoin d'« extraits du texte source »
Le mode objet JSON (response_format: {"type": "json_object"}) règle la question « la sortie est-elle un objet JSON ? », et non « cette requête réussira forcément, le contenu sera forcément complet, le parsing ne lèvera forcément aucune exception ». La requête peut échouer, le modèle peut refuser de répondre, la sortie peut être tronquée par une limite de longueur, le transfert en flux peut s'interrompre, et le contenu renvoyé peut être incomplet ou malformé ; le client doit gérer ces situations ainsi que les exceptions de parsing de json.loads. Il faut d'abord confirmer que la réponse s'est terminée normalement et que le contenu est complet avant de passer au parsing. Pouvoir parser ne signifie pas pouvoir utiliser : un format correct ne signifie pas des faits corrects. La valeur d'un champ provient-elle réellement du texte source, a-t-elle été complétée par le modèle au passage, et un champ donné relève-t-il d'une « absence dans le texte » ou d'une « valeur vide explicitement écrite » : rien de tout cela n'est couvert par les contraintes de format.
Écrire un modèle de champs dans le prompt revient en substance à fournir au modèle un « formulaire à remplir » plutôt qu'une « liste de preuves ». Quand un champ manque de support dans le texte source, le modèle tend à produire une valeur plausible — c'est le mode de défaillance le plus dangereux dans une tâche d'extraction, car il ne signale aucune erreur et ne fait que polluer silencieusement les données en aval.
Le contrat d'extraction de cet article se compose donc de trois parties : la définition des champs et des types, la citation du texte source associée à chaque valeur, et une modélisation explicite des valeurs manquantes. Ensemble, elles font de la question « d'où vient cette phrase » une partie de la sortie, et non une supposition a posteriori.
Concevoir le contrat d'extraction : champs, types et convention de nullabilité
Le contrat commence par la liste des champs. Supposons que la tâche consiste à extraire des informations structurées d'une description d'offre d'emploi ou de collaboration ; on fige d'abord les champs cibles :
title: chaîne, obligatoirebudget: nombre, nullabledeadline: chaîne (date ISO), nullablecontact: chaîne, nullableskills: tableau de chaînes, peut être un tableau vide
L'essentiel est que « nullable » ne signifie pas « facultatif ». La convention impose que chaque champ figure dans la sortie, avec null ou un tableau vide explicite en cas d'inconnue, sans omission de clé. Omettre une clé empêche l'aval de distinguer « le modèle a jugé le champ vide » de « le modèle n'a pas du tout traité ce champ ».
Il faut aussi resserrer les types à un niveau vérifiable par une machine : budget n'accepte qu'un nombre, pas une chaîne comme "à négocier" ; deadline suit le format YYYY-MM-DD ; skills doit être un tableau de chaînes et non une chaîne unique concaténée par des virgules pour s'en sortir. Plus le type est précis, plus la couche de validation décrite plus loin peut bloquer les problèmes.
Le bloc ci-dessous est la description des champs à écrire dans le prompt, pas des paramètres de requête ; ces derniers ne servent qu'à activer le mode objet JSON.
Veuillez produire un objet JSON contenant exactement les clés suivantes :
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
Toutes les clés doivent être présentes. Mettez null lorsque l'information ne peut pas être déterminée à partir du texte source (tableau vide pour les tableaux) ; ne devinez pas.
Associer un extrait de citation à chaque champ
Donner une valeur sans sa source, c'est renoncer à toute traçabilité. La méthode consiste à transformer chaque champ extractible en structure appariée : la valeur et sa citation sont émises ensemble.
{
  "title": {"value": "stagiaire en analyse de données", "evidence": "recrute 2 stagiaires en analyse de données"},
  "budget": {"value": 300, "evidence": "salaire journalier de 300 yuans"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "envoyez votre CV à hr@example.com"},
  "skills": [
    {"value": "SQL", "evidence": "maîtrise de SQL exigée"},
    {"value": "Python", "evidence": "la connaissance de Python est un plus"}
  ]
}
Quelques points importants. Premièrement, evidence doit être un fragment contigu du texte source, et non une reformulation ou un résumé du modèle — une reformulation prive la citation de sa valeur de comparaison. Deuxièmement, lorsque la valeur vaut null, evidence doit aussi valoir null ; cette contrainte à elle seule permet de contenir une partie des affabulations : si le modèle invente une valeur, il ne peut généralement pas inventer le fragment correspondant, ce qui crée une contradiction de format. Troisièmement, les champs de type tableau fournissent une citation par élément, et non une citation pour l'ensemble du tableau, sinon un élément erroné décrédibilise tout le groupe. Quatrièmement, le fragment de citation doit être aussi court que possible, couvrant uniquement le texte minimal qui soutient la valeur, afin de faciliter ensuite une comparaison par inclusion de chaîne.
Le volume de sortie augmente, mais en échange, tout enregistrement inséré en base peut répondre à la question « sur quelle phrase du texte source repose ce champ ».
Traiter explicitement les valeurs manquantes et l'incertitude
Dans une tâche d'extraction, l'erreur la plus fréquente du modèle n'est pas de mal extraire, mais de « compléter ». Il faut modéliser séparément trois situations au niveau du contrat.
Absence. Le texte source ne contient aucune information pertinente ; le champ vaut null. Cette sémantique doit être distinguée de « valeur égale à une chaîne vide » : une chaîne vide est une valeur extraite, null est une valeur non extraite. C'est en clarifiant la convention en amont que l'aval peut décider de passer ou d'alerter.
Ambiguïté. Le texte source contient une formulation pertinente mais insuffisante pour conclure. Par exemple, il indique seulement « salaire à négocier » : budget doit alors valoir null, et le prompt doit préciser de ne pas convertir une description qualitative en nombre, ni de mapper « à négocier » sur 0.
Candidats multiples. Le texte source contient deux moyens de contact ou deux dates, alors que le contrat n'accepte qu'une valeur unique. Les options possibles sont de faire supporter une liste de candidats par la structure du champ, ou de fixer une priorité dans le prompt (par exemple prendre la première occurrence). Quelle que soit l'option, elle doit figurer dans le contrat, sinon la stratégie d'arbitrage du modèle variera à chaque fois et le résultat sera difficile à reproduire de façon stable.
Ajoutez enfin un filet de sécurité : autoriser le modèle à produire un tableau unresolved listant les informations clés qu'il n'arrive à rattacher à aucun champ. C'est bien plus sûr que de les forcer dans un champ, et cela vous laisse une porte d'observation des modes de défaillance du modèle.
Trois niveaux de validation métier avant l'insertion en base
Le mode objet JSON ne contraint que la forme de la sortie ; le parsing peut encore échouer. La validation s'exécute dans l'ordre : d'abord confirmer l'intégrité de la réponse, puis effectuer la validation structurelle et métier côté client, enfin vérifier les citations ; si un niveau échoue, on ne passe pas au suivant.
Avant le parsing, vérifier : la requête a-t-elle abouti, y a-t-il eu un refus de réponse, la raison de fin indique-t-elle une troncature par longueur, la réponse en flux s'est-elle terminée normalement, le contenu est-il vide. Une fois confirmé que la réponse s'est terminée normalement et que le contenu est complet, exécuter json.loads ; une exception de parsing déclenche directement le traitement d'échec, sans envoyer un contenu tronqué aux validations suivantes. Ce n'est qu'après un parsing réussi que l'on entre dans les trois niveaux de validation ci-dessous.
Premier niveau : types et structure
Les clés sont-elles toutes présentes, les types correspondent-ils, deadline respecte-t-elle le format de date, budget est-il un nombre fini. Ce niveau se traite avec du code ordinaire, à faible coût et avec le meilleur taux d'interception.
Deuxième niveau : énumérations et domaines de valeurs
Écarter les valeurs impossibles métier : montant négatif, date antérieure à aujourd'hui, chaîne vide ou doublon dans skills, longueur de chaîne au-delà de la limite du champ. Si un champ dispose d'un vocabulaire contrôlé (secteur, niveau hiérarchique), effectuer ici une correspondance par liste blanche et prévoir un emplacement pour la normalisation des synonymes.
Troisième niveau : cohérence inter-champs
Un champ valide isolément ne garantit pas la validité de l'enregistrement entier. Les vérifications typiques incluent : lorsque budget n'est pas nul, deadline l'est-elle aussi (dans de nombreux cas métier les deux sont liés), contact contredit-il le type de poste suggéré par skills, et la distribution des champs des enregistrements de même title dans un même lot est-elle anormalement concentrée. C'est le niveau le plus proche de la sémantique métier, et celui pour lequel il faut le plus écrire de tests.
N'oubliez pas la vérification mécanique de evidence : lorsque la valeur n'est pas nulle, evidence doit être non nul et doit pouvoir être retrouvé dans le texte source d'entrée par inclusion de chaîne ou correspondance floue. Un échec de correspondance n'impose pas forcément de rejeter directement, mais doit au moins marquer l'enregistrement comme peu fiable et l'envoyer en file de traitement manuel.
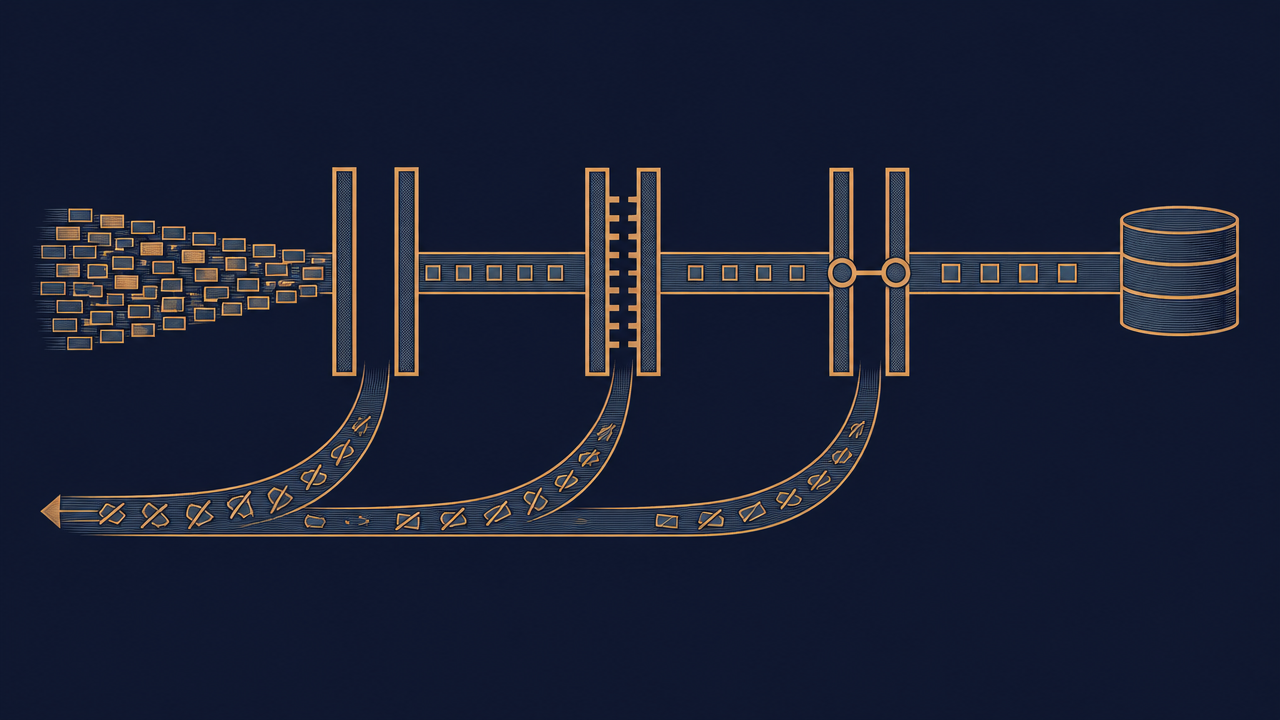
Transformer un échec de validation en prompt du tour suivant
Après un échec de validation, la pire approche est de renvoyer la requête telle quelle en espérant que cette fois l'extraction soit correcte. Il vaut mieux réinjecter les causes d'échec de façon structurée :
La sortie précédente n'a pas passé la validation :
- la valeur de deadline "dès que possible" ne respecte pas le format YYYY-MM-DD
- l'evidence de skills[2] est introuvable dans le texte source
Veuillez corriger uniquement les problèmes ci-dessus, laisser les autres champs inchangés et produire à nouveau le JSON complet.
Trois détails méritent attention. Premièrement, le message d'erreur doit pointer le chemin du champ précis, pour permettre au modèle une correction locale plutôt qu'une reprise intégrale. Deuxièmement, exiger explicitement de « laisser les autres champs inchangés », sinon de nouvelles erreurs apparaissent facilement et l'on obtient une oscillation où corriger un point en casse un autre. Troisièmement, fixer une limite de tentatives (par exemple deux tours) ; au-delà, basculer en file de traitement manuel plutôt que boucler indéfiniment — une relance sans limite allonge la latence et fait grimper les coûts.
Si un même type d'erreur revient lors des relances, le problème vient généralement du contrat, trop vague, et non du modèle. Il faut alors revoir la définition des champs et les exemples, plutôt que d'ajouter encore des instructions au prompt.
Mode d'appel et périmètre de cet article
Sur HiAPI, glm-5.3 s'appelle via le protocole compatible OpenAI Chat Completions ; pour activer le mode objet JSON, on définit response_format avec un type objet dans la requête, les paramètres et noms de champs précis étant ceux de la documentation d'interface de la page du modèle. Le marqueur de capacité jsonObject=true indique que le modèle prend en charge le mode objet JSON, pas que l'interface prend en charge un mode de réponse JSON Schema, ni que l'on peut compter sur une validation par le serveur selon le Schema ; dans cet article, la structure des champs, les types et les contraintes métier sont tous validés localement côté client après parsing. La logique d'extraction, les champs de citation et la couche de validation résident dans votre propre serveur ; le modèle se contente de produire du texte conforme au contrat.
Cet article traite uniquement de la conception du contrat et du processus de validation, sans chiffres de facturation ni promesses de performance ; pour les prix et quotas en temps réel, référez-vous au panneau tarifaire du site. C'est seulement une fois les trois éléments — définition des champs, validation des citations et stratégie de relance — mis en place que l'on passe de « format valide » à « sémantique exploitable » ; un format correct ne signifie pas des faits corrects, et une seed fixe ne garantit pas non plus une reproduction exacte : la stratégie de relance doit rester assortie d'une limite et d'une file de traitement manuel.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de génération d'images par texte avec Nano Banana version de base : format, espaces réservés et usage des prompts
Utiliser les champs aspect_ratio et prompt de l'API de tâche pour générer des images à composition claire pour bannières et cartes sociales
-

Guide d'utilisation
Gestion des réponses Kimi K3 en pratique : JSON complet, interruption de flux et limites de la logique de retry
-

Guide d'utilisation
Guide de production de chansons courtes avec MiniMax Music 3 : comment séparer paroles, balises de section et brief d'arrangement
Concevoir une requête de chanson courte reproductible sur la base des deux entrées obligatoires du contrat actuel