
Guide d'utilisation
Guide de démarrage avec gpt-6.2-sol : limites de capacité, intégration API et tarification par token
Points de décision et de pratique pour l'intégration par les équipes d'ingénierie

Sur cette page
Qu'est-ce que gpt-6.2-sol et à qui s'adresse-t-il
gpt-6.2-sol est un modèle textuel lancé par OpenAI, désormais disponible via l'interface unifiée de HiAPI.ai. Il s'agit du modèle principal du quotidien de la série GPT-6, qu'OpenAI positionne comme un modèle courant adapté aussi bien au codage qu'à l'orchestration d'agents à grande échelle. Son type de sortie est le texte brut : c'est le premier filtre pour déterminer s'il vous convient, plutôt que de le considérer comme une boîte noire universelle « capable de tout faire ».
Ses scénarios les plus confortables sont : les questions-réponses de connaissances et la consolidation de résultats de recherche, les brouillons et réécritures de contenu, l'extraction et la classification de données structurées, le jugement sémantique dans les dialogues multi-tours, et son utilisation comme maillon d'un processus pour prendre des décisions textuelles (triage, étiquetage, résumé, reconnaissance d'intention). Le point commun de ces tâches est que l'entrée est du texte et que la sortie attendue est également du texte ; le modèle peut être intégré dans un service existant comme un appel de fonction.
Le public visé est constitué des équipes d'ingénierie : celles qui évaluent l'introduction d'un nouveau modèle textuel ou qui s'apprêtent à basculer massivement leurs appels existants vers un nouveau modèle. Si vous avez besoin de générer des images ou de l'audio, cela sort de son périmètre et doit être écarté dès la phase de sélection.
Un critère de décision pragmatique : formulez d'abord la tâche à résoudre en une phrase et demandez-vous « l'entrée et la sortie de cette tâche sont-elles toutes deux du texte ? ». Si la réponse est non, ce modèle ne pourra au mieux prendre en charge que le segment textuel du processus.
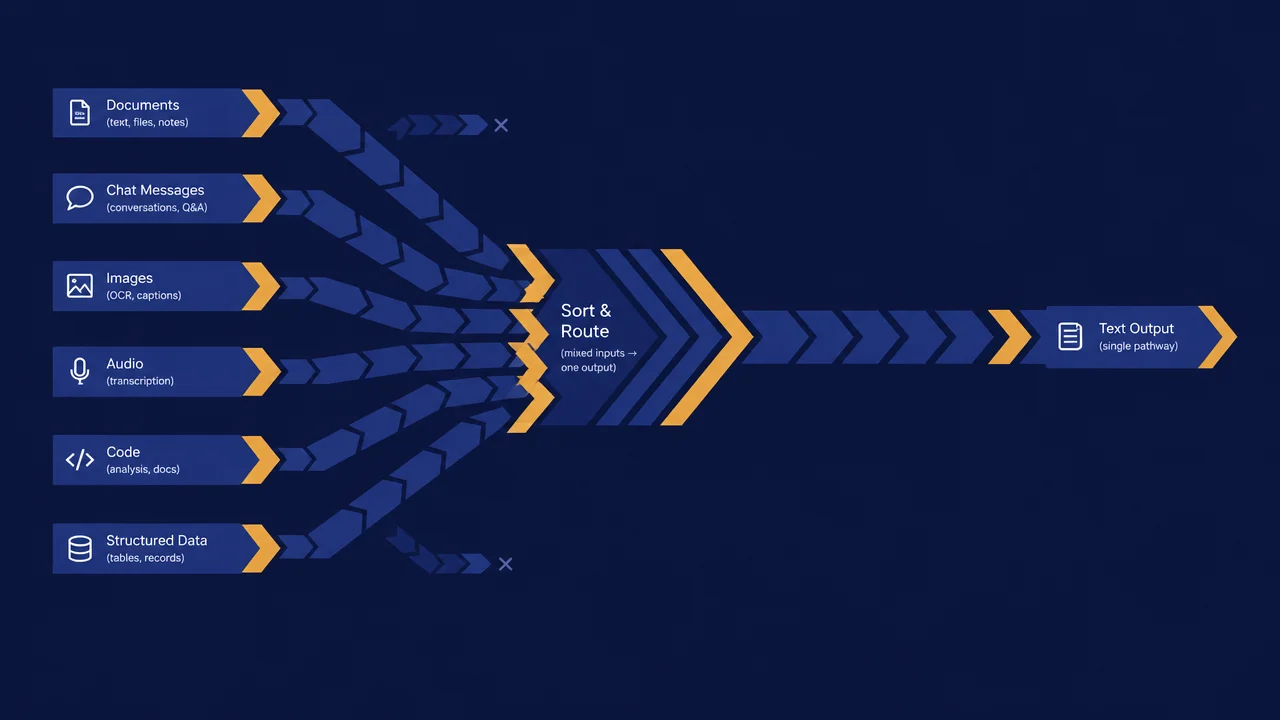
Limites de capacité : ce que la sortie textuelle peut et ne peut pas faire
Considérez gpt-6.2-sol comme un pipeline texte entrant, texte sortant. Ce que le pipeline peut faire est clair : à partir d'un contexte textuel, produire un résultat textuel. Sur cette base, les tâches directement prises en charge incluent la classification et l'étiquetage, le résumé et la réécriture, l'extraction d'informations, la génération de questions-réponses, la conversion de format (par exemple, passer d'un texte libre à un texte structuré conforme à votre convention), ainsi que le classement et l'explication de résultats candidats multiples.
Les parties nécessitant des étapes supplémentaires doivent également être identifiées à l'avance :
- Sortie strictement structurée requise : via l'API Responses, vous pouvez utiliser
text.formatpour transmettre un JSON Schema et activer strict, afin que la réponse soit générée directement selon la définition des champs ; avec Chat Completions, cette option n'existe pas et il faut se contenter de contraintes par prompt. Avec Chat Completions, il faut combiner contraintes de prompt, validation côté serveur et nouvelles tentatives ; on ne peut pas supposer que la première réponse sera nécessairement analysable. - Faits d'actualité requis : la sortie du modèle n'est pas une source de vérité ; les contenus impliquant des données, des dates ou des états externes doivent être fournis par votre couche de recherche ou votre base de données, puis confiés au modèle pour la formulation.
- Produits non textuels requis : la génération d'images, de voix, etc. ne fait pas partie de son type de sortie et doit passer par un maillon dédié.
- Comportement déterministe requis : une même requête n'est pas garantie reproductible mot pour mot ; les parties impliquant une logique fortement cohérente doivent être placées dans le code plutôt que confiées au jugement du modèle.
Consigner les limites dans le document de conception coûte bien moins cher que de corriger en production après coup. Tout maillon dépassant les capacités textuelles doit être explicitement marqué comme « nécessitant un composant externe », afin d'éviter tout décalage d'attentes lors de la revue.
Paramètres clés et tarifs de gpt-6.2-sol
Voici les informations déjà établies pour appeler gpt-6.2-sol via HiAPI ; l'intégration et l'estimation des coûts ci-dessous s'y réfèrent.
- Positionnement : modèle principal du quotidien de la série GPT-6. OpenAI le positionne comme un modèle courant adapté aussi bien au codage qu'à l'orchestration d'agents à grande échelle ; il est plus intelligent et plus économe en tokens que GPT-6.1 Sol.
- Contexte et sortie : fenêtre de contexte de 1 050 000 tokens, sortie unique maximale de 128 000 tokens.
- Date de connaissance : 2026-06-01.
- Sortie et capacités : sortie textuelle, prise en charge du streaming et de l'appel d'outils (
tools). - Modes d'appel : prise en charge de l'API Responses (
https://api.hiapi.ai/v1/responses) et de Chat Completions (https://api.hiapi.ai/v1/chat/completions). Le niveau de réflexionreasoning.effort(low / medium / high / xhigh / max, medium par défaut) et la sortie structurée JSONtext.formatne sont disponibles que via l'API Responses. - Tarifs : prix actuellement affichés sur la page du modèle (par million de tokens) : entrée 0,500 $, entrée en cache 0,025 $, sortie 2,500 $, écriture en cache (5 minutes) 0,625 $. La facturation fait foi selon l'affichage en temps réel de la page du modèle gpt-6.2-sol.
Comment choisir entre gpt-6.2-astra et lui
Le gpt-6.2-astra de la même série est le modèle phare, destiné aux projets les plus difficiles et les plus longs, avec un prix unitaire plus élevé. Il est recommandé d'utiliser d'abord Sol pour la plupart des tâches ; face à un problème que Sol gère mal, comme une refactorisation complexe inter-modules ou un document professionnel très exigeant, passez à Astra. Les deux s'appellent de la même manière ; il suffit de changer le nom du modèle.
Informations d'interface à confirmer avant l'intégration
Lors de l'intégration sur HiAPI.ai, la page du modèle /models/gpt-6.2-sol est le point d'entrée de l'information. La liste suivante doit être vérifiée point par point avant d'écrire la première ligne de code d'appel, et il faut se référer à la documentation officielle et de la plateforme, sans deviner à partir de posts communautaires ou de configurations d'anciens projets :
- Identifiants et mode d'authentification : d'où vient la clé, où elle est stockée, comment l'injecter de manière sécurisée côté serveur, sans jamais la transmettre au navigateur.
- Champs de requête et champs obligatoires : nommage exact et contraintes de valeur des champs tels que l'identifiant du modèle, la structure des messages, la limite de longueur de génération.
- Contraintes de contexte et de longueur de sortie : la fenêtre de contexte de gpt-6.2-sol est de 1 050 000 tokens et la sortie unique maximale de 128 000 tokens ; la manière dont la limite de sortie s'applique détermine directement votre stratégie de découpage.
- Limitation de débit et quotas : selon quelle dimension les limites de débit sont-elles calculées (nombre de requêtes ou volume de tokens) et quelle est la forme de la réponse en cas de déclenchement.
- Sémantique des codes d'erreur : quelles erreurs méritent une nouvelle tentative, lesquelles sont des problèmes de paramètres pour lesquels réessayer ne sert à rien ; il faut les distinguer.
- Base de facturation : ce modèle est facturé au token ; la page du modèle indique séparément les prix unitaires d'entrée, d'entrée en cache, de sortie et d'écriture en cache.
Consignez ces conclusions dans la documentation d'intégration interne de l'équipe ; lors d'un changement de personne ou de modèle, cette liste de vérification pourra être réutilisée directement. Tant qu'un point n'est pas confirmé, ne l'écrivez pas dans la branche de production.
Points clés de l'appel API et de l'organisation des paramètres
Le travail essentiel côté appel ne consiste pas à envoyer une requête, mais à organiser les requêtes en une encapsulation réutilisable, observable et dégradable. Voici d'abord un exemple minimal : obtenir un JSON structuré avec l'API Responses. Avec le SDK officiel OpenAI, il suffit de pointer base_url vers HiAPI :
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Extraire les champs du ticket ; mettre null pour les champs manquants.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Si vous avez déjà un client Chat Completions, il suffit de remplacer le nom du modèle par gpt-6.2-sol pour l'appeler, mais le niveau de réflexion et la sortie structurée JSON ne sont pas disponibles avec Chat Completions. Procédez ensuite dans l'ordre suivant :
Structure de la requête
Séparez les messages en deux couches : contraintes système et contenu utilisateur. La couche système contient le rôle, les exigences de format de sortie et les interdictions ; la couche utilisateur contient les données métier. Ne mélangez pas les données métier et les instructions dans un même bloc, sinon en cas de problème il sera impossible de déterminer s'il vient des données ou des instructions.
Contrat de sortie
Écrivez clairement la forme de sortie attendue (par exemple les noms de champs, l'autorisation ou non de texte explicatif). Même ainsi, effectuez une validation d'analyse côté serveur : un échec d'analyse est considéré comme un appel échoué, à réessayer ou dégrader, plutôt que de transmettre directement un résultat partiel au frontend.
Exceptions et nouvelles tentatives
Les nouvelles tentatives ne doivent avoir lieu que pour des erreurs récupérables, comme une défaillance réseau transitoire ou une limitation de débit. Réessayer pour des paramètres invalides ou un contenu trop long n'a pas de sens ; il faut remonter l'erreur directement. Les tentatives doivent avoir une limite de nombre et un intervalle d'attente croissant, pour éviter de transformer une panne en avalanche.
Ensemble minimal d'observations
Pour chaque appel, enregistrez au minimum : la durée, le volume de tokens en entrée et en sortie, si une nouvelle tentative a eu lieu, et si le résultat final est un succès ou une dégradation. Ces éléments déterminent la capacité à calculer les coûts et à localiser les problèmes par la suite. Une intégration sans journaux équivaut à une non-intégration.
Structure des coûts sous tarification par token
gpt-6.2-sol est facturé au token, ce qui signifie que le coût d'un appel n'est pas une valeur fixe, mais s'accumule linéairement avec le volume d'entrée et de sortie. Ce qu'il faut établir en ingénierie, c'est un modèle de coût, pas la mémorisation d'un chiffre :
- Côté entrée : le prompt système, l'historique de conversation et le contexte récupéré sont tous comptés. Sans troncature, l'entrée d'un dialogue multi-tours gonfle continuellement avec le nombre de tours.
- Côté sortie : plus la génération est longue, plus la facturation est élevée. Exiger du modèle de longues explications fait grimper les coûts de manière incontrôlable.
- Coût total : le coût d'une requête est constitué de l'entrée et de la sortie ; l'optimisation doit donc considérer les deux côtés.
Les moyens de contrôle correspondants : simplifier et réutiliser le prompt système ; appliquer une fenêtre glissante ou une compression par résumé à l'historique de conversation ; découper les longs documents avant de les envoyer selon les besoins ; fixer une limite raisonnable de sortie ; dédupliquer et mettre en cache les tâches par lots, pour ne pas payer deux fois une même entrée.
La bonne méthode d'estimation budgétaire est d'exécuter un échantillon réel, de compter les volumes moyens de tokens en entrée et en sortie, puis de multiplier par l'ordre de grandeur des appels pour obtenir une estimation d'ordre de grandeur. Les prix actuels figurent dans la section « Paramètres clés et tarifs » ci-dessus ; les prix peuvent être ajustés et la facturation fait foi selon l'affichage en temps réel de la page du modèle.
Déterminer s'il faut basculer par une comparaison transversale
Le choix ne doit pas reposer sur une seule évaluation ou un seul indicateur. La méthode la plus fiable est de comparer gpt-6.2-sol et votre modèle candidat actuel sur le même lot d'échantillons métier réels :
- Échantillonnage : prélevez un lot de requêtes représentatives dans les journaux de production ou les données annotées, couvrant les tâches courantes et les cas longs.
- Entrée unifiée : même prompt, même lot de données, en ne changeant que l'identifiant du modèle, pour éliminer l'interférence due aux différences de prompt.
- Notation multidimensionnelle : ne regardez pas seulement le score, mais aussi le taux de conformité de format, le taux d'échec, la consommation moyenne de tokens et la durée moyenne.
- Contrôle manuel par échantillonnage : la qualité d'expression et les erreurs factuelles que les indicateurs automatiques ne détectent pas doivent être examinées par un humain.
- Décision : définissez explicitement le seuil d'admission au basculement, par exemple le niveau de conformité de format et de taux d'échec à atteindre pour valider.
L'objectif de la comparaison n'est pas de prouver que le nouveau modèle est meilleur, mais de répondre à la question « sur la tâche actuelle, le gain du basculement couvre-t-il les coûts de migration et d'exploitation ? ». Si l'écart n'est pas significatif, conserver la situation actuelle est aussi une décision correcte. Dans la même série, pour les tâches les plus difficiles et les plus longues, vous pouvez inclure gpt-6.2-astra dans la comparaison ; pour la plupart des tâches, il est recommandé d'utiliser d'abord Sol.
Questions fréquentes et parcours de dépannage
Pour les problèmes fréquents du début de l'intégration, l'ordre de vérification suivant est généralement le plus rapide :
- Délai d'attente : vérifiez d'abord si une entrée trop longue a fait augmenter le temps de traitement, puis s'il s'agit d'un réseau ou d'une limitation de débit côté serveur. Le plan de dégradation doit être préparé avant la panne.
- Sortie tronquée : vérifiez si la limite de longueur de génération est trop basse et si le prompt système exige une sortie trop longue. La troncature n'est souvent pas un problème du modèle, mais des paramètres.
- Format de sortie non conforme : assurez-vous que les exigences de format dans le prompt sont suffisamment précises et que la validation et les nouvelles tentatives sont ajoutées côté serveur ; en cas d'échecs répétés, envisagez des contraintes par exemples plus explicites.
- Échec d'authentification : vérifiez que la clé est correctement injectée, qu'elle n'a pas été exposée par erreur au frontend, et qu'aucune variable d'environnement ne manque.
- Erreur de limitation de débit : confirmez la dimension et le seuil de limitation, ajoutez un backoff et une file d'attente pour éviter une saturation par concurrence instantanée.
La discipline de base du dépannage : identifier d'abord s'il s'agit d'un problème de construction de requête, de contrainte côté serveur ou d'analyse dans le code métier, puis agir. Ne comptez pas sur l'ajustement de paramètres au hasard.
Surveillance et itération après la mise en production
La mise en production n'est pas une fin. Considérez l'intégration comme une chaîne en fonctionnement continu et surveillez au moins ces indicateurs : volume d'appels et taux de réussite, taux de conformité de format, volume moyen de tokens en entrée et en sortie, durée moyenne, proportion de dégradations et de nouvelles tentatives. Ils correspondent respectivement aux quatre dimensions : capacité, qualité, coût et stabilité.
Sur le rythme d'itération, il est recommandé de revoir à intervalle fixe les échantillons d'échec et les retours utilisateurs, de consigner les erreurs typiques sous forme de nouveaux cas d'évaluation, et d'ajuster en conséquence les prompts, la stratégie de découpage et les limites de sortie. Lorsque le modèle ou la configuration de la plateforme change, faites une régression avec le même lot d'échantillons d'évaluation avant de décider d'élargir le trafic.
Un principe de mise en production utilisable : valider d'abord l'effet réel par un déploiement progressif à faible trafic, puis élargir progressivement, en conservant à tout moment un interrupteur de retour à l'ancien modèle. Pour consulter d'abord les détails du modèle et les informations d'intégration, commencez par /models/gpt-6.2-sol. Ce n'est qu'en consolidant simultanément les limites de capacité, le modèle de coût et la surveillance que gpt-6.2-sol pourra devenir un maillon textuel stable et fiable dans votre système.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de prise en main de gpt-6.2-astra : limites de capacités du modèle texte, points d'intégration et maîtrise des coûts
-

Guide d'utilisation
Guide de prise en main de Tripo H3.1 : trois modes d'entrée, paramètres et choix tarifaires
Décision d'intégration et maîtrise des coûts de la génération 3D pour les développeurs
-

Guide d'utilisation
Générer des images de produits e-commerce avec qwen-image-2.1-turbo via l'API HiAPI
Workflow de visuels catalogue rapide pour développeurs : sortie PNG transparente et requête API exécutable