
Comparatif et évaluation
Alternative à l'API InfiniteTalk : générer des présentateurs parlants synchronisés labialement avec heygen-avatar-v de hiapi
Pas besoin de déployer vous-même les poids ouverts d'InfiniteTalk — optez pour l'alternative de l'API hébergée, avec des sorties réellement pilotées par script et par audio.
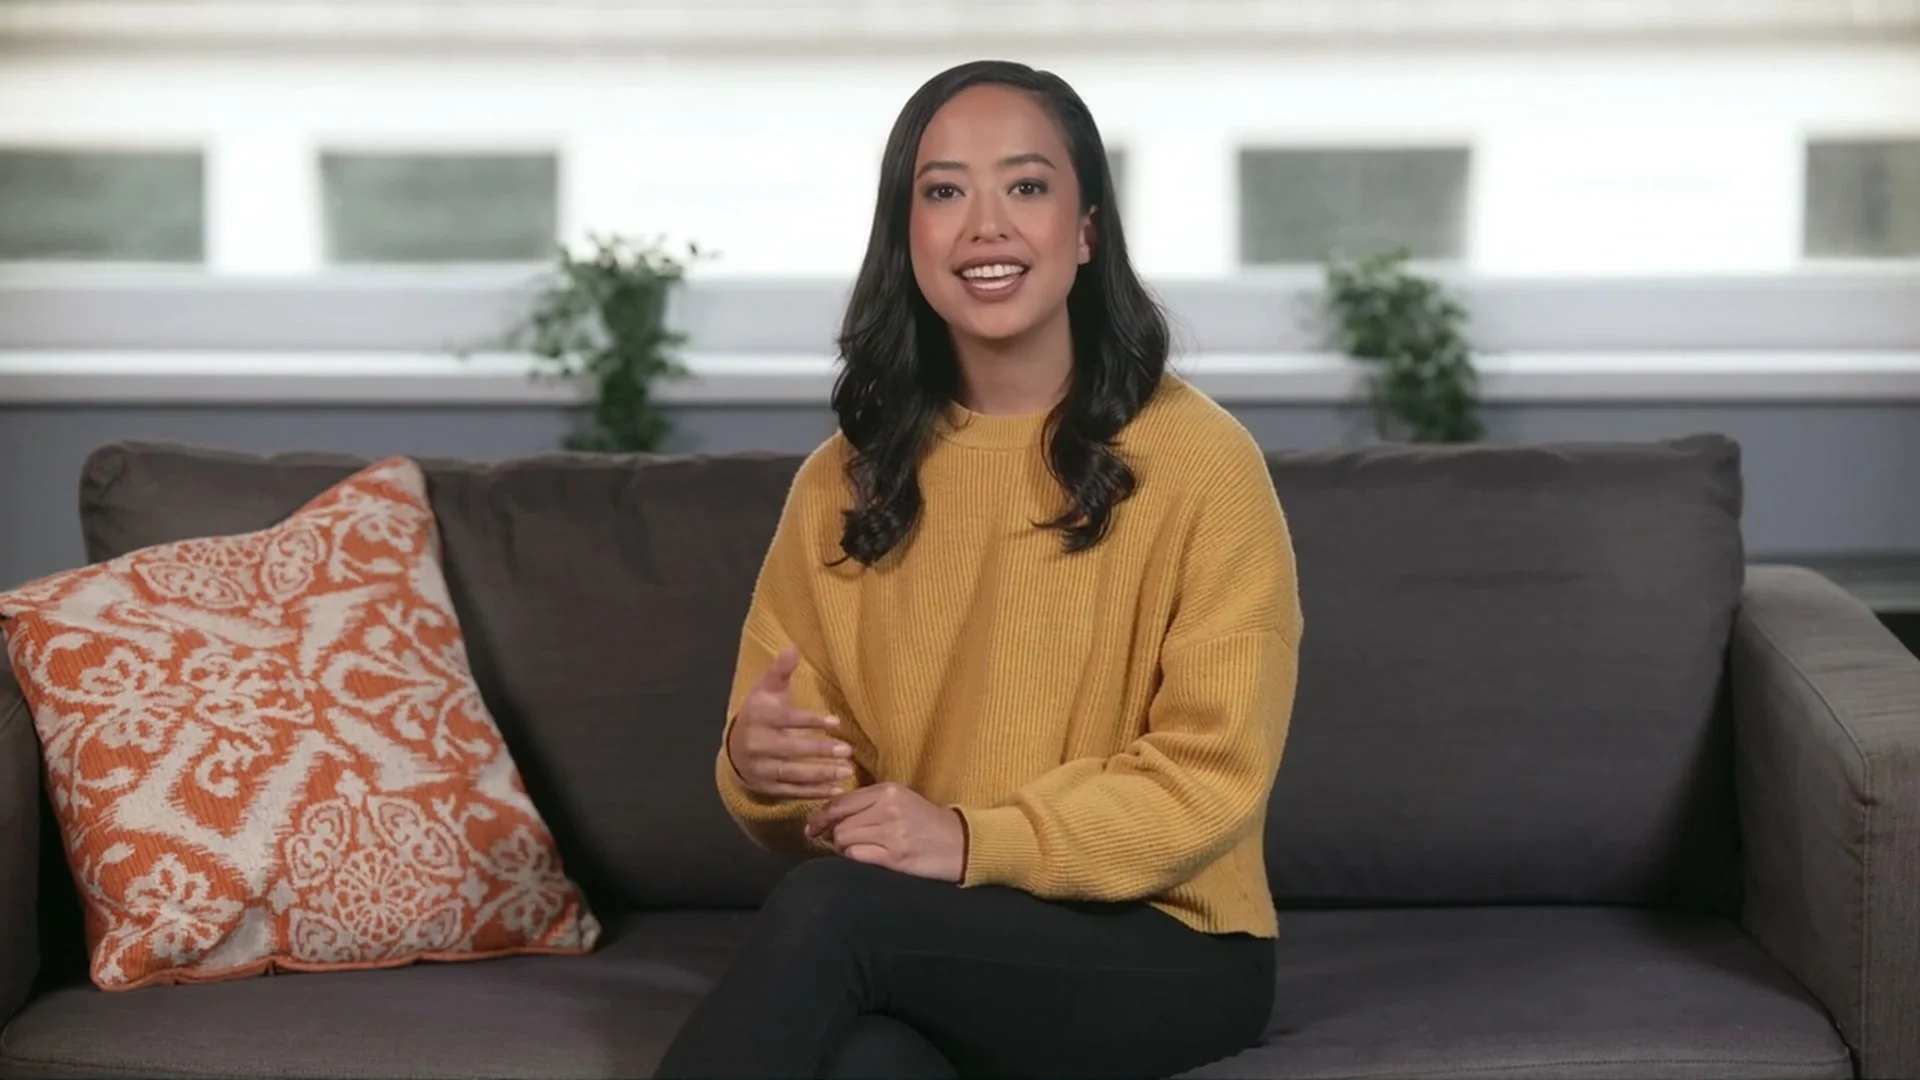
Si vous avez découvert l'API InfiniteTalk via une liste de fournisseurs et que vous souhaitez obtenir une vidéo de présentation synchronisée labialement sans monter un environnement GPU ni vous engager dans un déploiement de poids ouverts, voici une comparaison honnête. InfiniteTalk et heygen-avatar-v de hiapi abordent des problèmes qui se recoupent par des directions opposées : InfiniteTalk est un modèle vidéo audio-vers-vidéo à poids ouverts que vous pouvez exécuter vous-même ou auquel accéder via un hébergeur tiers ; heygen-avatar-v est une API hébergée qui transforme un script ou une piste audio en vidéo de présentateur synchronisée labialement, facturée à un tarif uniforme de 0,15 $ par seconde. Les deux ne sont pas des solutions directement interchangeables — et le seul point où elles divergent est précisément là où vous devez prendre votre décision. Ci-dessous, deux rendus réels de heygen-avatar-v.
Que signifie réellement « API InfiniteTalk » ?
InfiniteTalk est un modèle vidéo audio-vers-vidéo open source publié en 2025. Sa principale prouesse est le doublage vidéo à trames clairsemées : donnez-lui une vidéo existante plus une piste audio, et il reconstruit les segments en synchronisant les lèvres avec le nouvel audio, tout en conservant la personne, l'arrière-plan et les mouvements de caméra d'origine — la longueur étant pratiquement illimitée. Il peut aussi fonctionner comme modèle image + audio vers vidéo. À la date de rédaction, il prend en charge les sorties 480P et 720P.
Comme les poids sont ouverts, « API InfiniteTalk » ne correspond pas à un point d'accès officiel unique. Il s'agit soit de votre propre déploiement GPU, soit d'un hébergeur tiers — WaveSpeed et distributeurs similaires — qui encapsule le modèle et vous facture. Cette ouverture fait tout son attrait : contrôle maximal, capacité de fine‑tuning, et, si vous possédez le matériel, absence de majoration fournisseur à la seconde. Mais c'est aussi son coût opérationnel : vous devez maintenir le modèle, les GPU et la chaîne de traitement, ou accepter le tarif et la file d'attente du distributeur.
Où heygen-avatar-v est une véritable alternative — et où elle ne l'est pas
Commençons par tracer clairement la frontière, car c'est là toute la décision :
- heygen-avatar-v génère à partir de présentateurs prédéfinis — 497 présentateurs et 102 voix. Il ne redouble pas un clip spécifique que vous possédez déjà. Si votre tâche principale est « prendre cette séquence de vraie personne et resynchroniser sa bouche sur un nouvel audio », c'est le domaine vidéo-vers-vidéo d'InfiniteTalk, et heygen-avatar-v n'en est pas le substitut.
- Il constitue bel et bien une alternative solide si : ce dont vous avez vraiment besoin, c'est de générer une vidéo de personne parlante synchronisée labialement à partir d'un script ou d'une piste audio — vidéo explicative, cours, produit ou publicité de style UGC — heygen-avatar-v produit exactement cela en tant qu'API hébergée, sans héberger de modèle et sans distributeur intermédiaire.
La plupart des équipes qui tapent « API InfiniteTalk » dans la barre de recherche appartiennent à la deuxième catégorie. Ce qu'elles veulent, c'est le résultat — un clip de personne parlante piloté par audio ou texte — et non l'obligation d'exécuter un modèle de diffusion en production. C'est précisément le vide que comble heygen-avatar-v. Si vous avez spécifiquement besoin de resynchroniser vos propres séquences sur une nouvelle narration, continuez d'utiliser le flux de doublage d'InfiniteTalk ; rien ici ne le remplace.
Ce que heygen-avatar-v peut réellement faire
Un appel POST https://api.hiapi.ai/v1/tasks suffit à renvoyer une vidéo de présentateur synchronisée labialement. Deux modes de pilotage existent :
- Piloté par script — transmettez
avataravecprompt(jusqu'à 5 000 caractères) et éventuellementvoice; l'API lit le script et synchronise les lèvres. - Piloté par audio — transmettez
avataravecaudio_url(jusqu'à 600 secondes, 32 MiB), et omettezprompt/voice; le présentateur synchronise ses lèvres sur votre enregistrement existant. Ce mode correspond proprement aux flux InfiniteTalk privilégiant l'audio.
Les contrôles de sortie incluent resolution (720p / 1080p / 4k), six ratios d'image (dont 9:16), output_format (mp4 / webm), caption: true pour générer un fichier SRT annexe, ainsi que des remplacements fit, remove_background et background. Le tarif est uniforme de 0,15 $ par seconde de sortie — sans majoration selon la résolution, facturé sur les secondes réellement rendues, avec remboursement des tâches échouées.
Du script au présentateur
HeyGen Avatar V est désormais disponible sur HiAPI. Créez de superbes vidéos de présentateur à partir d'un script ou d'un audio, avec des mouvements naturels et des sous-titres. Offre de lancement : 20 % de réduction.
Rendu avec avatar: "Abigail Sofa Front" et voice: "Derya - Lifelike - Excited" en 1280×720 (version web 720p). Tout le clip provient de ce unique script — aucune séquence filmée, aucun portrait téléversé.
Une version publicitaire décontractée, face caméra
Deuxième rendu heygen-avatar-v, un accroche produit de style UGC détendu — le type de courte publicité au cadrage spontané pour lequel les équipes se tournent vers des outils de la classe InfiniteTalk. Même API de tâches, présentateur prédéfini et réglages différents. Rappel honnête issu des tests : l'arrière-plan est fourni avec le présentateur choisi, et le remplacement background ne parvient pas toujours à substituer le décor de tournage ; testez donc votre combinaison présentateur + arrière-plan sur un court extrait avant un lancement en production.
InfiniteTalk face à heygen-avatar-v : choisissez selon votre mode d'exécution souhaité
| InfiniteTalk (poids ouverts) | heygen-avatar-v (hiapi) | |
|---|---|---|
| Mode d'exécution | Auto-hébergement sur votre propre GPU, ou recours à un distributeur tiers | API hébergée, une clé hiapi |
| Atout principal | Redoubler une vidéo existante ; longueur illimitée | Générer une vidéo de présentateur prédéfini parlant à partir d'un script ou d'un audio |
| Entrées de pilotage | Audio (+ vidéo source ou image) | Script (prompt) ou audio_url |
| Utiliser votre propre personne à l'écran | Oui — doublage vidéo-vers-vidéo | Non — présentateurs sélectionnés (Avatar IV possible avec une seule photo) |
| Sortie | 480P / 720P | 720p / 1080p / 4k, six ratios d'image, mp4/webm, sous-titres SRT |
| Modèle de coût | Votre temps GPU, ou le tarif du distributeur | 0,15 $ uniforme par seconde de sortie, remboursement des tâches échouées |
| Charge d'exploitation | Modèle et infrastructure à maintenir | Aucune — POST /v1/tasks |
La dimension la plus importante est la première ligne. InfiniteTalk vous confie le modèle ; heygen-avatar-v vous confie le résultat. Si le besoin est de redoubler vos propres séquences ou de disposer d'une longueur illimitée, exécutez InfiniteTalk. Si le besoin est de « générer une vidéo de personne parlante à partir d'un script ou d'un audio, facturée à la seconde, avec une seule clé », heygen-avatar-v vous le permet sans jamais toucher à un GPU.
Une requête fonctionnelle
L'analogue le plus proche d'une tâche InfiniteTalk privilégiant l'audio est le mode piloté par audio de heygen-avatar-v — votre enregistrement en entrée, un présentateur synchronisé labialement en sortie :
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
Vous préférez piloter depuis du texte, en portrait et avec des sous-titres incrustables ? Remplacez audio_url par un script :
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Riley Casual Front",
      "prompt": "Le nouveau produit vient de sortir. Faites glisser vers le haut pour l'acheter dès maintenant !",
      "voice": "Charming Charles - Friendly",
      "aspect_ratio": "9:16",
      "resolution": "1080p",
      "caption": true,
      "output_format": "mp4"
    }
  }'
Conservez data.taskId, interrogez GET /v1/tasks/{taskId} jusqu'à ce que status soit success, puis téléchargez chaque élément de output[] avant son expireAt (video, et le fichier SRT caption s'il est activé). Cela suit le même schéma basé sur les tâches que tous les autres modèles vidéo de la plateforme — voir le guide de démarrage de l'API asynchrone unifiée pour la structure de requête/réponse partagée, et la page du modèle heygen-avatar-v pour la liste complète des présentateurs et voix prédéfinis.
Questions fréquentes
heygen-avatar-v peut-il redoubler une vidéo que je possède déjà ? Non. Ce doublage global, préservant l'identité d'une séquence existante, est la spécialité d'InfiniteTalk. heygen-avatar-v génère à partir de présentateurs prédéfinis sélectionnés. Si vous avez seulement besoin d'animer un portrait statique unique, Avatar IV est la solution sœur pilotée par photo ; ni l'un ni l'autre n'est un outil de doublage vidéo-vers-vidéo.
Puis-je utiliser mon propre audio plutôt qu'un script ?
Oui. Transmettez audio_url (jusqu'à 600 secondes, 32 MiB) et omettez prompt et voice. Le présentateur synchronise directement ses lèvres sur votre enregistrement.
Combien cela coûte-t-il ? 0,15 $ uniforme par seconde de sortie, identique en 720p, 1080p et 4k, facturé sur les secondes réellement rendues. Remboursement des tâches échouées.
Quelles résolutions et quels ratios d'image sont disponibles ?
720p, 1080p et 4k, avec six ratios d'image : 16:9, 9:16, 4:5, 5:4, 1:1 et auto.
Dois-je héberger ou maintenir quoi que ce soit ? Non. heygen-avatar-v est une API hébergée qui utilise votre clé hiapi existante — pas de poids, pas de GPU, aucune inscription séparée. C'est le principal compromis par rapport à l'exécution d'InfiniteTalk par vous-même.
Pour commencer
Si votre véritable objectif est de générer une vidéo de personne parlante synchronisée labialement à partir d'un script ou d'un fichier audio — et non d'auto-héberger un modèle — heygen-avatar-v est le chemin le plus court. Choisissez un présentateur et une voix sur la page du modèle heygen-avatar-v, écrivez une ligne de script pour tester, puis connectez l'API de tâches à votre flux. Pour un guide ciblé sur les réseaux sociaux, voir transformer un script en vidéo courte de prise de parole ; si vous pesez encore des outils de présentateur hébergés ou facturés au siège, les comparaisons avec Synthesia et Hedra couvrent ces arbitrages.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Comparatif horizontal de Recraft v4.1 Flash en génération d'images à partir de texte : guide de sélection et de migration pour les développeurs
Avec un coût de 0,01 $ par image et ses capacités de génération pure à partir de texte, déterminez s'il convient à votre pipeline de génération d'images
-

Comparatif et évaluation
Comparatif transversal de hailuo-2.3-fast/image-to-video : comment choisir un modèle image-to-video et les points clés de migration
-

Comparatif et évaluation
Seedream 5.0 Pro image-to-image comparatif horizontal : capacités, tarification et recommandations de choix