
比較レビュー
InfiniteTalk API の代替案:hiapi の heygen-avatar-v でリップシンクしたトーキングデジタルヒューマンを生成
InfiniteTalk のオープンウェイトを自前でデプロイせず、マネージド API の代替案を採用——実際のスクリプト駆動と音声駆動の出力を含む。
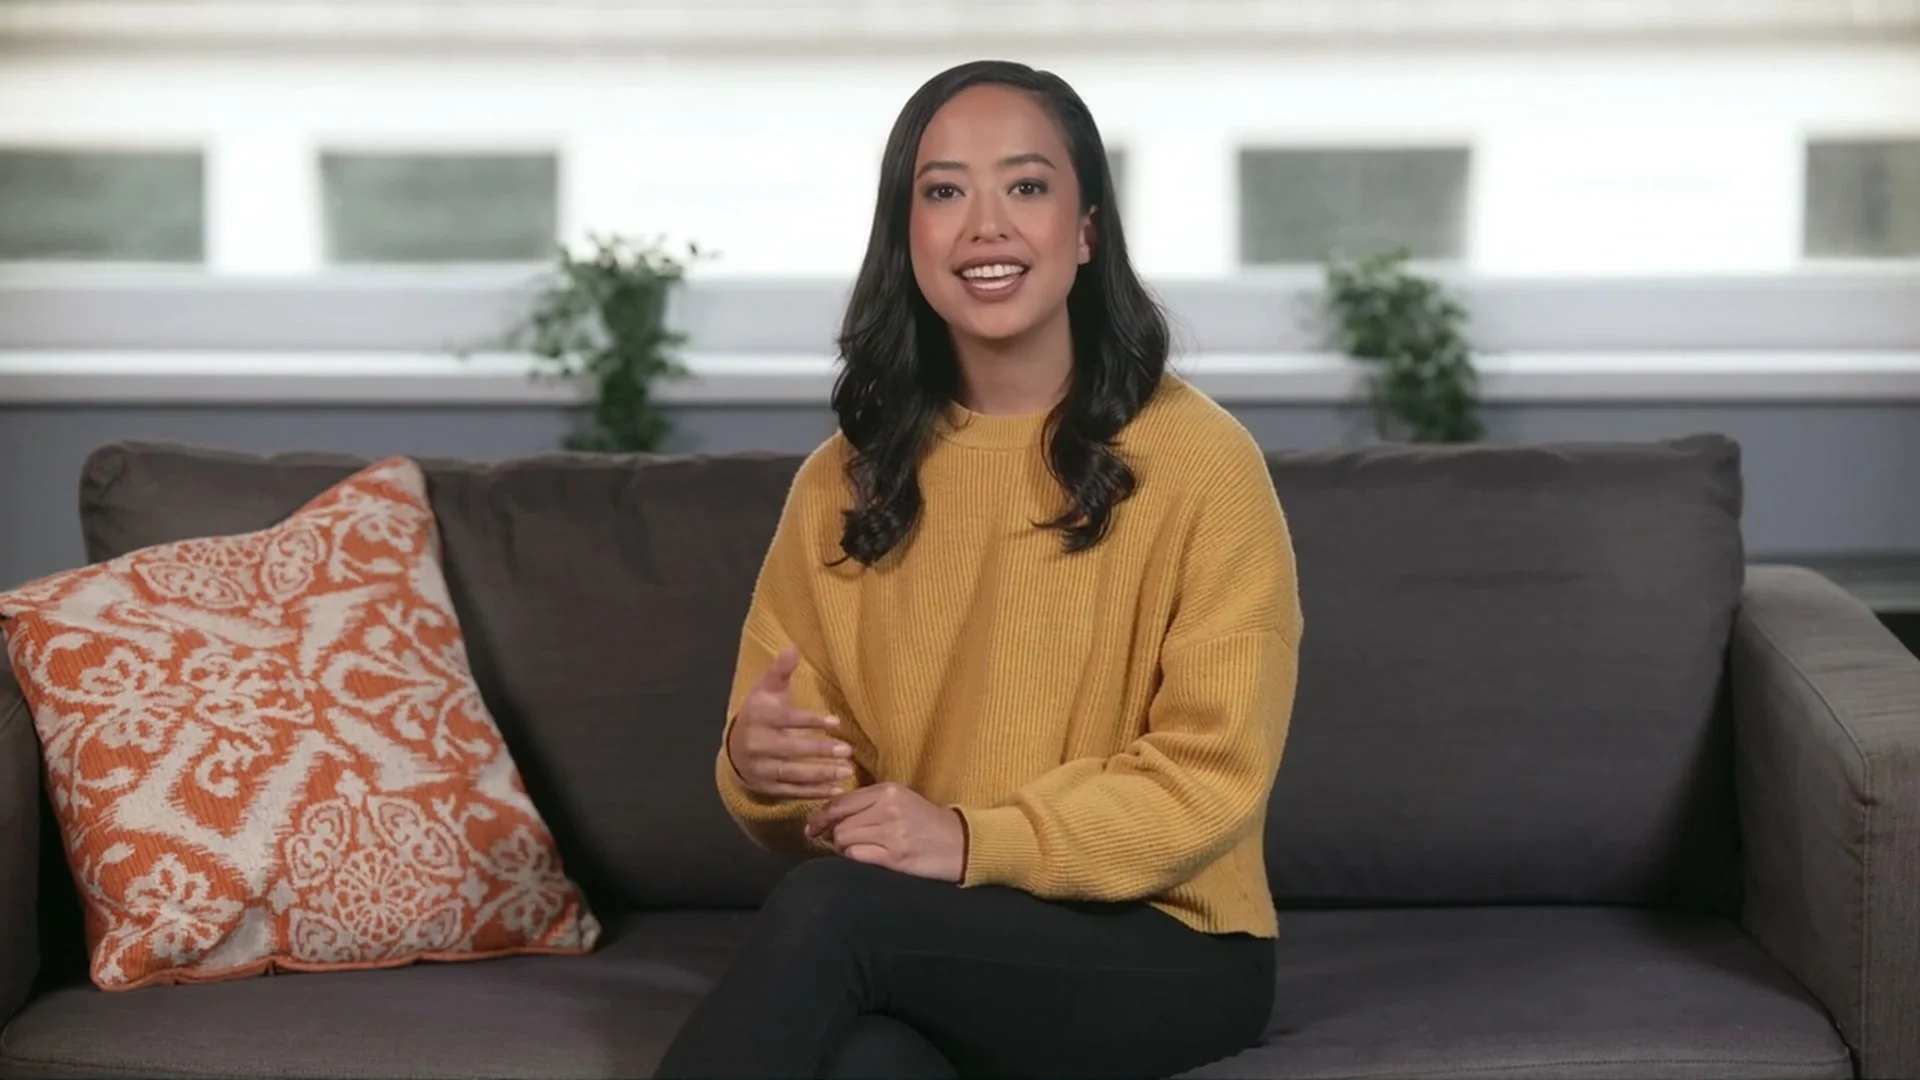
あるプロバイダーの一覧から InfiniteTalk API を知り、GPU 環境を構築したりオープンウェイトのデプロイを約束したりすることなく、リップシンクしたトーキング動画を手に入れたいと考えているなら、ここに正直な比較を用意しました。InfiniteTalk と hiapi の heygen-avatar-v は、重なり合う問題を逆の方向から解決します。InfiniteTalk はオープンウェイトの音声駆動動画モデルで、自分で実行することも、サードパーティのホスティング事業者経由でアクセスすることもできます。一方 heygen-avatar-v はマネージド API で、スクリプトや音声トラックをリップシンクしたキャスター動画に変換し、出力 1 秒あたり 0.15 ドルの均一料金です。両者はそのまま交換できる等価なソリューションではありません——そして両者が唯一分かれる点こそが、あなたが判断すべきところです。以下に 2 つの実際の heygen-avatar-v レンダリング結果を示します。
「InfiniteTalk API」とは一体何を意味するのか
InfiniteTalk は 2025 年にリリースされたオープンソースの音声駆動動画モデルです。その特徴的な技はスパースフレーム動画吹き替えです。既存の動画に音声トラックを加えると、元の人物、背景、カメラワークを保ちながら、新しいリップシンクを付けたクリップを再生成します——長さは実質無制限です。画像と音声から動画を生成するモデルとしても動作します。執筆時点では 480P と 720P の出力に対応しています。
ウェイトがオープンであるため、「InfiniteTalk API」は単一の公式エンドポイントではありません。それは自分自身の GPU デプロイか、あるいは WaveSpeed や類似のディストリビューターといったサードパーティのホスティング事業者がモデルをラップして料金を請求するものです。このオープン性こそが魅力です。最大限の制御、微調整の可能性、そしてハードウェアを持っていれば秒単位のベンダー上乗せ料金が不要です。しかしこれは運用コストでもあります。モデル、GPU、パイプラインを維持するか、ディストリビューターの価格表と待ち行列を受け入れる必要があります。
heygen-avatar-v が真の代替となる場面——そしてそうでない場面
まず境界を明確にしましょう。なぜならそれがまさに判断そのものだからです:
- heygen-avatar-v はプリセットのデジタルヒューマンから生成します——497 人のキャスターと 102 種類の声です。既存の特定の映像に吹き替えをすることはありません。あなたの中心的なタスクが「この実写素材を使って、その人物の口の動きを新しい音声にリシンクする」ことであれば、それは InfiniteTalk の動画から動画への領域であり、heygen-avatar-v はその代替ではありません。
- しかし強力な代替となるのは次の場合です。本当に必要なのが、スクリプトや音声トラックからリップシンクしたトーキング動画を生成すること——例えば解説動画、講座、製品や UGC 風広告——であれば、heygen-avatar-v はまさにそれらをマネージド API として生成でき、モデルをホストする必要もなく、間にディストリビューターもいません。
検索バーに「InfiniteTalk API」と入力するチームのほとんどは第 2 のカテゴリーに属します。彼らが欲しいのは出力——音声やテキストで駆動されるトーキングクリップ——であり、本番環境で拡散モデルを動かす義務ではありません。これが heygen-avatar-v が埋める空白です。自分で撮影した素材を新しいナレーションにリシンクする必要が特にあるなら、InfiniteTalk の吹き替えワークフローを使い続けてください。ここにはそれを代替するものは何もありません。
heygen-avatar-v が実際にできること
1 回の POST https://api.hiapi.ai/v1/tasks 呼び出しで、リップシンクしたデジタルヒューマン動画が返ります。駆動方法は 2 種類あります:
- スクリプト駆動——
avatarに加えてprompt(最大 5,000 文字)と任意のvoiceを渡します。API がスクリプトを読み上げ、口の動きを同期します。 - 音声駆動——
avatarに加えてaudio_url(最大 600 秒、32 MiB)を渡し、prompt/voiceは省略します。デジタルヒューマンが手持ちの録音に合わせてリップシンクします。このモードは音声優先の InfiniteTalk ワークフローにきれいに対応します。
出力の制御には resolution(720p / 1080p / 4k)、6 種類のアスペクト比(9:16 を含む)、output_format(mp4 / webm)、付属の SRT ファイルを生成する caption: true、そして fit、remove_background、background の上書きがあります。料金は均一の出力 1 秒あたり 0.15 ドル——解像度による割増はなく、実際にレンダリングされた秒数で課金され、失敗したタスクは返金されます。
スクリプトからキャスターへ
HeyGen Avatar V が HiAPI で公開されました。スクリプトや音声から、自然な動きと字幕を備えた美しいキャスター動画を作成できます。ローンチ記念:20% オフ。
avatar: "Abigail Sofa Front" と voice: "Derya - Lifelike - Excited" を使用し、1280×720(720p のウェブ版)でレンダリングしました。クリップ全体がその 1 つのスクリプトから生まれています——撮影素材もなく、肖像のアップロードもありません。
カジュアルでカメラ目線の広告版
2 つ目の heygen-avatar-v レンダリングで、ゆるい UGC 風の製品フックです——チームがこうした短く生活感のある広告を作るために InfiniteTalk 級のツールに頼るタイプのものです。同じタスク API、異なるプリセットのデジタルヒューマンと設定です。テストからの正直な注意点:背景は選択したデジタルヒューマンに付属しており、background の上書きが撮影シーンを常に置き換えられるわけではないので、本番実行の前に短いクリップでデジタルヒューマンと背景の組み合わせをテストしてください。
InfiniteTalk 対 heygen-avatar-v:望む実行方法で選ぶ
| InfiniteTalk(オープンウェイト) | heygen-avatar-v(hiapi) | |
|---|---|---|
| 実行方法 | 自分の GPU でセルフホスト、またはサードパーティのディストリビューターを利用 | マネージド API、hiapi キー 1 つ |
| 中核的な強み | 既存動画への吹き替え、長さ無制限 | スクリプトや音声からプリセットのデジタルヒューマンによるトーキング動画を生成 |
| 駆動入力 | 音声(+ ソース動画または画像) | スクリプト(prompt)または audio_url |
| 画面上で自分の実写人物を使用 | 可——動画から動画への吹き替え | 不可——厳選されたプリセット(単一写真には Avatar IV が使用可能) |
| 出力 | 480P / 720P | 720p / 1080p / 4k、6 種類のアスペクト比、mp4/webm、SRT 字幕 |
| コストモデル | 自分の GPU 時間、またはディストリビューターの料率 | 出力 1 秒あたり均一 0.15 ドル、失敗タスクは返金 |
| 運用負担 | 維持すべきモデルとインフラ | なし——POST /v1/tasks |
最も重要な次元は最初の行です。InfiniteTalk はモデルをあなたに渡し、heygen-avatar-v は結果をあなたに渡します。要件が自分の素材への吹き替えや無制限の長さであれば、InfiniteTalk を実行してください。要件が「スクリプトや音声からトーキング動画を生成し、秒単位で課金され、キー 1 つで済む」ことであれば、heygen-avatar-v は GPU に触れることなく実現できます。
動作するリクエスト
音声優先の InfiniteTalk タスクに最も近い類推は、heygen-avatar-v の音声駆動モードです——録音を入力し、リップシンクしたデジタルヒューマンを出力します:
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
テキストから駆動し、縦向きで、焼き込み可能な字幕を付ける方がよければ、audio_url をスクリプトに置き換えてください:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Riley Casual Front",
      "prompt": "新商品が登場しました。上にスワイプして今すぐチェック!",
      "voice": "Charming Charles - Friendly",
      "aspect_ratio": "9:16",
      "resolution": "1080p",
      "caption": true,
      "output_format": "mp4"
    }
  }'
data.taskId を保存し、status が success になるまで GET /v1/tasks/{taskId} をポーリングし、output[] の各項目を expireAt より前にダウンロードしてください(video、有効時は caption の SRT も)。これはプラットフォーム上の他のすべての動画モデルと同じタスクベースのパターンです——共有のリクエスト/レスポンス構造については統一非同期 API クイックスタートを、デジタルヒューマンと声のプリセットの完全なリストについてはheygen-avatar-v モデルページをご覧ください。
よくある質問
heygen-avatar-v は既存の動画に吹き替えできますか? いいえ。既存素材に対して全体的にアイデンティティを保ったまま吹き替えるのは InfiniteTalk の得意分野です。heygen-avatar-v は厳選されたプリセットのデジタルヒューマンから生成します。単一の静止した肖像を動かしたいだけなら、Avatar IV が写真駆動の姉妹ソリューションです。どちらも動画から動画への吹き替えツールではありません。
スクリプトではなく自分の音声で駆動できますか?
できます。audio_url(最大 600 秒、32 MiB)を渡し、prompt と voice を省略してください。デジタルヒューマンが録音に直接リップシンクします。
料金はいくらですか? 出力 1 秒あたり均一 0.15 ドルで、720p、1080p、4k でまったく同じ、実際にレンダリングされた秒数で課金されます。失敗したタスクは返金されます。
利用できる解像度とアスペクト比は?
720p、1080p、4k、6 種類のアスペクト比:16:9、9:16、4:5、5:4、1:1、auto です。
何かをホストしたり維持したりする必要はありますか? いいえ。heygen-avatar-v は既存の hiapi キーを使うマネージド API です——ウェイトも GPU も、別途登録も不要です。InfiniteTalk を自分で実行する場合との主なトレードオフはこれです。
はじめに
本当の目標がスクリプトや音声ファイルからリップシンクしたトーキング動画を生成すること——モデルのセルフホストではない——なら、heygen-avatar-v はより短い道です。heygen-avatar-v モデルページでキャスターと声を選び、1 行のスクリプトを試しに書いて、タスク API をあなたのパイプラインに接続してください。SNS 向けの焦点を絞った解説については、スクリプトを口播ショート動画に変えるを参照してください。シートベースの他のマネージドデジタルヒューマンツールとまだ比較検討中なら、Synthesia と Hedra の比較がそれらのトレードオフをカバーしています。


