比較レビュー
hailuo-2.3-fast/image-to-video 横断比較:画像から動画へのモデルの選び方と移行の要点

まず、解決すべき画像から動画への問題がどの種類なのかを明確にする
画像から動画(image-to-video)は単一の要件ではない。同じ「この画像を動画にしてください」という一言でも、プロダクトマネージャー、デザイナー、エンジニアの口から出ると、しばしば三つの異なる事柄を指す。静的な商品画像を動かして展示する、マーケティング素材用に数秒の雰囲気ショートを作る、あるいは一つのキーフレームをカメラモーション付きのクリップに拡張する、といった具合だ。要件が異なれば、モデル選定で注目すべき指標もまったく変わってくる。
どのモデルのドキュメントを開く前に、まず要件を以下の比較可能な次元に分解することを勧める:
- モーションの大きさ:画面に必要なのは微かな呼吸感(光や影、水面、髪)だけか、それとも明確なカメラのズームや被写体の移動が必要か。モーションが大きいほど、画面が崩れるリスクは高くなる。
- 画面の安定性:構造の歪み、被写体の変形、背景のちらつきが許容されるか。商品展示系ではほぼゼロトレランスだが、雰囲気系では緩和できる。
- 入力の忠実度:生成結果が元画像にどれだけ近い必要があるか。商品画像では被写体が変形せず色がずれないことが求められ、クリエイティブ系ではモデルの「自由な発揮」が許される。
- 1回あたりの長さとバッチ規模:一度に何本生成し、毎日何本処理するかが、コスト感度を直接左右する。
- レイテンシと並列性:ユーザーがオンラインで待つのか、オフラインでバッチ処理するのか。前者は応答時間に敏感で、後者はスループットとコストに敏感だ。
これらの項目を要件リストとして書き出してからモデルのパラメータを見れば、判断はずっと明確になる。本稿では以降、hailuo-2.3-fast/image-to-video を参照対象として用いる。これは MiniMax が提供するもので、出力タイプは動画、機能は image-to-video に特化し、1本単位の課金で、コストを抑えられるベースライン候補として適している。
よくある誤判断
多くのチームは最初に単価を比較してしまい、安いが成功率の低いモデルを選んでしまう。その結果、やり直しと人による確認のコストが、節約した費用をはるかに上回る。より合理的なのは、上記の次元を業務の優先度順に並べてから、モデルをそれに当てはめることだ。
hailuo-2.3-fast/image-to-video の位置づけとコストのベースライン
まずこのモデルをその座標系に戻そう。hailuo-2.3-fast/image-to-video の提供元は MiniMax で、出力タイプは動画、機能は image-to-video に明確に限定されている。つまり入力画像を起点に動画を生成するものであり、テキストから動画を生成したり複数画像を参照したりするものではない。名前の fast は通常、速度やコストで何らかのトレードオフを行っていることを意味し、高頻度呼び出しの候補として適しており、極致の画質を追求するフラッグシップ選択肢ではない。
課金方式は1本単位の課金で、現在の価格はサイトの価格パネルで確認できる。この方式自体が非常に有用だ。1本単位の課金とは、コストを「生成本数」で直接見積もれるということであり、まずトークンや秒数に換算する必要がない。予算モデルを作るときに業務指標と整合させやすい——たとえば「今月は商品ショートを5000本出す」なら、そのまま本数を掛ければよい。
コストのベースラインとして扱う
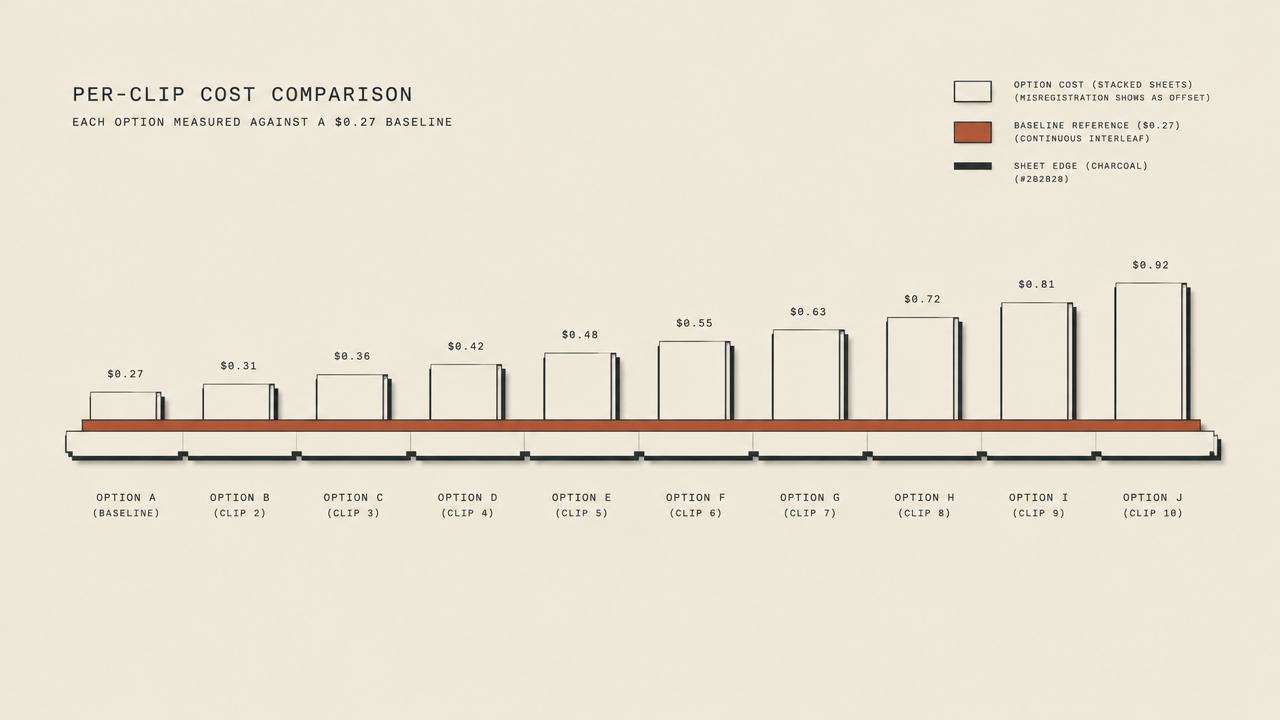
このモデルの1本あたりのコストを一つの水平なベースラインとし、他の候補モデルはすべて「1本あたりの等価コスト」に換算してから比較することを勧める。換算するときは表示価格だけを使うのではなく、次の式を用いる:
1本あたりの実効コスト = 1本の価格 ÷ 生成成功率 × (1 + やり直し率)
生成成功率とは1回の呼び出しで使える結果が得られる割合を指し、やり直し率とは再実行や人手による修正が必要になる割合を指す。表示価格が安くても成功率が七割しかないモデルの実効コストは、表示価格が高い競合より高くなる可能性がある。hailuo-2.3-fast/image-to-video をこのベースラインに置けば、他のモデルが「高いだけの価値がある」のか「高いのに理不尽」なのかを素早く判断できる。
機能の境界は事前に明確にしておく
これは image-to-video のみを行い、テキストからの動画生成、動画編集、音声生成は担当しない。業務フローに「ゼロからの生成」と「画像ベースの生成」の両方がある場合、オーケストレーション層で異なるモデルに振り分けるか、同じインターフェース層で統一的にラップし、業務コードにベンダーごとの分岐が散らばるのを避けるべきだ。
横断比較で見るべき次元
同種の画像から動画へのモデルを並べて比較するとき、固定の次元リストを使えば「感覚で選ぶ」ことを避けられる。以下のリストは重要度順に並べており、そのままレビュー表として使える。
1. 画面の安定性とモーションの品質
これは可用性に最も影響する次元だ。被写体が変形しないか、背景がちらつかないか、カメラの動きが自然かどうかに注目する。fast 系のモデルは速度のために通常モーションの大きさを控えめにする傾向があり、軽微な動きの表現は良好だが、大きなカメラワークは実測で確認する必要がある。
2. 入力の忠実度と画像仕様
モデルが入力画像に求める要件は大きく異なる。解像度の上下限、アスペクト比、ファイル形式、透明チャンネルに対応しているかどうか。忠実度は生成結果と元画像の一致度を見るもので、特に文字、ロゴ、顔などの敏感な領域が重要だ。
3. コストの方式と予測可能性
1本単位か、秒単位か、トークン単位かという課金方式が、予算モデルを正確に作れるかどうかを決める。1本単位の課金(hailuo-2.3-fast/image-to-video など)は最も見積もりやすい。出力秒数単位の課金では目標の長さに合わせて換算する必要がある。絶対値だけを比べず、「1つの業務ユニットを完了するあたりのコスト」を比べるべきだ。
4. レイテンシと並列処理能力
オンラインの場面では最初の結果が返るまでの時間を、オフラインの場面では単位時間あたりのスループットを見る。並列の上限は往々にして単発のレイテンシよりも早くボトルネックになるため、接続前にレート制限の方針を必ず確認する。
5. 長さと出力仕様
1回で生成できる長さの範囲、出力解像度、エンコード形式は、そのまま下流の編集や配信フローに投入できるか、トランスコードの工程を減らせるかを直接左右する。
6. 失敗時のセマンティクスと可観測性
タイムアウト、コンテンツ遮断、パラメータエラーが区別可能なエラーコードを返すか、冪等な再試行に対応しているか。この項目はデモ段階では見えないが、本番稼働後に最も厄介になる。
どう採点するか
各次元に業務優先度で重みを付け、実測データで点数を埋める。少なくとも同一の入力画像群(商品画像、人物、風景、文字入り画像の四種類をカバー)で一度対照実験を行い、成功率と主観的な可用率を記録することを勧める。公式のサンプルだけを見てはいけない。
シーン別に優先度を並べる:どういう場合に fast 版を選ぶか
比較の次元は道具であり、実際の意思決定はやはりシーンに戻るべきだ。以下のようないくつかの状況では、fast 系モデルがより合理的な第一選択となることが多く、hailuo-2.3-fast/image-to-video はその代表的な候補になり得る。
予算に敏感なバッチ生成
EC の詳細ページの動き、SNS 素材の大量生産といったタスクは、1本あたりの価値は高くないが数が多く、コスト曲線が非常に急だ。この場合は1本単位の課金で1本あたりのコストを抑えられるモデルを優先し、節約した予算を人手による抜き取り検査に回すべきだ。
素早い試行錯誤が必要なクリエイティブ段階
ビジュアルの方向性を決める前に、チームはしばしば数十から数百のバリエーションを回す。この段階で求めるのは「可能性を素早く見る」ことであり、画質が多少落ちても許容される。fast 版で一次選別を行い、方向性を固めてからより強力なモデルで仕上げる、という二段階のワークフローが一般的だ。
モーションの小さい展示系の要件
商品画像の微かな光の流れ、静止ポスターの呼吸感、人物のクローズアップの微表情など、こうした要件自体は大きなカメラワークを必要とせず、fast モデルの安定性とコストのバランス点がまさに適合する。
どういう場合に選ぶべきでないか
業務が大きなカメラモーション、長尺の物語クリップ、あるいは被写体の一貫性にほぼゼロトレランスを求める場合、画質と安定性をコストより優先し、より能力の高いモデルを検討すべきだ。選定とは「最良のモデル」を探すことではなく、「現在の制約下での最適解」を探すことだ。
実用的な判断順序
- まず画質の下限を fast 系モデルが満たせるかを問う;
- 次にバッチ規模によってコストが主要な矛盾になるかを見る;
- 最後に並列性とレイテンシが業務のピークに耐えられるかを検証する。
三つのステップをすべて通過するシーンなら、そのまま fast 版を使う。どれか一つでも通過しなければ、より上位のモデルを探す。
移行と接続時の注意点
デモから本番へ進むと、問題の多くは細部に現れる。hailuo-2.3-fast/image-to-video に切り替える、あるいは初めて接続する際は、以下のリストに沿って項目ごとに検証することを勧める。
入力画像の仕様
- 対応する解像度の範囲とアスペクト比を確認し、範囲外のときはエラーになるのか自動トリミングされるのかを把握する。自動トリミングは構図を密かに変えてしまう可能性がある。
- 形式とファイルサイズの上限を確認し、大きな画像は事前圧縮が必要かどうかを確認する。圧縮は細部を失い、出力の忠実度に影響する。
- 文字やロゴを含む画像について専用のテストを行い、重要な情報が生成時に塗りつぶされないことを確認する。
返却構造とポーリングのセマンティクス
動画生成は多くが非同期タスクであるため、確認すべきは、送信後に返るタスク識別子のフィールド、状態を問い合わせるインターフェースの形式、状態の列挙値(待機中、処理中、成功、失敗)、および成功時の動画アドレスのフィールド位置と有効期限だ。返却構造の解析はアダプター層として書くべきで、業務コードに散らばらせてはいけない。そうすれば後でモデルを替えるときの変更範囲がずっと小さくなる。
失敗時の再試行と冪等性
- 再試行可能なエラー(タイムアウト、レート制限)と再試行不可能なエラー(不正なパラメータ、コンテンツ遮断)を区別し、前者はバックオフして再試行し、後者は即座に失敗として報告する。
- 再試行には冪等な識別子を付け、同じ画像で重複して課金・複数生成されるのを避ける。
- 1つのタスク全体のタイムアウトを設定し、ポーリングが無限に吊り下がるのを防ぐ。
サイレントなデグレードを避ける
これは移行で最も見えにくい落とし穴だ。パラメータがサポートされていないのにインターフェースは成功を返し、実際にはデフォルト値が使われ、出力が期待と異なるのに誰も気づかない。対策は、重要なパラメータを明示的に検証し、返却結果に実際に有効となった設定を記録して、ログとモニタリングに含めることだ。
可観測性と段階的リリース
本番前に、成功率、平均所要時間、1本あたりのコスト、人手による却下率の四つの指標を仕込む。切り替え時には段階的なトラフィックで新旧モデルの同一の入力群に対する挙動を比較し、退行がないことを確認してから全量に切り替える。
集約層で選定と切り替えのコストを下げる
前のいくつかの節で同じ提案が繰り返し出てきた。モデルの呼び出しを一層のアダプターコードに集約する、というものだ。理由は直接的で、画像から動画への分野はイテレーションが速く、今日の最適解が半年後には置き換えられている可能性があり、そのたびに業務コードを直す必要があれば、コストが高すぎて最適化を諦めてしまうからだ。
集約 API 層がやるべきことは実は三つだ:
リクエストと返却構造の統一
異なるモデルのパラメータ名、非同期タスクの仕組み、返却フィールドを一つの内部規約にマッピングする。業務側は「画像を送信 + パラメータ + 結果を取得」だけを認識し、背後が誰であるかを気にしない。これにより hailuo-2.3-fast/image-to-video から別のモデルへ切り替えても、変更はマッピング設定の中だけに収まる。
課金視点の統一
すべてのモデルの課金方式を「1本あたりの実効コスト」に換算して表示し、成功率とやり直し率を組み合わせることで、選定の議論を業務指標に戻し、パラメータ表の中を堂々巡りしないようにする。
段階的リリースとロールバックのサポート
トラフィックの比率や業務タグで異なるモデルに振り分け、同じ入力群で A/B 比較を行う。あるモデルの成功率が下がったりレイテンシが急増したとき、緊急リリースではなく一つの設定でバックアップモデルに戻せるようにする。
導入の提案
まず hailuo-2.3-fast/image-to-video のようなコストを抑えられるモデルで全経路を通し、アダプター層と指標の仕込みを整えてから、より上位の候補を徐々に導入して対照とする。選定の本質は制約下でのトレードオフであり、集約層があればこのトレードオフを低コストで繰り返し行える。
要件を分解し、ベースラインを立て、アダプター層を薄く作れば、あとはデータにどのモデルを使うかを決めさせればよい。