
Confronto e valutazione
Alternativa all'API di InfiniteTalk: genera avatar parlanti con sincronizzazione labiale usando heygen-avatar-v di hiapi
Niente deployment autonomo dei pesi aperti di InfiniteTalk: passa a un'API gestita — con output reali guidati da script e da audio.
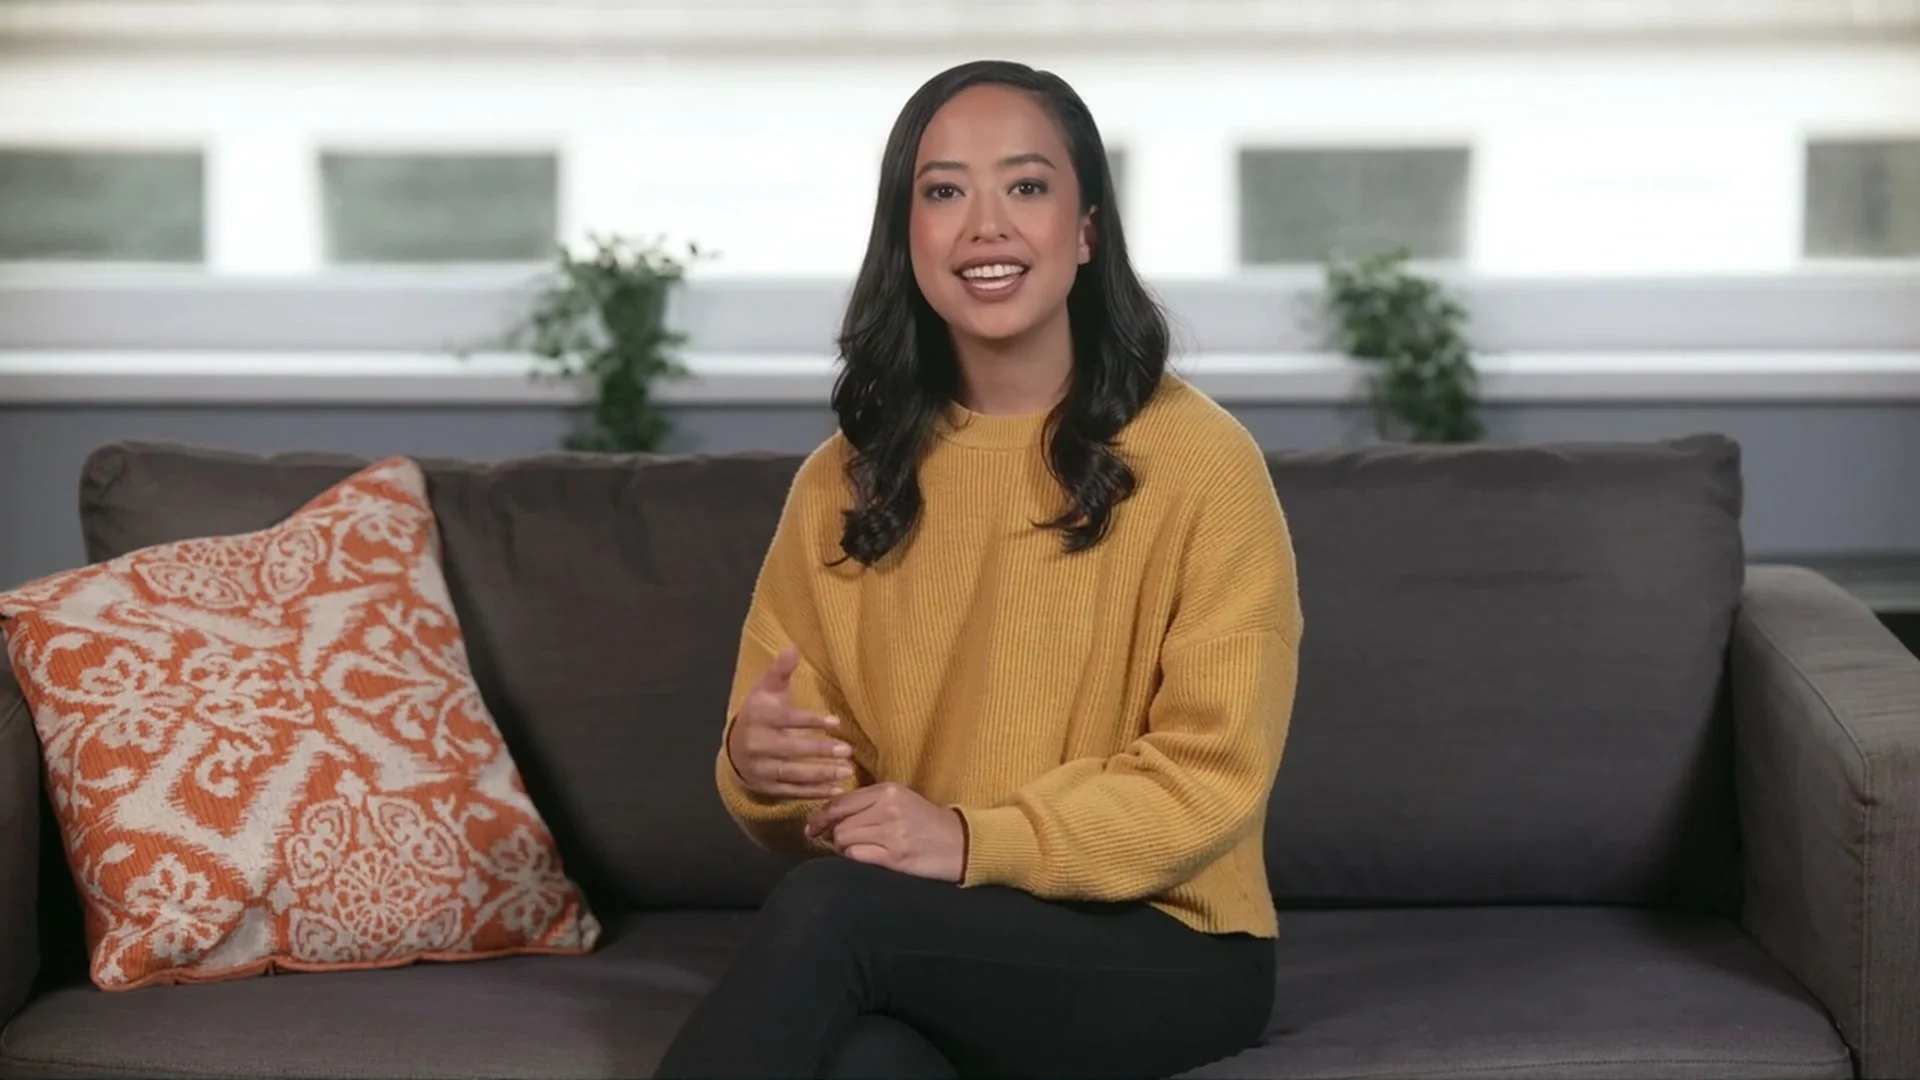
Se hai scoperto l'API di InfiniteTalk tramite la lista di un provider e vuoi ottenere video parlanti con sincronizzazione labiale senza allestire un ambiente GPU né impegnarti in un deployment con pesi aperti, ecco un confronto onesto. InfiniteTalk e heygen-avatar-v di hiapi risolvono problemi sovrapposti da direzioni opposte: InfiniteTalk è un modello video audio-driven a pesi aperti che puoi eseguire in autonomia o a cui puoi accedere tramite provider terzi; heygen-avatar-v è invece un'API gestita che trasforma script o tracce audio in video di un anchorman con sincronizzazione labiale, a un prezzo unificato di 0,15 dollari al secondo. Non sono alternative direttamente intercambiabili — e il punto in cui divergono è esattamente dove dovresti prendere la decisione. Sotto trovi due rendering reali di heygen-avatar-v.
Cosa significa realmente "API di InfiniteTalk"
InfiniteTalk è un modello video audio-driven open source rilasciato nel 2025. Il suo trucco distintivo è il doppiaggio video a frame sparsi: dagli un video esistente e una traccia audio e rigenererà i segmenti con una nuova sincronizzazione labiale, preservando la persona, lo sfondo e il movimento di camera originali — con una durata praticamente illimitata. Può funzionare anche come modello di generazione video da immagine più audio. Al momento della scrittura è disponibile per output a 480P e 720P.
Poiché i pesi sono aperti, "API di InfiniteTalk" non è un singolo endpoint ufficiale. È o il tuo deployment su GPU, oppure un provider terzo — WaveSpeed e distributori simili — che incapsula il modello e ti addebita un costo. Questa apertura è il suo richiamo: massimo controllo, possibilità di fine-tuning e, se possiedi l'hardware, nessun ricarico del fornitore al secondo. Ma è anche il suo costo operativo: devi mantenere modello, GPU e pipeline, oppure accettare il listino e le code del distributore.
Dove heygen-avatar-v è davvero un'alternativa — e dove non lo è
Prima chiariamo i confini, perché questa è la decisione stessa:
- heygen-avatar-v genera a partire da avatar predefiniti — 497 anchorman e 102 voci. Non doppia nuovamente un tuo specifico filmato esistente. Se il tuo compito principale è "prendi questo materiale reale e risincronizza la bocca con un nuovo audio", quello è il dominio video-to-video di InfiniteTalk, e heygen-avatar-v non è un suo sostituto.
- È invece una valida alternativa se: ciò che ti serve davvero è un video parlante con sincronizzazione labiale generato da uno script o da una traccia audio — video esplicativi, corsi, prodotti o annunci in stile UGC — heygen-avatar-v produce esattamente questo come API gestita, senza ospitare modelli e senza intermediari.
La maggior parte dei team che digitano "API di InfiniteTalk" nella barra di ricerca appartiene alla seconda categoria. Vogliono l'output — una clip parlante guidata da audio o testo — non l'obbligo di eseguire un modello diffusion in produzione. È proprio questo vuoto che heygen-avatar-v colma. Se invece hai specificamente bisogno di risincronizzare materiale girato da te con una nuova voce fuori campo, continua a usare il flusso di doppiaggio di InfiniteTalk; qui non c'è nulla che lo sostituisca.
Cosa può fare concretamente heygen-avatar-v
Una singola chiamata POST https://api.hiapi.ai/v1/tasks restituisce un video di un avatar con sincronizzazione labiale. Ci sono due modalità di guida:
- Guidata da script — passa
avatarpiùprompt(fino a 5.000 caratteri) evoiceopzionale; l'API legge lo script e sincronizza il movimento della bocca. - Guidata da audio — passa
avatarpiùaudio_url(fino a 600 secondi, 32 MiB) e omettiprompt/voice; l'avatar sincronizza le labbra con la tua registrazione esistente. Questa modalità si mappa in modo pulito sui flussi InfiniteTalk audio-first.
I controlli di output includono resolution (720p / 1080p / 4k), sei formati d'aspetto (incluso 9:16), output_format (mp4 / webm), caption: true per generare un file SRT allegato, oltre a fit, remove_background e override background. Il prezzo è unificato a 0,15 dollari per secondo di output — nessun ricarico per risoluzione, addebito sui secondi effettivamente renderizzati, rimborso per le attività fallite.
Dallo script all'anchorman
HeyGen Avatar V è ora disponibile su HiAPI. Crea video di anchorman raffinati da script o audio, con movimenti naturali e sottotitoli. Offerta di lancio: sconto del 20%.
Renderizzato con avatar: "Abigail Sofa Front" e voice: "Derya - Lifelike - Excited" a 1280×720 (versione web 720p). L'intera clip deriva da quello script — nessun materiale girato, nessun ritratto caricato.
Una versione pubblicitaria disinvolta e frontale
Un secondo rendering di heygen-avatar-v, un gancio di prodotto in stile UGC sciolto — il tipo di annuncio breve e dall'inquadratura informale per cui i team si rivolgono a strumenti di livello InfiniteTalk. Stessa API task, avatar predefinito e impostazioni diverse. Avvertenza onesta dai test: lo sfondo è fornito insieme all'avatar scelto, e l'override background non sempre riesce a sostituire la scena ripresa, quindi prima di una run di produzione prova con una clip breve la combinazione avatar più sfondo.
InfiniteTalk contro heygen-avatar-v: scegli in base a come vuoi gestirlo
| InfiniteTalk (pesi aperti) | heygen-avatar-v (hiapi) | |
|---|---|---|
| Modalità di esecuzione | Self-hosting sulla propria GPU, oppure distributore terzo | API gestita, una sola chiave hiapi |
| Punto di forza principale | Doppiaggio di video esistenti; durata illimitata | Genera video parlanti di avatar predefiniti da script o audio |
| Input di guida | Audio (+ video o immagine sorgente) | Script (prompt) o audio_url |
| Usare una propria persona sullo schermo | Sì — doppiaggio video-to-video | No — preset selezionati (con una singola foto si può usare Avatar IV) |
| Output | 480P / 720P | 720p / 1080p / 4k, sei formati d'aspetto, mp4/webm, sottotitoli SRT |
| Modello di costo | Tempo della tua GPU, oppure tariffe del distributore | Unificato a 0,15 dollari per secondo di output, rimborso per attività fallite |
| Carico operativo | Modelli e infrastruttura da mantenere | Nessuno — POST /v1/tasks |
La dimensione più importante è la prima riga. InfiniteTalk ti consegna il modello; heygen-avatar-v ti consegna il risultato. Se l'esigenza è doppiare il proprio materiale o una durata illimitata, esegui InfiniteTalk. Se l'esigenza è "generare un video parlante da script o audio, a consumo al secondo, con una sola chiave", heygen-avatar-v te lo consente senza toccare una GPU.
Una richiesta funzionante
L'analogia più vicina a un task InfiniteTalk audio-first è la modalità guidata da audio di heygen-avatar-v — la tua registrazione in input, un avatar sincronizzato in output:
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
Preferisci guidare da testo, in verticale e con sottotitoli burn-in? Sostituisci audio_url con uno script:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Riley Casual Front",
      "prompt": "Il nuovo prodotto è appena arrivato. Scorri e acquista subito!",
      "voice": "Charming Charles - Friendly",
      "aspect_ratio": "9:16",
      "resolution": "1080p",
      "caption": true,
      "output_format": "mp4"
    }
  }'
Salva data.taskId, interroga GET /v1/tasks/{taskId} finché status non diventa success, poi scarica ogni elemento di output[] prima del relativo expireAt (video e, se abilitato, il file SRT caption). È lo stesso schema basato su task di tutti gli altri modelli video della piattaforma — per la struttura condivisa di richiesta e risposta vedi la guida rapida all'API asincrona unificata, e per l'elenco completo degli avatar e delle voci predefinite vedi la pagina del modello heygen-avatar-v.
Domande frequenti
heygen-avatar-v può doppiare nuovamente un video che ho già? No. Quel doppiaggio olistico e identitario di materiale esistente è specialità di InfiniteTalk. heygen-avatar-v genera da avatar predefiniti selezionati. Se ti serve solo animare un singolo ritratto statico, Avatar IV è la soluzione sorella guidata da foto; nessuno dei due è uno strumento di doppiaggio video-to-video.
Posso guidare con un mio audio invece che con uno script?
Sì. Passa audio_url (fino a 600 secondi, 32 MiB) e ometti prompt e voice. L'avatar sincronizzerà direttamente le labbra con la tua registrazione.
Quanto costa? Unificato a 0,15 dollari per secondo di output, identico per 720p, 1080p e 4k, addebitato sui secondi effettivamente renderizzati. Rimborso per le attività fallite.
Quali risoluzioni e formati d'aspetto sono disponibili?
720p, 1080p e 4k, con sei formati d'aspetto: 16:9, 9:16, 4:5, 5:4, 1:1 e auto.
Devo ospitare o mantenere qualcosa? No. heygen-avatar-v è un'API gestita che usa la chiave hiapi che hai già — niente pesi, niente GPU, nessuna registrazione separata. Rispetto a eseguire InfiniteTalk in autonomia, questo è il compromesso principale.
Inizia
Se il tuo vero obiettivo è generare un video parlante con sincronizzazione labiale da uno script o da un file audio — non ospitare un modello — heygen-avatar-v è la strada più breve. Scegli un anchorman e una voce sulla pagina del modello heygen-avatar-v, abbozza una riga di script, poi collega la task API alla tua pipeline. Per un approfondimento mirato ai social media, vedi trasformare uno script in un video parlato breve; se stai ancora valutando strumenti per avatar gestiti o basati su postazione, i confronti con Synthesia e Hedra coprono quei compromessi.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Confronto e valutazione
Confronto orizzontale di Seedream 5.0 Pro image-to-image: capacità, prezzi e consigli per la scelta