
Guide d'utilisation
Guide de prise en main de qwen-image-3.0-pro/text-to-image : capacités, tarification et intégration pratique
Des limites de capacités à la facturation à l'image, pour que les développeurs intègrent rapidement un modèle text-to-image
Quels problèmes ce modèle permet de résoudre
qwen-image-3.0-pro/text-to-image est un modèle purement text-to-image : il prend un prompt texte en entrée et produit une image. Il ne fait que du text-to-image, sans image-to-image, sans édition d'image (inpainting/outpainting), sans transfert de style. Si votre besoin produit implique une interaction du type « téléverser une image puis la retoucher », c'est que le choix du modèle est inadapté : il faut chercher un modèle doté de capacités d'édition, et non empiler tant bien que mal des prompts sur celui-ci.
Trois catégories de cas d'usage lui conviennent.
Visuels marketing et opérationnels
Images de fond d'affiche, arrière-plans de bannières d'événement, illustrations pour réseaux sociaux : ces besoins se caractérisent par le volume, une cohérence de style et une tolérance élevée sur la précision de chaque image. Avec des prompts structurés, on obtient de façon stable des visuels exploitables, que le design retravaille ensuite en mise en page.
Images de remplacement et supports de prototype
Les prototypes produit, les démos et les environnements de test ont besoin de nombreuses images de remplacement. Les générer à la demande par text-to-image est plus flexible que de maintenir une bibliothèque d'assets statiques, et évite les problèmes de provenance incertaine des droits.
Ébauches conceptuelles et exploration d'inspiration
Avant la conception formelle, le text-to-image permet d'explorer rapidement plusieurs directions visuelles et d'aider l'équipe à converger tôt sur un style. La valeur de ce type de scénario réside dans l'ampleur, pas dans la qualité de la version finale.
Scénarios inadaptés
- Tâches d'édition qui doivent préserver la structure de l'image d'origine ou l'identité d'une personne ;
- Images de mise en page exigeant une grande précision de rendu du texte ;
- Création interactive nécessitant plusieurs cycles de retouches locales.
Le critère peut se résumer en une phrase : le besoin se limite-t-il à « du texte en entrée, une image en sortie » ? Si oui, le modèle convient ; dès qu'apparaît « transformer une image existante », il ne convient pas.
Comment estimer les coûts avec une facturation à l'image
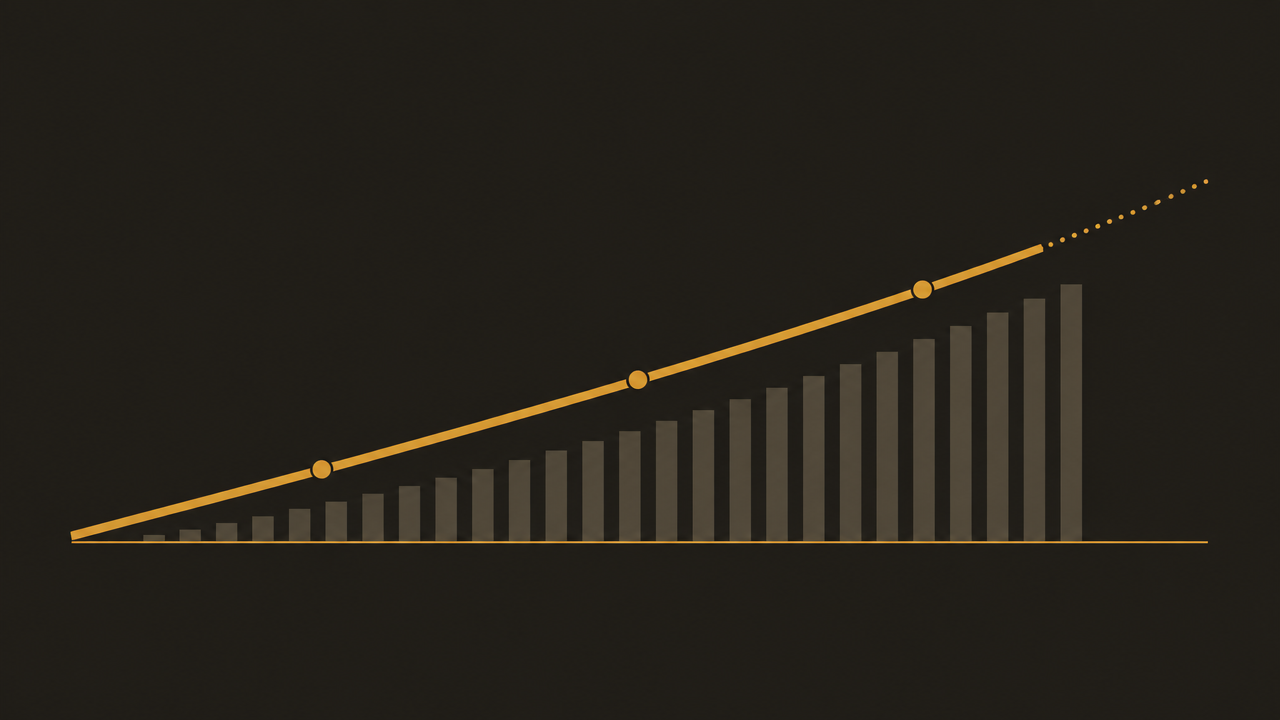
Ce modèle est facturé au nombre d'images générées : chaque image générée avec succès est facturée une fois. Le coût total est donc linéaire par rapport au nombre d'appels, et le modèle d'estimation est très simple :
coût total ≈ nombre d'images générées avec succès × prix unitaire par image
Le prix unitaire exact est celui affiché dans le panneau tarifaire du site ; cet article ne fige pas de chiffre afin d'éviter que la documentation ne devienne obsolète après un ajustement tarifaire. Pour établir un budget, il suffit de reprendre la valeur actuelle du panneau et de l'injecter dans la formule.
Ce que signifie une croissance linéaire
La courbe de coût est une droite passant par l'origine, sans palier de remise sur lequel compter ni effet de lissage du type « plus on consomme, moins c'est cher ». Le cœur du contrôle budgétaire n'est donc pas de réduire le prix unitaire, mais de réduire les appels inutiles.
Trois facteurs qui font déraper les coûts
- L'amplification par les nouvelles tentatives. Une requête échouée relancée automatiquement trois fois, si chaque tentative déclenche réellement une génération, représente trois images sur la facture. La stratégie de retry doit être alignée sur la logique de facturation.
- L'essai effréné de prompts pendant le débogage. En phase de développement, les ajustements répétés de paramètres font facilement exploser le nombre d'images sur une journée. Il est conseillé de fixer un quota journalier pour l'environnement de débogage.
- La régénération de contenus identiques. Un même prompt avec les mêmes paramètres produit des images strictement identiques ; ces appels doivent être interceptés par le cache.
Méthode d'estimation
Déterminez d'abord côté métier le « volume quotidien d'images utiles », multipliez par un « coefficient d'échec et de retry » (1,3 à 1,5 peut être prudent au début) pour obtenir la fourchette du nombre d'images facturées, puis appliquez le prix unitaire. Après la mise en production, recalculez le coefficient à partir des factures réelles et corrigez-le mois après mois.
Moyens de contrôle
- Normaliser les prompts : une entrée de même sémantique qui touche le cache renvoie directement le résultat existant ;
- Stocker les résultats de génération dans un stockage objet, indexer par hash de contenu, et servir les requêtes répétées depuis le cache de lecture ;
- Fixer une limite de concurrence et un plafond total d'images pour les tâches par lots, afin d'éviter les scripts emballés.
L'avantage de la facturation à l'image est sa forte prévisibilité ; l'inconvénient est l'absence d'économie d'échelle. La conception du cache et de la déduplication côté ingénierie détermine donc directement le coût unitaire métier.
Processus d'intégration et points clés des paramètres
L'intégration passe par l'interface unifiée de HiAPI.ai, sans avoir à connecter séparément chaque fournisseur en amont. Le chemin minimal se décompose en quatre étapes.
Étape 1 : obtenir une clé
Créez une clé API dans la console, en émettant une clé distincte par environnement (développement/préproduction/production) pour faciliter ensuite le suivi des quotas et le regroupement des factures par clé. La clé reste uniquement côté serveur, sans être distribuée au client.
Étape 2 : confirmer l'identifiant du modèle
Utilisez l'identifiant de modèle qwen-image-3.0-pro/text-to-image lors de l'appel. Attention, la barre oblique fait partie de l'identifiant : ne la séparez pas et ne la réécrivez pas.
Étape 3 : lancer la première requête
Le corps de requête minimal se compose de l'identifiant de modèle et d'un prompt :
{
  "model": "qwen-image-3.0-pro/text-to-image",
  "prompt": "a minimal flat-design illustration of a mountain lake at dawn, soft gradient sky"
}
La réponse renvoie les données de l'image (URL ou base64, selon le format de retour de l'interface) ; transférez-les immédiatement vers votre propre stockage, sans dépendre durablement d'un lien temporaire.
Étape 4 : traiter les réponses et les erreurs
Distinguez trois types de résultats : génération réussie, erreur de paramètre (4xx, à ne pas relancer), erreur serveur ou de limitation de débit (5xx/429, relançable avec backoff). Seule la troisième catégorie entre dans la file de retry.
Points à surveiller lors des appels
- Longueur et langue du prompt : une description structurée et précise, en anglais ou en chinois, convient ; évitez d'empiler des adjectifs sans signification ;
- Forme de sortie : vérifiez à l'avance si l'interface renvoie des données binaires directement persistables ou un lien nécessitant un second téléchargement ;
- Idempotence : associez un ID métier unique à chaque requête métier, pour dédupliquer lors des retries et éviter une double facturation ;
- Délai d'expiration : la génération d'image est plus longue qu'une interface texte classique ; le délai côté client doit garder une marge suffisante, sinon vous gaspillerez des générations « côté serveur terminées, côté client abandonnées ».
Une fois le premier appel réussi, il est conseillé d'établir une base de référence avec quelques prompts de smoke test fixes : toute évolution ultérieure de paramètres ou de version pourra être comparée à cette base pour déterminer si le problème vient de la couche d'intégration.
Conception de prompts et réglage des résultats
Le taux d'exploitabilité du text-to-image dépend fortement de la qualité du prompt. Dans un contexte de facturation à l'image, une génération inutile est un coût réel ; le réglage des prompts doit donc être traité comme un problème d'ingénierie, non comme une question mystique.
Du flou à la structure
Le problème d'un prompt flou n'est pas d'être « pas assez beau », mais d'être non reproductible. Décomposer la description en quelques dimensions stables fait nettement converger le résultat :
- Sujet : quoi dessiner ; un sujet unique vaut mieux que plusieurs ;
- Style : illustration, réaliste, plat, aquarelle, etc. ;
- Composition et angle de vue : gros plan, panoramique, vue plongeante ;
- Lumière et tonalité : douce, fort contraste, couleurs froides ;
- Arrière-plan et espaces vides : fond épuré nécessaire ou non pour la mise en page ultérieure.
Boucle d'itération
La boucle de réglage recommandée : définir un prompt de référence → modifier une seule variable → consigner le résultat → converger vers un modèle. Ne changer qu'une dimension à la fois permet de savoir quel mot a fait la différence. Capitalisez les modèles validés dans une bibliothèque de prompts, que le métier appelle par scénario au lieu de réécrire à chaque fois depuis zéro.
Comment réduire les appels inutiles
- Sondage à petite échelle : pour un nouveau scénario, validez d'abord la direction avec un petit nombre d'images, puis montez en volume ;
- Descriptions négatives : indiquez clairement ce que vous ne voulez pas (pas de texte, pas de filigrane), ce qui économise plus d'appels que de répéter des descriptions positives ;
- Modélisation : figez les prompts stables et efficaces en modèles paramétrés, pour réduire l'aléatoire ;
- Contrôle humain par échantillonnage : inspectez une proportion des résultats, mesurez le taux d'exploitabilité et utilisez-le comme base pour poursuivre ou non le réglage.
Quand arrêter le réglage
Lorsque le taux d'exploitabilité entre en plateau et que le gain marginal d'une modification de prompt devient inférieur à son coût, passez aux moyens d'ingénierie : changer de modèle de composition, ajouter du post-traitement, ou réduire le périmètre de ce scénario. L'objectif du réglage est « suffisant et stable », pas la perfection sur chaque image.
Retry en cas d'échec, délais d'expiration et stockage des résultats
La génération d'image est typiquement une opération lente ; l'insérer de façon synchrone dans la chaîne métier principale est une source classique d'incidents. Côté ingénierie, il faut concevoir les points suivants avant l'intégration.
Passage en tâches asynchrones
La requête client se contente de créer une tâche et de renvoyer un ID de tâche ; la génération réelle est consommée par un worker d'arrière-plan via une file. La chaîne principale n'est pas bloquée, et un échec de génération n'affecte pas les autres opérations de l'utilisateur. Le client récupère le résultat par polling ou callback.
Stratégie de retry
- Ne relancer que les erreurs relançables (timeout, 5xx, limitation de débit) ; les erreurs de paramètre échouent directement ;
- Adopter un backoff exponentiel avec gigue aléatoire pour éviter que des retries instantanés saturent le quota ;
- Fixer un nombre maximal de tentatives, au-delà duquel la tâche part en file de messages morts pour analyse humaine ;
- Dédupliquer via un ID d'idempotence métier pour empêcher que les retries produisent des images facturées en double.
Délais d'expiration et concurrence
La durée de génération varie sensiblement ; le seuil de timeout doit être fixé sur des quantiles, non sur une moyenne. La limite de concurrence doit être alignée sur le quota du compte ; en cas d'accumulation dans la file, privilégier la dégradation plutôt qu'un retry infini.
Stockage des résultats
Dès réception de l'image, transférez-la immédiatement vers votre stockage objet et enregistrez les métadonnées : prompt, paramètres, heure de génération, ID métier, hash de contenu. Le hash de contenu sert à la déduplication et aux hits de cache, l'ID métier au rapprochement. N'inscrivez pas les liens temporaires dans la base de données comme dépendance durable.
Rapprochement
Comparez régulièrement le « nombre d'images demandées » enregistré côté métier avec le « nombre d'images facturées » côté facturation ; un écart persistant et important indique un problème dans la logique de retry ou de déduplication. Ce contrôle doit intégrer l'exploitation courante, plutôt que d'attendre la fin du mois pour découvrir l'anomalie sur la facture.
L'idée centrale de cette conception : découpler la capacité de génération du métier, pour que les opérations lentes, les échecs et les retries restent dans un périmètre maîtrisé.
Liste de contrôle avant mise en production
Une intégration terminée ne signifie pas que l'on peut mettre en production. Il est conseillé de cocher cette liste point par point ; tant qu'un élément n'est pas confirmé, ne montez pas en charge.
Capacités et choix de modèle
- Il est confirmé que le métier ne dépend que du text-to-image, sans besoin d'édition introduit par erreur ;
- Les scénarios inadaptés sont identifiés et un message de repli a été prévu côté produit ;
- La qualité de sortie a été validée avec des prompts de référence comme atteignant le seuil minimal métier.
Coûts
- L'estimation budgétaire a été réalisée avec le prix unitaire actuel du panneau tarifaire du site ;
- Des quotas journaliers/mensuels d'images et des seuils d'alerte sont définis ;
- Le cache de résultats et la déduplication de contenu sont en place : les requêtes répétées ne sont pas facturées deux fois ;
- L'environnement de débogage dispose d'un quota distinct et ne pollue pas la facture de production.
Stabilité
- La génération passe par une file asynchrone, sans blocage synchrone de la chaîne principale ;
- Le retry ne couvre que les erreurs relançables, avec backoff et plafond ;
- L'ID d'idempotence est implémenté : un retry ne produit pas de tâche en double ;
- Le seuil de timeout est fixé sur des quantiles et validé par tests de charge.
Données et exploitation
- Les images sont transférées vers un stockage propre, avec métadonnées complètes ;
- Les clés sont isolées par environnement et détenues uniquement côté serveur ;
- Un mécanisme de rapprochement régulier entre images demandées et images facturées existe ;
- La file de messages morts a un responsable et un processus de traitement.
Observabilité
- Les indicateurs clés (taux de succès, durée moyenne, taux de retry, taux de hits de cache) sont intégrés à la supervision ;
- Les échantillons d'échec sont traçables jusqu'au prompt et aux paramètres précis.
Parcourir cette liste permet généralement d'exposer à l'avance la plupart des pièges. Les capacités du modèle sont déjà encapsulées sur HiAPI.ai ; les risques restants se situent essentiellement dans l'ingénierie et la gestion des coûts — en consolidant ces deux volets, la capacité text-to-image s'intègre durablement dans le produit. Bonne mise en production.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax