
Guida all'uso
Guida introduttiva a qwen-image-3.0-pro/text-to-image: capacità, prezzi e pratica di integrazione
Dai confini delle capacità alla tariffazione per immagine, per integrare rapidamente il modello text-to-image
Quali problemi risolve questo modello
qwen-image-3.0-pro/text-to-image è un modello puramente text-to-image: riceve in input un prompt testuale e restituisce un'immagine. Fa solo text-to-image, non include image-to-image, editing delle immagini (inpainting/outpainting), trasferimento di stile e capacità simili. Se nella tua esigenza di prodotto compare un'interazione del tipo «carica un'immagine e modificala un po'», la scelta è già sbagliata: serve un altro modello con capacità di editing, non puoi forzare il tutto accumulando prompt su questo modello.
Gli scenari adatti sono tre tipi.
Materiali visivi per marketing e operations
Immagini di base per poster, sfondi per banner di campagne, illustrazioni per i social: esigenze caratterizzate da volumi elevati, stile uniforme e tolleranza relativamente alta sulla precisione della singola immagine. Con prompt strutturati si ottengono materiali utilizzabili in modo stabile, poi il design si occupa dell'impaginazione secondaria.
Immagini segnaposto e materiali per prototipi
Prototipi di prodotto, demo e ambienti di test richiedono molti segnaposto. Generarli on demand con il puro text-to-image è più flessibile che mantenere una libreria statica di materiali, ed evita anche problemi di provenienza incerta dei diritti d'autore.
Bozze concettuali ed esplorazione di idee
Prima del design definitivo, il text-to-image permette di esplorare rapidamente più direzioni visive, aiutando il team a convergere sullo stile in fase iniziale. Il valore di questi scenari sta nell'«ampiezza», non nella «qualità della versione finale».
Scenari non adatti
- Attività di editing che richiedono di preservare la struttura dell'immagine originale o l'identità delle persone;
- Immagini tipografiche con requisiti rigidi sulla precisione del rendering del testo;
- Creazione interattiva con modifiche locali in più round.
Il criterio di valutazione si può semplificare in una frase: l'esigenza richiede solo «testo in ingresso, immagine in uscita»? Se sì, il modello è adatto; se compare «trasformare un'immagine già esistente», non lo è.
Come stimare i costi con la tariffazione per immagine
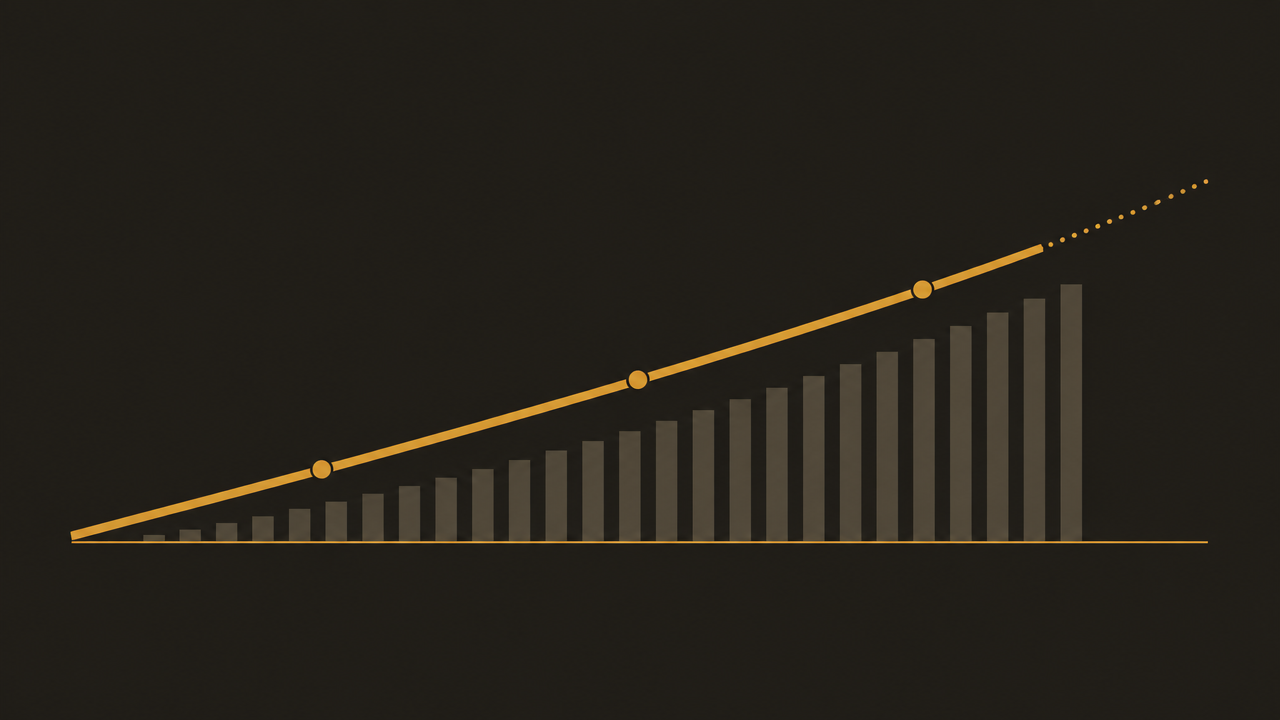
Il modello fattura in base al numero di immagini generate: ogni immagine generata con successo viene addebitata una volta. Il costo totale è quindi linearmente proporzionale al numero di chiamate, e il modello di stima è molto semplice:
costo totale ≈ numero di immagini generate con successo × prezzo per immagine
Il prezzo unitario specifico va preso dal pannello prezzi del sito; questo articolo non fissa numeri per evitare che il documento diventi obsoleto dopo un aggiornamento dei prezzi. Per fare budget basta inserire nella formula il valore attuale del pannello.
Cosa significa la crescita lineare
La curva dei costi è una retta che passa per l'origine: non ci sono sconti a scaglioni su cui contare né un margine «più usi, meno paghi». Il cuore del controllo di budget non è quindi abbassare il prezzo unitario, ma ridurre le chiamate inutili.
Tre fattori che fanno esplodere i costi
- Amplificazione dei retry. Se una richiesta fallita viene ritentata automaticamente tre volte e ogni tentativo genera effettivamente un'immagine, in fattura risultano tre immagini. La strategia di retry deve essere allineata alla modalità di fatturazione.
- Prove di prompt senza limiti in fase di debug. Durante lo sviluppo, modificare ripetutamente i parametri può facilmente produrre in un giorno un numero di immagini molto superiore al previsto. Si consiglia di impostare una quota giornaliera per l'ambiente di debug.
- Generazione ripetuta dello stesso contenuto. Gli stessi prompt e parametri producono immagini identiche: queste chiamate vanno intercettate dalla cache.
Metodo di stima
Definisci prima dal lato business il «volume giornaliero medio di immagini utili», poi moltiplicalo per il «coefficiente di fallimenti e retry» (inizialmente si può assumere prudenzialmente 1,3–1,5), ottenendo l'intervallo di immagini fatturate, e infine inserisci il prezzo unitario. Dopo il go-live, ricava il coefficiente a posteriori dalla fattura reale e correggilo mese per mese.
Strumenti di controllo
- Normalizza i prompt: input con lo stesso significato che colpiscono la cache restituiscono direttamente il risultato esistente;
- Salva i risultati generati nell'object storage, indicizzandoli per hash del contenuto, e servi le richieste ripetute dalla cache in lettura;
- Imposta limiti di concorrenza e di numero totale di immagini per le attività batch, evitando che gli script vadano fuori controllo.
Il vantaggio della tariffazione per immagine è l'elevata prevedibilità; lo svantaggio è l'assenza di economie di scala, per cui il design di caching e deduplicazione lato engineering determina direttamente il costo unitario del business.
Processo di integrazione e punti chiave sui parametri
L'integrazione avviene tramite l'interfaccia unificata di HiAPI.ai, senza dover collegare separatamente i vari fornitori upstream. Il percorso minimo si articola in quattro passi.
Primo passo: ottenere la chiave
Crea una API Key nella console, emettendola separatamente per ambiente (sviluppo/pre-produzione/produzione), così da poter gestire in seguito quote e rendicontazione per chiave. La chiave va tenuta solo lato server, non distribuita al client.
Secondo passo: confermare l'identificativo del modello
Nella chiamata usa l'identificativo di modello qwen-image-3.0-pro/text-to-image. Attenzione: la barra fa parte dell'identificativo, non separarla né riscriverla.
Terzo passo: effettuare la prima richiesta
La struttura minima del corpo della richiesta è l'identificativo del modello più un prompt:
{
  "model": "qwen-image-3.0-pro/text-to-image",
  "prompt": "a minimal flat-design illustration of a mountain lake at dawn, soft gradient sky"
}
La risposta restituisce i dati dell'immagine (URL o base64, a seconda del formato di risposta dell'interfaccia); appena ricevuti, trasferiscili subito nel tuo storage, senza dipendere a lungo da link temporanei.
Quarto passo: gestire risposte ed errori
Distingui tre tipi di esito: generazione riuscita, errore di parametri (4xx, da non ritentare), errore lato server o di rate limiting (5xx/429, ritentabile con backoff). Solo la terza categoria entra nella coda dei retry.
Punti da tenere presenti durante le chiamate
- Lunghezza e lingua del prompt: descrizioni strutturate e concrete, in inglese o cinese, vanno bene; evita di accumulare aggettivi privi di significato;
- Formato di output: verifica in anticipo se l'interfaccia restituisce binari direttamente persistibili o link da scaricare in un secondo momento;
- Idempotenza: associa a ogni richiesta di business un ID univoco, usato per deduplicare nei retry ed evitare addebiti duplicati;
- Timeout: la generazione di immagini richiede più tempo di una normale interfaccia testuale; lascia un margine sufficiente nel timeout del client, altrimenti si verificano sprechi del tipo «il server ha già generato l'immagine, il client ha già rinunciato».
Dopo il primo funzionamento, si consiglia di stabilire una baseline con pochi prompt di smoke test fissi; in seguito, per qualsiasi variazione di parametri o versione, confronta con la baseline per capire se il problema è nello strato di integrazione.
Design dei prompt e ottimizzazione dei risultati
Il tasso di utilizzabilità del text-to-image dipende fortemente dalla qualità del prompt. Nel contesto della tariffazione per immagine, una generazione inutile è un costo reale, quindi l'ottimizzazione dei prompt va trattata come un problema di engineering e non come una questione mistica.
Dal vago allo strutturato
Il problema dei prompt vaghi non è «non essere abbastanza belli», ma non essere riproducibili. Scomporre la descrizione in alcune dimensioni stabili fa convergere sensibilmente il risultato:
- Soggetto: cosa disegnare; un singolo soggetto è preferibile a più soggetti;
- Stile: illustrazione, realistico, flat, acquerello, ecc.;
- Composizione e punto di vista: primo piano, panorama, vista dall'alto;
- Luce e toni: morbidi, alto contrasto, colori freddi;
- Sfondo e spazio vuoto: se serve uno sfondo pulito per l'impaginazione successiva.
Ciclo iterativo
Il ciclo di ottimizzazione consigliato è: definire il prompt di baseline → modificare una sola variabile → registrare il risultato → convergere verso un template. Modificando ogni volta una sola dimensione si può capire quale parola ha avuto effetto. Consolida i template validati in una libreria di prompt, che il business richiama per scenario invece di scrivere ogni volta da zero.
Come ridurre le chiamate inutili
- Piccoli test esplorativi: per un nuovo scenario, verifica prima la direzione con un piccolo numero di immagini, poi aumenta il volume dopo la conferma;
- Descrizioni negative: specificare cosa non si vuole (ad esempio, niente testo, niente filigrana) fa risparmiare chiamate rispetto a ripetere descrizioni positive;
- Templating: fissare i prompt stabili ed efficaci in template parametrici, riducendo la casualità;
- Controllo a campione manuale: ispeziona a campione una percentuale dell'output e calcola il tasso di utilizzabilità come base per decidere se continuare a ottimizzare.
Quando smettere di ottimizzare
Quando il tasso di utilizzabilità entra in una fase di plateau e il beneficio marginale di modificare ulteriormente il prompt scende sotto il costo, conviene passare a mezzi di engineering: cambiare template di composizione, aggiungere post-processing o ridurre l'ambito di applicazione dello scenario. L'obiettivo dell'ottimizzazione è «sufficiente e stabile», non la perfezione su ogni immagine.
Retry dei fallimenti, timeout e archiviazione dei risultati
La generazione di immagini è un'operazione tipicamente lenta; inserirla in modo sincrono nella catena principale di business è una fonte comune di incidenti. Lato engineering, prima dell'integrazione vanno progettati i seguenti aspetti.
Trasformazione in attività asincrona
La richiesta del client si limita a creare l'attività e restituire l'ID attività; la generazione vera e propria è eseguita da worker in background che consumano la coda. La catena principale non si blocca e un fallimento della generazione non impatta le altre operazioni dell'utente. Il client ottiene il risultato tramite polling o callback.
Strategia di retry
- Ritenta solo per errori ritentabili (timeout, 5xx, rate limiting); gli errori di parametri falliscono direttamente;
- Usa backoff esponenziale con jitter casuale, evitando che retry istantanei saturino la quota;
- Imposta un numero massimo di retry; superato il limite, passa alla coda dei messaggi morti per l'analisi manuale;
- Deduplica tramite ID idempotente di business, evitando che i retry producano immagini fatturate in duplicato.
Timeout e concorrenza
Il tempo di generazione varia molto; la soglia di timeout va impostata sui percentili, non sulla media. Il limite di concorrenza va allineato alla quota dell'account; quando la coda si accumula, privilegia il degrado invece di retry infiniti.
Archiviazione dei risultati
Appena ricevuta l'immagine, trasferiscila subito nel tuo object storage e registra i metadati: prompt, parametri, data di generazione, ID di business, hash del contenuto. L'hash del contenuto serve per deduplicazione e hit della cache, l'ID di business per la riconciliazione. Non scrivere link temporanei nel database come dipendenza di lungo periodo.
Riconciliazione
Confronta periodicamente il «numero di immagini richieste» registrato lato business con il «numero di immagini fatturate» lato fatturazione; uno scostamento persistente e ampio indica problemi nella logica di retry o deduplicazione. Questo controllo va inserito nelle attività operative quotidiane, non bisogna aspettare la fine del mese guardando la fattura per scoprire anomalie.
L'idea centrale di questo design è: disaccoppiare la capacità di generazione dal business, facendo sì che operazioni lente, fallimenti e retry avvengano entro confini controllabili.
Checklist prima del go-live
Completare l'integrazione non significa essere pronti al go-live. Si consiglia di spuntare voce per voce la seguente checklist; se una voce non è confermata, non aumentare il volume.
Capacità e scelta del modello
- Confermato che il business dipende solo da text-to-image, senza esigenze di editing mescolate;
- Definiti gli scenari non adatti, con messaggi di fallback lato prodotto;
- Verificata con prompt di baseline la qualità dell'output rispetto alla soglia minima di business.
Costi
- Stima di budget completata usando il prezzo unitario attuale del pannello prezzi del sito;
- Impostate quote giornaliere/mensili di immagini e soglie di allarme;
- Implementate cache dei risultati e deduplicazione dei contenuti, per non addebitare due volte richieste ripetute;
- L'ambiente di debug ha una quota separata e non inquina la fatturazione di produzione.
Stabilità
- La generazione passa da una coda asincrona, senza blocchi sincroni nella catena principale;
- I retry coprono solo errori ritentabili, con backoff e limite massimo;
- Gli ID idempotenti sono implementati, i retry non producono attività duplicate;
- Le soglie di timeout sono impostate sui percentili e verificate con test di carico.
Dati e operations
- I risultati immagine sono stati trasferiti nello storage proprietario, con metadati completi;
- Le chiavi sono isolate per ambiente e detenute solo lato server;
- Esiste un meccanismo periodico di riconciliazione tra immagini richieste e immagini fatturate;
- La coda dei messaggi morti ha un responsabile e un processo di gestione.
Osservabilità
- Gli indicatori chiave (tasso di successo, tempo medio, tasso di retry, hit rate della cache) sono collegati al monitoraggio;
- I campioni di fallimento sono riconducibili al prompt e ai parametri specifici.
Passare in rassegna la checklist di solito fa emergere in anticipo la maggior parte dei problemi. La capacità del modello è già incapsulata su HiAPI.ai; i rischi restanti sono essenzialmente nella gestione engineering e dei costi: consolidando bene questi due aspetti, la capacità text-to-image può entrare stabilmente nel prodotto. Buon go-live.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori