
Tutoriel
API Vidu de génération de vidéo à partir de références en pratique : points d'intégration pour 5 scénarios métier à forte valeur
De la structure des supports à la chaîne d'appels : ancrer « image de référence / vidéo de référence → vidéo » dans de vrais métiers
Sur cette page
Différences d'ingénierie entre la génération de vidéo à partir de références et la génération à partir de texte
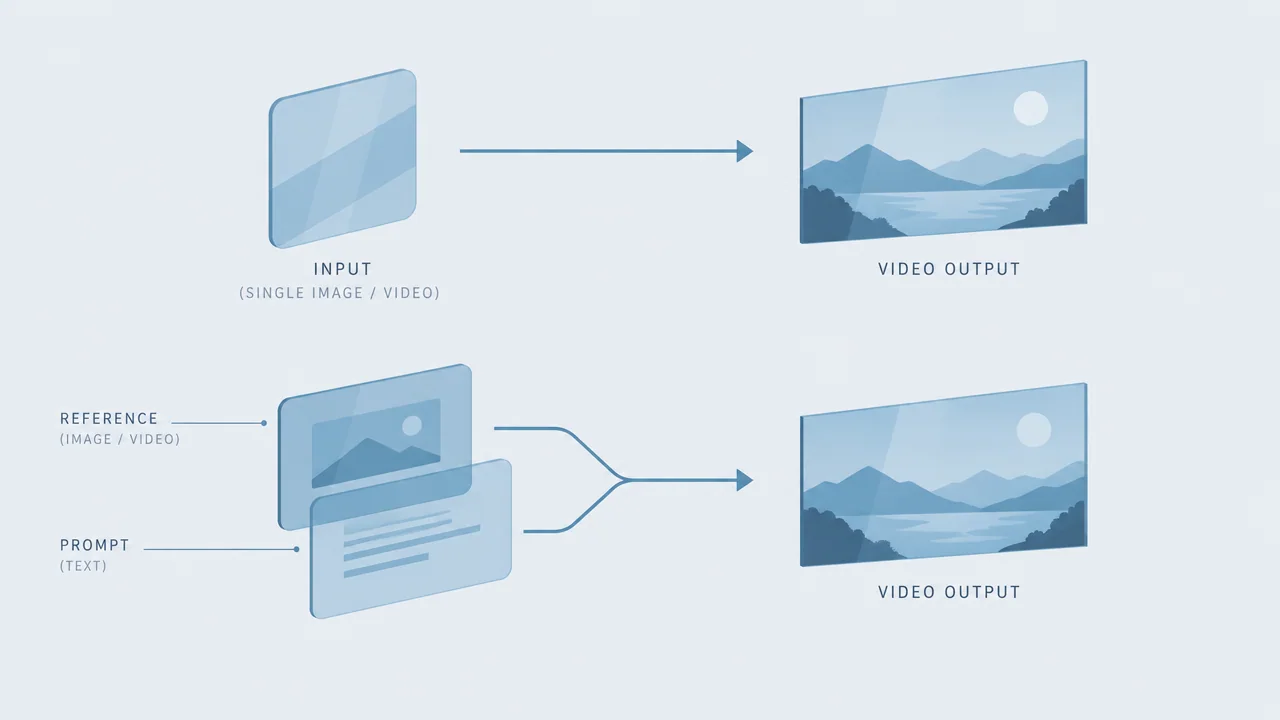
Avant d'intégrer vidu-q3-ad/reference-to-video dans un produit, la première chose à faire est de corriger une intuition : il ne s'agit pas d'un « text-to-video mieux écrit », mais d'un modèle dont la structure d'entrée a changé. La seule entrée du text-to-video est le prompt, et l'effort d'ingénierie se concentre naturellement sur l'optimisation des invites ; la génération à partir de références ajoute une branche de supports de référence — une image ou une vidéo sert d'ancrage pour le sujet et le style, et le prompt se réduit à décrire « ce qui doit se passer », et non « à quoi cela ressemble ».
Cette différence réécrit directement la chaîne d'intégration :
- La chaîne des supports devient un citoyen de première classe : le téléversement, la validation, le stockage et le numéro de version des supports de référence doivent être gérés comme des modèles de prompt ; sinon, lorsque le même code produit des résultats différents, vous ne pouvez pas en attribuer la cause.
- Le rôle du prompt se resserre : confiez l'apparence du sujet aux supports de référence ; le prompt ne décrit que l'action, la caméra, le rythme et la scène, ce qui réduit la volatilité du type « la même phrase change de visage à chaque génération ».
- La sortie reste une vidéo : tâches asynchrones, interrogation répétée (polling) et écriture des résultats sur disque sont identiques au text-to-video, et le cadre de tâches existant peut être réutilisé.
Les limites de capacité doivent aussi être alignées à l'avance : ce que le modèle peut garantir, c'est la continuité dans la vidéo finale du sujet et du style exprimés par les supports de référence, et non une reproduction au pixel près ni un complément inventé de contenus absents des supports de référence. Pour tous les scénarios où le métier exige « 100 % identique à l'image de référence », il faut d'abord déclasser le critère de validation en « cohérence subjective atteinte ».
Par conséquent, la première question pour décider d'intégrer ou non n'est pas « l'effet est-il impressionnant », mais « la valeur métier de la cohérence du sujet est-elle supérieure au coût d'une génération et au coût du contrôle manuel par échantillonnage ». Ce critère de décision traversera tous les scénarios ci-dessous.
Scénario 1 : vidéos publicitaires multi-versions pour produits et supports de diffusion
Les supports de diffusion sont le scénario d'application le plus direct de la génération à partir de références : l'apparence du produit est relativement fixe, et ce dont on a besoin, c'est de plusieurs versions courtes d'une même vidéo produit, pour des tests A/B sur différentes audiences, différents arguments de vente et différents emplacements.
Préparation des supports
- Pour chaque produit, maintenir un ensemble de supports de référence principaux (images multi-angles ou une vidéo de présentation), avec un numéro de version fixe, par exemple
sku_1024_ref_v3. Toute mise à jour des supports incrémente le numéro de version, et les anciennes versions sont conservées pour permettre le retour en arrière. - La qualité des supports de référence détermine directement la qualité du résultat : des supports avec un sujet centré, un éclairage uniforme, un fond propre et sans occlusion donnent une stabilité nettement meilleure. Pour un même SKU, ne mélangez pas des supports de référence issus de lots de tournage différents, sinon la couleur et la texture du sujet dériveront d'une version à l'autre.
Chaîne d'appels
La chaîne minimale est : lire les supports de référence du SKU → assembler le prompt selon le modèle d'argument de vente (action, caméra, scène, durée) → soumettre la tâche de génération → attendre la fin par polling → écrire le résultat dans la bibliothèque de supports avec une triple étiquette « SKU + version de référence + jeu de paramètres ».
La production multi-versions ne repose pas sur des ajustements aveugles répétés du prompt, mais sur une matrice de paramètres : combiner le mouvement de caméra, l'ambiance de scène et la durée comme dimensions contrôlables, exécuter chaque combinaison une seule fois et enregistrer le résultat. Ce que vous produisez alors n'est pas « un tas de vidéos », mais « un ensemble de versions explicable ».
Points clés de la gestion des versions
Enregistrez chaque résultat généré comme une ligne contenant au minimum : la version des supports de référence, la version du modèle de prompt, les paramètres de génération, la durée d'exécution et la note manuelle. Lorsqu'une version d'un argument de vente se dégrade, vous pouvez répondre en quelques minutes à la question « est-ce le support qui a changé, le modèle qui a été modifié, ou les paramètres qui ont bougé », au lieu de tout relancer au hasard. Ce registre sert aussi de base d'estimation des coûts lors de la montée en charge par lots ultérieure.
Scénario 2 : extension cohérente de l'image de marque et des personnages
Lorsque le besoin métier est « le même personnage / mascotte / porte-parole virtuel apparaît de façon récurrente », la valeur de la génération à partir de références est la plus concentrée, mais les conditions d'application sont aussi les plus strictes.
Conditions d'application
- Le sujet a une définition visuelle stable : un personnage de marque doit avoir une charte visuelle fixe (silhouette, couleurs, proportions), et les supports de référence sont l'expression visuelle de cette charte, pas un croquis fait à la va-vite.
- Les variations portent sur la « scène et l'action » : des courts-métrages du même personnage pour différentes fêtes, différents événements, différentes émotions — le sujet ne change pas, le contexte change ; c'est exactement la répartition des rôles où les supports de référence ancrent le sujet et le prompt décrit le contexte.
- La stylisation est acceptable : si le métier exige une silhouette fine parfaitement unifiée d'un plan à l'autre, il faut positionner la génération à partir de références comme un outil de proposition en amont et de complément de supports, et non comme la source de la vidéo finale.
Modes d'échec et diagnostic
Les échecs les plus typiques des scénarios de personnage sont « la dérive du sujet » et « la perte de traits distinctifs ». L'ordre de diagnostic recommandé est fixé en trois étapes :
- Vérifiez d'abord les supports de référence : plusieurs versions de référence contradictoires sont-elles utilisées en même temps, ou les supports de référence ont-ils une résolution insuffisante ou un sujet occupant une part trop faible ?
- Vérifiez ensuite si le prompt outrepasse son rôle : une multitude de descriptions d'apparence dans le prompt entre en concurrence avec les supports de référence pour l'interprétation, ce qui crée des incohérences. Réduire le texte descriptif aux seules actions et au contexte améliore souvent immédiatement le résultat.
- Vérifiez enfin la fluctuation des paramètres : quelle est la distribution de cohérence sur plusieurs générations avec le même support et le même prompt ? Mesurez d'abord le taux de conformité sur un petit échantillon, puis décidez s'il faut figer un jeu de paramètres.
Ne masquez pas l'instabilité en « lançant des dizaines de générations pour en choisir une » — c'est transférer le coût du diagnostic vers le coût de facturation, et le problème demeure.
Scénario 3 : recréation de supports existants et préparation au montage secondaire
De nombreuses équipes disposent déjà de supports filmés ; ce qui manque, ce sont des plans complémentaires : une transition a besoin d'un plan d'ambiance, une vidéo parlée a besoin d'un fragment d'atmosphère, une page produit a besoin d'une courte animation de présentation. Ici, la génération à partir de références se positionne comme « fournisseur de supports pour le montage », et non comme « générateur de vidéo finale ».
Usages typiques
- Utiliser une image clé ou un fragment de la vidéo existante comme référence pour générer des plans complémentaires de même style, destinés à combler les creux du rythme de montage.
- Utiliser une image produit comme référence pour générer un court fragment de présentation animée, inséré à un endroit fixe de la vidéo existante.
Points d'attention pour le raccord
- La continuité visuelle repose sur les paramètres, pas sur la chance : les plans complémentaires doivent être proches des supports d'origine en composition, en teinte et en vitesse de mouvement ; cela doit être écrit dans le prompt et le jeu de paramètres, puis comparé côte à côte avec les supports d'origine après génération.
- La durée doit correspondre au manque de montage : la génération à partir de références est facturée à la seconde de sortie ; générer 10 secondes pour en couper 3 est un pur gaspillage. Définissez d'abord la durée du manque de montage, puis soumettez une tâche de la durée correspondante.
- La portée de la cohérence d'interface est limitée : les images de début et de fin des plans complémentaires ne se raccorderont pas automatiquement sans couture aux supports d'origine ; les transitions nécessitent encore des moyens de montage (fondu enchaîné, recadrage, musique) ; il faut prévoir cette étape manuelle dans le plan d'intégration.
Comprendre ce scénario comme « fournir de la matière au monteur » plutôt que « remplacer le monteur » rend la gestion des attentes beaucoup plus fluide, et le critère de validation plus facile à écrire : il suffit que le fragment généré puisse être inséré dans la timeline et que le spectateur ne décroche pas pour qu'il soit considéré comme conforme.
Scénario 4 : génération de contenus interactifs et personnalisés
Les scénarios de génération déclenchés par l'utilisateur (par exemple, saisir une phrase pour générer un court-métrage avec son propre visage ou celui de son animal) sont extrêmement sensibles à la latence, alors que la génération à partir de références est intrinsèquement une tâche asynchrone : cet écart doit être résolu au niveau de l'architecture.
Conception de la chaîne
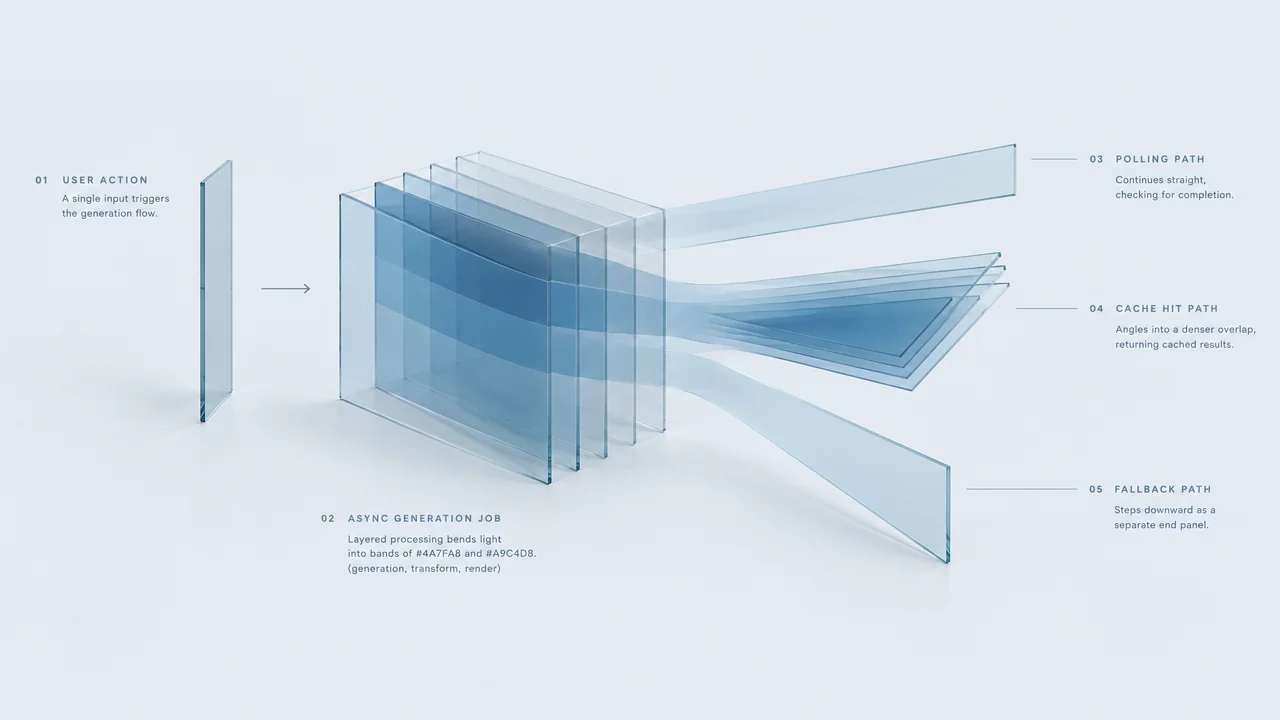
Action utilisateur → validation des paramètres et vérification du quota → soumission de la tâche de génération et retour immédiat de l'ID de tâche → attente côté frontend par polling ou push → écriture sur disque et retour de l'adresse de lecture une fois terminé. L'essentiel est de concevoir « l'attente » comme une partie de l'expérience produit, et non de faire semblant qu'il s'agit d'une interface synchrone.
Trois questions à trancher à l'avance
- Plafond d'attente : fixez un seuil de temporisation pour chaque tâche ; au-delà, basculez vers la branche d'échec et informez l'utilisateur, sans le laisser attendre indéfiniment.
- Cache des résultats : utilisez comme clé de cache « empreinte des supports de référence + prompt + paramètres ». Une entrée identique qui touche le cache renvoie directement le résultat historique, ce qui économise la facturation en double et raccourcit nettement le temps de réponse des requêtes secondaires. Dans les scénarios personnalisés, la probabilité qu'un même utilisateur fasse une requête répétée n'est pas faible.
- Dégradation en cas d'échec : en cas d'échec d'une tâche, ne relancez pas indéfiniment sur place. Configurez une limite de tentatives selon le métier (idéalement 1 au maximum) ; au-delà, dégradez vers un support générique ou une image statique prédéfinie, pour garantir que le parcours utilisateur ne s'interrompt pas.
Il faut par ailleurs distinguer « saisie utilisateur » et « supports de référence » : la photo téléversée par l'utilisateur est le support de référence, et une validation de qualité (dimensions, visibilité du sujet) doit être faite avant soumission ; bloquer en entrée de chaîne est bien moins coûteux que de laisser une tâche échouer à mi-parcours.
Scénario 5 : processus de contrôle par échantillonnage de la production de supports en lot
L'intérêt du lot n'est pas de générer mille vidéos d'un coup, mais de garantir un taux de conformité prévisible parmi ces mille, et de savoir continuellement quel est ce taux.
Contrôle par échantillonnage à plusieurs niveaux
- Contrôle complet d'un petit échantillon au premier tour : avant la mise en ligne d'un nouveau jeu de paramètres ou d'une nouvelle version de supports de référence, lancez 10 à 20 vidéos, regardez-les toutes manuellement, et confirmez la cohérence du sujet, la pertinence des actions et la propreté de l'image.
- Échantillonnage proportionnel en période stable : une fois le jeu de paramètres stabilisé, échantillonnez selon une proportion fixe (par exemple 10 % par lot), en vous concentrant sur l'apparition de dérives massives.
- Contrôle complet en cas d'anomalie : dès qu'un échantillonnage révèle un échec systématique (par exemple, distorsion généralisée d'une catégorie de supports de référence), revoyez l'intégralité du lot et gelez le jeu de paramètres concerné.
Notation et régression
Attribuez une note légère à chaque résultat échantillonné (conforme / à corriger / non conforme) et enregistrez la catégorie de la cause d'échec : dérive du sujet, action anormale, qualité d'image insuffisante, durée non conforme. Ces données de catégorisation sont plus utiles que la note globale — elles indiquent directement s'il faut modifier les supports ou les paramètres au tour suivant.
La méthode de comparaison de régression est la suivante : figez un lot d'« échantillons de référence » (supports de référence et prompt verrouillés), relancez ce lot après chaque ajustement de paramètres ou de modèle, et comparez côte à côte avec les résultats historiques. Si les échantillons de référence ne sont pas conformes, le changement a introduit une régression : revenez en arrière avant de parler d'optimisation.
Le coût de la main-d'œuvre doit entrer dans le budget : les heures de contrôle par échantillonnage et la facturation de génération font partie du coût marginal de ce scénario. La taille du lot doit être déduite à rebours de « combien l'équipe de contrôle peut-elle examiner », et non de la limite de concurrence de l'interface.
Modèle de coûts et liste d'évaluation avant intégration
La facturation de la génération à partir de références se fait à la seconde de sortie, ce qui signifie que le coût croît linéairement avec la durée, sans effet de « prix unitaire dilué sur les vidéos longues ». L'estimation est directe : coût unitaire ≈ durée de sortie × prix unitaire × nombre de tentatives prévues, le tout multiplié par le volume métier. Le point important est que les deux derniers termes sont facilement sous-estimés — les nouvelles tentatives et les vidéos ratées sont les postes qui dérapent le plus souvent.
Trois contraintes fortes de maîtrise des coûts
- Budget de durée défini en amont : le côté produit définit d'abord la durée maximale de chaque type de scénario, le côté interface la valide et refuse directement les dépassements. Découper après génération est un gaspillage.
- Limite de tentatives figée : codez en dur le nombre maximal de tentatives, au lieu de laisser une porte ouverte du type « on réessaie en cas d'échec ». Les problèmes d'effet doivent être résolus par le diagnostic, pas par la relance.
- Cache et déduplication : ne soumettez pas deux fois la même entrée, dédupliquez les tâches en lot par lot, pour éviter qu'un même support soit généré de façon répétée dans différents flux.
Liste d'évaluation avant mise en production
- Le scénario cible dépend-il vraiment de la cohérence du sujet ? S'il ne s'agit que d'une image d'ambiance, le text-to-video est peut-être plus simple.
- Existe-t-il déjà une source stable, normée et versionnée de supports de référence ? Sinon, commencez par établir une norme de supports avant de parler d'intégration.
- Le taux de conformité de cohérence sur petit échantillon atteint-il le seuil acceptable pour le métier ? En cas d'échec, ne pas passer au lot.
- La durée de sortie et la limite de tentatives sont-elles alignées côté produit et côté technique ?
- Le registre des résultats générés (version des supports, paramètres, notes) est-il en place ? Sans lui, aucune optimisation ultérieure n'est possible.
- Existe-t-il un dispositif clair de contrôle manuel par échantillonnage et une répartition des heures de travail ?
L'intérêt de cette liste est de décomposer « peut-on l'utiliser » en trois questions auxquelles on peut répondre indépendamment : « vaut-il la peine de l'utiliser, est-ce stable, peut-on se le permettre ». Mesurer d'abord le taux de conformité de cohérence sur un petit échantillon, puis parler d'intégration en lot : c'est le chemin le plus sûr pour faire entrer ce modèle dans la chaîne de production.
Modes d'échec courants et ordre de diagnostic
Lorsque l'effet n'est pas à la hauteur, la réaction la plus fréquente et la plus erronée est d'augmenter le nombre d'appels. Il est recommandé de suivre systématiquement l'ordre de diagnostic suivant, chaque étape permettant d'éliminer une catégorie de causes.
Étape 1 : qualité des supports de référence
Vérifiez si les supports de référence sont nets, si le sujet est entièrement visible et si des versions incohérentes sont mélangées. La grande majorité des problèmes de type « le sujet ne ressemble pas » se localisent à cette étape. Un problème de support ne doit pas être résolu en ajustant le prompt.
Étape 2 : cohérence des paramètres et du prompt
Confirmez que, dans une même comparaison, la version des supports, le modèle de prompt et les paramètres de génération sont réellement restés identiques. En ingénierie, le « résultat tantôt bon, tantôt mauvais » vient le plus souvent d'un endroit où un paramètre par défaut a été modifié en douce ou où le support a été changé sans incrémenter le numéro de version.
Étape 3 : le prompt outrepasse-t-il son rôle
Si le prompt empile de nombreuses descriptions d'apparence et de style, il entrera en conflit avec les supports de référence. Ramenez le prompt aux actions, à la caméra et à la scène, et observez si la cohérence remonte.
Étape 4 : la stratégie de nouvelles tentatives masque-t-elle le problème
Vérifiez dans les journaux combien de fois la même tâche a été relancée et dans quelle catégorie chaque échec s'est produit. Si les échecs se concentrent sur la même catégorie de supports ou le même groupe de paramètres, il s'agit d'un problème systémique, et la relance ne fait qu'amplifier le coût.
Étape 5 : la chaîne de tâches elle-même
Diagnostiquez les problèmes d'ingénierie tels que les temporisations, les échecs de téléversement et les résultats non écrits sur disque, en les distinguant des problèmes d'effet du modèle. Les actions de correction des deux catégories sont totalement différentes ; les mélanger dans le diagnostic crée des interférences mutuelles.
Inscrire cet ordre de diagnostic dans la documentation de l'équipe stabilise davantage la production que n'importe quelle astuce de prompt — il garantit qu'à chaque régression d'effet, l'équipe part des supports et des paramètres, et non de l'augmentation du volume d'appels.
Articles similaires
Voir tous les articles →-

Tutoriel
Guide pratique de gpt-6.2-sol : 5 usages à forte valeur des modèles textuels en entreprise
-

Tutoriel
Guide pratique de gpt-6.2-astra : intégration et points clés de mise en œuvre pour 5 scénarios textuels à forte valeur
Liste de points de contrôle pour les développeurs, de la sélection des scénarios à la mise en œuvre technique
-

Tutoriel
Cas d'usage concrets de Tripo H3.1 : 5 usages à forte valeur et points clés de mise en œuvre
Du texte-vers-3D à la reconstruction multi-vues : choisir le bon mode et les bons paramètres selon le cas d'usage