
사용 가이드
Kling 3.0 Turbo 이미지-투-비디오 프롬프트 레시피: 그대로 복사 가능한 프롬프트와 실제 출력
현장에서 검증된 네 가지 이미지-투-비디오 프롬프트—제품 오빗, 세로형 인물 마이크로 모션, 물리적 연속성, 리빙 포토—각각 입력 첫 프레임과 실제 API에서 생성된 실제 클립을 함께 제공합니다.
요약
- 이 글의 내용: 그대로 복사할 수 있는 네 가지 kling-3.0-turbo 이미지-투-비디오 프롬프트 레시피로, 각각 입력 첫 프레임, 정확한 모션 프롬프트, 그리고 실제 API에서 생성된 실제 클립을 보여줍니다—원본 첫 출력이며 어떤 재시도도 숨기지 않았습니다.
- 다루는 범위: 이커머스 제품 오빗 샷, 세로형 9:16 인물 마이크로 모션, 신뢰할 수 있는 물리로 이어지는 정지 동작 순간, 그리고 클래식한 리빙 포토 풍경.
- 모델 사실(실시간 작업 API로 검증됨): 입력은
prompt+image_urls(정확히 하나의 공개 이미지 URL) +duration(정수 3–15초) +resolution(720p/1080p)입니다.aspect_ratio필드는 없습니다—출력은 입력 프레임을 따르므로 9:16 정지 이미지는 9:16 비디오를 생성합니다. - 가격(출력 초당, 가격 페이지 기준): 720p는 $0.13/초, 1080p는 $0.16/초—텍스트-투-비디오 버전과 동일한 단일 요율입니다. 5초 클립은 $0.65, 3초 테스트는 $0.39입니다.
- 오디오: 클립은 네이티브 앰비언스 오디오 트랙과 함께 반환됩니다—소리를 켜고 재생하세요.
텍스트-투-비디오 vs 이미지-투-비디오: 언제 한 프레임에서 시작할까
텍스트-투-비디오는 구도 면에서 복권과 같습니다: 장면을 묘사하면 모델이 준 어떤 프레이밍이든 받아들여야 합니다. 이미지-투-비디오는 이 변수를 제거합니다. 먼저 정지 이미지에서 구도, 피사체, 조명, 브랜드 느낌을 고정합니다—예술적으로 지시하거나 실제로 촬영할 수 있는 것입니다—그다음 프롬프트를 전부 모션에 사용합니다: 무엇이 움직이는지, 얼마나 빠른지, 카메라가 무엇을 하는지.
이것이 작성 방식을 바꿉니다. 이미지-투-비디오 프롬프트는 이미 화면에 있는 내용을 다시 묘사해서는 안 됩니다; 모델은 그것을 볼 수 있습니다. 아래 레시피는 한 가지 규칙을 따릅니다: 화면 내용을 참조한 뒤 변화만 묘사—카메라 경로, 피사체 동작, 환경 운동, 그리고 무엇이 반드시 정지해야 하는지.
각 예시는 실제 입력 프레임과 생성된 클립을 보여주며, 그 사이에 정확한 프롬프트가 있습니다. 저는 gpt-image-2로 이 프레임들을 생성했으므로 전체 과정이 API로 재현 가능하지만, 여러분이 가진 어떤 이미지든—제품 사진, 촬영 스틸, 렌더—사용할 수 있습니다.
레시피 1—이커머스: 스튜디오 샷에서 제품 오빗 생성(16:9)
목표: 정적 제품 사진을 깔끔한 카메라 모션이 있는 쇼케이스 클립으로 바꾸기—상점에서 가장 지렛대가 큰 이미지-투-비디오 활용 사례입니다.
제품이 중앙에 있고 조명이 이미 올바른 히어로 이미지에서 시작하세요:
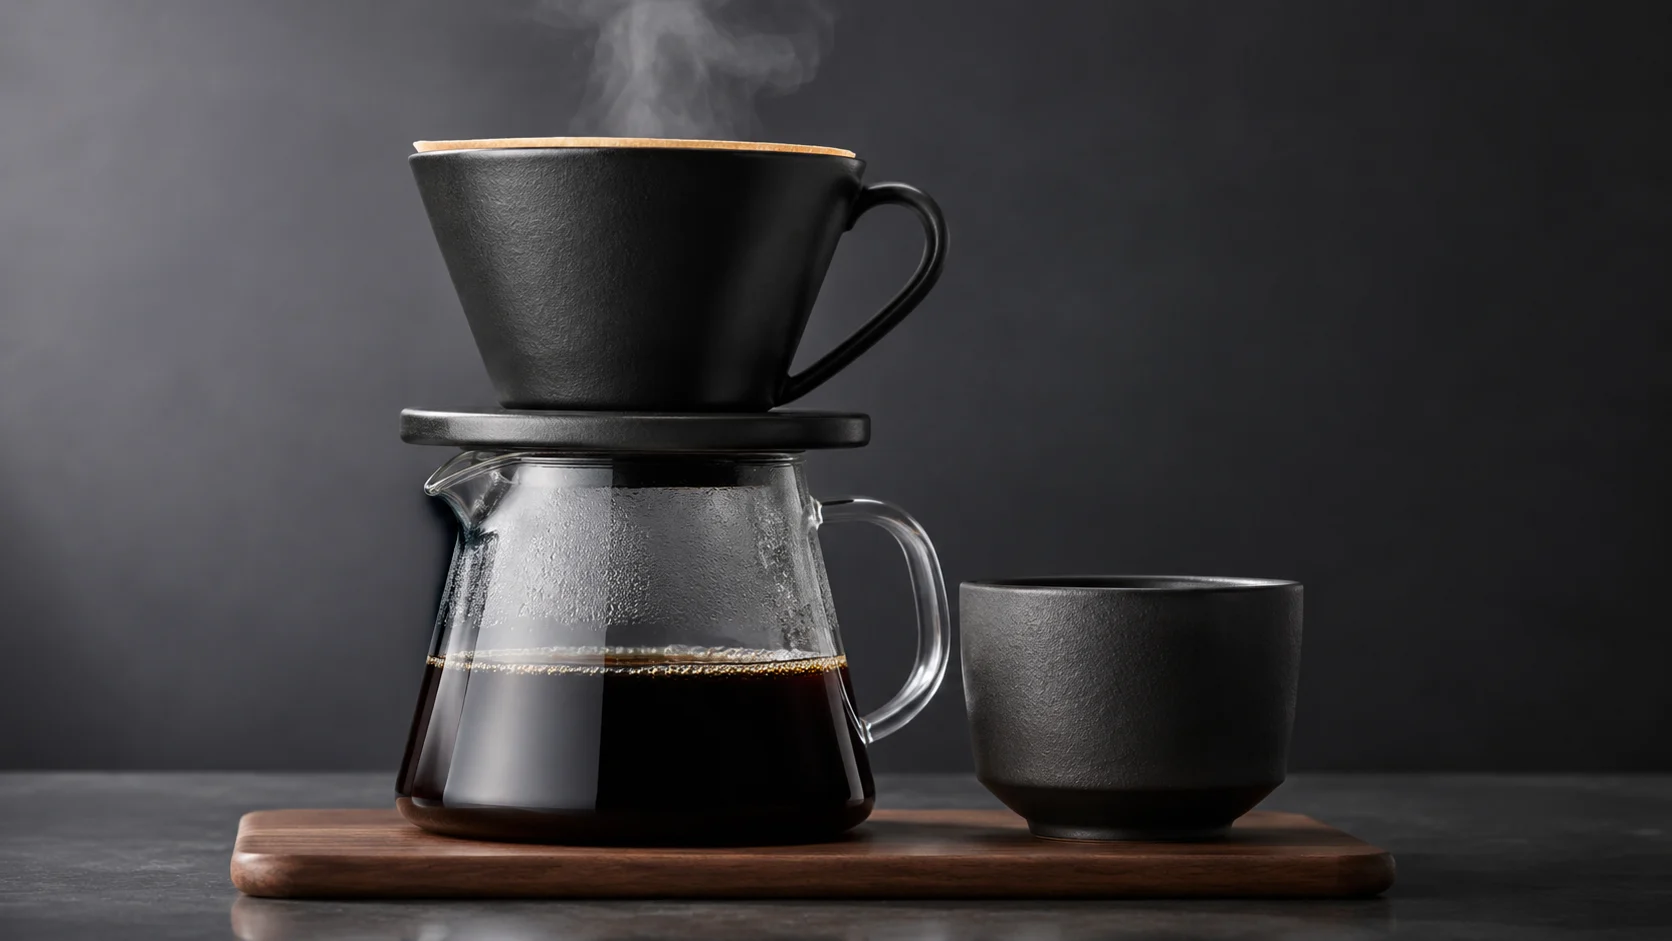
입력 첫 프레임(16:9, gpt-image-2로 생성—여러분이 가진 어떤 이미지도 동일하게 작동).
다음은 모션 프롬프트입니다:
Slow smooth orbit around the coffee set, the camera circling a quarter turn to the right while keeping the carafe centered. Steam keeps rising and curling naturally, reflections slide across the glass as the angle changes. The product stays sharp and undistorted, studio lighting unchanged, no cuts, elegant product-video motion.
커피 세트를 중심으로 한 4분의 1 회전 오빗, 증기는 계속 피어오름—kling-3.0-turbo/image-to-video, 5초 @ 720p. 위 첫 프레임에서 생성된 실제 출력, 원본 첫 버전, 이 가이드를 위해 생성.
왜 효과적인가: 프롬프트는 제품을 다시 묘사하지 않습니다—화면이 이미 그것을 담고 있습니다. 대신 카메라 지시("slow smooth orbit ... a quarter turn to the right")와 앵커("keeping the carafe centered"), 그리고 안전 조항("stays sharp and undistorted, studio lighting unchanged")을 제공합니다. 오빗을 4분의 1 회전으로 제한하는 것이 중요합니다: 5초 안에 완전한 360도는 모델이 제품의 보이지 않는 뒷면을 지어내도록 강제하며, 보통 형태를 왜곡시킵니다.
레시피 2—세로형 9:16: 숏폼을 위한 인물 마이크로 모션
목표: 숨 쉬는, 폰 네이티브 세로형 이미지—바람, 물, 한 번의 눈 깜빡임, 아주 느린 푸시인. 이것은 또한 중요한 스키마 사실의 시연입니다: 이미지-투-비디오에는 aspect_ratio 파라미터가 없습니다—출력은 화면을 상속하므로, 이 9:16 정지 프레임은 자르기 없이 9:16 클립을 생성합니다.
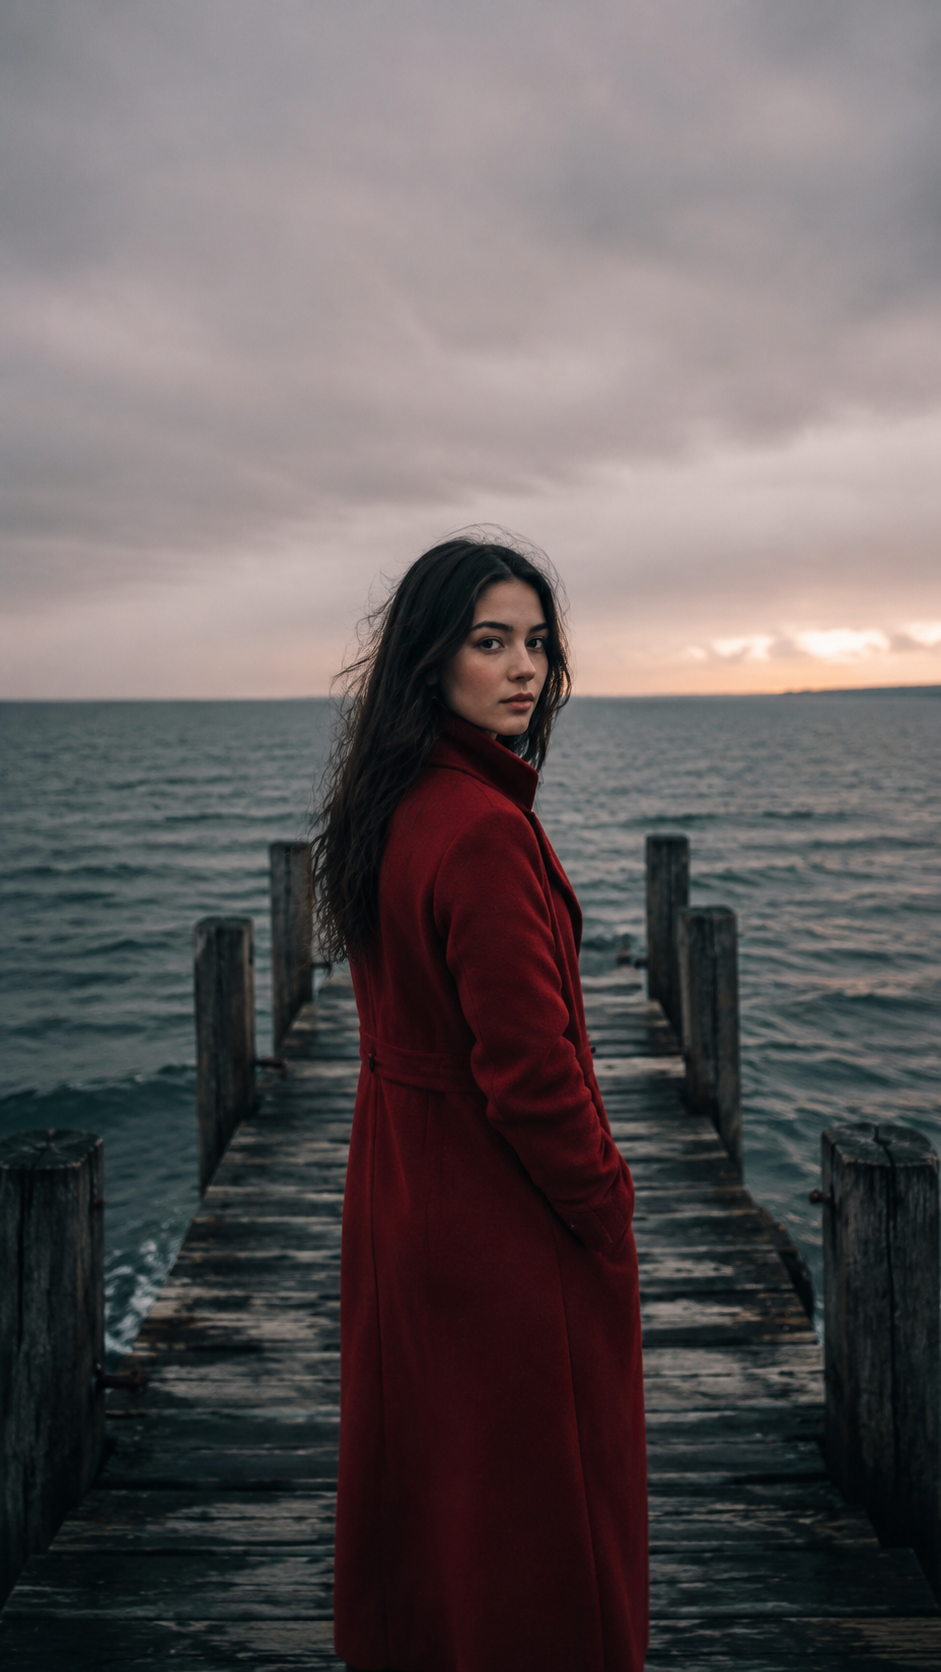
입력 첫 프레임(9:16, gpt-image-2로 생성—여러분이 가진 어떤 이미지도 동일하게 작동).
The scene comes alive: a steady sea wind lifts strands of her hair and ripples the hem of the red coat, small waves roll behind the pier, she blinks slowly and a faint smile forms. The camera pushes in very slowly toward her face. Subtle, realistic motion, no cuts, melancholic cinematic mood.
바람이 그녀의 머리카락을 들어 올리고 카메라는 푸시인—세로형—kling-3.0-turbo/image-to-video, 5초 @ 720p. 위 첫 프레임에서 생성된 실제 출력, 원본 첫 버전, 이 가이드를 위해 생성.
왜 효과적인가: 모션이 규모별로 계층화됩니다—환경(파도, 바람), 의상(코트 밑단의 물결), 연기(느린 눈 깜빡임, 희미한 미소), 그리고 하나의 카메라 운동(아주 느린 푸시인). 각 층은 작습니다; 합쳐지면 왜곡된 사진이 아니라 살아 있는 순간처럼 읽힙니다. "Subtle, realistic motion"은 여기서 실제 역할을 합니다—이를 생략하면 이미지-투-비디오 모델은 얼굴을 과도하게 애니메이션하는 경향이 있습니다.
레시피 3—물리적 연속성: 동작 샷 해동(16:9)
목표: 동작 중간에 멈춘 프레임을 가져와 모델이 신뢰할 수 있는 운동량으로 동작을 완성하게 하기—이미지-투-비디오 모델의 물리 능력에 대한 가장 어려운 테스트입니다.
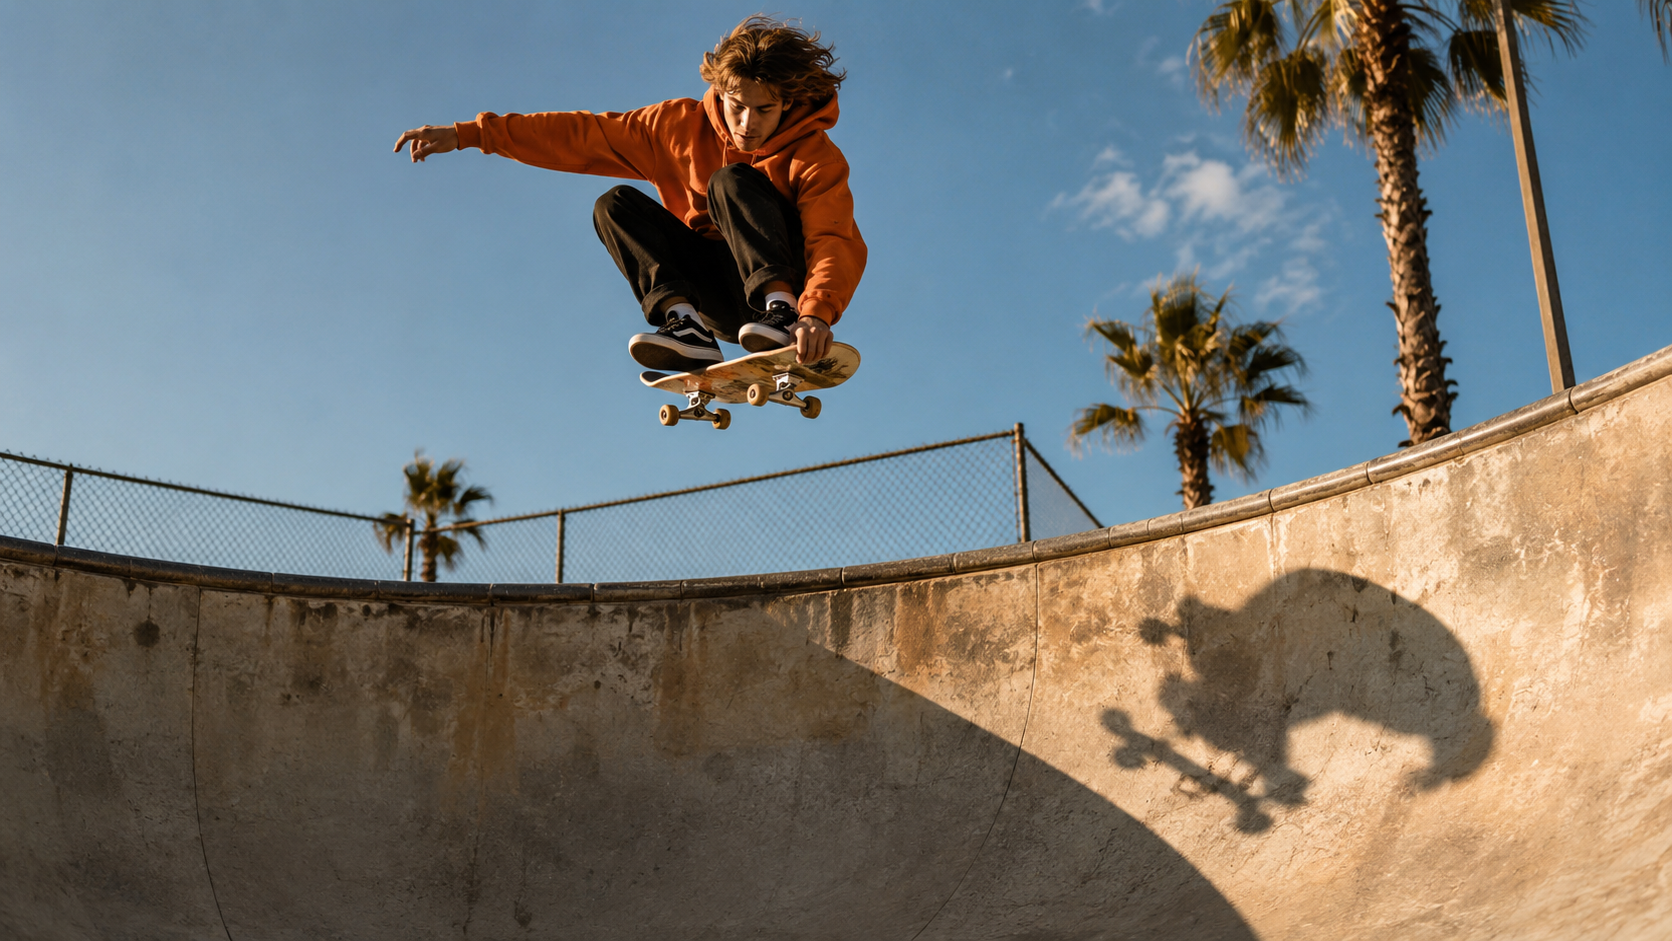
입력 첫 프레임(16:9, gpt-image-2로 생성—여러분이 가진 어떤 이미지도 동일하게 작동).
The frozen moment continues: the skateboarder completes the air, drops back into the bowl, wheels hit the concrete with a small wobble he absorbs with bent knees, then he carves up the far wall. The camera pans right to follow him through the landing. Natural skate physics, momentum preserved from the pose, no cuts.
공중 동작 완료, 착지, 그리고 먼 벽을 따라 활주—kling-3.0-turbo/image-to-video, 5초 @ 720p. 위 첫 프레임에서 생성된 실제 출력, 원본 첫 버전, 이 가이드를 위해 생성.
왜 효과적인가: 프롬프트는 이 프레임을 하나의 올바른 연속만 있는 물리 문제로 취급합니다—"completes the air, drops back into the bowl, wheels hit ... he absorbs with bent knees". 착지를 순서 있는 비트로 쓰고 "momentum preserved from the pose"를 명시적으로 요구하면 모델이 스케이트보더를 다시 튀어 올려 두 번째 불가능한 기술을 하도록 하는 것을 방지합니다. 작은 불완전함("a small wobble he absorbs")은 실패가 아니라 사실감으로 읽힙니다.
레시피 4—리빙 포토: 환경 풍경 루프(16:9)
목표: 클래식한 이미지-투-비디오 기법—흐르는 풍경. 또한 예산 템플릿이기도 합니다: 이것은 4초 클립($0.52)으로, 환경 모션을 반복할 때 저렴한 형태입니다.
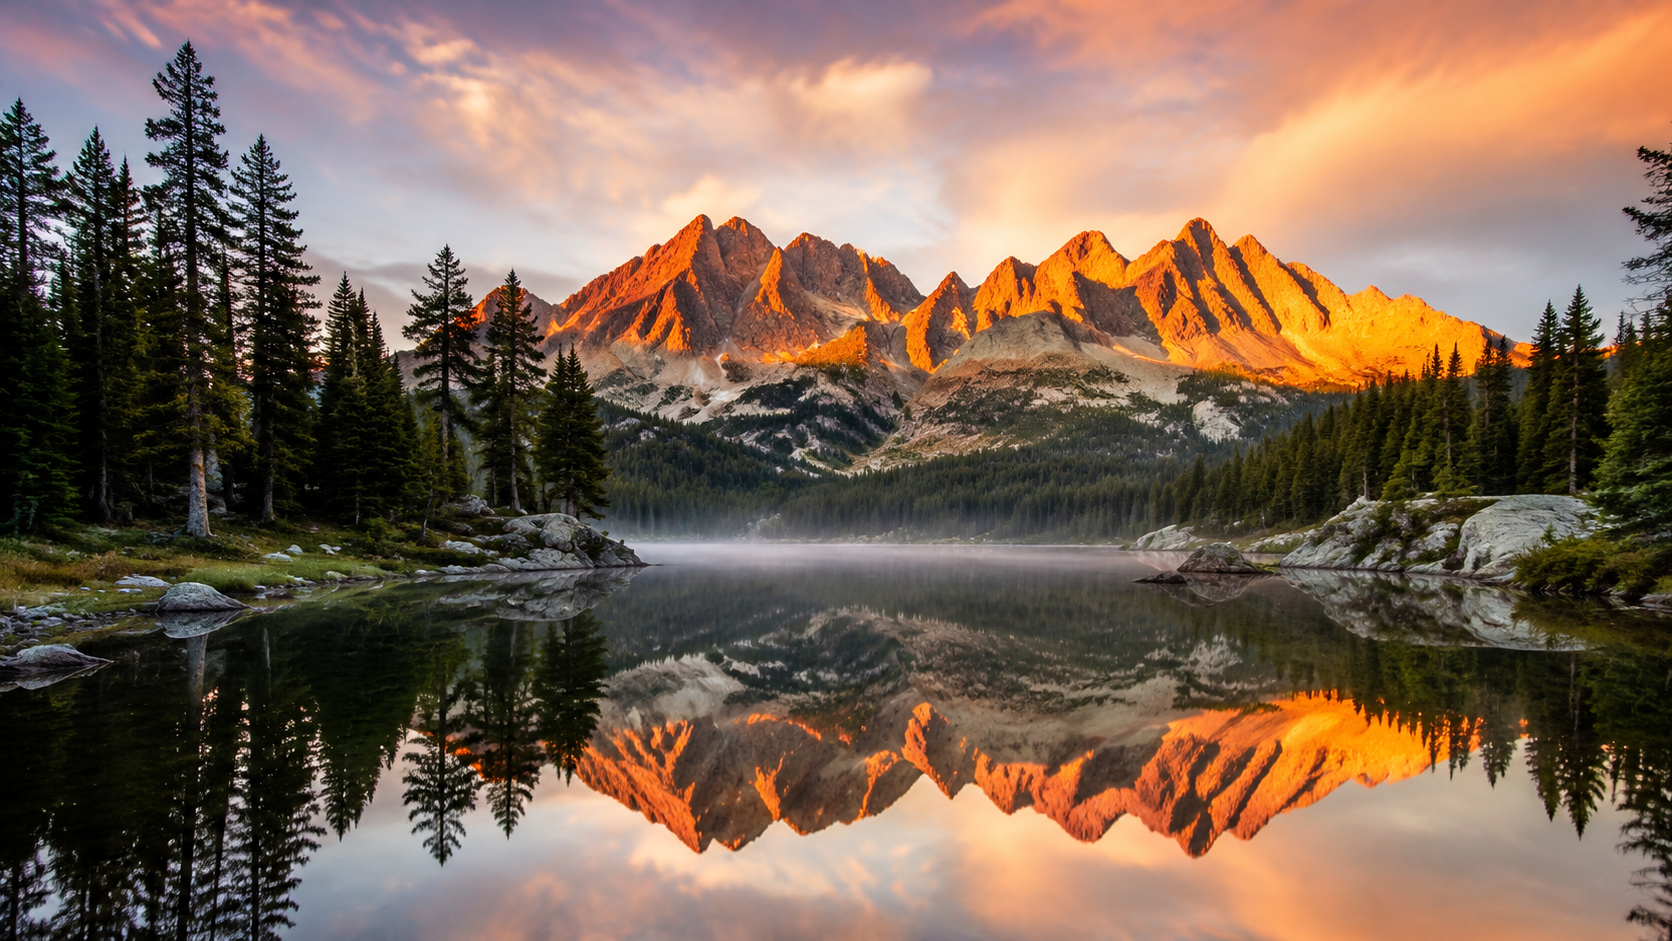
입력 첫 프레임(16:9, gpt-image-2로 생성—여러분이 가진 어떤 이미지도 동일하게 작동).
Bring the photograph to life with gentle ambient motion: mist drifts slowly across the far shore, soft ripples cross the mirror reflection, clouds creep behind the peaks, and two distant birds glide across the sky. The camera dollies forward very slowly over the water. Calm, seamless, loop-like motion, no cuts.
안개가 흐르고 잔물결이 반사를 가로지르며 카메라는 푸시인—kling-3.0-turbo/image-to-video, 4초 @ 720p. 위 첫 프레임에서 생성된 실제 출력, 원본 첫 버전, 이 가이드를 위해 생성.
왜 효과적인가: 모든 것이 자연스러운 리듬으로 움직입니다—안개는 "drifts slowly", 구름은 "creep", 잔물결은 "cross"—두 마리 새가 눈에 초점 사건을 주어 클립이 화면 보호기처럼 보이지 않게 합니다. "Loop-like motion"은 모델이 반복 재생에도 견디는 균일한 리듬을 형성하도록 안내하며, 이것이 바로 히어로 영역 배경 비디오에 원하는 효과입니다.
입력 스키마, 검증됨
아래 모든 내용은 어떤 클립도 생성하기 전에 실시간 작업 API로 확인되었습니다(유효하지 않은 값은 400을 반환하고 허용 가능한 값을 나열합니다):
| 필드 | 유형 | 설명 |
|---|---|---|
prompt |
string | 필수—화면이 아니라 모션을 묘사 |
image_urls |
문자열 배열 | 필수, 정확히 하나의 URL(maxItems: 1), 공개 접근 가능해야 함 |
duration |
integer | 3–15초 |
resolution |
string | 720p 또는 1080p |
스키마는 엄격합니다: aspect_ratio, seed, negative_prompt, sound는 모두 거부되며 additional properties ... not allowed 오류가 발생합니다. 알아 둘 두 가지 결과가 있습니다:
- 출력 종횡비는 입력 프레임을 따릅니다. 세로형 비디오를 원하나요? 세로형 이미지를 넣으세요(레시피 2). 화면과 맞설 수 있는 파라미터는 없습니다.
- 이미지 URL은 플랫폼에서 접근 가능해야 합니다—CDN이나 오브젝트 스토리지에 호스팅하고, 인증 뒤나 localhost에 두지 마세요.
직접 실행하기(API)
네 레시피 모두 같은 비동기 흐름을 사용합니다—프레임 URL로 작업을 생성하고, 종료 상태까지 폴링하고, mp4를 다운로드합니다:
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY", "Content-Type": "application/json"}

def animate(image_url, prompt, duration=5, resolution="720p"):
    body = {"model": "kling-3.0-turbo/image-to-video",
            "input": {"prompt": prompt, "image_urls": [image_url],
                      "duration": duration, "resolution": resolution}}
    task_id = requests.post(API, json=body, headers=HEADERS, timeout=60).json()["data"]["taskId"]
    while True:
        t = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
        if t["status"] == "success":
            return t["output"][0]["url"]   # signed link, expires — download immediately
        if t["status"] == "fail":
            raise RuntimeError(t.get("error"))
        time.sleep(5)

print(animate("https://your-cdn.example.com/product.jpg",
              "Slow smooth orbit around the product, quarter turn right, no cuts"))
반환된 output[0].url은 임시입니다—바이트를 즉시 영구 저장하고 핫링크하지 마세요. 전체 파라미터 참조는 문서를 참고하세요.
자주 묻는 질문
kling-3.0-turbo 텍스트-투-비디오와 무엇이 다른가요?
같은 계열, 같은 초당 가격, 다른 제어면입니다: 텍스트-투-비디오는 aspect_ratio를 받고 구도를 창조합니다; 이미지-투-비디오는 하나의 image_urls 항목을 받고 그로부터 구도를 상속합니다. 시작 프레임이 없다면 텍스트-투-비디오 레시피 모음을 대신 사용하세요.
클립 하나에 얼마인가요?
출력 초당 과금: 720p는 $0.13/초, 1080p는 $0.16/초. 이 글의 5초 클립 세 개는 각각 $0.65, 4초 풍경은 $0.52, 3초 720p 테스트는 $0.39입니다. 실시간 숫자는 가격 페이지를 참고하세요.
출력 종횡비를 제어할 수 있나요?
입력 이미지를 통해서만 가능합니다—aspect_ratio 필드는 없습니다. 9:16 프레임은 9:16 클립(레시피 2)을, 16:9 프레임은 16:9 클립을 생성합니다.
입력 이미지는 AI 생성이어야 하나요?
아니요—공개 접근 가능한 이미지 URL이면 무엇이든 됩니다: 제품 사진, 영화 스틸, 렌더. 저는 전체 과정을 하나의 API로 재현 가능하게 하기 위해 순전히 gpt-image-2로 프레임을 생성했습니다.
클립에 소리가 있나요?
이 가이드의 클립은 네이티브 앰비언스 오디오 트랙과 함께 반환됩니다(실제 파일에서 검증됨). 명시적 오디오 가격 계층과 4K 출력은 omni 계층을 확인하세요—kling-3.0-omni 이미지-투-비디오 가이드 참고.
이 프롬프트 패턴을 다른 이미지-투-비디오 모델로 옮길 수 있나요?
구조는 그렇습니다—모션 전용 프롬프트, 계층화된 환경 운동, 순서 있는 비트로 쓰인 물리. 같은 패턴으로 다른 모델 계열을 비교하고 싶다면, 대응하는 wan2.7 이미지-투-비디오 레시피 모음도 관리하고 있습니다.
네 가지 모션 프롬프트 모두 복사할 수 있습니다. API 키를 받아 위 코드 조각을 kling-3.0-turbo 이미지-투-비디오에 연결하고, 가진 아무 프레임이나 넣으면 3초 테스트 클립에 $0.39가 듭니다.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트