
Guida all'uso
Ricette di prompt per Kling 3.0 Turbo image-to-video: prompt pronti da copiare e output reali
Quattro prompt image-to-video verificati sul campo — orbita di prodotto, micro-movimento su ritratto verticale, continuità fisica, foto che prende vita — ciascuno con il primo frame di input e la clip reale generata tramite API live.
Riepilogo
- Di cosa tratta questo articolo: quattro ricette di prompt kling-3.0-turbo image-to-video pronte da copiare, ciascuna con il primo frame di input, il prompt di movimento esatto e la clip reale generata tramite API live — output originale alla prima esecuzione, senza alcun retry nascosto.
- Copertura: orbita di prodotto per e-commerce, micro-movimento su ritratto verticale 9:16, istante d'azione congelato portato avanti con fisica credibile, e il classico paesaggio in stile foto che prende vita.
- Fatti sul modello (verificati contro l'API live dei task): input
prompt+image_urls(esattamente un URL immagine pubblico) +duration(intero 3–15 secondi) +resolution(720p/1080p). Nessun campoaspect_ratio— l'output segue il frame di input, quindi un fermo immagine 9:16 produce un video 9:16. - Prezzo (per secondo di output, dalla pagina dei prezzi): 720p a $0.13/secondo, 1080p a $0.16/secondo — stessa tariffa uniforme della versione text-to-video. Una clip di 5 secondi costa $0.65; un test da 3 secondi costa $0.39.
- Audio: le clip tornano con una traccia ambient nativa — riproduci con l'audio attivo.
Text-to-video vs image-to-video: quando partire da un frame
Il text-to-video è una lotteria sulla composizione: descrivi una scena e accetti l'inquadratura che il modello ti restituisce. L'image-to-video elimina questa variabile. Blocchi composizione, soggetto, luce e percezione del brand in un'immagine statica — qualcosa su cui puoi fare art direction o che puoi fotografare davvero — e poi usi l'intero prompt per il movimento: cosa si muove, quanto velocemente, e cosa fa la camera.
Questo cambia il modo in cui scrivi. Un prompt image-to-video non deve ridescrivere ciò che è già nell'immagine; il modello lo vede. Le ricette qui sotto seguono una regola: fai riferimento a ciò che è nell'immagine, poi descrivi solo ciò che cambia — percorso di camera, azione del soggetto, movimento ambientale, e cosa deve restare fermo.
Ogni esempio mostra il frame di input reale e la clip generata, con il prompt esatto nel mezzo. Ho generato questi frame con gpt-image-2, così l'intero flusso è riproducibile via API, ma va bene qualsiasi immagine tu abbia — foto di prodotto, still fotografici, rendering.
Ricetta 1 — E-commerce: orbita di prodotto da scatto in studio (16:9)
Obiettivo: trasformare una foto di prodotto statica in una clip espositiva con un movimento di camera pulito — il caso d'uso image-to-video a più alto impatto per un negozio.
Parti da una hero image con il prodotto centrato e l'illuminazione già corretta:
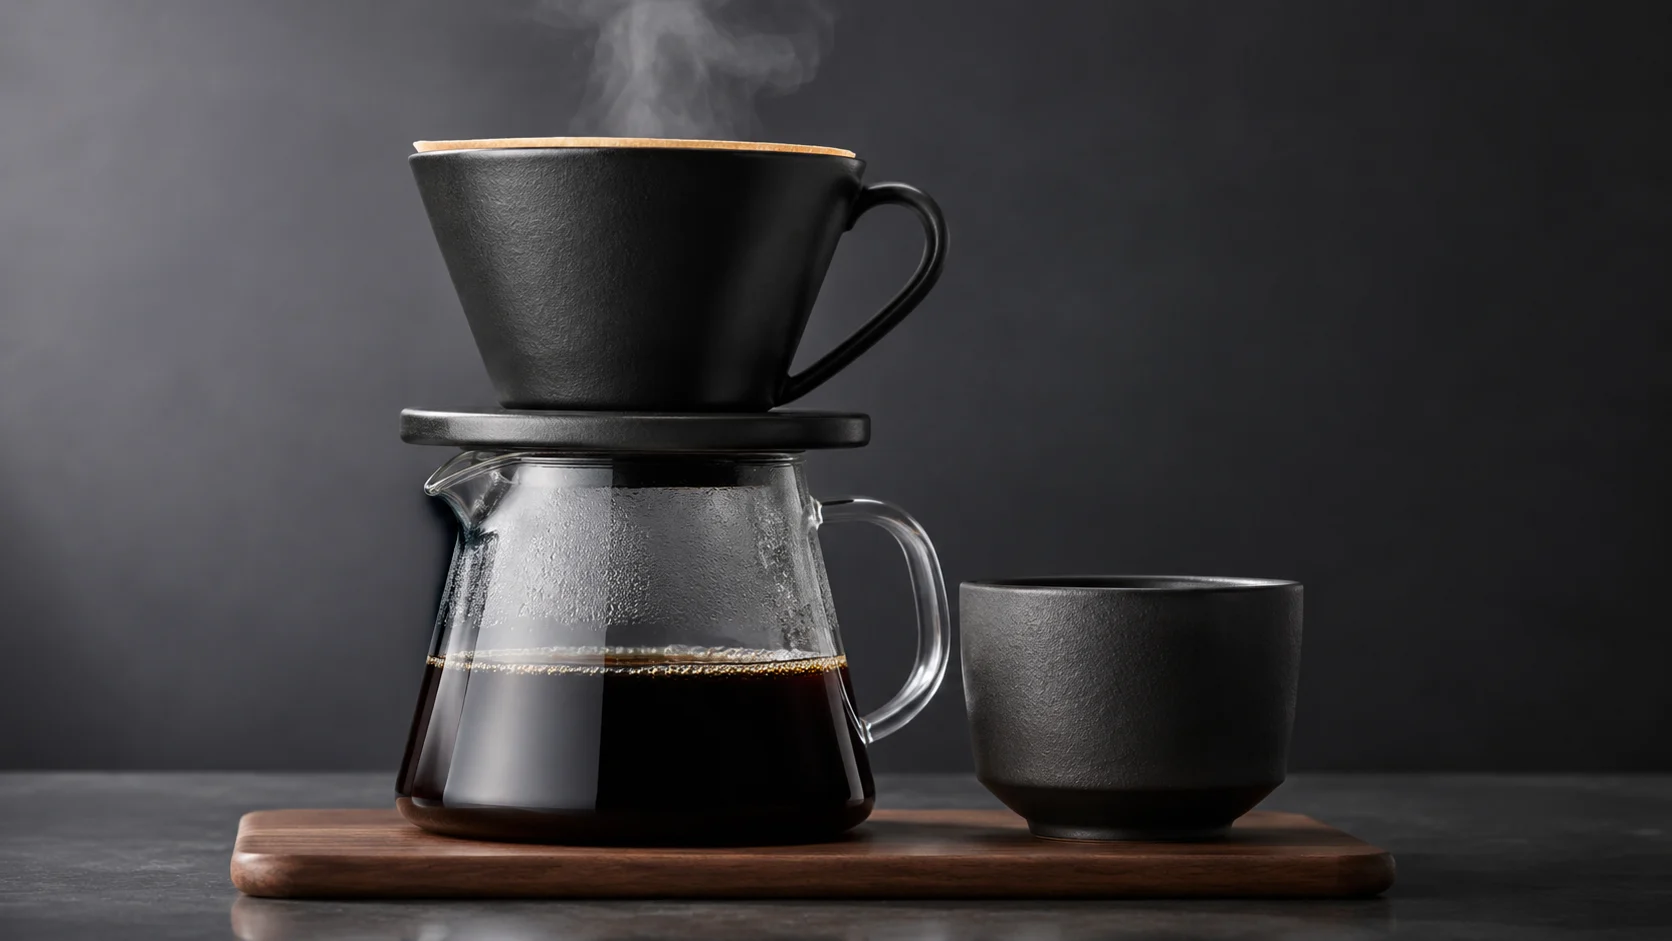
Frame di input (16:9, generato con gpt-image-2 — qualsiasi immagine tu abbia funziona allo stesso modo).
Poi il prompt di movimento:
Slow smooth orbit around the coffee set, the camera circling a quarter turn to the right while keeping the carafe centered. Steam keeps rising and curling naturally, reflections slide across the glass as the angle changes. The product stays sharp and undistorted, studio lighting unchanged, no cuts, elegant product-video motion.
Orbita di un quarto di giro attorno al set da caffè, con il vapore che continua a salire — kling-3.0-turbo/image-to-video, 5 s @ 720p. Output reale generato dal frame di input qui sopra, originale alla prima esecuzione, prodotto per questa guida.
Perché funziona: il prompt non ridescrive mai il prodotto — l'immagine lo contiene già. Invece fornisce un'istruzione di camera ("slow smooth orbit ... a quarter turn to the right"), più un punto di ancoraggio ("keeping the carafe centered") e una clausola di sicurezza ("stays sharp and undistorted, studio lighting unchanged"). Limitare l'orbita a un quarto di giro è importante: un giro completo di 360 gradi in cinque secondi costringe il modello a inventare il retro invisibile del prodotto, cosa che di solito lo deforma.
Ricetta 2 — Verticale 9:16: micro-movimento su ritratto per video brevi
Obiettivo: un'immagine che respira, nativa verticale per mobile — vento, acqua, un battito di ciglia, un lento avvicinamento. È anche la dimostrazione di un fatto cruciale dello schema: image-to-video non ha un parametro aspect_ratio — l'output eredita il frame, quindi questo fermo immagine 9:16 genera una clip 9:16 senza alcun ritaglio.
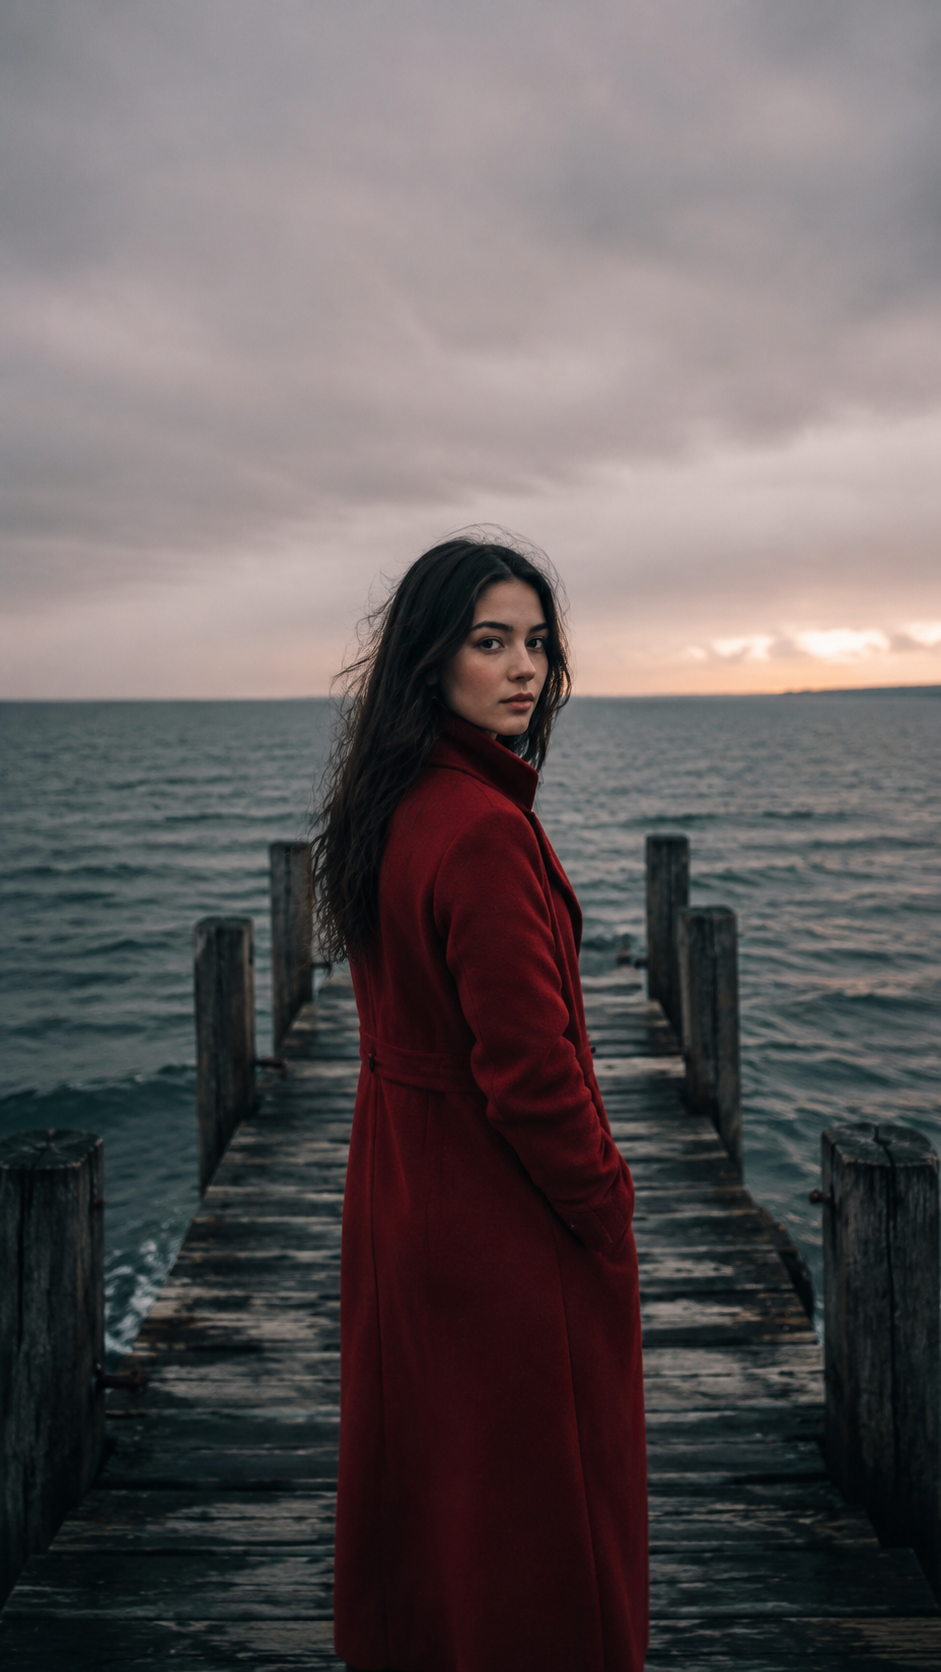
Frame di input (9:16, generato con gpt-image-2 — qualsiasi immagine tu abbia funziona allo stesso modo).
The scene comes alive: a steady sea wind lifts strands of her hair and ripples the hem of the red coat, small waves roll behind the pier, she blinks slowly and a faint smile forms. The camera pushes in very slowly toward her face. Subtle, realistic motion, no cuts, melancholic cinematic mood.
Il vento solleva i suoi capelli mentre la camera si avvicina — formato verticale — kling-3.0-turbo/image-to-video, 5 s @ 720p. Output reale generato dal frame di input qui sopra, originale alla prima esecuzione, prodotto per questa guida.
Perché funziona: il movimento è stratificato per scala — ambiente (onde, vento), abbigliamento (il cappotto che ondeggia), performance (battito di ciglia lento, accenno di sorriso) e un movimento di camera (avvicinamento molto lento). Ogni livello è piccolo; insieme si leggono come un istante vivo, non come una foto distorta. "Subtle, realistic motion" qui fa un lavoro concreto — senza di esso, i modelli image-to-video tendono ad animare eccessivamente i volti.
Ricetta 3 — Continuità fisica: scongelare una scena d'azione (16:9)
Obiettivo: prendere un frame centrale di un'azione congelata e far completare il movimento al modello con una quantità di moto credibile — il test più difficile per le capacità fisiche di un modello image-to-video.
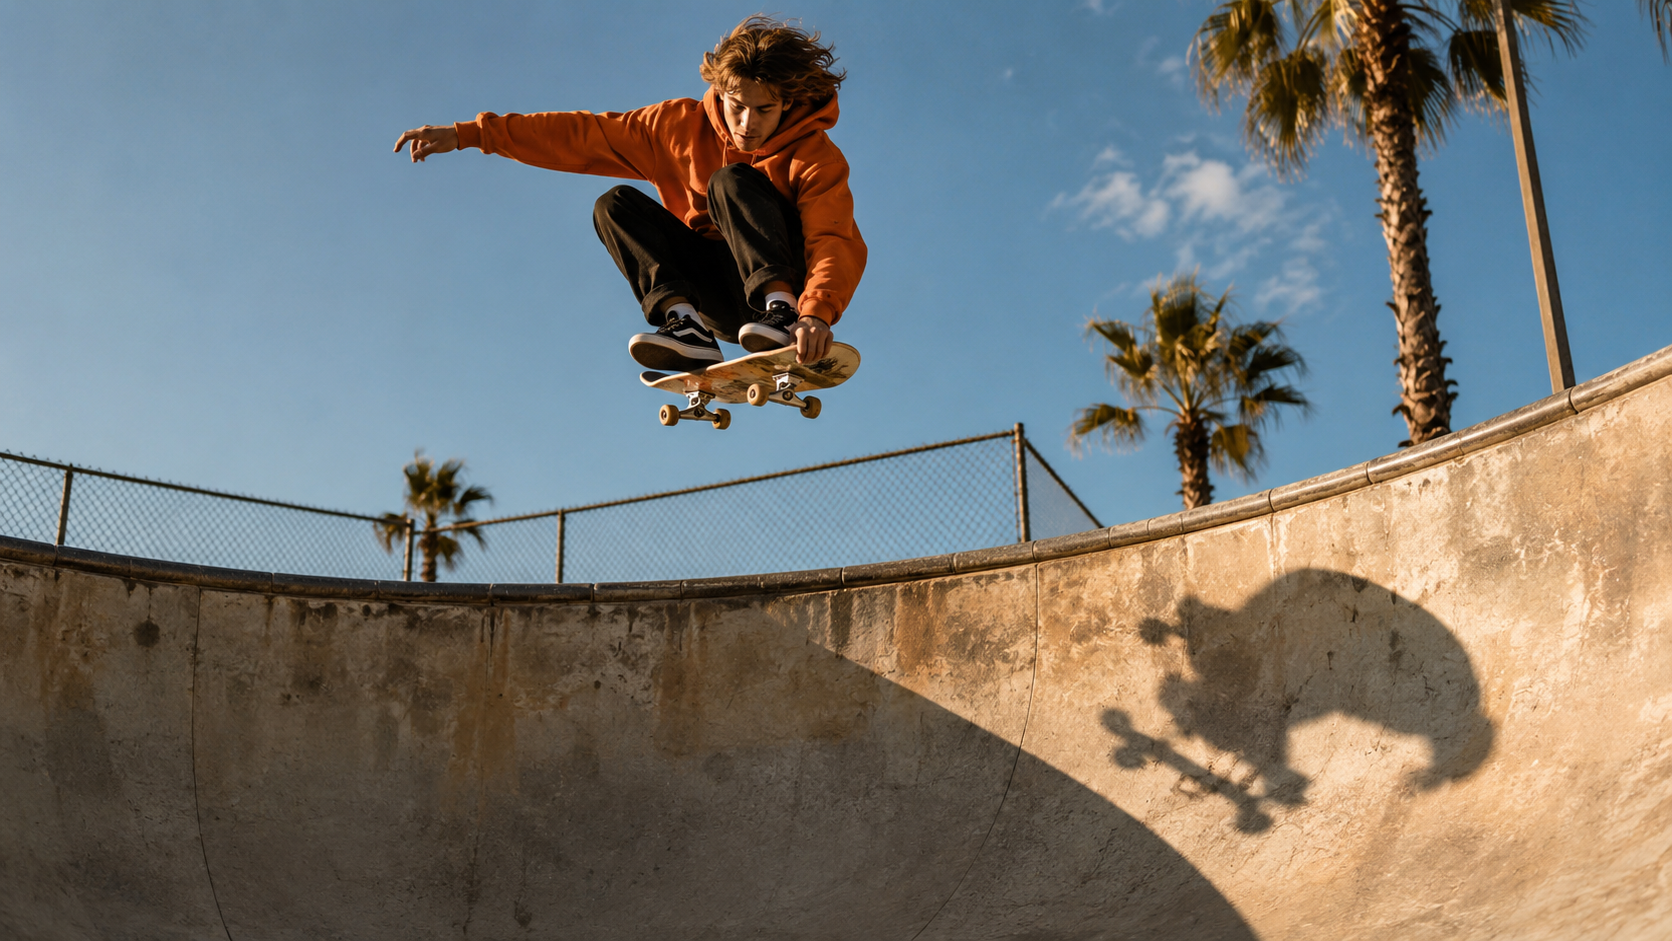
Frame di input (16:9, generato con gpt-image-2 — qualsiasi immagine tu abbia funziona allo stesso modo).
The frozen moment continues: the skateboarder completes the air, drops back into the bowl, wheels hit the concrete with a small wobble he absorbs with bent knees, then he carves up the far wall. The camera pans right to follow him through the landing. Natural skate physics, momentum preserved from the pose, no cuts.
Il salto si completa, atterraggio e curva lungo la parete opposta — kling-3.0-turbo/image-to-video, 5 s @ 720p. Output reale generato dal frame di input qui sopra, originale alla prima esecuzione, prodotto per questa guida.
Perché funziona: il prompt tratta il frame come un problema di fisica con una sola continuazione corretta — "completes the air, drops back into the bowl, wheels hit ... he absorbs with bent knees". Scrivere l'atterraggio come una sequenza ordinata di battute e chiedere esplicitamente "momentum preserved from the pose" impedisce al modello di rilanciare lo skater in un secondo trick impossibile. Le piccole imperfezioni ("a small wobble he absorbs") si leggono come realismo, non come errore.
Ricetta 4 — Foto che prende vita: loop di paesaggio ambientale (16:9)
Obiettivo: il classico trucco image-to-video — un paesaggio che scorre. È anche il template economico: una clip di 4 secondi ($0.52), la forma più conveniente per iterare sul movimento ambientale.
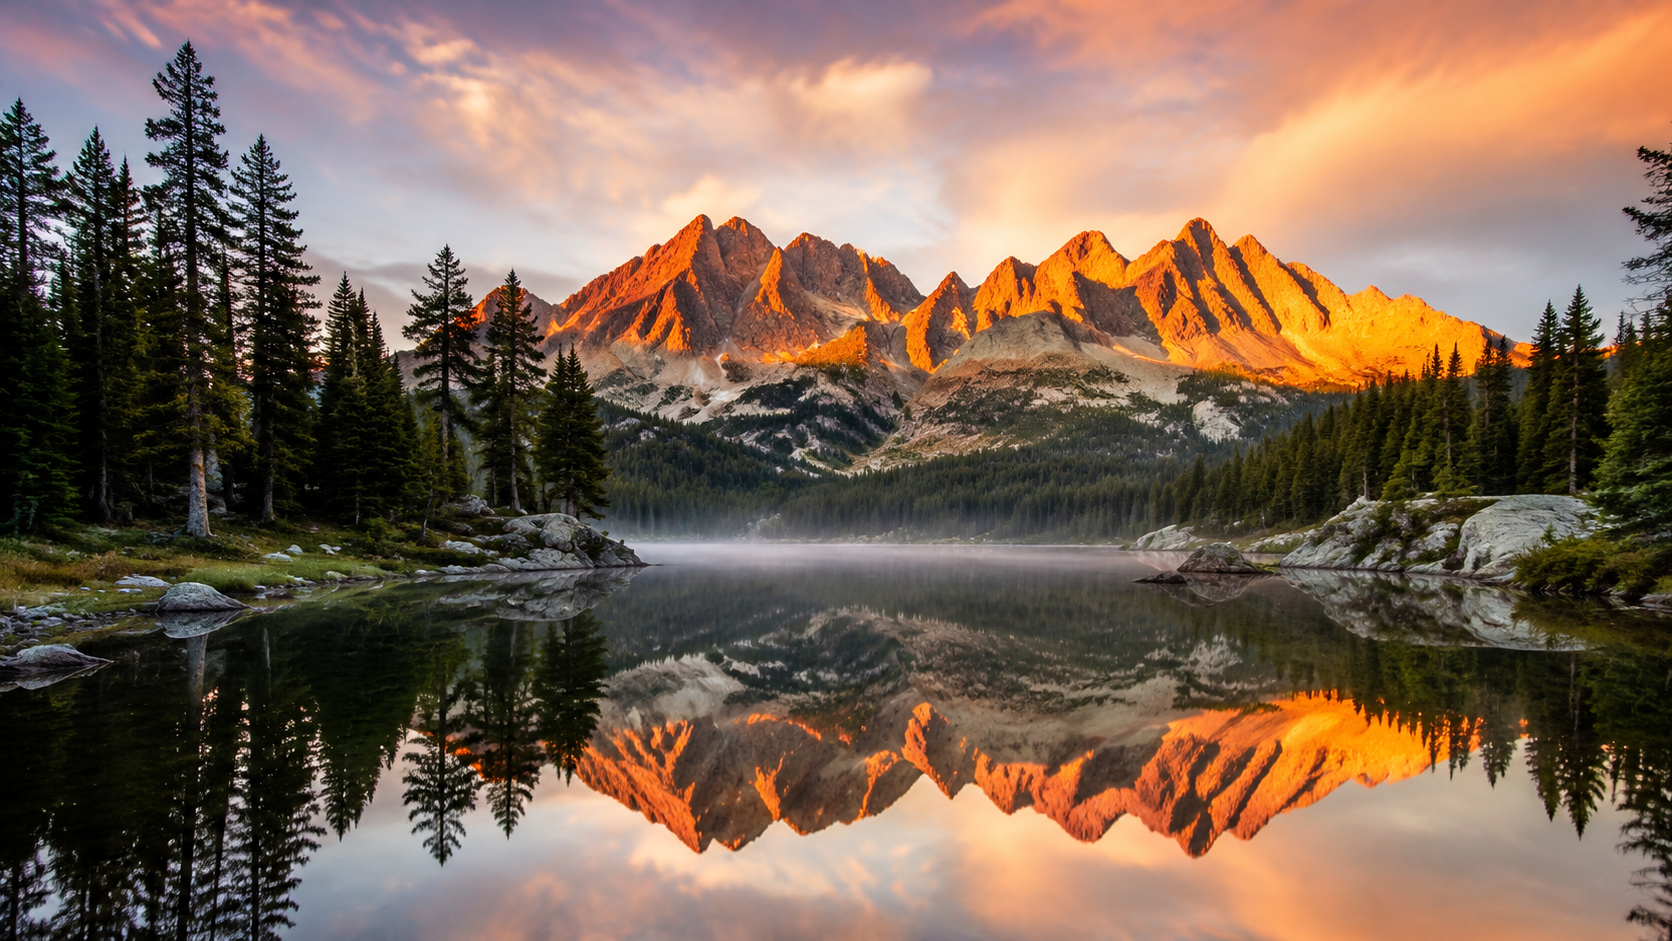
Frame di input (16:9, generato con gpt-image-2 — qualsiasi immagine tu abbia funziona allo stesso modo).
Bring the photograph to life with gentle ambient motion: mist drifts slowly across the far shore, soft ripples cross the mirror reflection, clouds creep behind the peaks, and two distant birds glide across the sky. The camera dollies forward very slowly over the water. Calm, seamless, loop-like motion, no cuts.
La nebbia si sposta, le increspature attraversano il riflesso mentre la camera avanza — kling-3.0-turbo/image-to-video, 4 s @ 720p. Output reale generato dal frame di input qui sopra, originale alla prima esecuzione, prodotto per questa guida.
Perché funziona: tutto si muove a un ritmo naturale — la nebbia "drifts slowly", le nuvole "creep", le increspature "cross" — e due uccelli danno all'occhio un evento focale, così la clip non sembra un salvaschermo. "Loop-like motion" guida il modello verso un ritmo uniforme che regge la riproduzione in loop, esattamente ciò che vuoi per un video di sfondo in una hero section.
Schema di input, verificato
Tutto quanto segue è stato confermato contro l'API live dei task prima di generare qualsiasi clip (i valori non validi restituiscono 400 con l'elenco dei valori accettati):
| Campo | Tipo | Descrizione |
|---|---|---|
prompt |
string | Obbligatorio — descrive il movimento, non l'immagine |
image_urls |
array di stringhe | Obbligatorio, esattamente un URL (maxItems: 1), deve essere pubblicamente accessibile |
duration |
integer | 3–15 secondi |
resolution |
string | 720p o 1080p |
Lo schema è rigoroso: aspect_ratio, seed, negative_prompt e sound vengono rifiutati con l'errore additional properties ... not allowed. Due conseguenze vale la pena conoscerle:
- Il rapporto d'aspetto dell'output segue il frame di input. Vuoi un video verticale? Fornisci un'immagine verticale (Ricetta 2). Nessun parametro può contrastare il frame.
- L'URL dell'immagine deve essere raggiungibile dalla piattaforma — ospitalo sul tuo CDN o storage a oggetti, non dietro autenticazione o su localhost.
Eseguire queste ricette da soli (API)
Tutte e quattro le ricette usano lo stesso flusso asincrono — crea il task con l'URL del tuo frame, fai polling fino allo stato finale, scarica l'mp4:
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY", "Content-Type": "application/json"}

def animate(image_url, prompt, duration=5, resolution="720p"):
    body = {"model": "kling-3.0-turbo/image-to-video",
            "input": {"prompt": prompt, "image_urls": [image_url],
                      "duration": duration, "resolution": resolution}}
    task_id = requests.post(API, json=body, headers=HEADERS, timeout=60).json()["data"]["taskId"]
    while True:
        t = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
        if t["status"] == "success":
            return t["output"][0]["url"]   # signed link, expires — download immediately
        if t["status"] == "fail":
            raise RuntimeError(t.get("error"))
        time.sleep(5)

print(animate("https://your-cdn.example.com/product.jpg",
              "Slow smooth orbit around the product, quarter turn right, no cuts"))
L'URL restituito da output[0].url è temporaneo — salva subito i byte, non fare hotlink. Per il riferimento completo dei parametri vedi la documentazione.
Domande frequenti
In cosa differisce dalla versione text-to-video di kling-3.0-turbo?
Stessa famiglia, stesso prezzo al secondo, diversa superficie di controllo: il text-to-video accetta aspect_ratio e crea la composizione; l'image-to-video accetta una voce image_urls e ne eredita la composizione. Se non hai un frame di partenza, usa la raccolta di ricette text-to-video.
Quanto costa una clip?
Si paga per secondo di output: 720p a $0.13/secondo, 1080p a $0.16/secondo. Le tre clip da 5 secondi di questo articolo costano $0.65 ciascuna, il paesaggio da 4 secondi $0.52, e un test da 3 secondi a 720p $0.39. Per i numeri aggiornati vedi la pagina dei prezzi.
Posso controllare il rapporto d'aspetto dell'output?
Solo tramite l'immagine di input — non esiste un campo aspect_ratio. Un frame 9:16 produce una clip 9:16 (Ricetta 2), un frame 16:9 produce una clip 16:9.
L'immagine di input deve essere generata con AI?
No — va bene qualsiasi URL immagine pubblicamente accessibile: fotografia di prodotto, still cinematografico, rendering. Ho generato questi frame con gpt-image-2 solo per rendere l'intero flusso riproducibile tramite una singola API.
Le clip hanno audio?
Le clip di questa guida tornano con una traccia ambient nativa (verificato sui file reali). Per i livelli di prezzo espliciti sull'audio e l'output 4K, guarda il livello omni — vedi la guida image-to-video di kling-3.0-omni.
Questi pattern di prompt si trasferiscono ad altri modelli image-to-video?
La struttura sì — prompt solo di movimento, movimento ambientale stratificato, fisica scritta come sequenza ordinata di battute. Manteniamo anche una raccolta di ricette image-to-video per wan2.7 che corrisponde, se vuoi confrontare un'altra famiglia di modelli sugli stessi pattern.
I quattro prompt di movimento sono tuoi da copiare. Ottieni una chiave API, punta lo snippet qui sopra su kling-3.0-turbo image-to-video, usa qualsiasi frame tu abbia, e una clip di test da 3 secondi costa $0.39.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori