
비교 평가
Synthesia 대안: HeyGen Avatar V로 AI 디지털 휴먼 영상 만들기
좌석 기반 디지털 휴먼 편집기 대신 사용량 기반 과금 API 대안 — 실제 스크립트 기반 및 오디오 기반 출력 예시 포함.
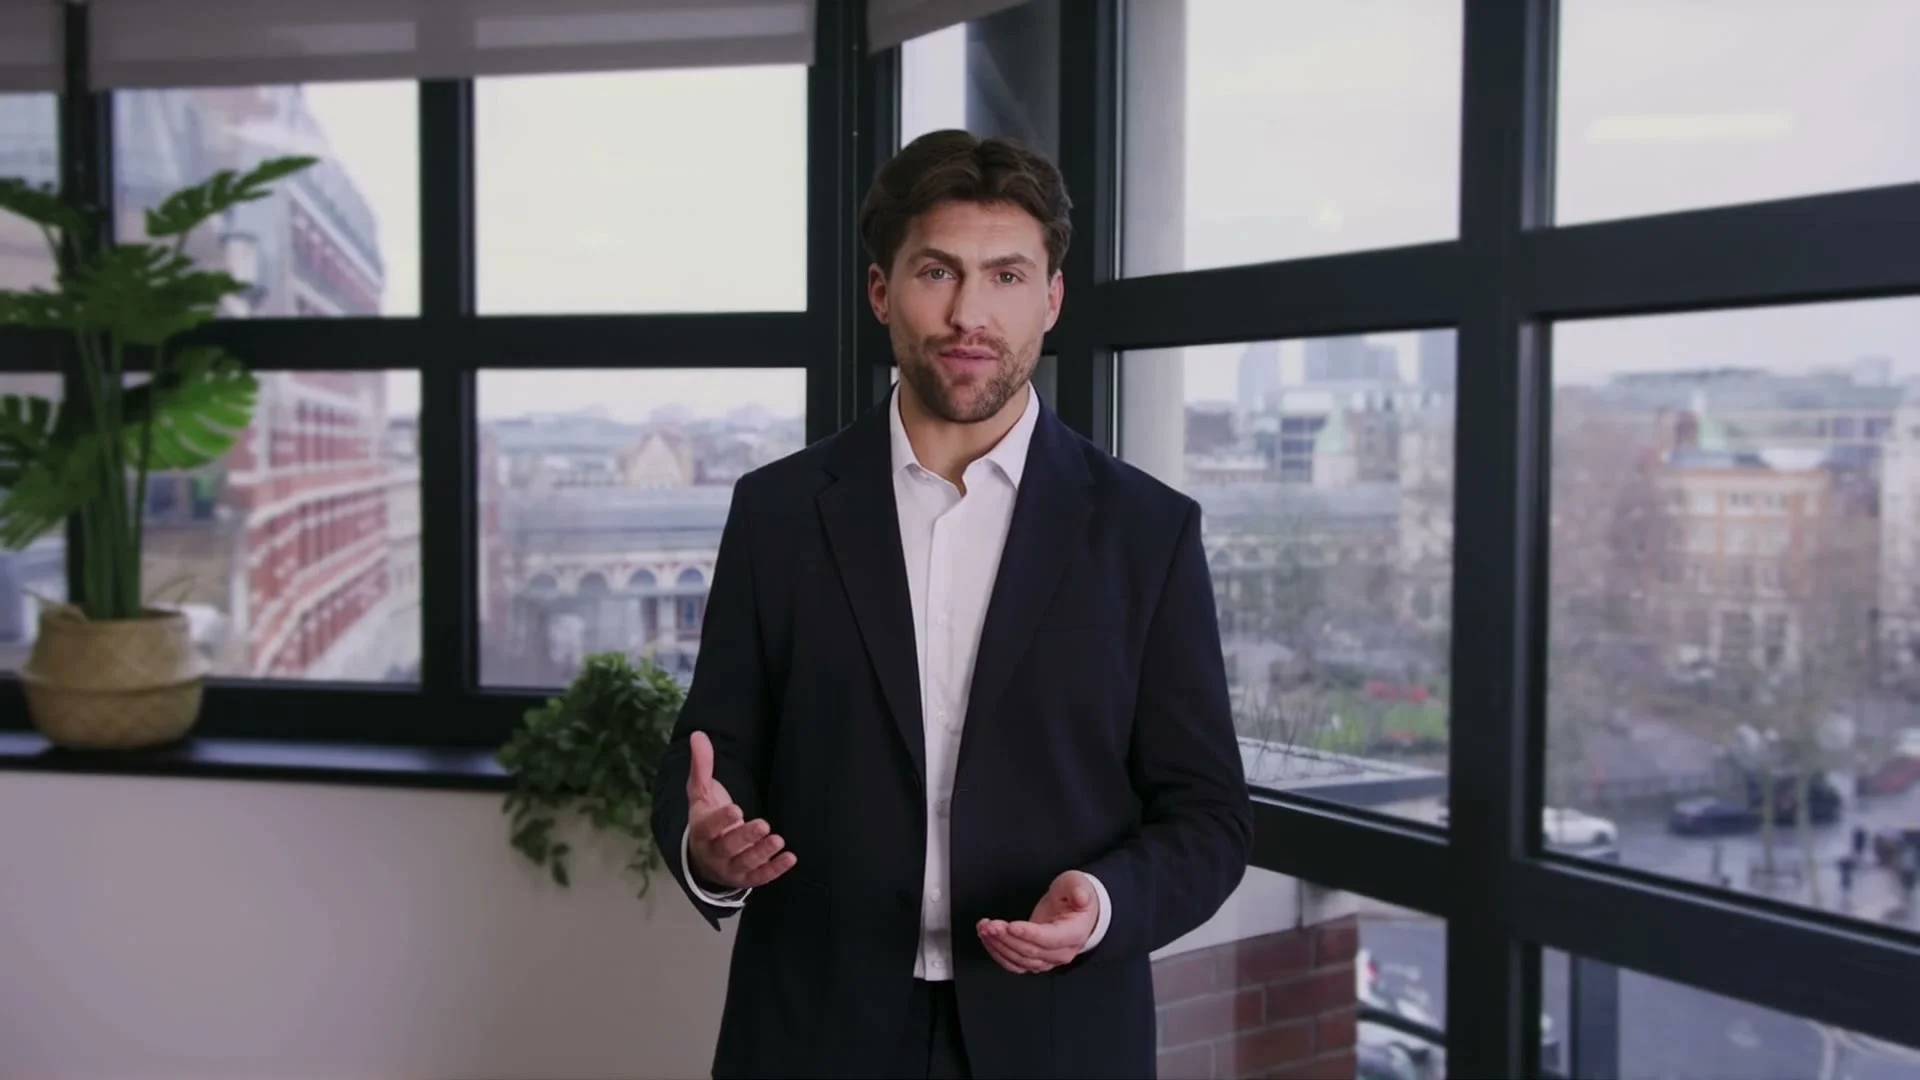
Synthesia의 대안을 검토 중이라면 짧게 답하자면, HiAPI의 HeyGen Avatar V는 동일한 종류의 출력 — 스크립트 또는 이미 보유한 오디오로 구동되는 립싱크 디지털 휴먼 영상 — 을 생성하지만, 좌석 라이선스 기반 웹 앱이 아닌 사용량 기반 과금 API 호출입니다. 편집기 로그인도, 월 최소 결제도 없으며, 가격은 실제로 렌더링한 영상 초 수에 따라 달라집니다. 아래에 실제 출력 샘플이 있습니다.
Synthesia 대안을 찾는 이유
Synthesia는 호스팅 편집기를 통해 기업 교육 및 설명 영상을 빠르게 제작하는 것으로 명성을 얻었습니다. 그 워크플로를 벗어나는 팀들은 보통 디지털 휴먼 품질에 불만이 있는 것이 아니라, 제품의 패키징 방식에서 문제를 겪습니다. 좌석 기반 구독은 콘텐츠 팀이 UI에서 작업하도록 설계된 것이지, 예약 또는 온디맨드로 디지털 휴먼 영상을 렌더링해야 하는 백엔드 작업을 위한 것이 아닙니다. 디지털 휴먼 생성을 앱, CMS 또는 자동화 파이프라인에 연결하고 사람이 수동으로 파일을 내보내지 않으려 한다면, 제약은 디지털 휴먼 엔진 자체가 아니라 접근 방식에 있습니다. 바로 이것이 HiAPI의 HeyGen Avatar V가 채우고자 하는 공백입니다.
HeyGen Avatar V가 실제로 할 수 있는 것
HeyGen Avatar V는 텍스트 스크립트와 음성 프리셋, 또는 구동 오디오 파일을 받아 립싱크 디지털 휴먼 영상을 반환합니다:
- 스크립트 기반 —
prompt(최대 5,000자)와voice를 전달하면, API가 내레이션을 생성하고 디지털 휴먼의 입 모양을 그에 맞춥니다. - 오디오 기반 — 대신
audio_url을 전달하면, 디지털 휴먼이 이미 제작한 오디오에 직접 립싱크합니다(최대 600초, 32 MiB). - 출력 제어 —
resolution(720p/1080p/4k),aspect_ratio(세로형을 위한9:16을 포함한 6가지 옵션),output_format(mp4/webm), 그리고fit,remove_background,background재정의. - 자막 —
caption: true로 설정하면, 완료된 작업이 영상과 함께 SRT 파일을 반환합니다. - 가격 — 출력 영상 초당 $0.15로 일괄 청구되며, 해상도에 따른 추가 요금이 없습니다. 30초 클립은 720p든 4K든 비용이 $4.50입니다.
- 접근 방식 — 단일
POST https://api.hiapi.ai/v1/tasks호출; 작업을 폴링하거나 콜백을 사용해 완료된output[]배열을 받습니다.
실제 출력: 모델의 두 가지 예시
장편 영상 내레이션, 1080p
Heres the pricing breakdown you asked for, explained simply.
avatar: "Brandon Business Standing Front"와 voice: "Jack Sterling"을 사용해 resolution: "1080p"로 렌더링했습니다. 솔직히 말하면, 이 클립은 background 색상 재정의(#0F172A)를 요청했지만 적용되지 않았습니다 — 디지털 휴먼은 원래의 실사 오피스 배경을 유지했습니다. 특정 배경이 사용 사례에 중요하다면, 프로덕션 투입 전에 먼저 테스트하세요.
숏폼 세로형 영상, 자막 포함
New drop just landed, swipe up and shop now!
avatar: "Riley Casual Front"와 voice: "Cute Chloe"를 사용해 aspect_ratio: "9:16" 및 caption: true로 렌더링했으며, 이 클립에는 부속 SRT 파일도 함께 반환되었습니다. 이것은 소셜/광고 집행 시나리오에서 더 깊이 다루는 동일한 숏폼 세로형 디지털 휴먼 워크플로입니다.
Synthesia vs HeyGen Avatar V: 진짜 차이는 접근 방식
이 두 제품은 같은 범주 — 스크립트에서 디지털 휴먼 영상 — 에 속하지만, 서로 다른 사용자를 위해 패키징되었습니다:
| Synthesia | HiAPI의 HeyGen Avatar V | |
|---|---|---|
| 접근 방식 | 호스팅 웹 편집기, 좌석 기반 플랜 | 직접 API, POST /v1/tasks |
| 과금 단위 | 구독 등급 / 번들 크레딧 | 렌더링 1초당 $0.15 |
| 적합한 용도 | UI에서 수동으로 영상을 제작하는 사람 | 프로그래밍 방식으로 영상을 생성하는 파이프라인 또는 앱 |
| 출력 | 립싱크 디지털 휴먼 영상 | 립싱크 디지털 휴먼 영상(스크립트 또는 오디오 기반) |
워크플로가 "한 사람이 로그인해서 파일을 내보내는" 방식이라면 Synthesia처럼 UI 우선 도구가 합리적인 선택입니다. 워크플로가 "서비스가 더 큰 파이프라인의 일부로 디지털 휴먼 영상을 생성해야 하는" 방식이라면 사용량 기반 과금 API가 더 적합한 형태이며 — 이것이 바로 HeyGen Avatar V가 채우는 공백으로, HiAPI의 다른 모든 영상 모델과 동일한 작업 기반 패턴을 사용합니다.
자주 묻는 질문
HeyGen Avatar V는 자막을 지원하나요?
지원합니다. caption: true로 설정하면, 성공적으로 완료된 작업이 output 배열에 영상(type: "video")과 SRT 파일(type: "caption")을 함께 반환합니다.
최대 영상 길이는 얼마인가요?
오디오 기반 생성은 최대 600초의 구동 오디오(최대 32 MiB)를 지원합니다. 스크립트 기반 길이는 스크립트에 따라 다르며 — prompt는 최대 5,000자를 받습니다.
사용 가능한 해상도와 화면 비율은 무엇인가요?
720p, 1080p, 4k이며, 6가지 화면 비율을 지원합니다: 16:9, 9:16, 4:5, 5:4, 1:1, auto.
가격이 정말 해상도와 무관하게 일괄인가요?
네 — 유일한 가격 요소는 estimated_seconds로, 초당 $0.15로 청구됩니다. 해상도는 비용을 바꾸지 않습니다.
스크립트 대신 기존 오디오로 디지털 휴먼을 구동할 수 있나요?
가능합니다 — prompt/voice 대신 audio_url을 전달하면, 디지털 휴먼이 해당 오디오에 직접 립싱크합니다.
시작하기
전체 파라미터 레퍼런스, 디지털 휴먼 프리셋, 음성 프리셋은 HeyGen Avatar V 모델 페이지에 있습니다. HiAPI의 모든 영상 모델이 공유하는 요청/응답 구조는 통합 비동기 API 빠른 시작을 참고하세요 — 위에서 보여준 것과 동일한 POST /v1/tasks → 폴링/콜백 → output[] 패턴입니다.


