
比較レビュー
Synthesia の代替案:HeyGen Avatar V で AI デジタルヒューマン動画を構築
Synthesia のシートベースのデジタルヒューマンエディターに代わる従量課金 API——実際のスクリプト駆動および音声駆動の出力例付き。
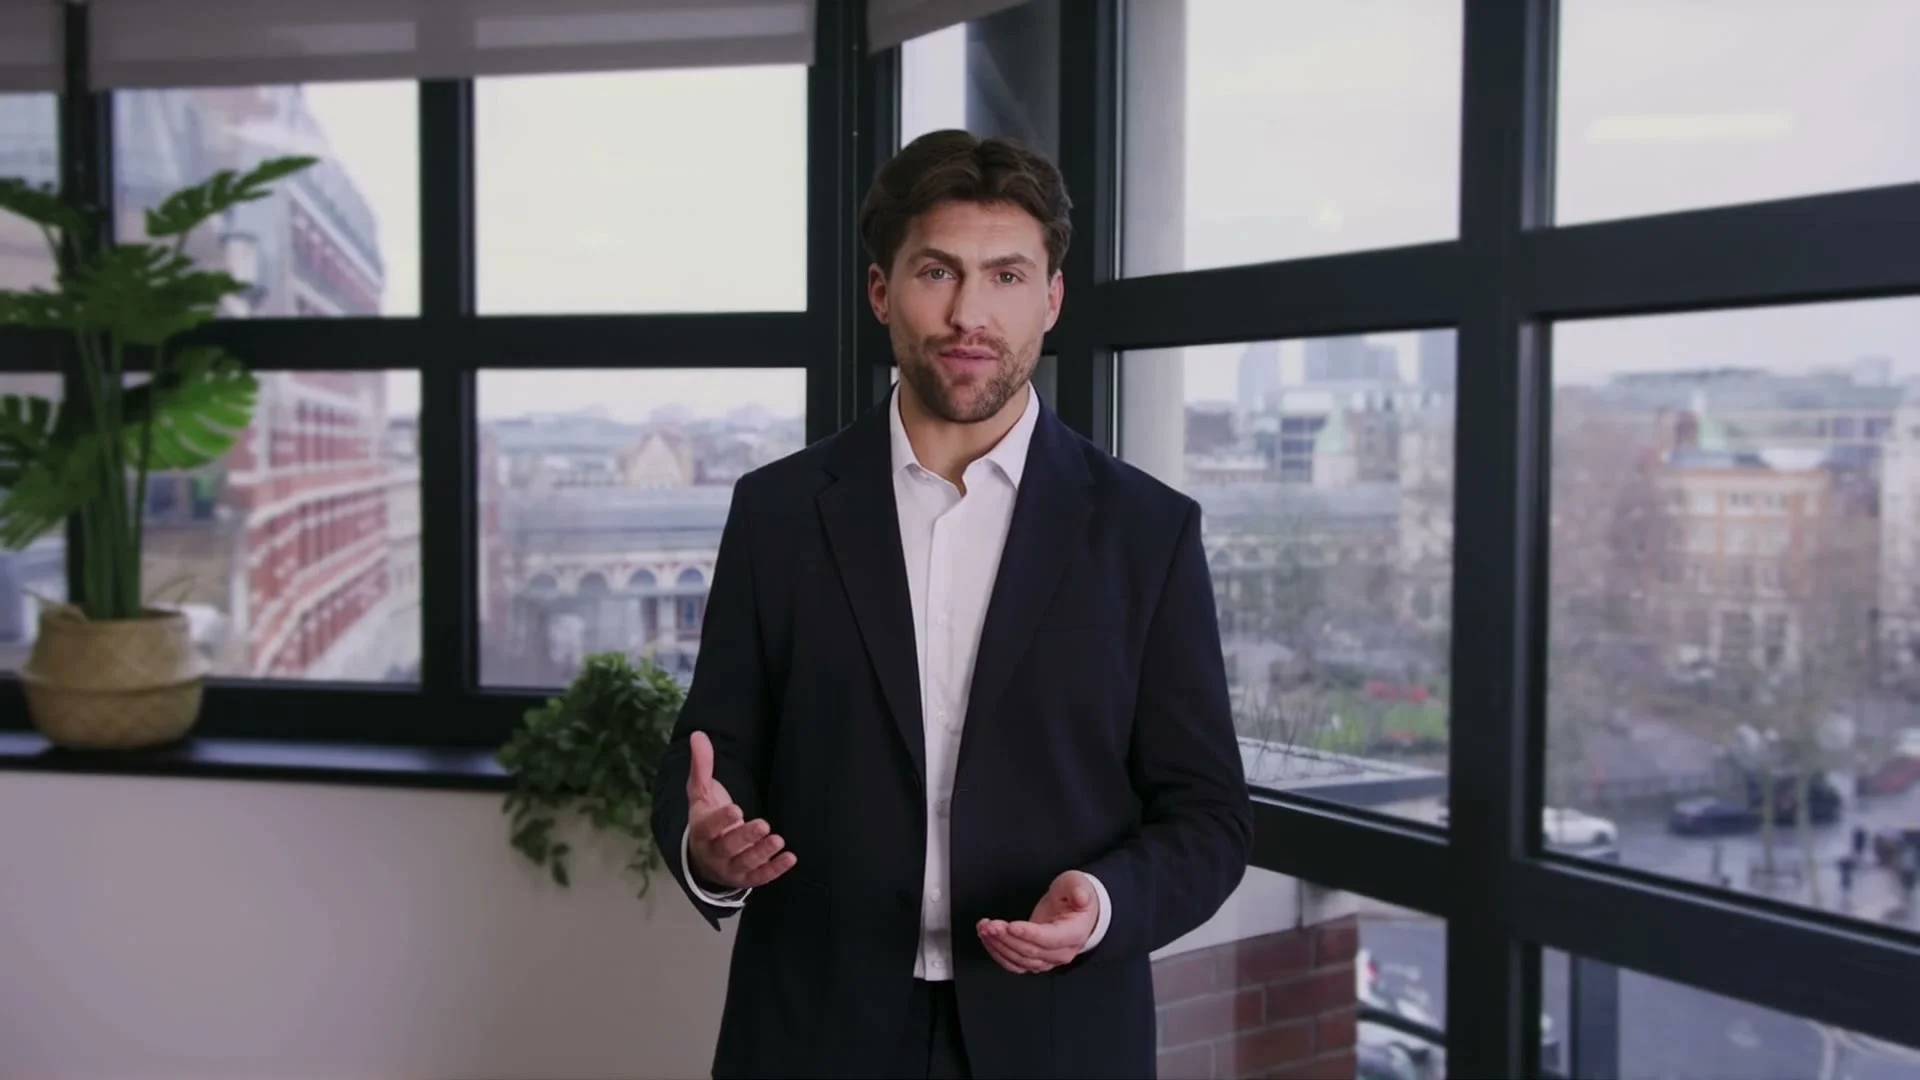
Synthesia の代替案を検討しているなら、短く言えばこうです。HiAPI 上の HeyGen Avatar V は同じ種類の出力——スクリプトや手持ちの音声で駆動されるリップシンク済みのデジタルヒューマン動画——を生成できますが、それはシートライセンス制の Web アプリではなく、従量課金の API 呼び出しです。エディターへのログインも、月額最低利用料もなく、料金は実際にレンダリングした動画の秒数に応じて変わります。以下に実際の出力サンプルを示します。
Synthesia の代替案を探す理由
Synthesia は、ホスト型エディターを通じて企業研修や解説動画を素早く制作できることで評価を確立しました。そのワークフローを超えるチームが不満を感じるのは、通常デジタルヒューマンの品質ではなく、製品のパッケージング方法です。シートベースのサブスクリプションはコンテンツチームが UI 上で操作するために設計されており、スケジュールやオンデマンドでデジタルヒューマン動画をレンダリングするバックエンドタスク向けではありません。手動でファイルをエクスポートするのではなく、アプリ、CMS、自動化パイプラインにデジタルヒューマン生成を組み込みたい場合、制約となるのはアクセス方式であり、必ずしもデジタルヒューマンエンジン自体ではありません。まさにこのギャップを埋めるのが、HiAPI 上の HeyGen Avatar V です。
HeyGen Avatar V に実際にできること
HeyGen Avatar V は、テキストスクリプトと音声プリセット、または駆動用の音声ファイルを受け取り、リップシンク済みのデジタルヒューマン動画を返します:
- スクリプト駆動——
prompt(最大 5,000 文字)とvoiceを渡すと、API がナレーションを生成し、デジタルヒューマンの口の動きをそれに同期させます。 - 音声駆動——代わりに
audio_urlを渡すと、デジタルヒューマンは既に制作済みの音声に直接リップシンクします(最長 600 秒、32 MiB)。 - 出力制御——
resolution(720p/1080p/4k)、aspect_ratio(縦向き用の9:16を含む 6 つのオプション)、output_format(mp4/webm)、さらにfit、remove_background、backgroundの上書き設定。 - 字幕——
caption: trueを設定すると、完了したタスクは動画と一緒に SRT ファイルを返します。 - 料金——出力動画 1 秒あたり $0.15 の一律課金で、解像度による割増はありません。30 秒のクリップは 720p でも 4K でも $4.50 です。
- アクセス方法——1 回の
POST https://api.hiapi.ai/v1/tasks呼び出し。タスクをポーリングするか、コールバックで完了したoutput[]配列を取得します。
実際の出力:モデルの 2 つの例
長尺動画のナレーション、1080p
Heres the pricing breakdown you asked for, explained simply.
avatar: "Brandon Business Standing Front" と voice: "Jack Sterling" を使用し、resolution: "1080p" でレンダリングしました。正直に言うと、このクリップは background カラーの上書き(#0F172A)をリクエストしましたが、反映されませんでした——デジタルヒューマンは元の実写オフィス背景を保持しました。特定の背景がユースケースにとって重要なら、本番投入前に必ずテストしてください。
字幕付きの短尺縦型動画
New drop just landed, swipe up and shop now!
avatar: "Riley Casual Front" と voice: "Cute Chloe" を使用し、aspect_ratio: "9:16" と caption: true でレンダリングしました。このクリップでは付属の SRT ファイルも返されました。これは、ソーシャル/広告配信の場面でより詳しく紹介している 短尺縦型デジタルヒューマンワークフローと同じものです。
Synthesia と HeyGen Avatar V:本当の違いはアクセス方式
この 2 つの製品は同じカテゴリー——スクリプトからデジタルヒューマン動画——に属しますが、対象ユーザーに合わせてパッケージング方法が異なります:
| Synthesia | HiAPI 上の HeyGen Avatar V | |
|---|---|---|
| アクセス方法 | ホスト型 Web エディター、シートベースのプラン | ダイレクト API、POST /v1/tasks |
| 課金単位 | サブスクリプションティア / バンドルクレジット | レンダリング 1 秒あたり $0.15 |
| 最適な用途 | UI 上で手動で動画を制作する人 | プログラムで動画を生成するパイプラインやアプリ |
| 出力 | リップシンク済みのデジタルヒューマン動画 | リップシンク済みのデジタルヒューマン動画(スクリプトまたは音声駆動) |
ワークフローが「人がログインしてファイルをエクスポートする」ものであれば、Synthesia のような UI 優先のツールは妥当な選択です。ワークフローが「サービスがより大きなパイプラインの一部としてデジタルヒューマン動画を生成する必要がある」ものであれば、従量課金 API のほうが適した形です——そしてこれが HeyGen Avatar V が埋めるギャップであり、HiAPI 上の他のすべての動画モデルと同じタスクベースのパターンを使用しています。
よくある質問
HeyGen Avatar V は字幕に対応していますか?
はい。caption: true を設定すると、正常に完了したタスクは output 配列に動画(type: "video")と SRT ファイル(type: "caption")を同時に返します。
動画の最大長はどれくらいですか?
音声駆動の生成では、最長 600 秒の駆動音声に対応します(最大 32 MiB)。スクリプト駆動の長さはスクリプト次第で、prompt は最大 5,000 文字を受け付けます。
利用可能な解像度とアスペクト比は?
720p、1080p、4k に対応し、6 つのアスペクト比をサポートします:16:9、9:16、4:5、5:4、1:1、auto。
料金は本当に解像度に依存せず一律ですか?
はい——唯一の料金要素は estimated_seconds で、1 秒あたり $0.15 で課金されます。解像度は費用を変えません。
スクリプトの代わりに既存の音声でデジタルヒューマンを駆動できますか?
はい——prompt/voice の代わりに audio_url を渡すと、デジタルヒューマンはその音声に直接リップシンクします。
はじめに
完全なパラメーターリファレンス、デジタルヒューマンプリセット、音声プリセットはHeyGen Avatar V モデルページにあります。HiAPI 上のすべての動画モデルが共有するリクエスト/レスポンス構造については、統一非同期 API クイックスタート——上記で示したものと同じ POST /v1/tasks → ポーリング/コールバック → output[] パターン——を参照してください。


