
Guia de uso
Guia de integração para desenvolvedores do gpt-image-2.6-flare/image-to-image: limites de capacidade, preços e pontos de integração
Dos limites de capacidade à cobrança por imagem, esclareça de uma vez as decisões-chave antes da integração
Nesta página
Para que problemas este modelo é adequado
gpt-image-2.6-flare/image-to-image é um modelo de imagem para imagem (image-to-image) fornecido pela OpenAI, cujo tipo de saída é imagem. Sua entrada não é um texto puro, mas uma (ou várias) imagens existentes, acrescidas da sua descrição de «como deve ficar», produzindo por fim uma nova imagem. Esse posicionamento determina o tipo de problema que ele resolve.
Cenários adequados
- Transformação direcionada com uma imagem de base: você tem imagens de produtos, ilustrações, capturas de tela de interface ou fotos prontas e deseja alterar estilo, detalhes ou conteúdo local enquanto preserva a estrutura do sujeito.
- Geração que precisa de uma âncora visual estável: a geração puramente por texto pode desviar a cada execução, enquanto o image-to-image delega a restrição de «qual é a aparência» à imagem de entrada, bastando que a descrição foque em «o que mudar».
- Etapa de pós-processamento de imagens em um fluxo: por exemplo, gerar variantes de forma unificada após o upload ou produzir vários conjuntos de materiais visuais a partir de um template.
Cenários pouco adequados
- Criação do zero, sem nenhuma imagem de referência: esse tipo de necessidade é mais adequado a modelos de geração puramente por texto; forçar uma imagem de base irrelevante só adiciona interferência ao modelo.
- Edição que exige reprodução pixel a pixel exata: a saída do modelo de imagem é um «resultado regenerado», não uma ferramenta de retoque em nível de pixel; esperar que ele mova com precisão a posição de um elemento costuma frustrar.
- Layouts com conteúdo textual absolutamente preciso: a renderização de texto sempre foi um ponto fraco na geração de imagens; para textos críticos, recomenda-se sobrepor com ferramentas de design ou composição programática após a geração.
Em resumo: trate o gpt-image-2.6-flare/image-to-image como um gerador «que parte de uma imagem», e não como um software de retoque. Com isso claro, o design de parâmetros e o controle de custos posteriores passam a fazer sentido.
Cobrança por imagem: como calcular o modelo de custo
O modelo cobra por imagem, e a dimensão de cobrança é a quantidade de imagens de saída, não a quantidade de imagens de entrada nem tokens. Isso significa que o modelo de custo é bastante linear: o custo total é proporcional ao número total de imagens finalmente produzidas.
O custo é determinado por três variáveis
- Quantidade de imagens por requisição: quantas imagens uma chamada gera, o amplificador mais direto.
- Número de requisições: a frequência com que o lado do negócio dispara chamadas.
- Proporção de retentativas e descartes: a parte reexecutada por insatisfação com o resultado também entra na contagem de imagens de saída.
A estimativa de orçamento pode ser simplificada como:
Quantidade estimada de saída = número de requisições × imagens por requisição × (1 + taxa de retentativa)
Multiplicando pelo preço unitário, tem-se a ordem de grandeza do custo dessa funcionalidade para um determinado volume de chamadas. Observe que o preço unitário deve seguir os valores em tempo real exibidos no painel de preços do HiAPI.ai; este artigo não fixa números concretos para evitar dessincronização com ajustes de preço.
Três pontos fáceis de deixar de fora
- Taxa de retentativa subestimada: a geração de imagens tem aleatoriedade natural, e o desejo do usuário de «gerar outra» se converte diretamente em nova saída cobrada. Recomenda-se, na fase de avaliação, fazer execuções piloto em pequeno lote com imagens reais do negócio para medir a proporção real de retentativas.
- Várias imagens em uma chamada vs. várias chamadas de uma imagem: se o negócio precisa de vários candidatos, projetar como várias saídas em uma única requisição costuma favorecer a observação de custos e a simplificação do fluxo em comparação com chamadas seriais.
- O ambiente de teste também consome: integração, regressão e demonstrações geram imagens de saída; a apuração de custos deve identificar separadamente o tráfego não produtivo.
Na prática de engenharia
No código, registre para cada chamada «ID da requisição / identificador da imagem de entrada / quantidade de imagens de saída / cenário a que pertence», formando um livro-razão leve de uso. Assim é possível atribuir custos por cenário e, mantendo o preço unitário, melhorar diretamente o custo unitário do negócio ajustando a quantidade de imagens e a estratégia de retentativa. Para modelos cobrados por imagem, a visualização do uso em si já é metade da otimização de custos.
Elementos de requisição a preparar antes da integração
Para integrar um modelo de imagem para imagem, é preciso primeiro esclarecer três coisas: «o que fornecer, o que pedir e quanto pedir». Os nomes específicos dos parâmetros seguem a documentação do HiAPI.ai; aqui apresentamos uma lista de elementos no nível de design.
1. Especificação da imagem de entrada
- Formato e tamanho: defina antecipadamente os formatos e limites de tamanho permitidos e faça pré-validação no cliente, evitando que imagens não conformes só falhem no servidor.
- Resolução e proporção: a nitidez e a proporção da imagem de entrada afetam significativamente a qualidade e a composição da saída; recomenda-se normalizar uma vez no lado do negócio (redimensionar, recortar ou preencher bordas).
- Confiabilidade da origem: imagens enviadas por usuários podem conter conteúdo sensível ou formatos anormais; o servidor deve ter verificações básicas de conteúdo e segurança antes de entrar na etapa de geração.
2. Descrição da intenção da requisição
A descrição do image-to-image deve responder «o que mudar em relação à imagem de entrada», e não descrever a cena do zero. Recomenda-se:
- montar o prompt com templates estruturados (sujeito inalterado + estilo alvo + detalhes a ajustar), reduzindo a volatilidade da entrada livre;
- fixar vários conjuntos de templates de prompt para o mesmo tipo de negócio, com versionamento, para facilitar comparações A/B de efeitos;
- não inserir informações privadas do usuário nos prompts.
3. Quantidade de saída e modo de chamada
- Quantidade de imagens: determina diretamente o custo por chamada; defina faixas por cenário de negócio, não libere globalmente.
- Síncrono ou assíncrono: a geração de imagens costuma demorar mais que texto; se o produto é sensível à latência da primeira tela, projete um fluxo de tarefa assíncrona + polling/callback em vez de deixar o front-end esperando.
- Timeout e retentativa: defina limites de timeout e máximo de retentativas, com backoff nas retentativas, evitando amplificar chamadas quando o servidor oscila.
4. Camada de adaptação unificada
Recomenda-se encapsular no servidor uma camada de adaptação de geração de imagens, de modo que o código de negócio dependa apenas da abstração «imagem de entrada + intenção + quantidade → lista de imagens de saída». A vantagem é que substituição de modelo, degradação e estatísticas se concentram em um único lugar, minimizando mudanças ao comparar horizontalmente outros modelos de imagem no futuro.
Usos típicos e design de fluxo
Um fluxo de image-to-image viável pode ser dividido aproximadamente em cinco etapas: «upload → validação → geração → distribuição → armazenamento».
Fluxo ponta a ponta
- Cliente envia a imagem de entrada: o front-end faz pré-validação de formato e tamanho, envia ao armazenamento de objetos e obtém uma referência da imagem, em vez de inserir o binário na requisição de negócio.
- Verificação de admissão no servidor: valida se a imagem é decodificável, se as dimensões estão conformes, se o conteúdo é seguro, e registra identificadores de usuário e cenário.
- Montagem da requisição de geração: a camada de adaptação combina referência da imagem, template de prompt e quantidade de imagens em uma chamada e grava o registro da tarefa (ID da tarefa, cenário, quantidade).
- Espera assíncrona do resultado: em cenários de longa duração, cria a tarefa e retorna imediatamente o ID, obtendo o resultado por polling ou callback; em cenários curtos, pode retornar de forma síncrona.
- Tratamento e distribuição do resultado: transfere as imagens geradas para armazenamento próprio, gera links de acesso com expiração e registra o uso (quantidade de saída) no livro-razão.
- Falha e retentativa: para falhas de rede, faz retentativas com backoff em número limitado; para «geração bem-sucedida mas usuário insatisfeito», aciona nova geração por iniciativa do usuário, e não reexecução automática.
Pontos de design
- Prioridade à tarefa: modele cada geração como uma entidade de tarefa, com máquina de estados clara (na fila / gerando / sucesso / falha); a experiência do front-end e a solução de problemas no back-end ficam muito mais simples.
- Chave de idempotência: submissões repetidas do mesmo usuário com a mesma imagem de entrada e a mesma intenção devem acionar a lógica de idempotência, evitando cobrança duplicada.
- Estratégia de retenção de resultados: por padrão, transfira as imagens geradas para armazenamento próprio, evitando depender de links temporários; ao mesmo tempo, defina período de retenção para controlar o custo de armazenamento.
- Observabilidade: marque cada tarefa com cenário, versão do template e quantidade de imagens; a avaliação de efeitos e a atribuição de custos posteriores dependem dessas tags.
O valor desse fluxo é transformar a «chamada ao modelo» em uma etapa de negócio monitorável, reproduzível e mensurável, e não em uma requisição HTTP espalhada pelo código de negócio.
Sugestões de otimização de custo e estabilidade
Como a cobrança é linear pela quantidade de saída, as alavancas de otimização de custo são relativamente claras; a otimização de estabilidade recai mais sobre o design de timeout, retentativa e degradação.
Lado do custo
- Definir quantidade de imagens por cenário: prévias internas podem gerar só uma imagem, e a publicação oficial pode gerar vários candidatos; não use um valor padrão global para tudo.
- Cache e reutilização de resultados: requisições com a mesma imagem de entrada + mesmo template de intenção podem acionar o cache e retornar o resultado histórico; para cenários de e-commerce e templates, pré-gerar + reutilizar costuma ser mais vantajoso que chamar em tempo real.
- Lotes e agregação: coloque tarefas de processamento do mesmo lote de imagens de entrada em fila para consumo serial, com limite de concorrência, evitando que picos instantâneos elevem a taxa de retentativa.
- Limitar reexecução automática: só retente em falhas técnicas claras (rede, timeout); a «insatisfação» no nível de negócio fica a cargo de acionamento do usuário.
- Painel de uso: estatísticas de imagens de saída por cenário e por versão de template, com limpeza periódica de chamadas de baixo valor.
Lado da estabilidade
- Limitação de concorrência: limites em dois níveis, por usuário e global, para evitar que uma única conta ou tráfego súbito esgote a cota.
- Timeout por níveis: configure separadamente timeout de conexão e de geração; tarefas longas passam a assíncronas, evitando que interfaces síncronas travem.
- Circuit breaker e degradação: quando a taxa de erro ultrapassar o limite, abra o circuito e degrade retornando uma imagem provisória ou pedindo para tentar mais tarde, em vez de retentar indefinidamente.
- Governança de imagens de entrada: a maioria das falhas vem de entradas não conformes; antecipar a validação no cliente reduz significativamente chamadas inúteis.
- Implantação gradual: valide efeito e taxa de falha de templates de prompt e ajustes de parâmetros com pouco tráfego antes de liberar totalmente.
As duas otimizações têm tensão: cache e limitação de concorrência aumentam a estabilidade e reduzem custos, mas podem sacrificar frescor. Recomenda-se configurar estratégias separadas para linhas de negócio «sensíveis a atualidade» e «insensíveis a atualidade», em vez de buscar uma configuração universal.
Dúvidas frequentes e ideias de solução de problemas
Ao integrar geração de imagens, os problemas geralmente se enquadram em três categorias: lado da entrada, lado da chamada e lado do resultado. Investigar nessa ordem é o mais eficiente.
Primeira camada: a imagem de entrada está conforme
- A imagem decodifica normalmente? O formato está na lista de permitidos?
- Dimensões, proporção e tamanho do arquivo estão dentro dos limites?
- O conteúdo acionou a verificação de segurança?
- A referência da imagem é acessível pelo servidor (permissões de armazenamento, links temporários expirados)?
Problemas no lado da entrada costumam se manifestar como «a requisição falha diretamente» ou «o resultado gerado não tem relação alguma»; são os primeiros a eliminar.
Segunda camada: o fluxo de chamada está saudável
- Foi timeout de chamada síncrona ou retorno de código de erro explícito? O tratamento é diferente.
- O parâmetro de quantidade de imagens excede o intervalo permitido?
- A cota da conta ou o limite de concorrência foram atingidos?
- As retentativas criaram efeito de amplificação (uma falha dispara várias reexecuções)?
Recomenda-se distinguir nos logs «erro do cliente» e «erro do servidor/rede»; o primeiro não deve ser retentado, o segundo sim, com backoff.
Terceira camada: o resultado está dentro do esperado
- Se «o estilo saiu errado»: o problema provavelmente está no template de prompt; verifique se ele expressa claramente «o que mudar em relação à imagem de entrada».
- Se «o sujeito se perdeu»: a imagem de entrada pode estar complexa demais ou com resolução insuficiente; tente melhorar a qualidade da entrada ou simplificar a intenção.
- Se «o texto saiu borrado»: é uma deficiência comum da geração de imagens; considere sobrepor texto programaticamente após a geração.
- Se «às vezes bom, às vezes ruim»: a geração de imagens tem aleatoriedade; execute várias vezes com a mesma entrada para estatificar a taxa de aprovação e então decidir se ajusta o template.
Resumo da ordem de investigação
Primeiro a entrada, depois o fluxo, por fim o efeito. As duas primeiras camadas são determinísticas e permitem localização rápida; a terceira é probabilística e exige amostra para sustentar o julgamento. Transforme os pontos de checagem de cada camada em campos de log: a solução de problemas deixa de ser «adivinhação» e passa a ser «consulta».
Quando considerar comparar horizontalmente outros modelos de imagem
gpt-image-2.6-flare/image-to-image é uma escolha razoável para «geração direcionada com imagem de base», mas não é a solução geral para todas as necessidades de imagem. Os sinais abaixo indicam que vale a pena voltar o olhar para outros modelos de imagem.
Sinais que disparam a comparação horizontal
- Estrutura de custo incompatível: com o crescimento do volume de negócio, o custo total por imagem ultrapassa a faixa orçamentária, enquanto outros modelos, com qualidade equivalente, têm outra forma de cobrança (por exemplo, por token).
- Qualidade insuficiente: em estilos específicos ou categorias específicas (como pessoas, detalhes de produtos, composição de texto), ajustes repetidos de prompt não atingem a linha de aceitação.
- Limites de capacidade não cobertos: a necessidade se expande de «alterar imagem» para «geração pura» ou «referência com múltiplas imagens», e um único modelo pode não cobrir tudo.
- Exigências de estabilidade e conformidade aumentam: necessidade de redundância com múltiplos fornecedores, compromissos específicos de conformidade de dados ou garantias de cota mais detalhadas.
Como fazer a transição de forma suave
A chave está na camada de adaptação unificada mencionada anteriormente. Abstraia as demandas de imagem do negócio como «conjunto de imagens de entrada + intenção + quantidade e especificação de saída → lista de resultados», com todos os detalhes de chamada do modelo concentrados dentro da camada de adaptação. Assim, ao trocar de modelo:
- adicione uma nova implementação de modelo e registre-a na camada de adaptação;
- faça comparação offline com o mesmo lote de imagens de entrada de referência, quantificando qualidade e custo unitário;
- faça implantação gradual por cenário, observando taxa de falha e satisfação do usuário;
- mantenha o modelo original como caminho de degradação.
Sugestão de dimensões de avaliação
Na comparação, não compare apenas o preço unitário, mas «quantidade total de saída necessária para atingir a qualidade de aceitação × preço unitário» — porque a taxa de aprovação na primeira tentativa varia entre modelos; um modelo com preço nominal baixo mas alta taxa de retentativa pode ter custo unitário real maior. Inclua também latência, taxa de falha e restrições de entrada na tabela de pontuação.
No HiAPI.ai, você pode integrar diferentes modelos de imagem com o mesmo conjunto de formas de chamada, facilitando esse tipo de comparação horizontal. Recomenda-se primeiro esclarecer seus cenários e volume de uso e só então decidir se introduz um segundo modelo — redundância de múltiplos modelos tem valor, mas, sem necessidade real, o custo de manutenção também é custo.
Com limites de capacidade, forma de cobrança e elementos de requisição bem definidos, a integração do gpt-image-2.6-flare/image-to-image em si não é complexa; o que realmente determina o efeito de longo prazo é o design dessa camada de adaptação e governança.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de integração do Gemini Omni 1.2 Flash: modos de entrada, parâmetros e cobrança por especificação
Caminho mínimo de integração do modelo público gemini-omni-1.2-flash: modos de entrada, restrições de parâmetros, requisições copiáveis e cobrança por resolução
-
Guia de uso
Troque o Claude Code pelo DeepSeek gratuito: configure agora e comece a usar direto em 24 de novembro
Três formas de conectar: Claude Code, Python e curl; valide a configuração gratuitamente agora
-
Guia de uso
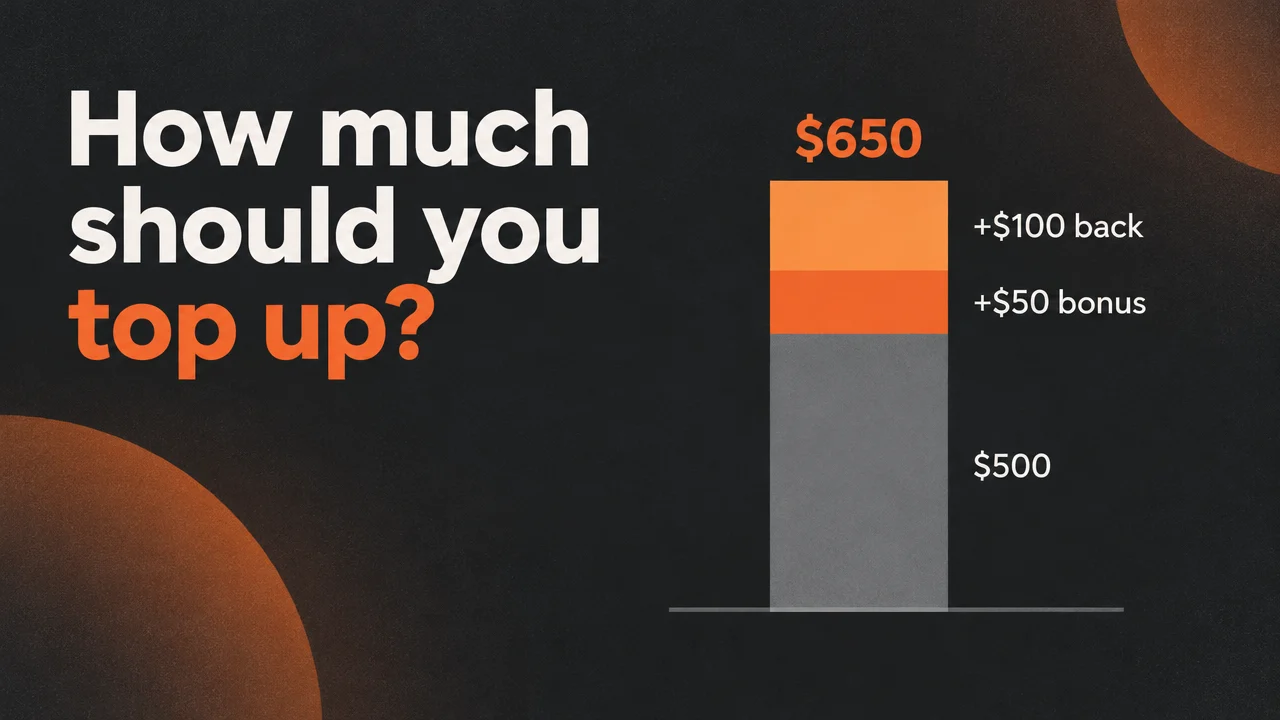
Na Black Friday, quanto recarregar compensa mais: $100 rende 18% a mais, $500 rende 30% a mais
Quatro faixas de orçamento, de $50 a $500, convertidas em segundos de vídeo e quantidade de imagens