
Guia de uso
Coletânea de casos do HeyGen Avatar IV: fotos, falas e vídeos finais de 7 cenários
Explicação horizontal, narração vertical, apresentação corporativa, lembrete de saúde, guiado por áudio, personagem 3D, curso em tela vertical — cada cenário traz foto de entrada, vídeo final real e falas completas, e as falas vão para a página do modelo com um clique.
Uma foto de retrato e um roteiro: com o HeyGen Avatar IV, a pessoa da foto passa a falar, e a sincronia labial, os piscares e as acenações com a cabeça acompanham o áudio. Os 7 cenários abaixo são todos vídeos finais reais, cada um com foto de entrada, falas completas e parâmetros; clique em «Gerar com esta fala», o roteiro já estará preenchido, e basta enviar sua própria foto para gerar. O HeyGen Avatar IV já está disponível no HiAPI, abra a página do modelo e gere direto, com cobrança por segundo de $0.15; um vídeo de 8 segundos custa $1.20.
| Cenário | Formato | Duração | Custo |
|---|---|---|---|
| 1. Explicação horizontal | 16:9 | 9 segundos | $1.35 |
| 2. Narração vertical de recomendação | 9:16 | 8 segundos | $1.20 |
| 3. Apresentação corporativa | 16:9 | 8 segundos | $1.20 |
| 4. Lembrete de saúde quadrado | 1:1 | 8 segundos | $1.20 |
| 5. Guiado por gravação | 9:16 | 10 segundos | $1.50 |
| 6. Personagem 3D falando | 16:9 | 8 segundos | $1.20 |
| 7. Foto horizontal em curso vertical | 9:16 | 11 segundos | $1.65 |
1. Explicação horizontal: uma foto para apresentar um produto ou abrir um curso
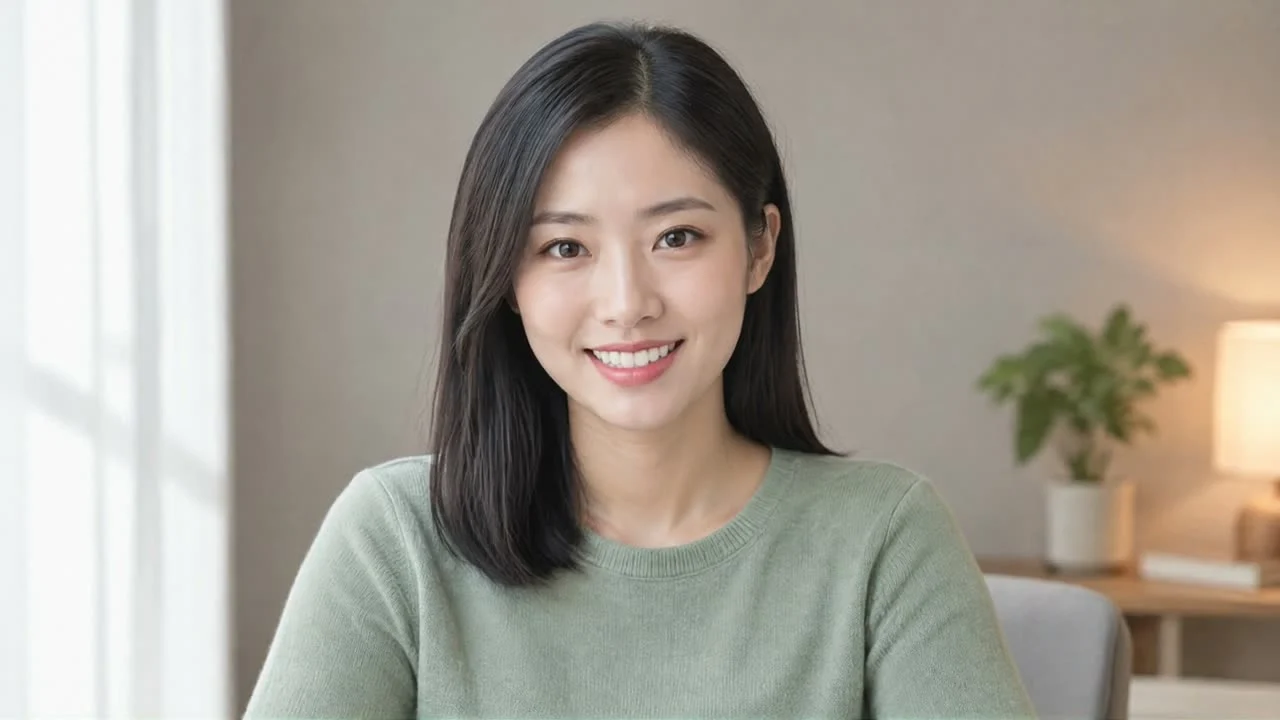
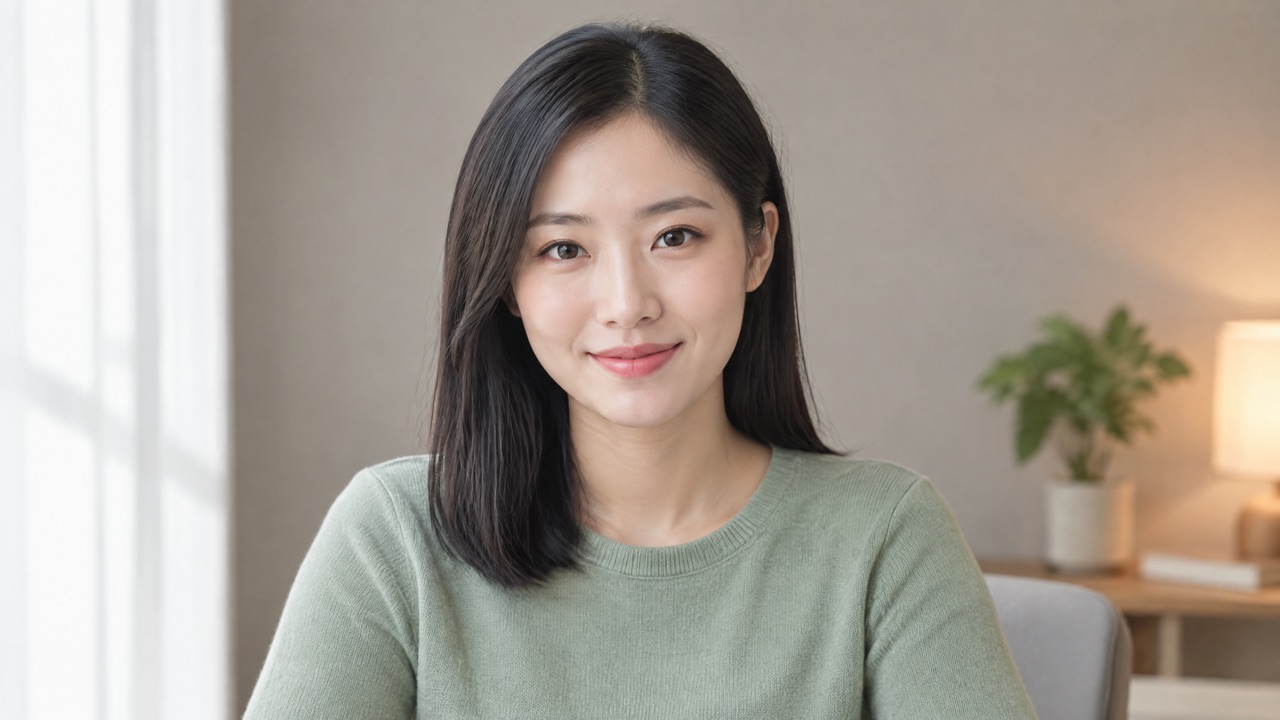
Ideal para a primeira tela do site, a abertura de um curso ou a página de apresentação de um produto; basta uma foto de meio corpo em ambiente doméstico.
Foto de entrada
Vídeo final
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
Significado em chinês: sou a Lin. Com uma foto e um roteiro curto, posso apresentar seu produto ou gravar uma aula, com sincronia labial e expressões naturais.
Parâmetros: voz Cute Chloe - Friendly · 16:9 · 1080p · 9 segundos ($1.35)
Gerar com esta fala → O roteiro já está preenchido; basta enviar sua própria foto para gerar; escolha a voz Cute Chloe - Friendly e o formato 16:9.
O vídeo final mantém o suéter, o penteado e o quarto da foto, apenas fazendo a pessoa se mover. Para trocar pelo seu produto: substitua I'm Lin pelo seu nome e present your product or record a lesson por uma frase sobre o que seu produto faz, por exemplo I can show you how our app plans your week in two minutes.
2. Narração vertical: recomendação de produto em vídeos curtos
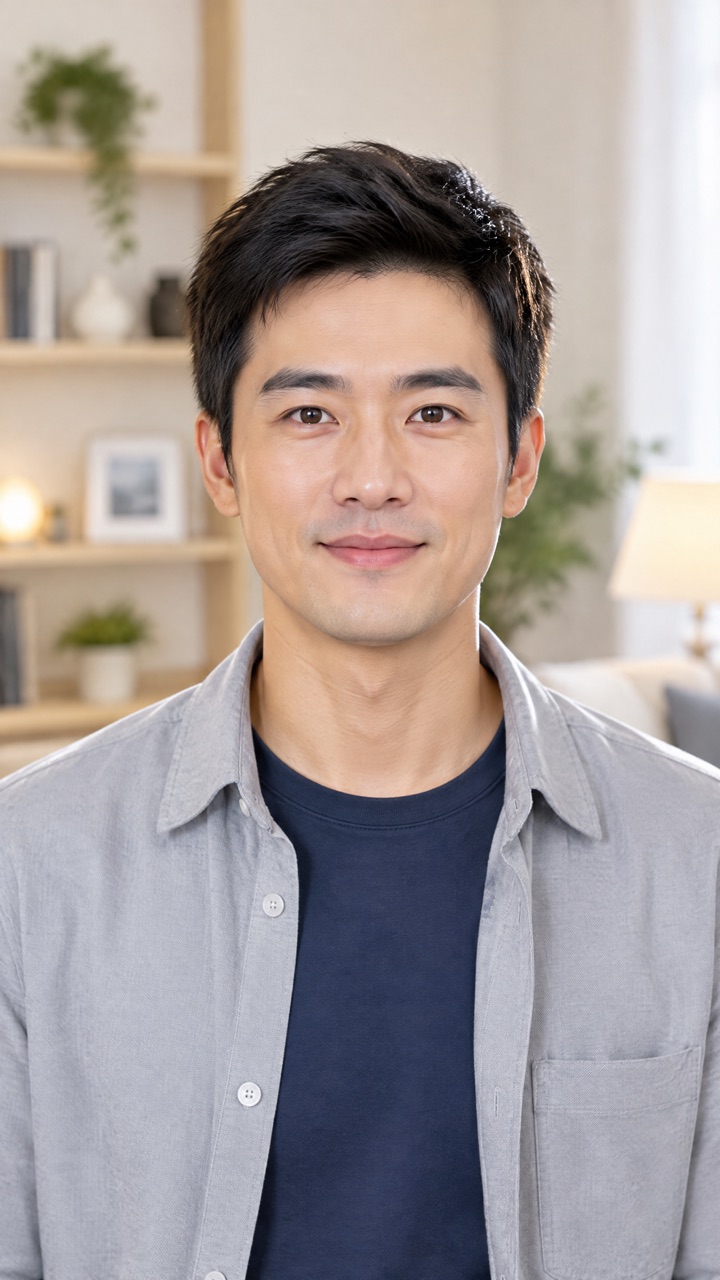
Ideal para narrações 9:16 no Douyin, Xiaohongshu e TikTok, falando em primeira pessoa sobre a experiência de uso e terminando com um convite para seguir.
Foto de entrada
Vídeo final
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.
Significado em chinês: uso estes fones novos há uma semana, o cancelamento de ruído é muito silencioso e a bateria dura o dia todo. Siga-me para ver mais.
Parâmetros: voz Andrew · 9:16 · 1080p · 8 segundos ($1.20)
Gerar com esta fala → O roteiro já está preenchido; basta enviar sua própria foto para gerar; escolha a voz Andrew e o formato 9:16.
A foto já é 9:16, então o vídeo final preenche a tela vertical, sem margens. Para narrações verticais, o mais prático é fotografar ou gerar uma foto vertical.
- Trocar de produto: mantenha a estrutura «há quanto tempo uso → dois pontos fortes → convite para seguir», por exemplo
I've been using this standing desk for a month. It rises in three seconds, and my back feels better. Follow me for more. - Produzir vários de uma vez: a mesma foto com roteiros de pontos fortes diferentes, rode vários de uma vez para um teste A/B.
3. Apresentação corporativa: falar dos dados trimestrais para a equipe
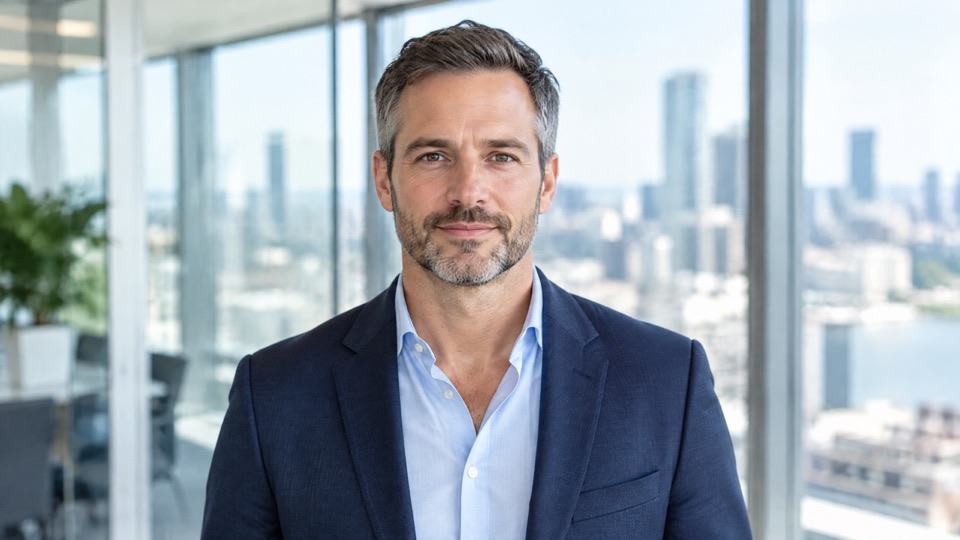
Ideal para treinamento interno, relatório semanal para clientes e abertura de vendas, com uma voz masculina firme e uma foto de meio corpo em escritório.
Foto de entrada
Vídeo final
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
Significado em chinês: sou o Daniel. Envie-me os números trimestrais e eu conduzo sua equipe para ver o que mudou e o que fazer a seguir.
Parâmetros: voz Dexter - Professional · 16:9 · 1080p · 8 segundos ($1.20)
Gerar com esta fala → O roteiro já está preenchido; basta enviar sua própria foto para gerar; escolha a voz Dexter - Professional e o formato 16:9.
Para o seu negócio: substitua quarterly numbers pelo seu entregável (your onboarding checklist, last week's support tickets) e escreva na segunda parte o que você fará com a equipe. Com uma foto real do responsável da empresa, você tem um vídeo de abertura pronto para enviar a clientes.
4. Lembrete de saúde quadrado: envio em comunidade de clínicas e farmácias
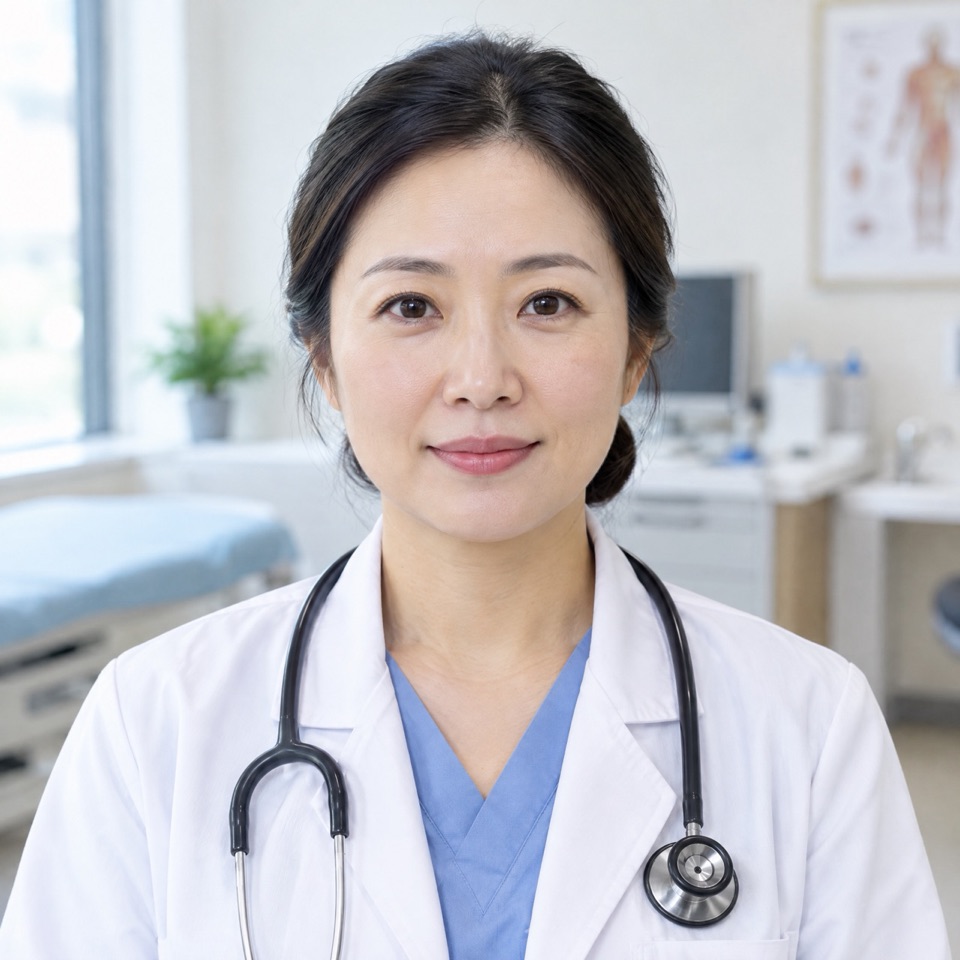
Ideal para vídeos curtos 1:1 no WeChat Moments, em comunidades e no WeChat Official Account, com uma imagem de médico e uma voz feminina suave.
Foto de entrada
Vídeo final
When the seasons change, mornings get chilly, so bring a jacket. If a cough lasts more than a week, please come see us at the clinic.
Significado em chinês: na mudança de estação, as manhãs ficam frias, então leve um casaco. Se a tosse durar mais de uma semana, venha ao consultório.
Parâmetros: voz Calm Chloe · 1:1 · 1080p · 8 segundos ($1.20)
Gerar com esta fala → O roteiro já está preenchido; basta enviar sua própria foto para gerar; escolha a voz Calm Chloe e o formato 1:1.
A foto e a saída são quadradas, e a imagem preenche o quadro exatamente. Para a sua instituição: escreva na primeira parte um lembrete de estação ou de situação e, na segunda, uma ação clara, por exemplo If your child has a fever for more than two days, book a visit with us.
5. Guiado por gravação: sua própria voz, seu próprio ritmo
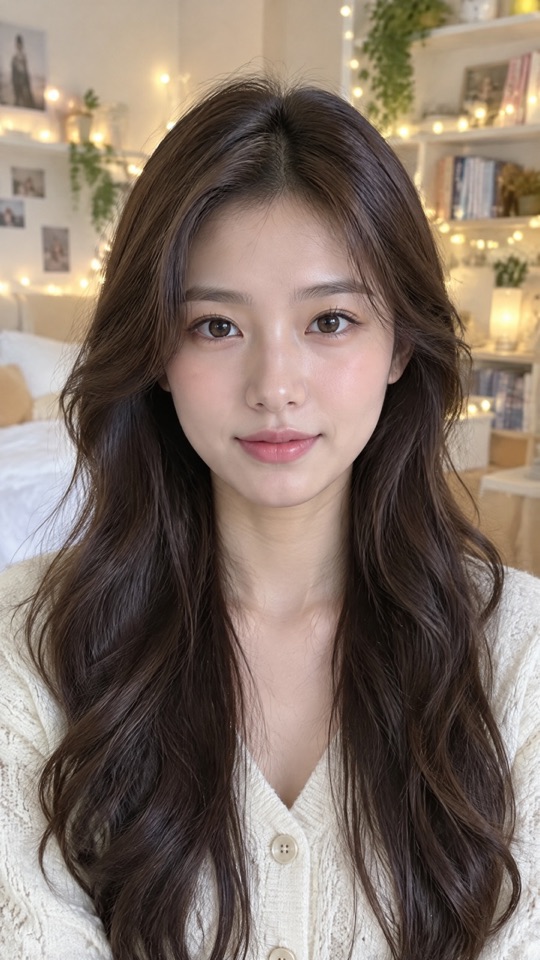
Quando você já tem uma narração ou trecho de podcast gravado, não precisa escrever roteiro: basta fazer a foto falar acompanhando a gravação.
Foto de entrada
Vídeo final
Parâmetros: upload de gravação em inglês · 9:16 · 1080p · 10 segundos ($1.50)
Enviar foto e gravação para gerar → Este cenário não tem roteiro: na página do modelo, basta enviar uma foto e uma gravação; o vídeo final tem a mesma duração da gravação, com máximo de 600 segundos.
A sincronia labial e as pausas acompanham a gravação, e o tom e o sotaque também vêm dela. Ideal para blogueiros e professores que querem manter a própria voz: grave primeiro uma narração de 10 a 30 segundos e use uma foto vertical sua. Ao usar gravação, não é preciso escolher voz.
6. Personagem 3D falando: mascote de marca, apresentador virtual
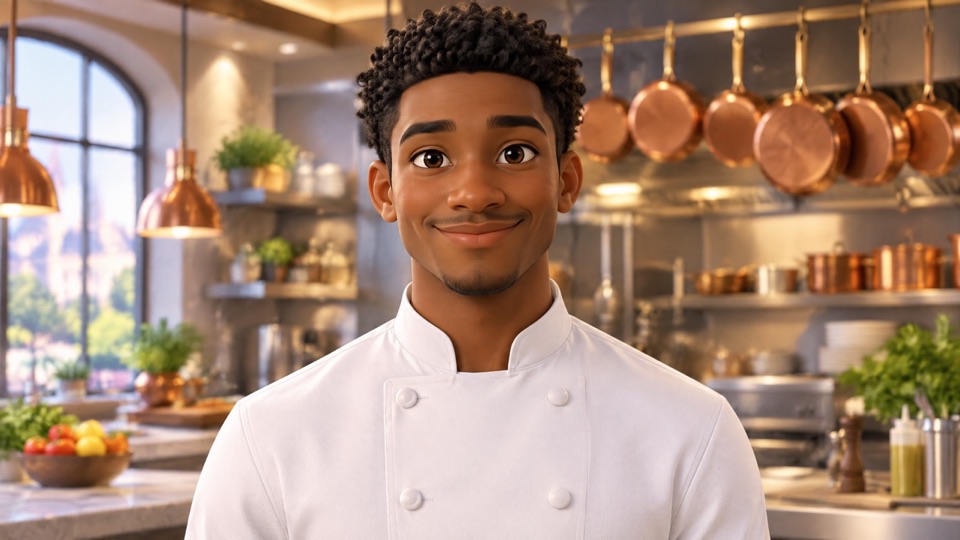
Ilustrações e personagens 3D também podem falar, desde que o rosto esteja nítido.
Foto de entrada
Vídeo final
Tonight's special is a slow-roasted tomato soup. It's simple, warm, and ready in twenty minutes. Let's cook!
Significado em chinês: o especial de hoje à noite é uma sopa de tomate assada lentamente, simples, quentinha e pronta em vinte minutos. Vamos cozinhar!
Parâmetros: voz Expressive Evan · 16:9 · 1080p · 8 segundos ($1.20)
Gerar com esta fala → O roteiro já está preenchido; basta enviar a imagem do seu próprio personagem para gerar; escolha a voz Expressive Evan e o formato 16:9.
- Trocar pelo seu mascote: envie uma imagem do rosto frontal do personagem e escreva o roteiro como «o que recomendar hoje → uma característica → um slogan».
- Fazer cardápio e atualizações diárias da loja: mude só
slow-roasted tomato soupetwenty minutesa cada dia, publicando com o mesmo personagem em sequência.
7. Foto horizontal em curso vertical: preencher as margens com uma imagem de fundo
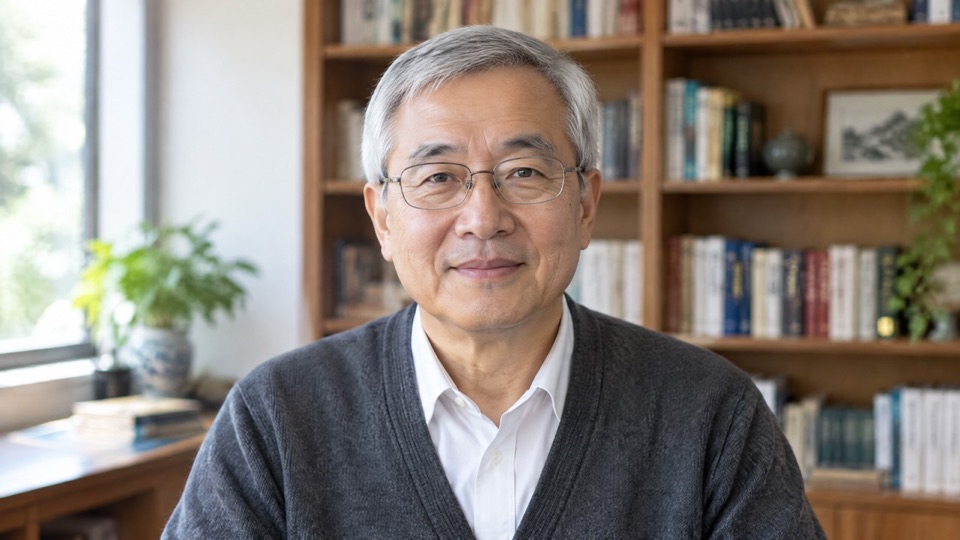
Se você só tem uma foto horizontal e precisa publicar na vertical, defina uma imagem como fundo: as margens superior e inferior serão preenchidas por ela.
Foto de entrada
Vídeo final
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
Significado em chinês: olá a todos, hoje vamos explicar o teorema de Pitágoras em cinco minutos: em um triângulo retângulo, a soma dos quadrados dos dois catetos é igual ao quadrado da hipotenusa.
Parâmetros: voz Professor Dean · 9:16 · 1080p · fundo: imagem (uma imagem de lousa) · 11 segundos ($1.65)
Gerar com esta fala → O roteiro já está preenchido; basta enviar sua própria foto para gerar; escolha a voz Professor Dean, o formato 9:16, selecione imagem como fundo e coloque uma imagem de lousa.
O fundo só tem efeito quando o formato de saída e a proporção da foto são diferentes; sem fundo definido, as margens ficam brancas. Também é possível preencher com uma cor da marca, por exemplo #1E3A5F. Para o seu curso: a primeira frase apresenta o tema e a duração, e a segunda dá direto a conclusão do conhecimento, por exemplo Today we'll learn three ways to say thank you in Japanese. The most polite one is arigatou gozaimasu.
Como escolher a foto
- Mais seguro: foto de uma só pessoa, rosto frontal, traços sem obstrução, iluminação uniforme e boca naturalmente fechada.
- Evite: perfil, máscara, foto em grupo, fotos em que o rosto é muito pequeno no quadro.
- Ilustrações e personagens 3D podem ser usados, desde que tenham um rosto nítido; imagens não humanas, como animais, podem não ser reconhecidas, e, em caso de falha, o valor é reembolsado integralmente.
- Mantenha o formato o mais próximo possível do vídeo final: para vertical, use foto vertical (casos 2 e 5); para quadrado, use foto quadrada (caso 4); quando as proporções forem diferentes, preencha as margens com imagem de fundo ou cor sólida (caso 7). Se escolher auto, a proporção da foto será mantida.
Como escrever o roteiro
- Frases curtas e coloquiais: cada frase fala de uma coisa só, como se estivesse falando para a câmera, não lendo um texto.
- Controlar o comprimento é controlar o custo: não é preciso definir a duração; ela é determinada pelo roteiro e pelo ritmo da fala, e o custo depende apenas dos segundos. Os 6 roteiros acima têm de 17 a 29 palavras em inglês, geram vídeos de 8 a 11 segundos, cerca de 2 a 3 palavras por segundo; para algo em torno de 10 segundos, escreva cerca de 25 palavras.
- Estrutura «quem é → uma frase de valor → uma ação»: os casos 1 e 3 começam dizendo o nome, o caso 2 termina com convite para seguir, o caso 4 termina com uma ação.
- Chinês também funciona: o roteiro aceita chinês e inglês, com até 5000 caracteres.
A resolução não afeta o preço: 720p e 1080p custam $0.15/segundo, então escolha direto 1080p.
Perguntas frequentes
Clicar em «Gerar com esta fala» preenche automaticamente? Sim. Ao abrir a página do modelo, o roteiro já está preenchido; envie sua foto, escolha a voz e o formato conforme o caso e clique em executar. Se não escolher voz, será usada a padrão Warm Pro Narrator.
Qual é a duração máxima do vídeo? Com roteiro, até 5000 caracteres, e a duração acompanha o roteiro; com gravação, a duração é a mesma da gravação, com máximo de 600 segundos.
Precisa de fundo transparente, legendas ou 4K? Escolha o HeyGen Avatar V: ele seleciona a imagem entre avatares digitais predefinidos e oferece fundo transparente, legendas SRT e 4K, pelo mesmo preço de $0.15/segundo, abra a página do modelo Avatar V. Para usar sua própria foto, use o Avatar IV.
Falhas na geração são cobradas? Não. A cobrança é feita pelos segundos reais do vídeo final, e tarefas com falha são reembolsadas integralmente.
Escolha o cenário mais parecido com o seu negócio, copie o roteiro dele, troque pelo nome do seu produto e envie sua foto e gere seu primeiro vídeo →
Links relacionados ao HeyGen Avatar IV
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores