
Guia de uso
Guia de introdução ao seedance-2.0-fast: capacidades de geração de vídeo, integração via API e controle de custos
Dos três modos de geração ao modelo de custo por segundo, uma checklist completa de decisão para desenvolvedores antes da integração
O que é o seedance-2.0-fast e para quem é indicado
O seedance-2.0-fast é um modelo de saída de vídeo lançado pela ByteDance, que oferece três modos de geração: text-to-video, image-to-video e reference-to-video. Entendido no contexto de engenharia, ele é um conversor de «material de entrada → trecho de vídeo»: você fornece texto, uma imagem de primeiro quadro ou material de referência, e ele gera um trecho de vídeo.
O perfil de equipe para o qual é indicado é bem específico: precisa produzir materiais de vídeo curto em lote, incorporar a geração de vídeo em produtos que já têm um fluxo de negócio claro (materiais de marketing, conteúdo em modelo, trechos curtos para redes sociais) e consegue lidar com o agendamento de tarefas assíncronas de longa duração. Em outras palavras, é para «equipes de engenharia montarem pipelines», não para o cenário de criadores que «geram uma única peça cinematográfica caprichada de uma vez».
Este artigo foca na decisão de integração: escolher o modo, organizar a requisição, calcular o custo, controlar o orçamento e solucionar erros. A tabela completa de parâmetros e a lista de capacidades do modelo em si não são repetidas aqui; os leitores que precisarem devem consultar a página de detalhes do modelo. O que realmente decide o sucesso do projeto, muitas vezes, não é se você lembra de todos os campos de parâmetros, mas se as três coisas — escolha de modelo, orçamento de duração e design de retentativas — foram pensadas com antecedência.
Como escolher os três modos de geração: text, image, reference
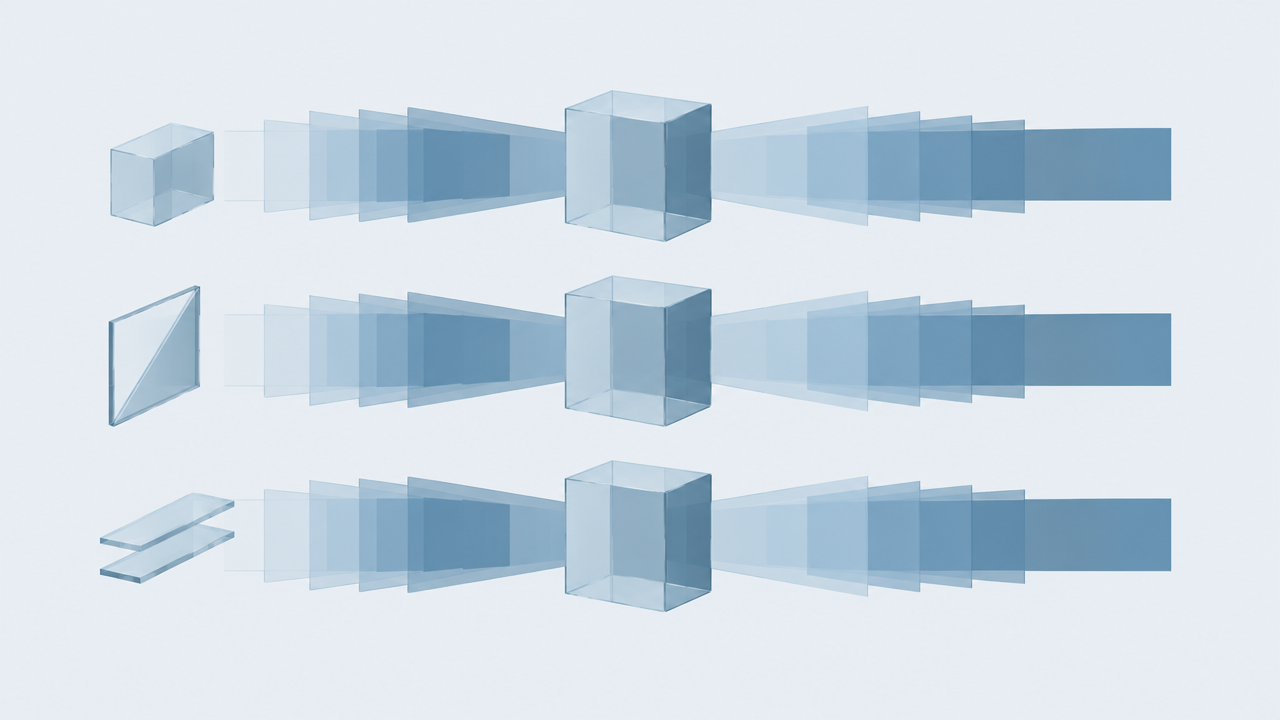
A diferença central entre os três modos está nas condições de entrada, não nas especificações de saída. Escolher o modo errado dobra diretamente o custo de retentativa, porque o vídeo é cobrado por segundos de saída.
text-to-video: use quando só tem a ideia
A entrada é apenas um prompt de texto. Indicado para explorar imagens do zero, gerar em lote materiais em modelo de estilo uniforme e cenários em que não há material filmado disponível. O custo é a menor controlabilidade: a diferença entre a descrição textual e a imagem final é a maior, geralmente exigindo várias rodadas de iteração para convergir, e cada rodada de iteração custa a duração de um vídeo.
image-to-video: use quando há um primeiro quadro definido
A entrada inclui uma imagem como ponto de partida do quadro. Indicado para cenários em que composição, sujeito ou tom visual já estão definidos e só é preciso «fazê-los se mover», como imagens de produto existentes, designs já prontos ou visuais de marca já estabelecidos. Como a base visual é travada pela imagem, é mais fácil acertar de primeira do que com texto puro, e o número de rodadas de iteração costuma ser menor.
reference-to-video: use quando há estilo ou material de referência
A entrada inclui material de referência, usado para restringir estilo, textura ou expressão visual. Indicado para cenários que exigem manter a consistência de uma série de materiais e estender uma linguagem visual a vários vídeos. É o mais sensível à qualidade do material de entrada — se o material de referência em si é confuso, a instabilidade da saída é amplificada, e a dificuldade de diagnóstico é a maior.
Regra prática de escolha
Primeiro pergunte-se «o que eu já tenho definido em mãos». Se só tem texto, descreva o que quer e siga o text-to-video; se tem uma base de imagem definida, siga o image-to-video; se tem um conjunto completo de materiais de estilo e exige que vários trechos sejam consistentes entre si, aí vale a pena usar o reference-to-video. Não use o text-to-video por padrão só porque tem a menor barreira — usá-lo quando há uma base de imagem equivale a abrir mão da controlabilidade de propósito, para depois comprá-la de volta com retentativas.
Pontos-chave da integração via API: como organizar a requisição
No nível de integração, a maior diferença entre modelos de vídeo e modelos de texto é: ele é um agendamento de recursos, não uma chamada de função. Organize as requisições com esse modelo mental e a maioria das armadilhas desaparece antecipadamente.
Organize os materiais de entrada antes de enviar
Os três modos têm formas de entrada diferentes; recomenda-se encapsular no lado do negócio com uma camada unificada de estrutura de parâmetros: identificador de modo, prompt de texto, imagem ou material de referência, duração alvo e especificações de saída. Modele explicitamente a «seleção de modo» como um campo, em vez de espalhá-la por ramos de código; assim, trocar de modo, fazer A/B e fazer degradação fica muito mais fácil depois. Normalize dimensões e formatos dos materiais antes do upload, sempre que possível, para não deixar problemas de compatibilidade para o tempo de execução.
Duração e especificações são parâmetros de custo
Duração e especificações de saída não são «opções de qualidade de imagem»; são parâmetros de cobrança. Na fase de construção da requisição, elas devem ser variáveis controladas — especialmente a duração: não deixe o código de negócio aceitar segundos arbitrários, mas sim vir de uma configuração revisada. Os nomes de campos e as faixas de valores devem seguir a página de detalhes do modelo; este artigo não repete os nomes específicos dos campos, para evitar divergências com a interface real.
Tarefas assíncronas devem ser projetadas desde o primeiro dia
A geração de vídeo leva muito mais tempo que texto; não presuma que uma requisição retornará dentro da janela de timeout do cliente. Abordagens viáveis:
- Após o envio, persista imediatamente o identificador da tarefa e todos os parâmetros de entrada, tratando «gerando» como um estado de primeira classe
- Avançar o estado por polling ou callback; usar backoff no intervalo de polling, sem alta frequência fixa
- Timeout do cliente não significa falha da tarefa; consulte o estado da tarefa antes de retentar, para evitar envio duplicado
- Registrar na tabela de tarefas também o modo, a duração e um resumo do material, para facilitar a atribuição posterior
O último item é frequentemente ignorado, mas é a única pista de localização quando o efeito regride no futuro.
Cobrança por segundo: convertendo US$ 0,1772/segundo em orçamento de projeto
O seedance-2.0-fast é cobrado por segundos de vídeo de saída, com valor oficial de US$ 0,1772/segundo. Essa base de cobrança tem três camadas de significado que vale a pena detalhar.
Primeira camada: custo por peça = preço unitário × duração de saída
O custo depende apenas dos segundos de saída, não de quantas requisições você enviou nem de quantas palavras escreveu no prompt. Portanto, «quanto custa um vídeo» pode ser calculado com antecedência: basta multiplicar o preço unitário pelos segundos que você pretende produzir. Isso também significa que a discussão de orçamento deve passar de «quantos vídeos vou gerar» para «quantos segundos vou gerar» — esta última é a verdadeira unidade de recurso.
Segunda camada: o orçamento mensal deve ser estimado por «tentativas», não por «peças finais»
Em projetos reais, a peça final é só a ponta do iceberg. Para um vídeo final, você pode ter gerado primeiro vários trechos curtos de teste, retentado algumas rodadas por causa de prompts insatisfatórios, e ainda ter trechos descartados por material inadequado. Tudo isso é cobrado por segundo. Na prática, um prompt ainda não convergido pode ter custo efetivo várias vezes maior que o custo da peça final. Ao fazer orçamento, estimar com um «multiplicador de tentativas» é muito mais confiável do que multiplicar diretamente o preço unitário pelo número de peças finais.
Terceira camada: retentativas e descartes são custos invisíveis
Dois pontos de vazamento concretos: envio duplicado por retentativa cega após timeout do cliente; e tarefas antigas que continuam rodando sem limpeza após alteração de parâmetros. O primeiro se resolve com «consultar o estado antes de retentar»; o segundo, com a tabela de tarefas contendo parâmetros e estados completos e limpeza periódica de tarefas zumbis. Resolver essas duas coisas costuma economizar mais do que qualquer técnica de prompt.
Preços em tempo real e regras de cobrança mais recentes devem ser consultados no painel de preços do site; este artigo discute apenas a lógica de conversão e não fixa números.
Melhores práticas de redução de custo: primeiro curto, depois longo; primeiro teste, depois execução
Transforme o controle de custos em processo, não em disciplina pessoal. A sequência abaixo pode ser aplicada diretamente.
1. Teste o prompt com duração curta
Valide primeiro a direção do prompt com a menor duração viável, confirme se composição, sujeito e ação atendem ao esperado, e só então estenda para a duração oficial. O trecho curto serve para eliminar «erros de direção», com custo baixíssimo; o trecho longo fica para a produção final de «direção já confirmada».
2. Valide com pequenas amostras antes de processar em lote
Não envie dezenas de tarefas de uma vez para depois observar o resultado. Rode primeiro um grupo pequeno (alguns poucos), verifique se a saída dos três modos cai na faixa esperada, confirme que não há erros sistemáticos em upload de material, seleção de especificações e configuração de duração, e só então libere o lote. Erros na fase de lote são os mais caros, porque são multiplicados pelo número de peças.
3. Faça cache e reutilize materiais já gerados
O mesmo material pode ser reutilizado em vários canais e versões. Armazene os resultados gerados junto com os parâmetros de entrada; na próxima vez que precisar de um trecho semelhante, priorize a busca de artefatos existentes em vez de gerar de novo. Especialmente eficaz para conteúdo em modelo: séries de materiais com visual estável podem reutilizar completamente o mesmo lote de trechos de base.
4. Invista duração de acordo com o valor de negócio
Não todo vídeo merece duração longa. Classifique os cenários de negócio: classe A (material central de conversão) usa duração longa e múltiplas rodadas de iteração; classe B (conteúdo auxiliar) usa duração curta e aprovação em uma passada; classe C (exploração experimental) fica estritamente limitada à duração mínima. Após a classificação, o orçamento é naturalmente alocado onde deve ser gasto.
O ponto comum desses quatro passos é colocar a «confirmação» antes do «gasto». A estrutura de custos da geração de vídeo determina: economizar não é gerar menos, mas gerar menos coisas erradas.
Perguntas frequentes e abordagem de diagnóstico
Timeout de tarefa e estratégia de polling
O erro de julgamento mais comum é tratar «o cliente não recebeu a resposta» como «a tarefa falhou». A abordagem correta é: persistir no envio, consultar o estado pelo identificador da tarefa após o timeout, e só permitir reenvio quando o estado confirmar falha. Use backoff no intervalo de polling para evitar que consultas de alta frequência derrubem seu próprio serviço. Callback e polling podem coexistir, mas é obrigatório tratar idempotência para impedir que a mesma tarefa seja consumida duas vezes.
Instabilidade da saída causada pela qualidade do material de entrada
image-to-video e reference-to-video são altamente sensíveis à qualidade da entrada. Imagem desfocada, sujeito com proporção pequena demais, estilo do material de referência confuso — tudo isso se manifesta como «saída aleatória». Nesse caso, não altere o prompt primeiro; troque o material e faça um experimento de controle: mesmo prompt, materiais diferentes; se o resultado for muito diferente, o problema está no material.
Ordem de diagnóstico quando o efeito não atende ao esperado
Recomenda-se fixar uma ordem para evitar tentativa e erro cegos que queimam duração:
- O modo está correto? — usar text-to-video quando há base de imagem é o erro de escolha mais comum
- O material de entrada é adequado? — confirme rapidamente com experimento de controle
- O prompt descreve a imagem ou descreve a intenção? — modelos de vídeo costumam responder de forma mais estável a descrições visuais concretas
- Duração e especificações correspondem ao cenário? — duração curta não comporta ações complexas; duração longa amplifica defeitos do prompt
- Houve regressão de efeito? — compare parâmetros de entrada e artefatos no histórico para determinar se é flutuação do modelo ou sua alteração
O quinto passo depende daquilo que foi enfatizado repetidamente antes: armazenar os resultados gerados junto com os parâmetros. Sem esse registro, o diagnóstico só depende de memória e suposição.
Quando usar e quando não usar
Indicado
Cenários de engenharia que precisam de iteração rápida e produção em lote de materiais de vídeo curto: trechos curtos para marketing e redes sociais, produção de conteúdo em modelo, e situações em que imagens ou bases de estilo existentes precisam «se mover». Esses três modos cobrem o intervalo contínuo de «só tenho a ideia» a «já tenho base visual», e, com o modelo de custo por segundo, o custo de tentativa e erro pode ser bastante controlável.
Não indicado
Cenários que exigem controle preciso extremo da imagem — por exemplo, storyboards alinhados quadro a quadro, tarefas que devem reproduzir estritamente uma imagem especificada; a aleatoriedade do vídeo generativo faz o custo de retrabalho sair de controle. Conteúdo que exige duração extremamente longa também não é adequado: a cobrança por segundo somada à degradação da estabilidade da saída faz a relação custo-benefício cair rapidamente.
Julgamento final
Trate o seedance-2.0-fast como uma peça substituível no pipeline, não como a única resposta. Antes da integração, confirme três coisas: a escolha de modo tem fundamento, o orçamento de duração está quantificado, e a tarefa assíncrona e a persistência de resultados estão projetadas. Feito isso, consulte a página de detalhes do modelo para verificar parâmetros específicos e preços em tempo real; isso é muito mais seguro do que copiar campos diretamente da tabela de parâmetros. Modelos de vídeo iteram rápido; manter o hábito de comparação lateral é mais vantajoso do que se prender a um único modelo.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores