
Guida all'uso
Guida introduttiva a seedance-2.0-fast: capacità di generazione video, integrazione API e controllo dei costi
Dalle tre modalità di generazione al modello di costo a consumo per secondo: la checklist decisionale completa per gli sviluppatori prima dell'integrazione
Che cos'è seedance-2.0-fast e a chi è destinato
seedance-2.0-fast è un modello di output video presentato da ByteDance, che offre tre modalità di generazione: text-to-video, image-to-video e reference-to-video. In un contesto ingegneristico, va inteso come un convertitore «materiale in input → frammento video»: fornisci testo, un'immagine di primo frame, materiale di riferimento, e ottieni in uscita un video.
Il profilo dei team adatti è molto specifico: serve produrre materiali video brevi in batch, incorporare la generazione video in prodotti che hanno già un flusso di business definito (materiali di marketing, contenuti templatizzati, frammenti brevi per i social), e accettare l'orchestrazione di attività asincrone e a lunga durata. In altre parole, è pensato per «team di ingegneria che costruiscono pipeline», non per il contesto creativo di «una singola opera rifinita generata alla volta».
Questo articolo si concentra sulle decisioni di integrazione: scelta della modalità, organizzazione delle richieste, calcolo dei costi, controllo del budget, risoluzione dei problemi. La tabella completa dei parametri e l'elenco delle capacità del modello non vengono ripetuti qui: chi ne ha bisogno faccia riferimento alla pagina di dettaglio del modello. Ciò che determina davvero il successo o il fallimento di un progetto raramente è la completezza con cui si memorizzano i campi dei parametri, ma se si sono ragionate in anticipo su tre cose: la scelta del modello, il budget di durata e la progettazione dei retry.
Come scegliere tra le tre modalità di generazione: text, image, reference
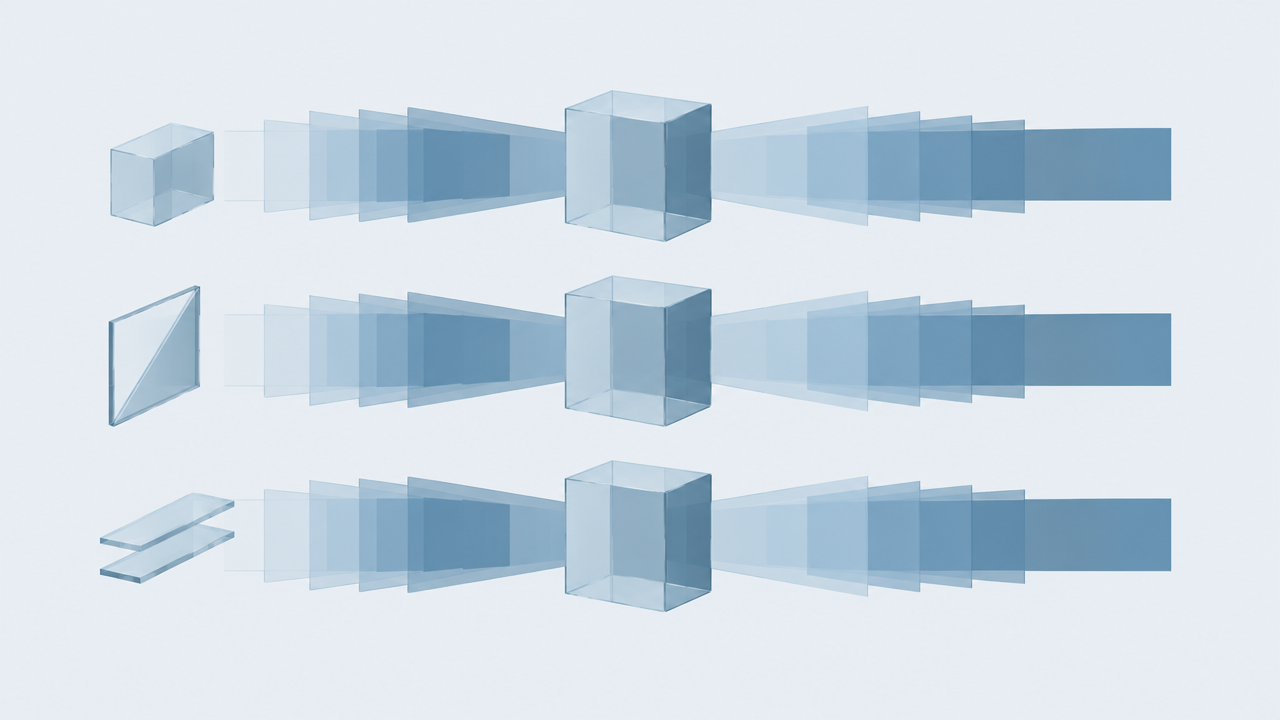
La differenza fondamentale tra le tre modalità sta nelle condizioni di input, non nelle specifiche di output. Scegliere la modalità sbagliata raddoppia direttamente il costo dei retry, perché i video vengono fatturati in base ai secondi di output.
text-to-video: da usare quando si ha solo un'idea
L'input è un prompt puramente testuale. È adatto all'esplorazione visiva da zero, alla generazione in batch di materiali templatizzati con uno stile uniforme e a scenari in cui non si dispone di materiale girato. Il prezzo da pagare è la controllabilità più bassa: lo scarto tra la descrizione testuale e l'immagine finale è massimo, e spesso servono più iterazioni per convergere, mentre ogni iterazione costa la durata di un video.
image-to-video: da usare quando si ha un primo frame definito
L'input include un'immagine come punto di partenza visivo. È adatto a scenari in cui composizione, soggetto o tono visivo sono già definiti e serve solo «farli muovere», ad esempio con immagini di prodotto già disponibili, bozze di design esistenti o visual di brand già consolidati. Poiché il riferimento visivo è ancorato dall'immagine, è più facile centrare il risultato al primo colpo rispetto al testo puro, e in genere le iterazioni sono meno numerose.
reference-to-video: da usare quando si hanno stile o materiali di riferimento
L'input include materiale di riferimento, usato per vincolare stile, texture o espressione visiva. È adatto a scenari in cui serve mantenere la coerenza di una serie di materiali o prolungare un certo linguaggio visivo su più video. È il più sensibile alla qualità dei materiali di input: se il materiale di riferimento è esso stesso disordinato, l'instabilità dell'output viene amplificata e la diagnosi diventa più difficile.
Regola mnemonica per la scelta
Chiediti innanzitutto «che cosa ho già di certo in mano». Se hai solo testo, descrivi chiaramente ciò che vuoi e usa text-to-video; se hai un riferimento visivo definito, usa image-to-video; solo se disponi di un set completo di materiali di stile e richiedi che più frammenti siano coerenti tra loro vale la pena usare reference-to-video. Non usare text-to-video solo perché è la soglia più bassa: usarlo quando hai un riferimento visivo significa rinunciare attivamente alla controllabilità e ricomprarla con i retry.
Punti chiave dell'integrazione API: come organizzare le richieste
A livello di integrazione, la differenza più grande tra un modello video e un modello testuale è questa: è un'operazione di orchestrazione di risorse, non una semplice chiamata di funzione. Organizzando le richieste con questo modello mentale, la maggior parte delle insidie scompare in anticipo.
Prima riorganizza i materiali di input, poi inviali
Le forme di input delle tre modalità sono diverse; si consiglia di incapsulare prima, lato business, una struttura di parametri di input unificata: identificatore della modalità, prompt testuale, immagine o materiale di riferimento, durata target e specifiche di output. Modellare esplicitamente la «scelta della modalità» come un campo anziché sparpagliarla nei rami del codice renderà molto più semplice cambiare modalità, fare A/B test o implementare fallback. Per quanto riguarda i materiali, cerca di normalizzare dimensioni e formato prima del caricamento, per non lasciare i problemi di compatibilità al runtime.
Durata e specifiche sono parametri di costo
Durata e specifiche di output non sono «opzioni di qualità», ma parametri di fatturazione. Già in fase di costruzione della richiesta vanno rese variabili controllate: in particolare la durata, che nel codice di business non deve mai arrivare come numero di secondi arbitrario, ma provenire da una configurazione approvata. Per i nomi dei campi e gli intervalli di valori fare riferimento alla pagina di dettaglio del modello; in questo articolo non si ripetono i nomi specifici dei campi, per evitare divergenze rispetto all'interfaccia reale.
Le attività asincrone vanno progettate fin dal primo giorno
La generazione video richiede molto più tempo di quella testuale: non dare per scontato che una richiesta rientri nella finestra di timeout del client. Approcci praticabili:
- Subito dopo l'invio, persistere l'identificatore dell'attività e i parametri completi, trattando «in generazione» come stato di prima classe
- Far avanzare lo stato tramite polling o callback, con intervalli di polling in backoff, evitando frequenze fisse elevate
- Il timeout del client non equivale a un fallimento dell'attività: prima di riprovare, interrogare lo stato dell'attività per evitare invii duplicati
- Registrare nella tabella delle attività anche modalità, durata e riepilogo dei materiali, per facilitare l'analisi successiva delle cause
L'ultimo punto è spesso trascurato, ma è l'unica traccia per individuare la causa quando, in futuro, la qualità peggiora.
Fatturazione al secondo: convertire $0.1772/secondo in budget di progetto
seedance-2.0-fast fattura in base ai secondi di video in output, con tariffa ufficiale di $0.1772/secondo. Questa modalità di fatturazione ha tre implicazioni che vale la pena approfondire.
Primo livello: costo singolo = prezzo unitario × durata di output
Il costo dipende solo dai secondi di output, non da quante richieste hai inviato né da quanti caratteri hai scritto nel prompt. Quindi «quanto costa un video» è calcolabile in anticipo: basta moltiplicare il prezzo unitario per i secondi che intendi produrre. Ciò implica anche che la discussione sul budget dovrebbe spostarsi da «quanti video voglio generare» a «quanti secondi voglio generare»: quest'ultima è la vera unità di risorsa.
Secondo livello: il budget mensile va stimato sulle «tentativi», non sui «prodotti finiti»
Nei progetti reali, il prodotto finito è solo la punta dell'iceberg. Per un video finito potresti aver prima prodotto diversi brevi campioni, aver ritentato più volte perché il prompt non era soddisfacente, e aver scartato frammenti per materiali non idonei. Tutto questo viene fatturato al secondo. Per esperienza, un prompt non ancora convergente può avere un costo effettivo pari a più volte il costo del prodotto finito. In fase di budget, stimare con un «fattore di tentativi» è molto più affidabile che moltiplicare direttamente il prezzo unitario per il numero di prodotti finiti.
Terzo livello: retry e scarti sono costi nascosti
Due falle concrete: gli invii duplicati causati da retry ciechi dopo un timeout del client; e le vecchie attività non ripulite che continuano a girare dopo modifiche ai parametri. La prima si risolve con «interrogare lo stato prima di riprovare», la seconda con una tabella delle attività che includa parametri e stato completi e con una pulizia periodica delle attività zombie. Risolvere queste due cose spesso fa risparmiare più di qualsiasi trucco sui prompt.
Per i prezzi in tempo reale e le regole di fatturazione più recenti fa fede il pannello prezzi del sito; questo articolo discute solo la logica di conversione e non fissa i numeri.
Best practice per la riduzione dei costi: prima brevi poi lunghi, prima provare poi eseguire
Trasforma il controllo dei costi in un processo, non affidarti alla buona volontà. La sequenza seguente è direttamente applicabile.
Uno: testare i prompt con durate brevi
Verifica prima la direzione del prompt con la durata minima praticabile, conferma che composizione, soggetto e azione siano come previsto, poi estendi alla durata definitiva. I frammenti brevi servono a escludere «errori di direzione», con costi bassissimi; i frammenti lunghi sono riservati alla produzione finale di direzioni già confermate.
Due: validare con un piccolo campione prima del batch
Non inviare decine di attività tutte insieme per poi osservare i risultati. Esegui prima un piccolo gruppo (bastano poche unità), verifica che l'output delle tre modalità rientri nell'intervallo atteso, conferma che caricamento dei materiali, scelta delle specifiche e configurazione della durata non presentino errori sistematici, poi apri al batch. Gli errori in fase di batch sono i più costosi, perché vengono moltiplicati per il numero di elementi.
Tre: cache e riuso dei materiali già generati
Lo stesso materiale può essere riutilizzato su più canali e in più versioni. Salva i risultati di generazione insieme ai parametri di input: quando la volta successiva ti servirà un frammento simile, cerca prima tra i prodotti esistenti invece di rigenerare. Particolarmente efficace per i contenuti templatizzati: le serie di materiali visivamente stabili possono riutilizzare tranquillamente lo stesso lotto di frammenti di base.
Quattro: graduare la durata in base al valore di business
Non tutti i video meritano durate lunghe. Classifica gli scenari di business: categoria A (materiali di conversione principali) con durate lunghe e più iterazioni; categoria B (contenuti ausiliari) con durate brevi e superamento al primo colpo; categoria C (esplorazione sperimentale) rigorosamente limitata alla durata minima. Dopo la classificazione, il budget si distribuisce naturalmente dove deve essere speso.
Il punto comune di questi quattro passi è mettere la «conferma» prima della «spesa». La struttura dei costi della generazione video stabilisce che risparmiare non significa generare meno, ma generare meno cose sbagliate.
Domande frequenti e approccio alla risoluzione dei problemi
Timeout delle attività e strategia di polling
L'errore di valutazione più comune è considerare «il client non ha ricevuto risposta» come «attività fallita». L'approccio corretto è: persistere subito all'invio, interrogare lo stato tramite l'identificatore dell'attività dopo il timeout, e consentire un nuovo invio solo dopo la conferma del fallimento. Gli intervalli di polling devono adottare una strategia di backoff, per evitare che interrogazioni ad alta frequenza sovraccarichino i propri servizi. Callback e polling possono coesistere, ma è necessario garantire l'idempotenza, per evitare che la stessa attività venga consumata due volte.
Instabilità dell'output causata dalla qualità dei materiali di input
image-to-video e reference-to-video sono altamente sensibili alla qualità dell'input. Immagini sfocate, soggetto troppo piccolo rispetto all'inquadratura, stili dei materiali di riferimento confusi: tutto ciò si manifesta come «output casuale». In questo caso non modificare subito il prompt: prova prima a cambiare materiale in un esperimento di controllo. Con lo stesso prompt e materiali diversi, se i risultati differiscono molto, il problema è nei materiali.
Ordine di indagine quando il risultato non è all'altezza delle aspettative
Si consiglia di fissare un ordine, per evitare tentativi ciechi che bruciano durata:
- La modalità è quella giusta? — usare text-to-video pur avendo un riferimento visivo è l'errore di selezione più comune
- I materiali di input sono idonei? — confermalo rapidamente con un esperimento di controllo
- Il prompt descrive l'immagine o descrive l'intenzione? — i modelli video reagiscono in genere in modo più stabile alle descrizioni visive concrete
- Durata e specifiche sono adatte allo scenario? — una durata breve non contiene azioni complesse, una durata lunga amplifica i difetti del prompt
- Si è verificato un peggioramento della qualità? — confronta parametri e prodotti nella cronologia, per capire se si tratta di fluttuazioni del modello o di modifiche tue
Il quinto passo dipende da ciò che è stato ribadito più volte in precedenza: salvare insieme risultati di generazione e parametri. Senza questa registrazione, la diagnosi può basarsi solo su memoria e congetture.
Quando usarlo e quando no
Adatto
Scenari ingegneristici che richiedono iterazione rapida e produzione in batch di materiali video brevi: frammenti brevi per marketing e social, produzione di contenuti templatizzati, casi in cui immagini o riferimenti di stile esistenti devono «muoversi». Queste tre modalità coprono l'intervallo continuo da «ho solo un'idea» a «ho già un riferimento visivo» e, con un modello di costo a consumo per secondo, il costo dei tentativi può essere tenuto sotto controllo in modo piuttosto efficace.
Non adatto
Scenari che richiedono un controllo molto preciso dell'immagine, come storyboard allineati frame per frame o attività che devono riprodurre rigorosamente una determinata inquadratura: la casualità del video generativo fa perdere il controllo sui costi di rilavorazione. Anche i contenuti che richiedono durate molto lunghe non sono adatti: la fatturazione al secondo combinata con il degrado della stabilità di output fa scendere rapidamente il rapporto qualità-prezzo.
Giudizio conclusivo
Considera seedance-2.0-fast un anello sostituibile nella pipeline, non l'unica risposta. Prima dell'integrazione conferma tre cose: la scelta della modalità ha una motivazione, il budget di durata è quantificato, le attività asincrone e la persistenza dei risultati sono progettate. Fatto questo, verificare i parametri specifici e i prezzi in tempo reale sulla pagina di dettaglio del modello sarà molto più sicuro che copiare i campi direttamente dalla tabella dei parametri. I modelli video si evolvono rapidamente: mantenere l'abitudine al confronto trasversale è più conveniente che bloccarsi su un singolo modello.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori