
Kuaishou
Kling 3.0
kling-3.0/motion-control
Série unificada de geração de vídeo multimodal, com suporte a texto para vídeo, imagem para vídeo, referência para vídeo e edição dentro do vídeo, sincronização labial nativa e áudio multilíngue
Experimentar kling-3.0/motion-control
Entrada
Criações
Ver todas as criaçõesSaída
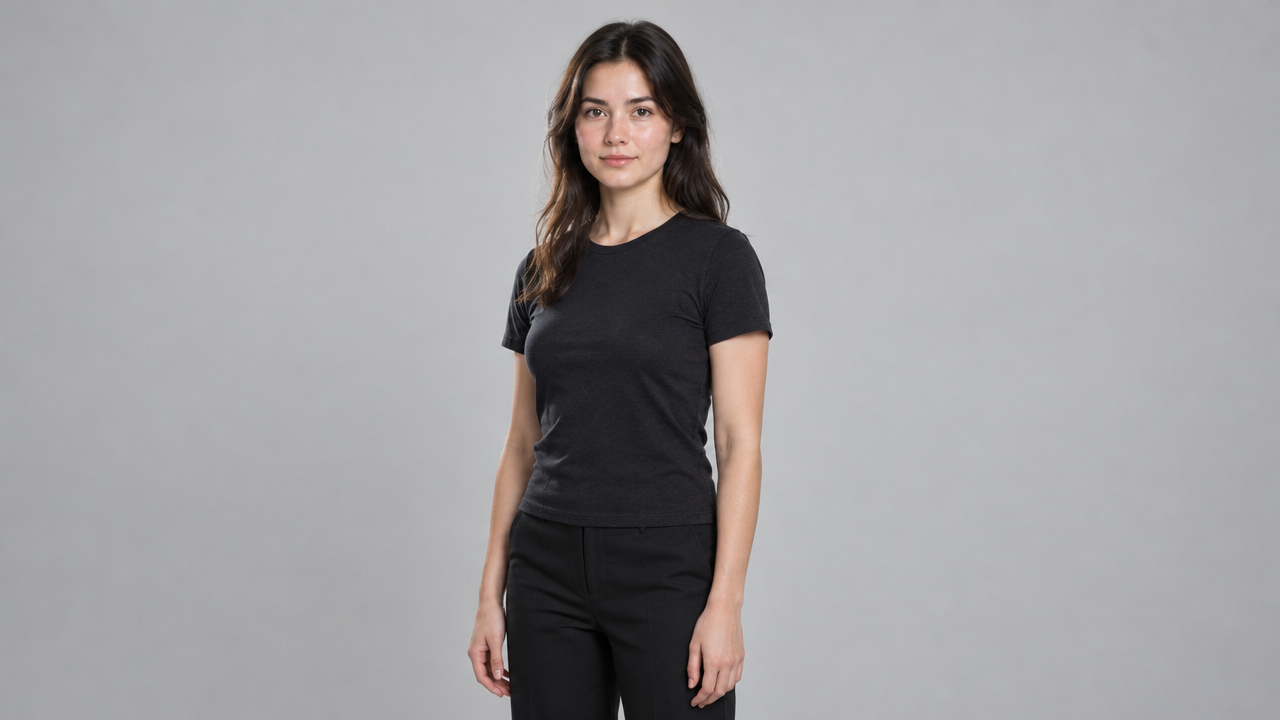
Do texto à imagem: conceito de storyboard com controle de movimento do Kling 3.0
Estilo Storyboard · Transferência de movimento · Consistência de Personagem
Entradas de referência
image_url
video_url
Prompt
Conceito de controle de movimento em nível de direção de storyboard: uma referência de personagem com enquadramento claro impulsiona a consistência de identidade, e um único trecho de referência contínuo impulsiona a pose, os gestos e o ritmo temporal. O prompt descreve uma transição neutra do estúdio para a rua, com luz principal direcional suave acompanhada de uma luz de contorno delicada, textura de pele natural, aparência de lente 35mm, leve sensação de respiração de câmera na mão, sujeito centralizado em plano médio, com cabeça, ombros e tronco visíveis durante todo o tempo. Mantenha o movimento fisicamente plausível e claramente legível, preserve a consistência do figurino e da identidade facial ao longo de todo o trecho, com gradação de cor contida, sombras frias e realces quentes, sem cortes e sem artefatos de estilização.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
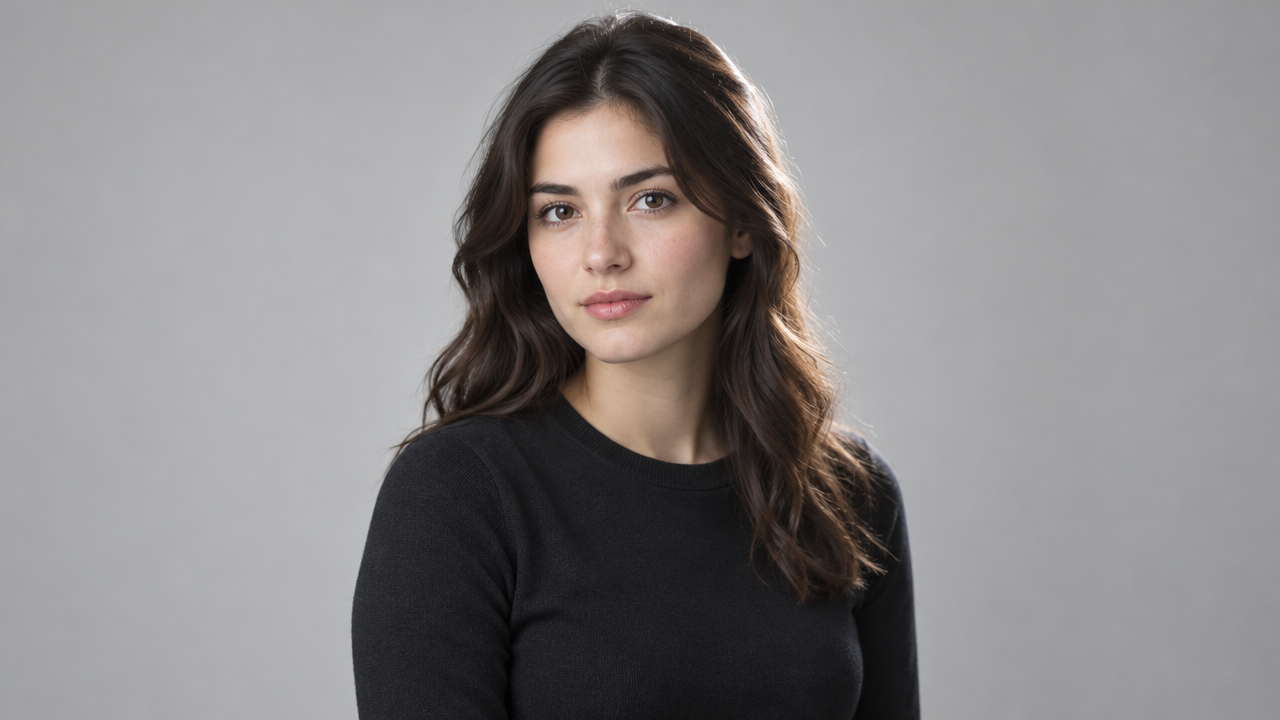
Notas visuais da linguagem de movimento de câmera: reproduzindo cinco movimentos básicos de câmera com motion-control
Estilo Movimento de câmera · Storyboard · Vídeo de referência
Entradas de referência
image_url
video_url
Prompt
Um plano médio contínuo, filmando uma personagem enquadrada da cabeça aos ombros, com fundo de estúdio neutro, para estudo de movimento de câmera: a câmera se aproxima lenta e suavemente de um plano médio até um close-up, mantendo a personagem centralizada e o horizonte nivelado. Luz principal direcional suave vinda da esquerda da câmera, complementada por um leve preenchimento, criando uma separação delicada de contorno, profundidade de campo rasa, color grading cinematográfico, contraste contido. Movimento mecânico suave, sem cortes, sem tremores de mão, identidade da personagem consistente durante todo o plano.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
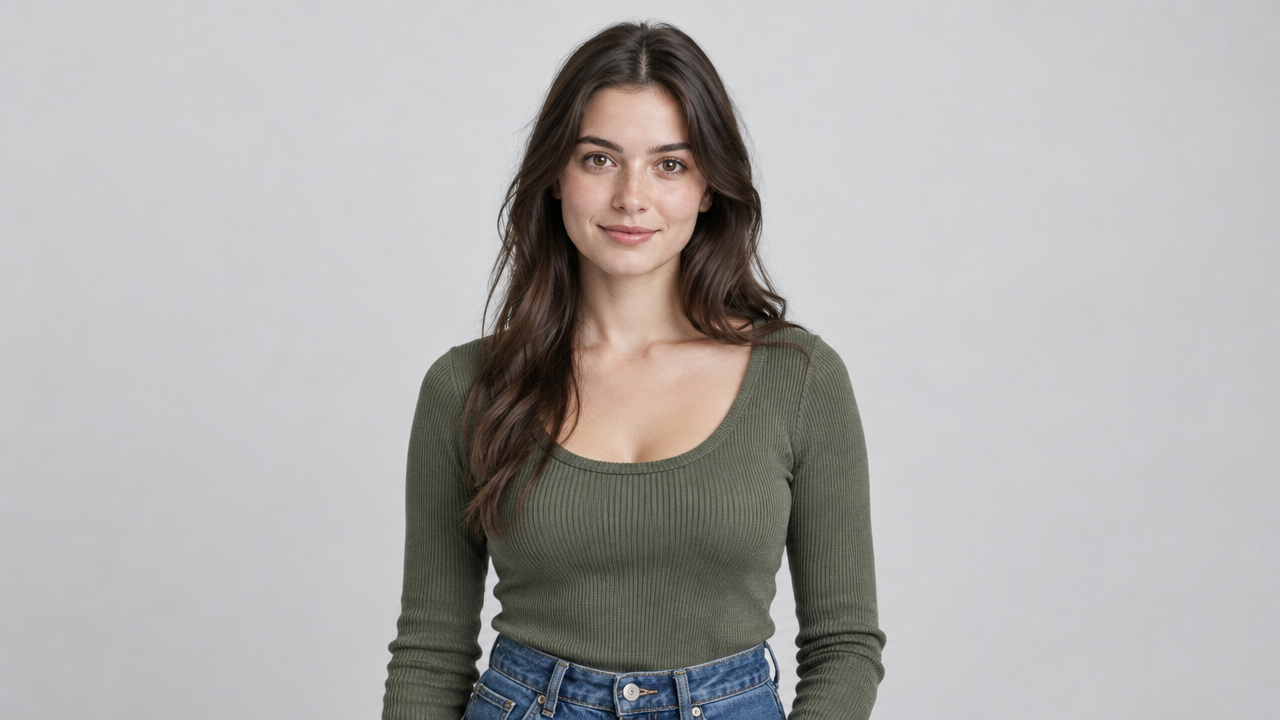
Cartão de fórmula de prompt do Kling 3.0 Motion Control: demonstração de escrita estruturada de câmera
Estilo Transferência de movimento · Engenharia de Prompt · Storyboard
Entradas de referência
image_url
video_url
Prompt
Plano médio do personagem da imagem de referência, em pé em um estúdio fotográfico moderno de luz suave, tendo como fonte principal uma grande janela de luz difusa e uma tênue luz de contorno fria vinda por trás. Garanta sempre que a cabeça, os ombros e o tronco do sujeito estejam completamente visíveis e centralizados no enquadramento, com espaço negativo limpo no topo da imagem. Color grading cinematográfico, profundidade de campo rasa, textura de pele natural, grain de filme sutil, lente equivalente a 35mm. Câmera fixa, com movimento de aproximação extremamente lento; postura, expressão e ritmo seguem integralmente o vídeo de referência, sem descrever nenhum movimento adicional no prompt.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Kling 3.0 Motion Control: parâmetros e capacidades de cenário ilustrados
Estilo Transferência de movimento · Consistência de Personagem · Detalhamento de capacidades
Entradas de referência
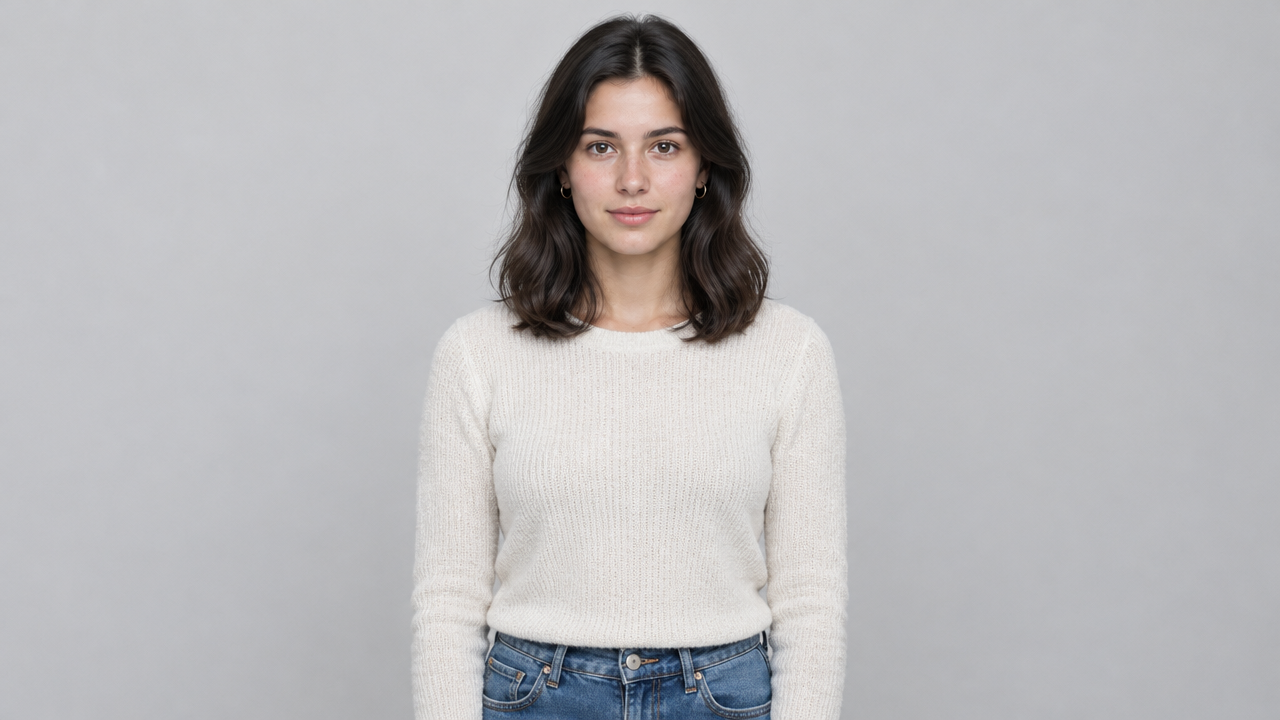
image_url
video_url
Prompt
Transferência de movimento de personagem: um plano médio contínuo, uma jovem de cabelos escuros na altura dos ombros vestindo uma blusa de tricô clara, em pé em um estúdio fotográfico claro e minimalista, com luz suave de janela vindo da esquerda. Ela executa uma sequência de movimentos natural e relaxada — vira-se levemente para a câmera, ajeita o cabelo atrás de uma orelha e então acena suavemente com a cabeça, exibindo um sorriso gentil. A câmera permanece basicamente fixa, com uma sutil sensação de respiração de câmera na mão, enquadrando cabeça, ombros e tronco durante todo o tempo. Pele e tecido mantêm texturas realistas, profundidade de campo rasa, fundo em tons frios neutros, ritmo de movimento natural, com sensação de peso e movimento de cabeça verossímeis, sem cortes, sem tratamento estilizado.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
kling-3.0/motion-control per second
| Especificações | Preço unitário |
|---|---|
| 720P | $0.100 |
| 1080P | $0.172 |
Visão geral do posicionamento
kling-3.0/motion-control é uma linha de geração de vídeo por condução de movimento: recebe uma imagem de referência de personagem e um vídeo de referência com movimento, e gera um novo vídeo coreografado a partir desse movimento. A aparência do personagem vem da imagem, o movimento e as expressões vêm do vídeo, e o prompt opcional serve para complementar cenário, estilo e enquadramento. É indicado para desenvolvedores que precisam transferir a atuação de uma pessoa real para um personagem específico, como em dramaturgia curta, apresentação falada e vitrines de e-commerce que exigem reutilizar o mesmo material de movimento.
Destaques principais
- Entrada desacoplada de personagem e movimento — a aparência do personagem é determinada pela imagem de referência e o ritmo do movimento pelo vídeo de referência, permitindo aplicar a mesma atuação a materiais de personagens diferentes.
- Duração de saída adaptável ao modo de orientação do personagem — ao seguir o vídeo, a orientação do personagem pode gerar até 30 segundos; ao seguir a imagem, até 10 segundos, selecionável conforme o tipo de cena.
- Suporte à preservação do áudio original do vídeo de referência — por padrão, a trilha sonora do vídeo de referência é mantida, com movimento e som sincronizados, eliminando a etapa de sincronização separada.
Descrição das capacidades
Transferência de movimento com duas fontes de material: é obrigatório fornecer a imagem do personagem e o vídeo de movimento; a imagem define a fisionomia do personagem e o vídeo define movimento e expressões, e o resultado gerado herda ambos.
Alternância do modo de orientação do personagem: character_orientation pode ser video ou image; o primeiro é adequado para movimentos complexos, com limite de 30 segundos; o segundo é adequado para movimentos de câmera, com limite de 10 segundos.
Prompt para complementar cenário e enquadramento: o prompt opcional tem até 2500 caracteres e serve para complementar cenário, estilo e direção de câmera, sem alterar o movimento e as expressões determinados pelo vídeo de referência.
Resolução selecionável e preservação de trilha sonora: a saída pode ser em 720p ou 1080p, com opção de preservar ou não o áudio original do vídeo de referência; resoluções mais altas correspondem a cobrança maior.
Cenários de aplicação
- Criadores de dramaturgia curta e apresentação falada reutilizando material de movimento — envie uma foto da imagem do personagem e um vídeo de atuação para obter um vídeo finalizado com o mesmo movimento desse personagem, útil para produção de conteúdo em série.
- E-commerce e marcas fazendo demonstração de produtos com personagens — combine a imagem de uma modelo ou avatar virtual com um vídeo de movimento de demonstração do produto para produzir um curta de apresentação do personagem, usado em páginas de detalhes e anúncios.
- Conteúdo de movimento que precisa preservar o áudio original — ao ativar a preservação do áudio original, a saída já traz a trilha sonora sincronizada, pronta para publicar vídeos curtos em redes sociais.
Limitações e recomendações de seleção
Os dois materiais de entrada têm requisitos rígidos: a imagem do personagem deve mostrar claramente cabeça, ombros e tronco, com proporção entre 2:5 e 5:2 e no máximo 10 MB; o vídeo de referência deve ter de 3 a 30 segundos, ser contínuo em um único enquadramento e ter o sujeito visível, com no máximo 100 MB. O movimento e as expressões são determinados pelo vídeo de referência, e o prompt só pode ajustar cenário e estilo, sem reescrever o movimento em si. Caso seja necessário gerar apenas a partir de texto ou a partir de imagem, deve-se escolher outra linha da mesma série; conteúdos narrativos longos ainda precisam ser gerados em segmentos e depois unidos.
Novidades
Ver o changelog →- Novo modelo Novo modelo: Kling 3.0 Omni (可灵 O3), chamado via POST /v1/tasks. kling-3.0-omn…
Perguntas frequentes
Ver todas as perguntas →-
O Kling 3.0 Image-to-Video precisa de upload de imagem?
Sim. Atualmente, kling-3.0/image-to-video é uma rota de imagem para vídeo; a imagem de entrada define o sujeito e a composição inicial, e o Prompt define a ação, o movimento de câmera e as mudanças de ambiente.
-
Quais durações e resoluções o Kling 3.0 Image-to-Video suporta?
O contrato de requisição atual do HiAPI suporta 3–15s, com resoluções de saída de 720p, 1080p e 4K. Os valores disponíveis estão sujeitos ao painel de parâmetros da página e à documentação da API.
-
Como é cobrado o Kling 3.0 Image-to-Video?
A tarefa é cobrada com base na duração da saída e no nível selecionado. A página exibe o preço em tempo real seguindo a unidade monetária global, e a cobrança final é determinada pelo registro da tarefa bem-sucedida.
-
Como melhorar a estabilidade do sujeito na geração de vídeo a partir de imagem?
Use uma imagem de entrada com o sujeito nítido, poucas oclusões e composição completa; no Prompt, descreva primeiro a ação principal e o enquadramento da câmera, e depois liste a aparência, os materiais e as relações de fundo que devem ser preservados. No primeiro teste, recomenda-se usar uma duração mais curta.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: kling-3.0/motion-control
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para kling-3.0/motion-control e a rota default — veja a tabela de parâmetros abaixo.
promptstringOpcionalmaxLength 2500Prompt opcional para descrever a cena, o estilo e o enquadramento. As ações e expressões dos personagens são extraídas do vídeo de referência, e a aparência do personagem é extraída da imagem de referência; quando não preenchido, depende dos próprios materiais de referência.
image_urlstringObrigatórioImagem de referência do personagem, com suporte a formatos jpeg/png/jpg, tamanho não superior a 10MB, largura e altura ambas maiores que 340px, proporção entre 2:5 e 5:2; exige que cabeça, ombros e tronco estejam claramente visíveis.
video_urlstringObrigatórioVídeo de referência de movimento, com suporte a formatos mp4/mov, tamanho não superior a 100MB, duração de 3 a 30 segundos, devendo ser uma gravação contínua de tomada única com cabeça, ombros e tronco do sujeito visíveis; a duração da saída acompanha esse vídeo, sendo no máximo 10 segundos quando character_orientation for image e no máximo 30 segundos quando for video.
resolutionstringOpcionalPadrão: "720p"Resolução da saída; quanto maior a resolução, maior o custo; padrão 720p.
720p1080pkeep_original_soundbooleanOpcionalPadrão: trueDefine se o áudio original do vídeo de referência é mantido na saída; padrão true, ou seja, mantido por padrão.
character_orientationstringOpcionalPadrão: "video"Origem da orientação do personagem: quando for video, a orientação acompanha o vídeo de referência, adequado para movimentos complexos, com suporte máximo de 30 segundos; quando for image, a orientação acompanha a imagem de referência, adequado para movimentos de câmera, com suporte máximo de 10 segundos. Padrão video.
videoimagecallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0/motion-control",
  "input": {
    "image_url": "…",
    "video_url": "…",
    "resolution": "720p",
    "keep_original_sound": true,
    "character_orientation": "video"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "kling-3.0/motion-control",
input: {
"image_url": "…",
"video_url": "…",
"resolution": "720p",
"keep_original_sound": true,
"character_orientation": "video"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "kling-3.0/motion-control",
"input": {
"image_url": "…",
"video_url": "…",
"resolution": "720p",
"keep_original_sound": True,
"character_orientation": "video"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Tutorial
recraft-v4.1-flash geração de imagens por texto na prática: 5 cenários de negócio de alto valor e pontos de integração
Partindo de um custo de US$ 0,01 por imagem, planeje como aplicar a geração de imagens em negócios reais
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 Grok Imagine 1.5 Lite xAI $0.029 /segundo
-
 Vidu Q4 Preview Vidu $0.051 /segundo
-
 Runway Gen 4.5 Runway $0.172 /segundo
-
 Seedance 2.5 ByteDance $0.121 /segundo
-
 FLUX 3 Video Black Forest Labs $0.090 /segundo
-
 PixVerse V6 PixVerse $0.036 /segundo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Kling 3.0 Kuaishou $0.100 /segundo
-
 Kling 4.0 Kuaishou $0.330 /segundo
-
 Gemini Omni Google --
-
 Veo 3.1 Fast Google $0.170 /segundo
-
 HeyGen Avatar V HeyGen $0.150 /segundo


