
Meta
Muse Image 1.0
muse-image-1.0/image-to-image
Modelo de geração e edição de imagens baseado em raciocínio da Meta, que primeiro decompõe prompts complexos e depois renderiza, podendo combinar várias imagens de referência e usar a busca na web para garantir precisão factual
Experimentar muse-image-1.0/image-to-image
Entrada
Criações
Ver todas as criaçõesSaída
image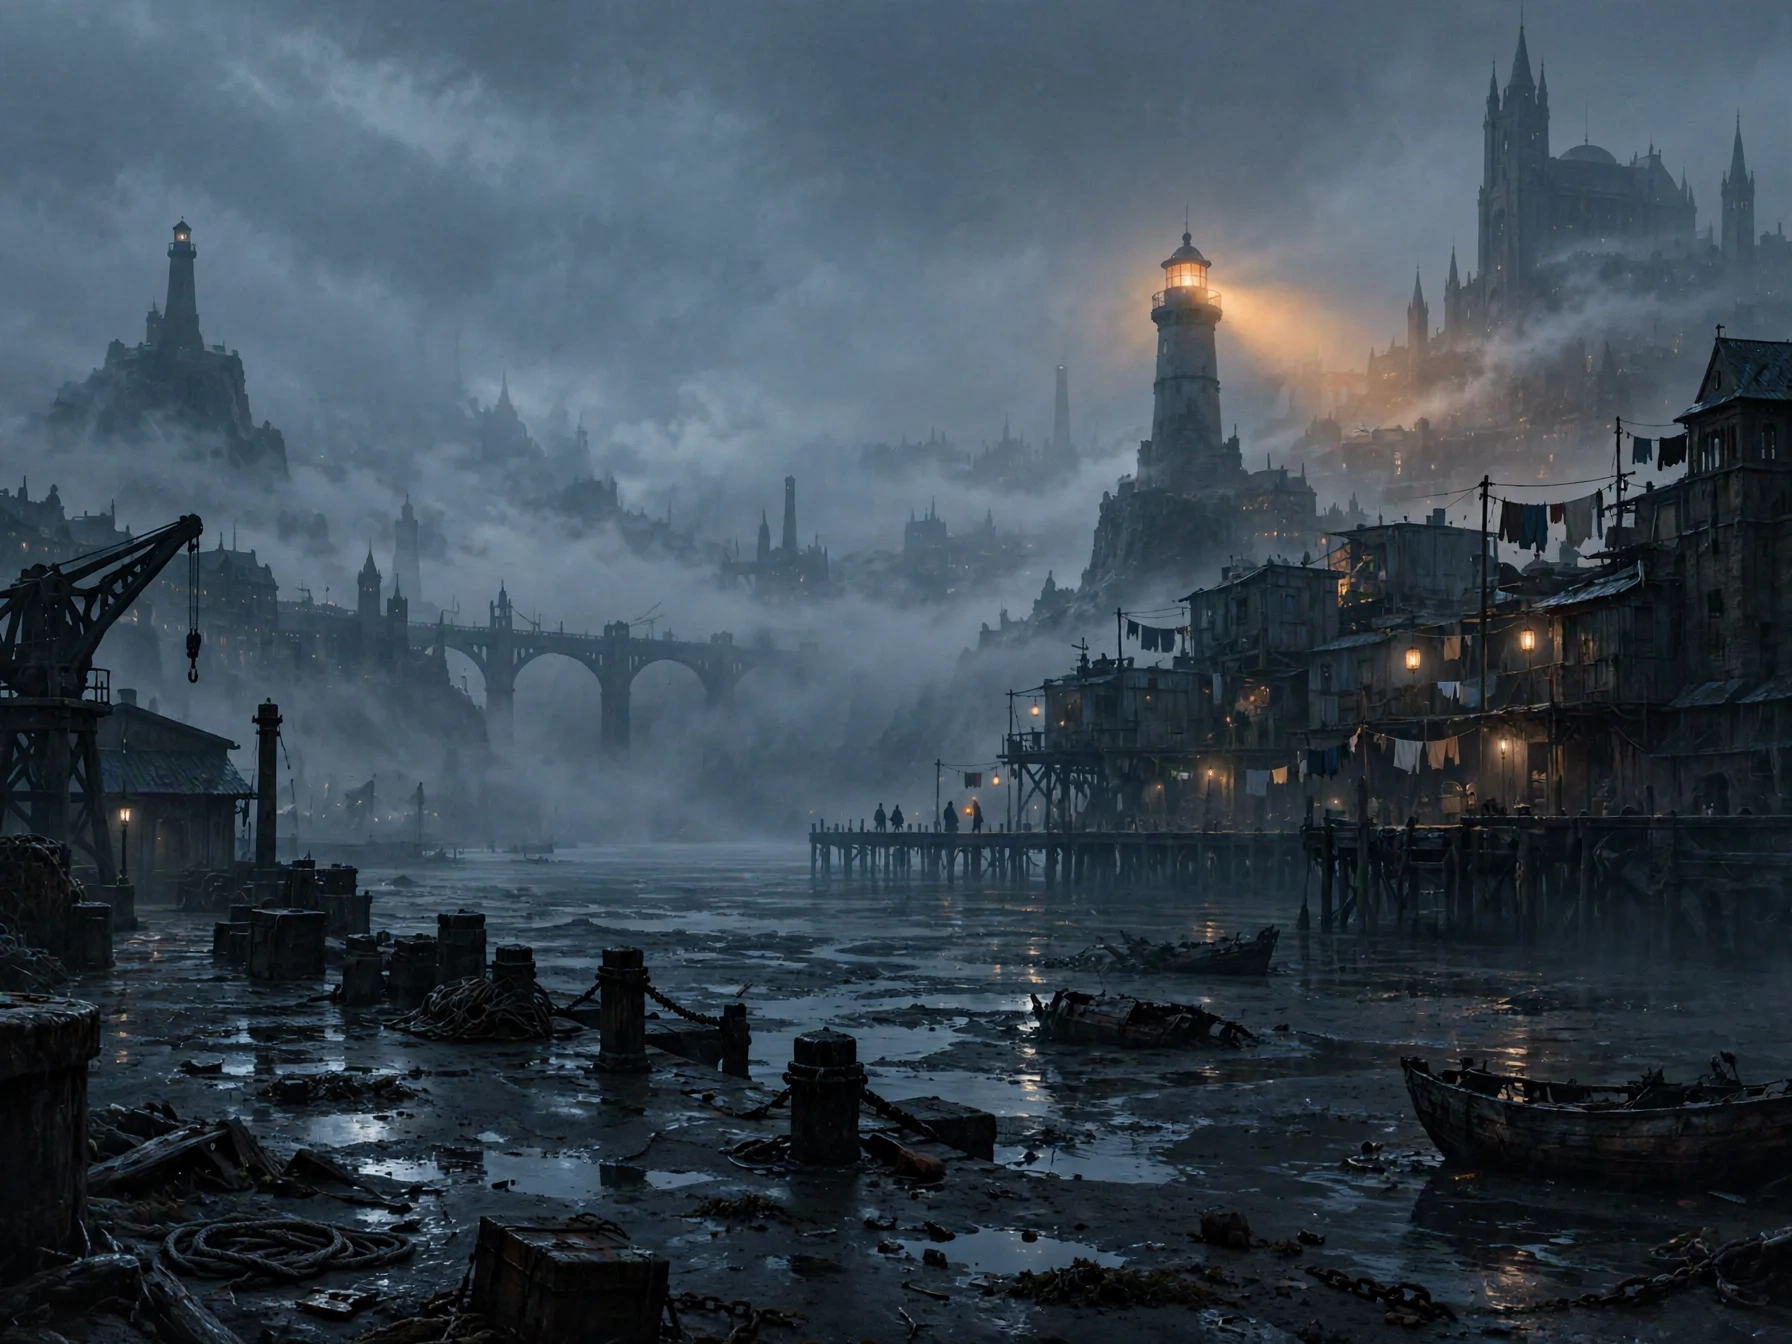
Conceito de arte do mundo: exploração atmosférica da Cidade das Marés de Cinzas
Estilo Arte conceitual · Construção de mundo · Moodboard
Entradas de referência
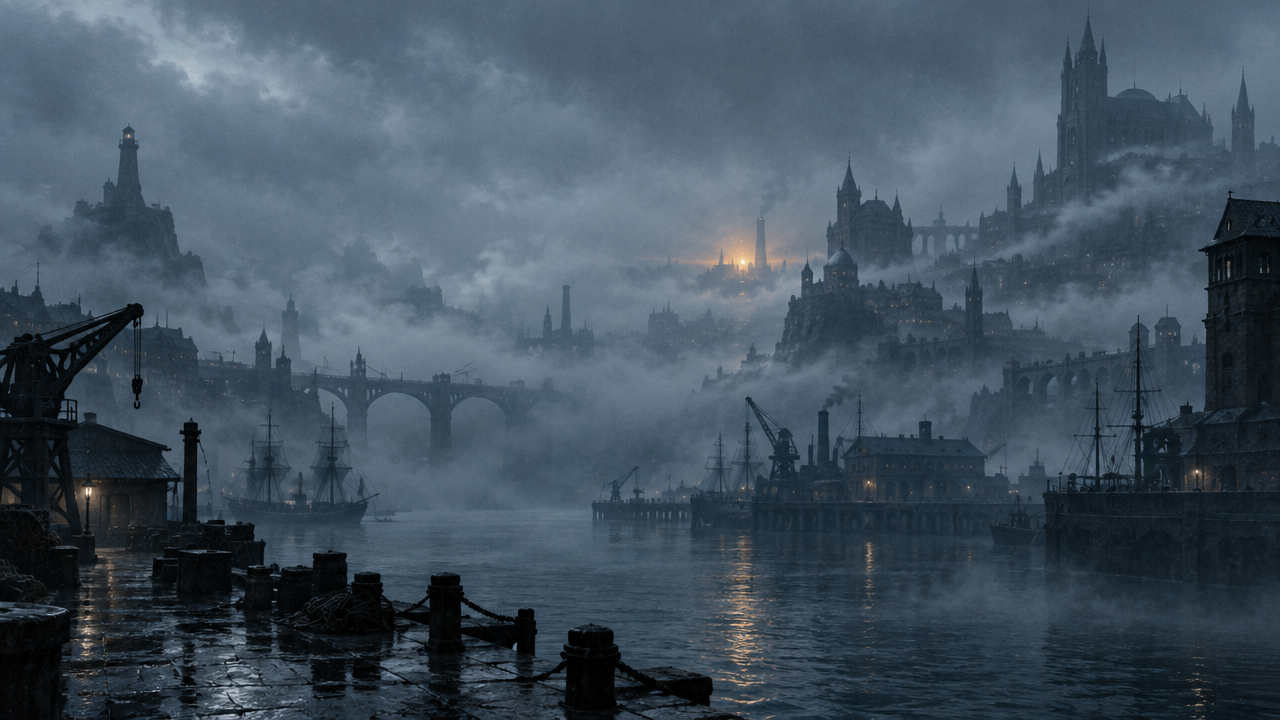
image_urls
Prompt
Arte conceitual cinematográfica de uma cidade costeira na maré baixa, composição widescreen 16:9. Primeiro plano: ruas de areia negra úmida expostas após a maré baixa, com cascos de navios e cordas cobertos por crosta de sal espalhados, reflexos finos e tênues do luar frio. Plano médio: arcos de aço corroídos pelo sal e moradias modulares empilhadas sobre palafitas, varal e lanternas penduradas, algumas silhuetas humanas caminhando ao longo de um passadiço de tábuas. Fundo: um alto farol de maré, com um feixe âmbar sombrio atravessando a névoa marinha densa, e um quebra-mar em ruínas ao longe dissolvendo-se na névoa. Preservar a paleta azul-acinzentada fria, a baixa saturação e a densidade da névoa atmosférica da imagem de referência; fazer com que os toques de luz âmbar quente se estendam às lanternas e ao feixe do farol. Luz volumétrica, grão de filme suave, textura de matte painting digital pictórica, detalhes contidos, contraste suave, sem texto, sem logotipos.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
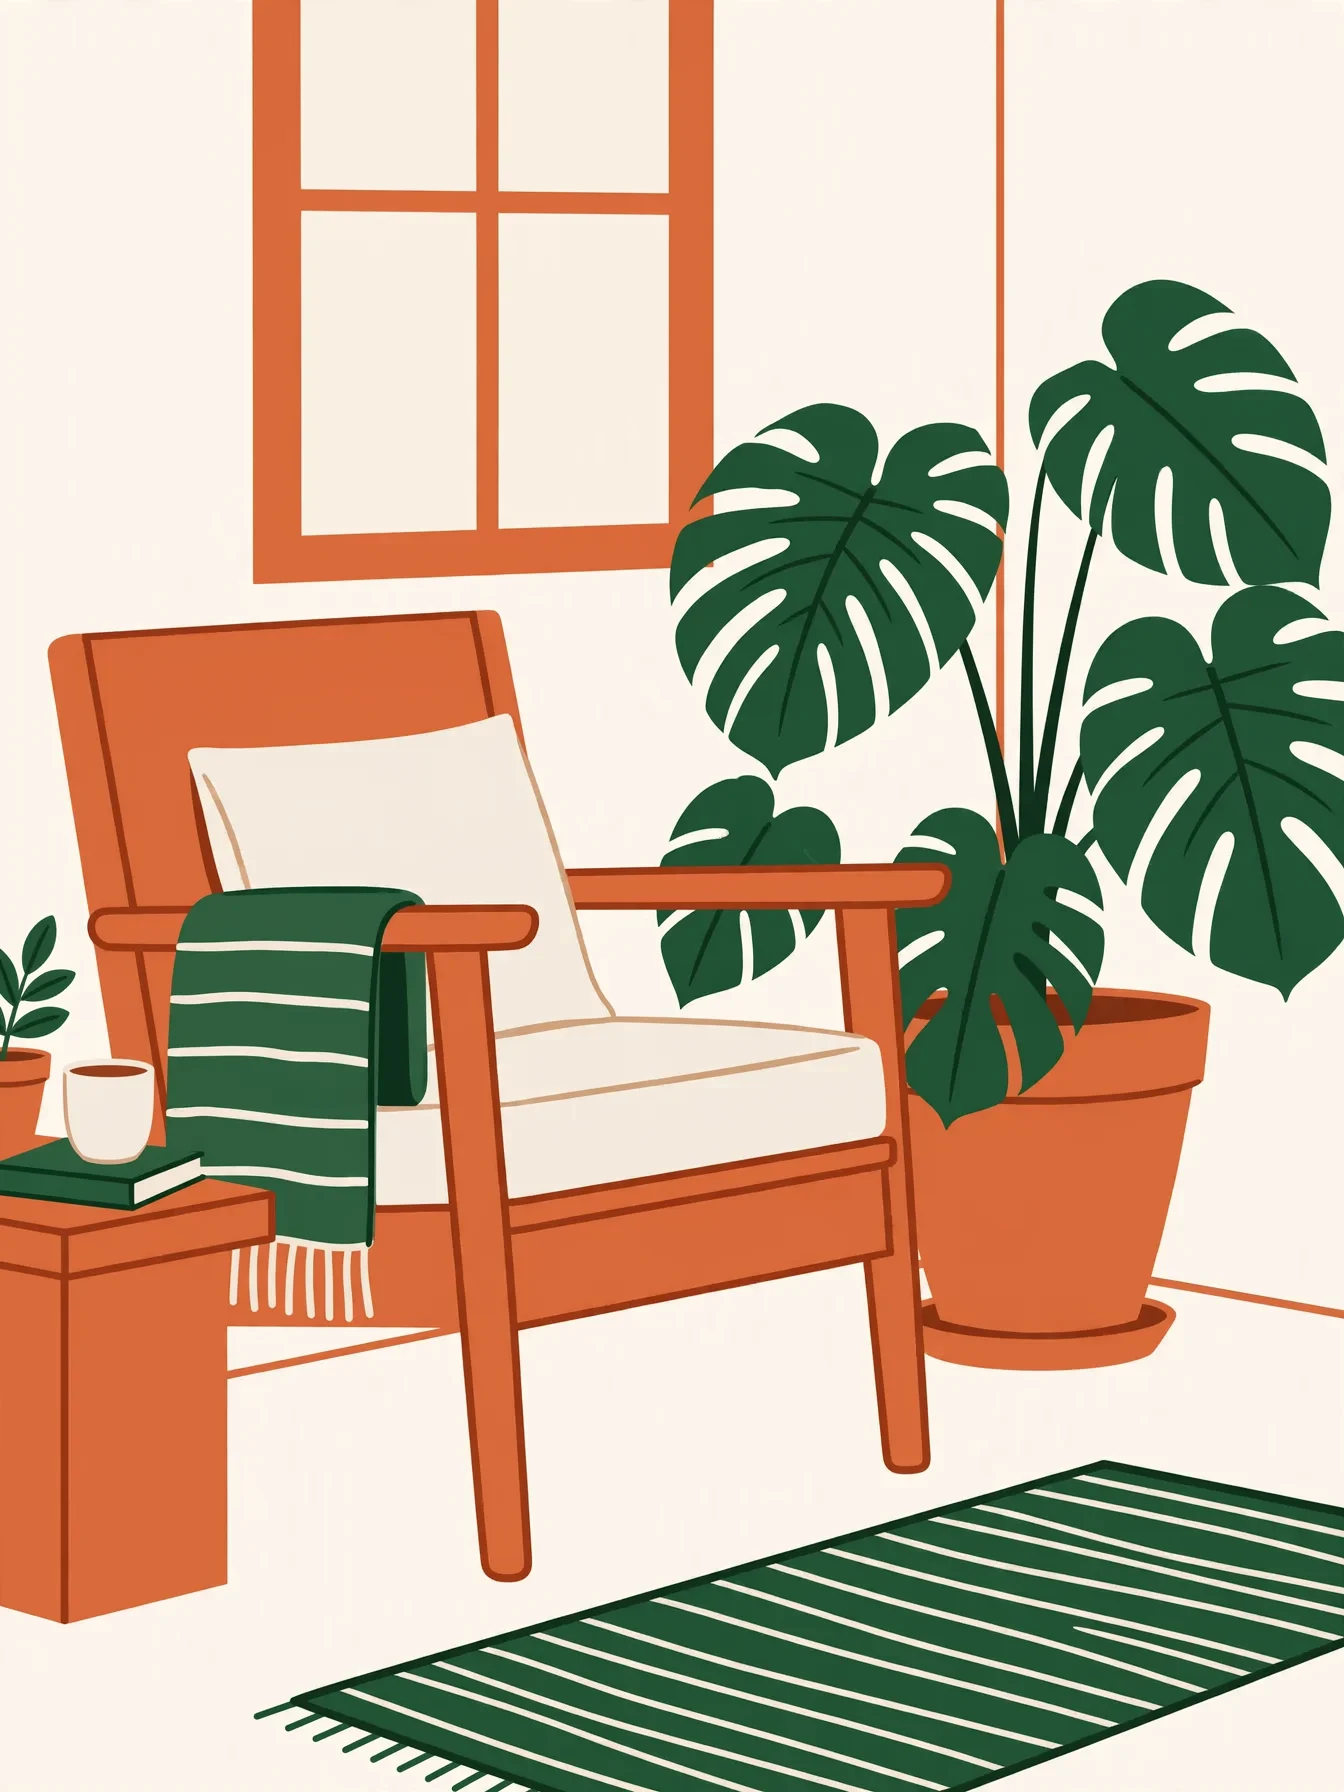
Espectro de estilos: tradução gradual de foto realista para ilustração flat
Estilo transferência de estilo · Ilustração flat · Orientação de referência
Entradas de referência
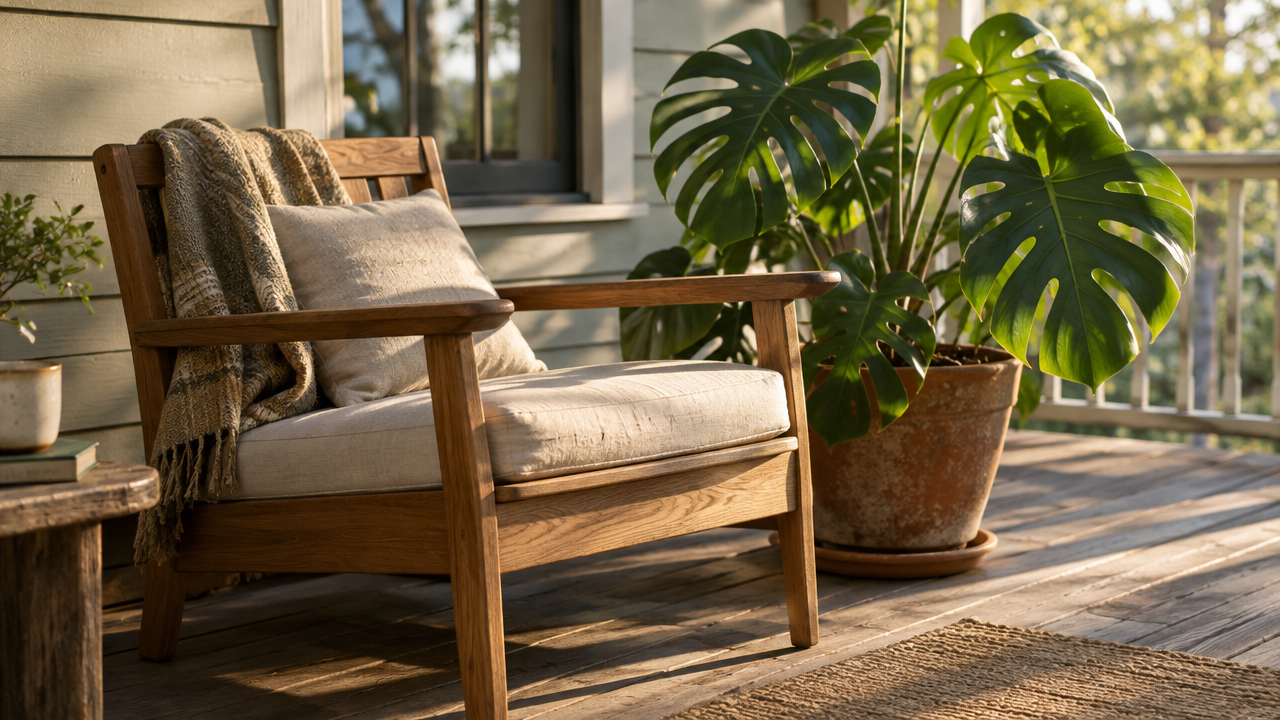
image_urls
Prompt
Ilustração vetorial flat convertida a partir da foto de referência: mantenha a identidade do sujeito, o contorno da cadeira e a posição das plantas exatamente iguais aos da referência, mas achate todo o restante. Substitua a iluminação fotográfica por duas ou três cores chapadas, comprima a profundidade de campo em planos sobrepostos, remova texturas e granulação, use linhas de contorno limpas e nítidas e uma paleta contida de terracota quente, branco-creme e verde-escuro. Sem gradientes, sem sombras projetadas, sem detalhes fotográficos. Composição centralizada, com bastante espaço negativo, estilo de ilustração editorial.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
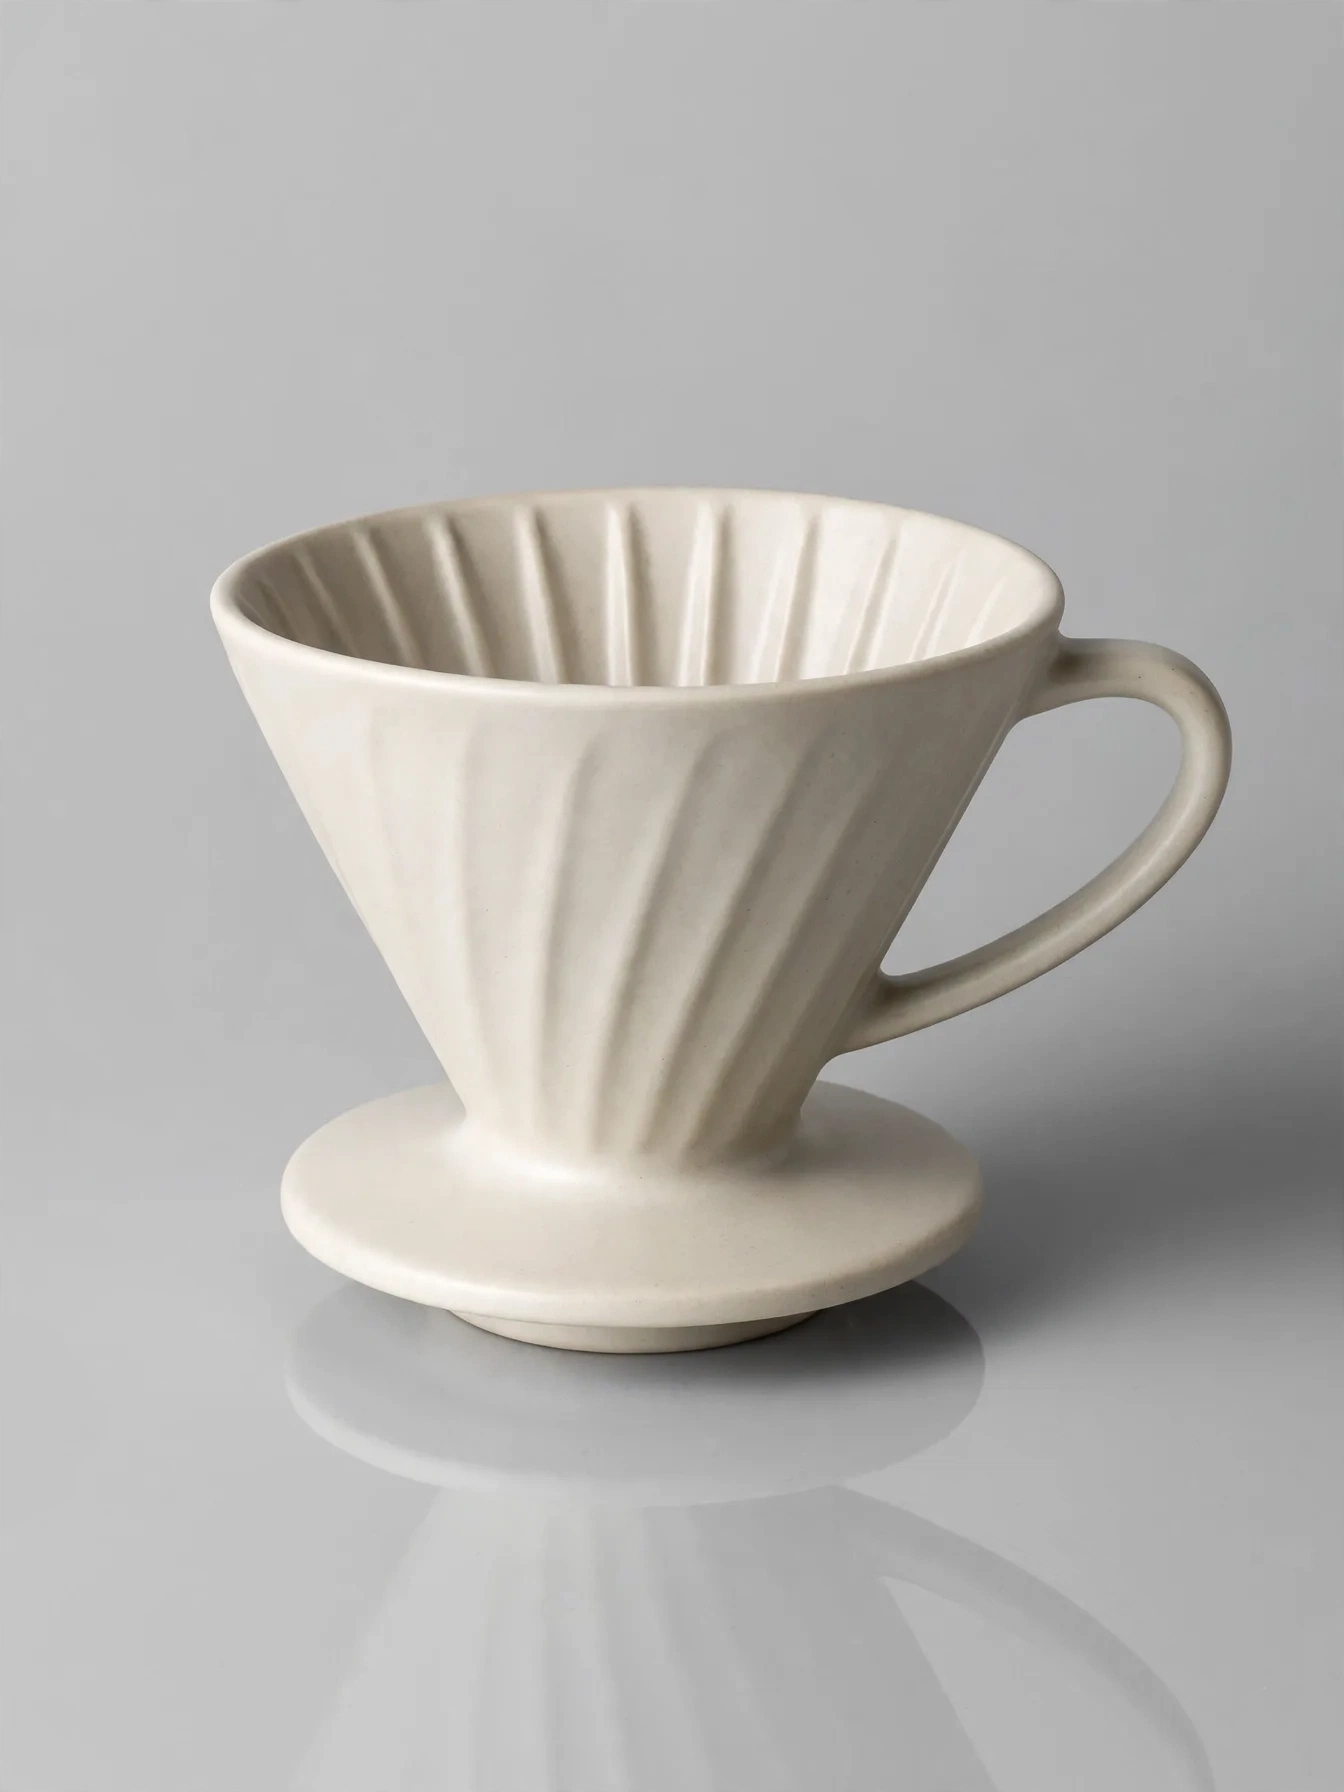
Qualidade de fotografia de produto nível e-commerce: uma imagem de referência para imagens de nível comercial
Estilo Imagem do produto · ecommerce · Iluminação de estúdio
Entradas de referência
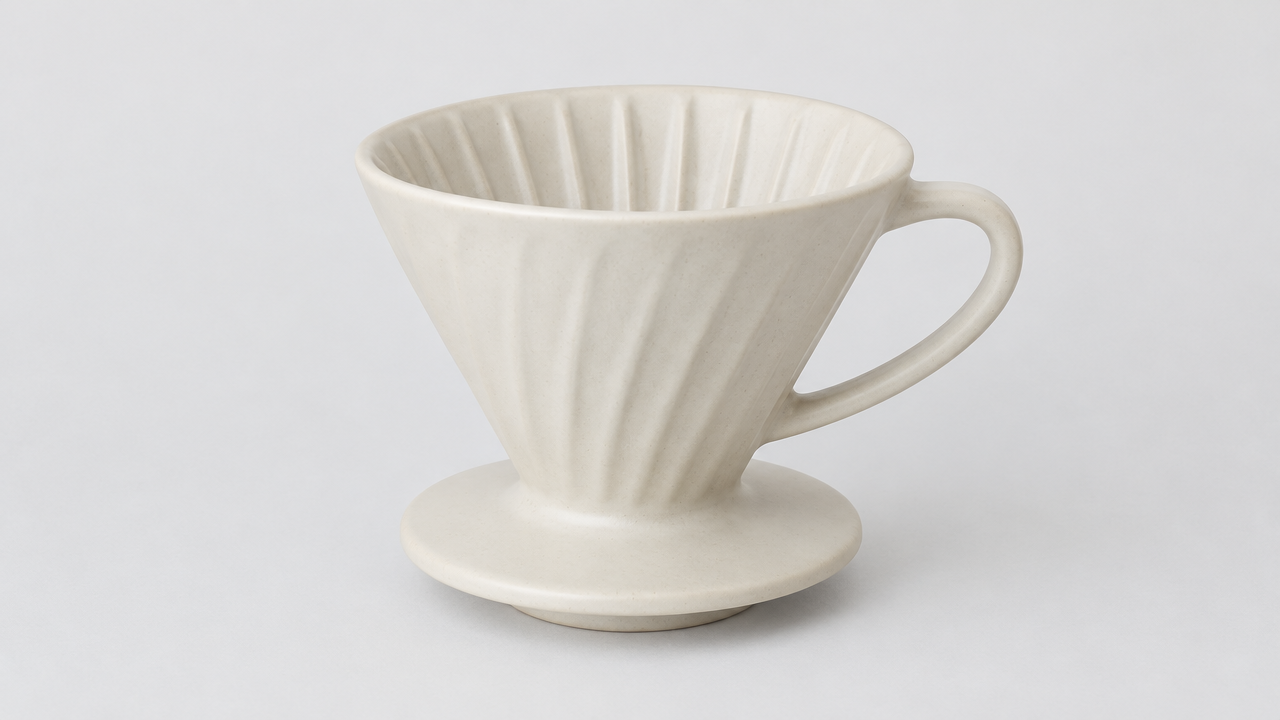
image_urls
Prompt
Reestilize o produto da imagem de referência como uma foto de produto comercial de e-commerce. Mantenha a forma exata, as proporções, as cores, a posição do logo e os detalhes de material do produto totalmente idênticos aos da imagem de referência; não adicione, remova nem redesenhe nenhuma característica. Posicione-o sobre um fundo de estúdio infinito cinza-claro fosco, com um reflexo suave e sutil na parte inferior. Iluminação: luz principal de softbox grande no canto superior esquerdo, com decaimento em gradiente suave para a direita, luz de contorno fina e estreita ao longo das bordas do produto para separá-lo do fundo, sem pontos de realce brilhantes no rótulo. Câmera: lente de produto equivalente a 85mm, ao nível dos olhos do produto, ângulo ligeiramente de três quartos, profundidade de campo suficientemente profunda para manter todo o produto nítido. Composição: produto centralizado, com amplo espaço negativo limpo, quadro horizontal 16:9, adequado para banner de loja. Pós-processamento: bordas nítidas, balanço de branco neutro, cores precisas, sem poeira, sem impressões digitais, sem adereços, sem sobreposição de texto.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
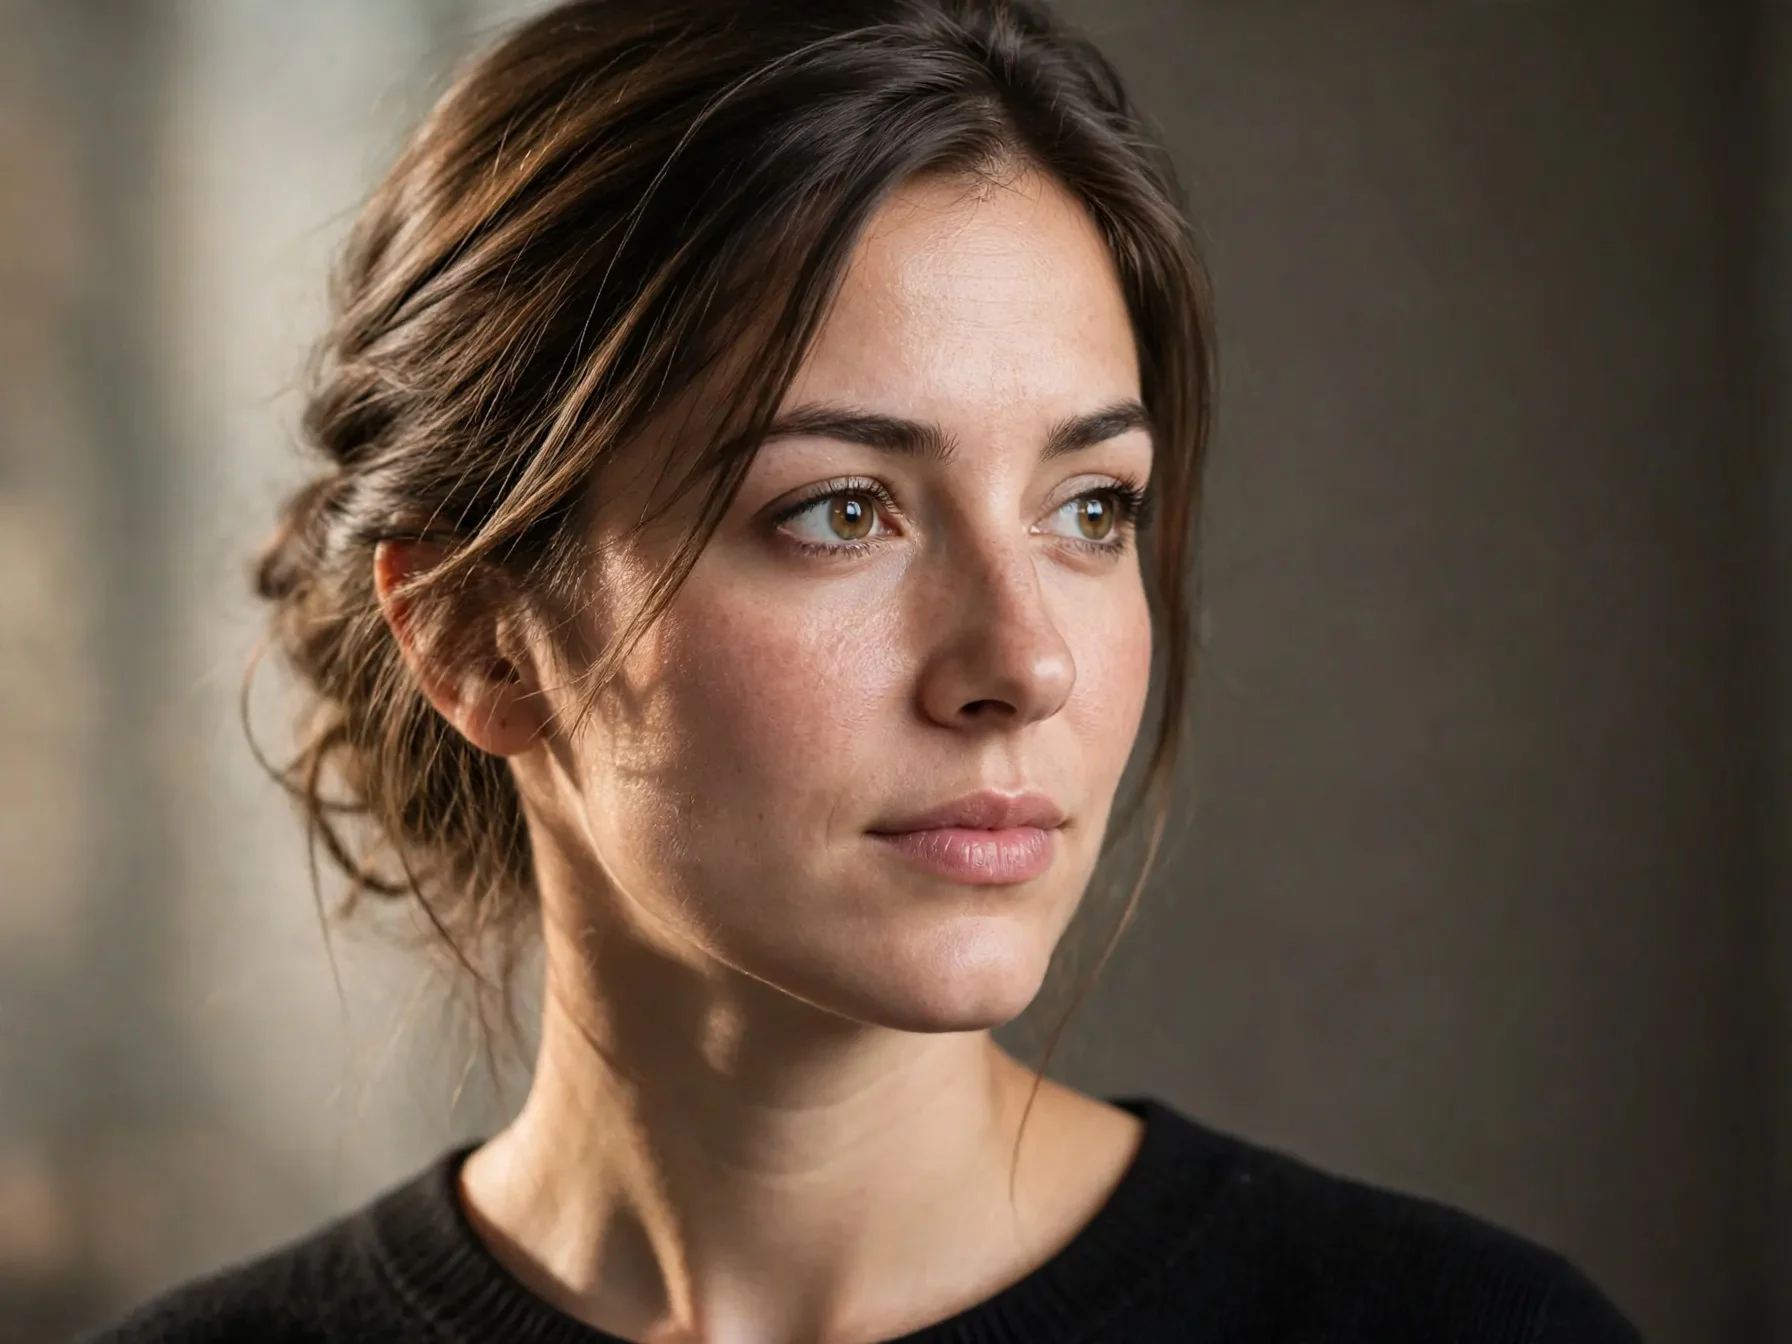
Redesenho de retratos realistas e artísticos guiado por imagem de referência
Estilo Retrato e fotografia · transferência de estilo · Fotorrealismo
Entradas de referência
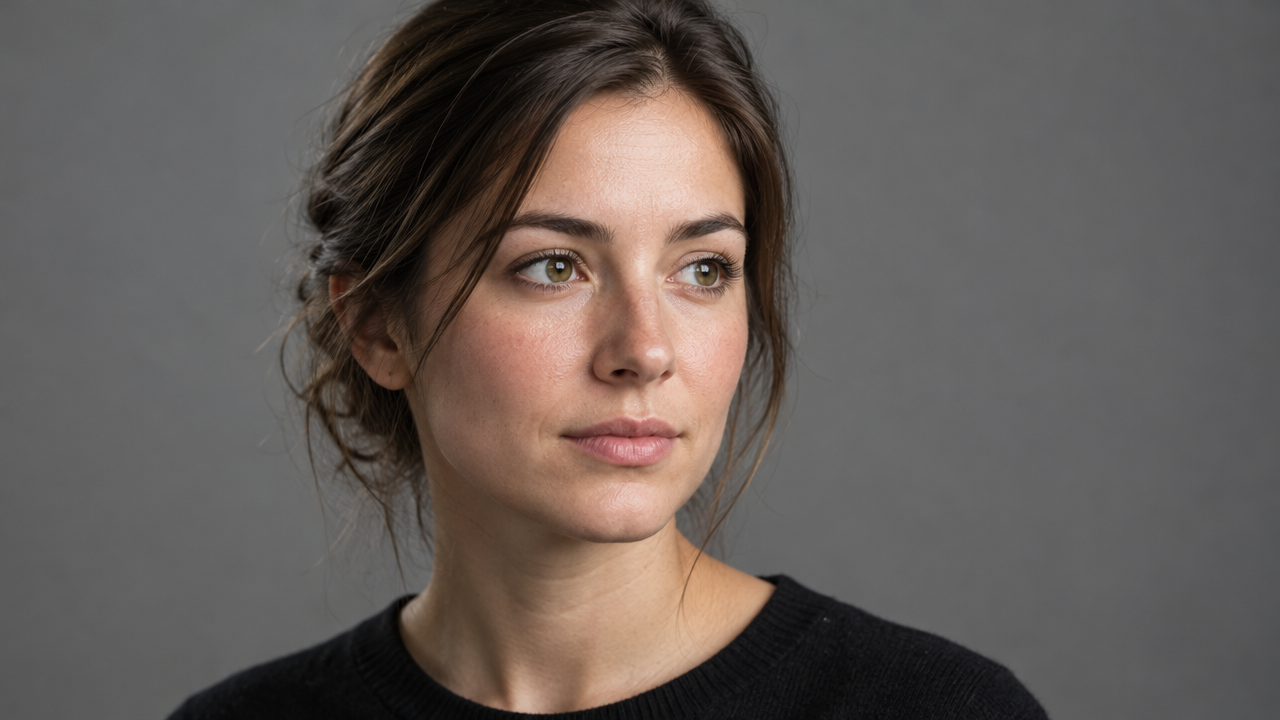
image_urls
Prompt
Estilo de redesenho de retrato de imagem para imagem. Use a foto de referência fornecida como única fonte de identidade da pessoa e de composição: mantenha a mesma estrutura facial, contorno do cabelo, ângulo da cabeça e postura dos ombros. Renderize um único retrato em plano médio-próximo, composição vertical 3:4, luz principal direcional suave vinda da esquerda da câmera, com transição delicada para um fundo infinito cinza-quente neutro. Preserve a textura natural da pele, com poros visíveis e fios de cabelo finos, reflexos especulares sutis nas maçãs do rosto e na ponte do nariz, olhos realistas com brilho visível e transições de tom realistas. Color grading contido, com leve contraste de textura de filme; sem estilização excessiva, sem suavização plástica da pele, sem adereços ou textos adicionais. Profundidade de campo rasa, foco nítido nos olhos, efeito de lente de retrato 85mm.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
muse-image-1.0/image-to-image per task
| Preço unitário | $0.015 |
|---|
Visão geral do posicionamento
muse-image-1.0/image-to-image é um modelo de geração e edição de imagens orientado por imagem de referência lançado pela Meta, acessível por meio da interface unificada do HiAPI.ai. Ele recebe como entrada uma ou mais imagens de referência, combinadas com prompts de texto, para realizar geração de cenas, substituição de elementos e reescrita de estilo, e decompõe e planeja o layout de instruções complexas de múltiplas partes antes de renderizar. É indicado para desenvolvedores que precisam usar materiais existentes como imagem-base e buscam alta fidelidade ao prompt e eficiência na produção em lote, podendo ser aplicado em fluxos como variações de materiais, imagens de cena de produtos e composição personalizada.
Destaques principais
- Fluxo de geração que primeiro raciocina e depois renderiza — antes da renderização, decompõe o prompt de múltiplas partes e planeja o layout, reduzindo a probabilidade de que instruções complexas sejam descartadas em uma única geração direta.
- Geração e edição realizadas no mesmo modelo — a fusão de imagens de referência e a reescrita conforme instruções dispensam o encadeamento de ferramentas de edição adicionais, reduzindo etapas de chamada.
- Várias imagens de referência por requisição — aceita até 10 imagens de referência, e é possível especificar no prompt o papel de cada imagem como sujeito, estilo ou composição.
- Especificações de saída controladas diretamente por parâmetros — permite definir a proporção e o formato de saída jpeg, png ou webp, facilitando a integração com a cadeia de materiais downstream.
Descrição das capacidades
Edição de imagens orientada por imagem de referência: recebe como entrada uma imagem de referência mais um prompt de texto e modifica ou preserva o conteúdo da imagem conforme o prompt, sendo adequada para ajustes direcionados em materiais existentes em vez de geração do zero.
Fusão de múltiplas imagens: uma única requisição pode conter de 1 a 10 imagens de referência, indicando no prompt o papel de cada imagem como sujeito, estilo ou composição, para tarefas de composição.
Execução decomposta de prompts complexos: planeja descrições de múltiplas partes antes de renderizar, tornando mais fácil implementar integralmente prompts que contenham vários sujeitos e requisitos de layout.
Controle das especificações de saída: suporta nove proporções, de 1:1 a 21:9, e permite escolher os formatos jpeg, png ou webp, produzindo diretamente conforme a necessidade de veiculação ou armazenamento.
Cenários de aplicação
- Equipes de publicidade e mídia: geração de variações em lote a partir de materiais existentes — enviar a imagem-base da marca e reescrever cena e proporção conforme o prompt de cada canal, produzindo vários conjuntos de materiais para testes A/B e distribuição multicanal.
- Operação de e-commerce: transformação de cenas de imagens de produto — usar fotos reais do produto como referência, indicar no prompt a substituição de fundo e cena e gerar imagens de catálogo ou de cena para a página de detalhes do produto.
- Composição personalizada: integração de fotos do usuário em novas cenas — usar a foto enviada pelo usuário como imagem de referência para compor uma cena temática e produzir imagens personalizadas para páginas de campanha ou compartilhamento social.
Limitações e recomendações de seleção
Informações públicas não divulgam detalhes técnicos como a arquitetura do modelo e a resolução de saída; os resultados gerados precisam ser avaliados conforme o efeito real. O raciocínio em várias etapas adiciona latência, não sendo adequado a cenários extremamente sensíveis ao tempo de resposta; a saída é limitada a imagens, sem envolver vídeo ou áudio. Se a tarefa exigir apenas geração de imagem a partir de texto sem imagem de referência, pode-se optar pela linha de geração texto-imagem da mesma família; se for necessário gerar vídeo ou obter latência menor, deve-se considerar outros modelos.
Perguntas frequentes
Ver todas as perguntas →-
Como escolher entre geração de imagem a partir de texto e edição de imagem?
Quando você tem apenas texto e vai começar do zero, escolha a geração de imagem a partir de texto; quando precisar manter um sujeito ou layout existente, escolha a edição de imagem e forneça uma imagem de referência.
-
Quantas imagens posso obter por vez?
Cada tarefa retorna uma imagem, sem opção de quantidade. Se precisar comparar outra composição, ajuste o prompt e envie uma nova tarefa.
-
Posso escolher 1K, 2K ou 4K?
Esta entrada não oferece níveis de resolução. O enquadramento é escolhido por você e as dimensões em pixels são determinadas pelo modelo, geralmente cerca de 2,5MP; consulte as dimensões reais do arquivo baixado.
-
Quais formatos de arquivo posso escolher?
Você pode escolher JPEG, PNG ou WebP; se nenhum for selecionado, WebP é usado. Escolha de acordo com as necessidades posteriores de materiais para páginas web ou ferramentas de design.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: muse-image-1.0/image-to-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para muse-image-1.0/image-to-image e a rota default — veja a tabela de parâmetros abaixo.
promptstringObrigatóriominLength 1maxLength 5000Prompt de texto que descreve a imagem que se deseja gerar ou explica o conteúdo da imagem de referência que precisa ser modificado ou preservado; ao usar imagens de referência, indique nelas o sujeito, o estilo ou o papel de composição de cada imagem.
image_urlsarrayObrigatóriominItems 1maxItems 10Array de imagens de referência, cujos elementos são endereços de imagem que fornecem as referências necessárias para image-to-image; recomenda-se indicar no prompt o sujeito, o estilo ou o papel de composição correspondente a cada imagem.
Array [ string ]
aspect_ratiostringOpcionalProporção de largura e altura da imagem de saída, que determina apenas a proporção e não especifica dimensões exatas em pixels.
1:14:33:416:99:163:22:321:9Mostrar tudo (1)
9:21output_formatstringOpcionalPadrão: "webp"Formato de arquivo para baixar a imagem, padrão webp.
jpegpngwebpcallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/image-to-image",
  "input": {
    "prompt": "…",
    "image_urls": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/image-to-image",
input: {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/image-to-image",
"input": {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 GPT Image 2.5 OpenAI $0.017 /imagem
-
 Ideogram V4.5 Ideogram $0.011 /imagem
-
 Grok Imagine Quality xAI $0.070 /imagem
-
 Recraft Crisp Upscale Recraft $0.004 /imagem
-
 Seedream 5.0 ByteDance $0.025 /imagem
-
 FASHN Tryon v1.6 FASHN $0.107 /imagem
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagem
-
 Z-Image Alibaba $0.008 /imagem
-
 Grok Imagine Image 2.0 xAI $0.052 /imagem
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /imagem
-
 BRIA Eraser Bria $0.058 /imagem
-
 FIBO 1.5 Bria $0.058 /imagem