
Meta
Muse Image 1.0
muse-image-1.0/image-to-image
Metas räsonierendes Modell zur Bildgenerierung und -bearbeitung: Es zerlegt komplexe Prompts vor dem Rendern, kann mehrere Referenzbilder zusammenführen und mithilfe von Websuche die sachliche Richtigkeit sicherstellen
muse-image-1.0/image-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image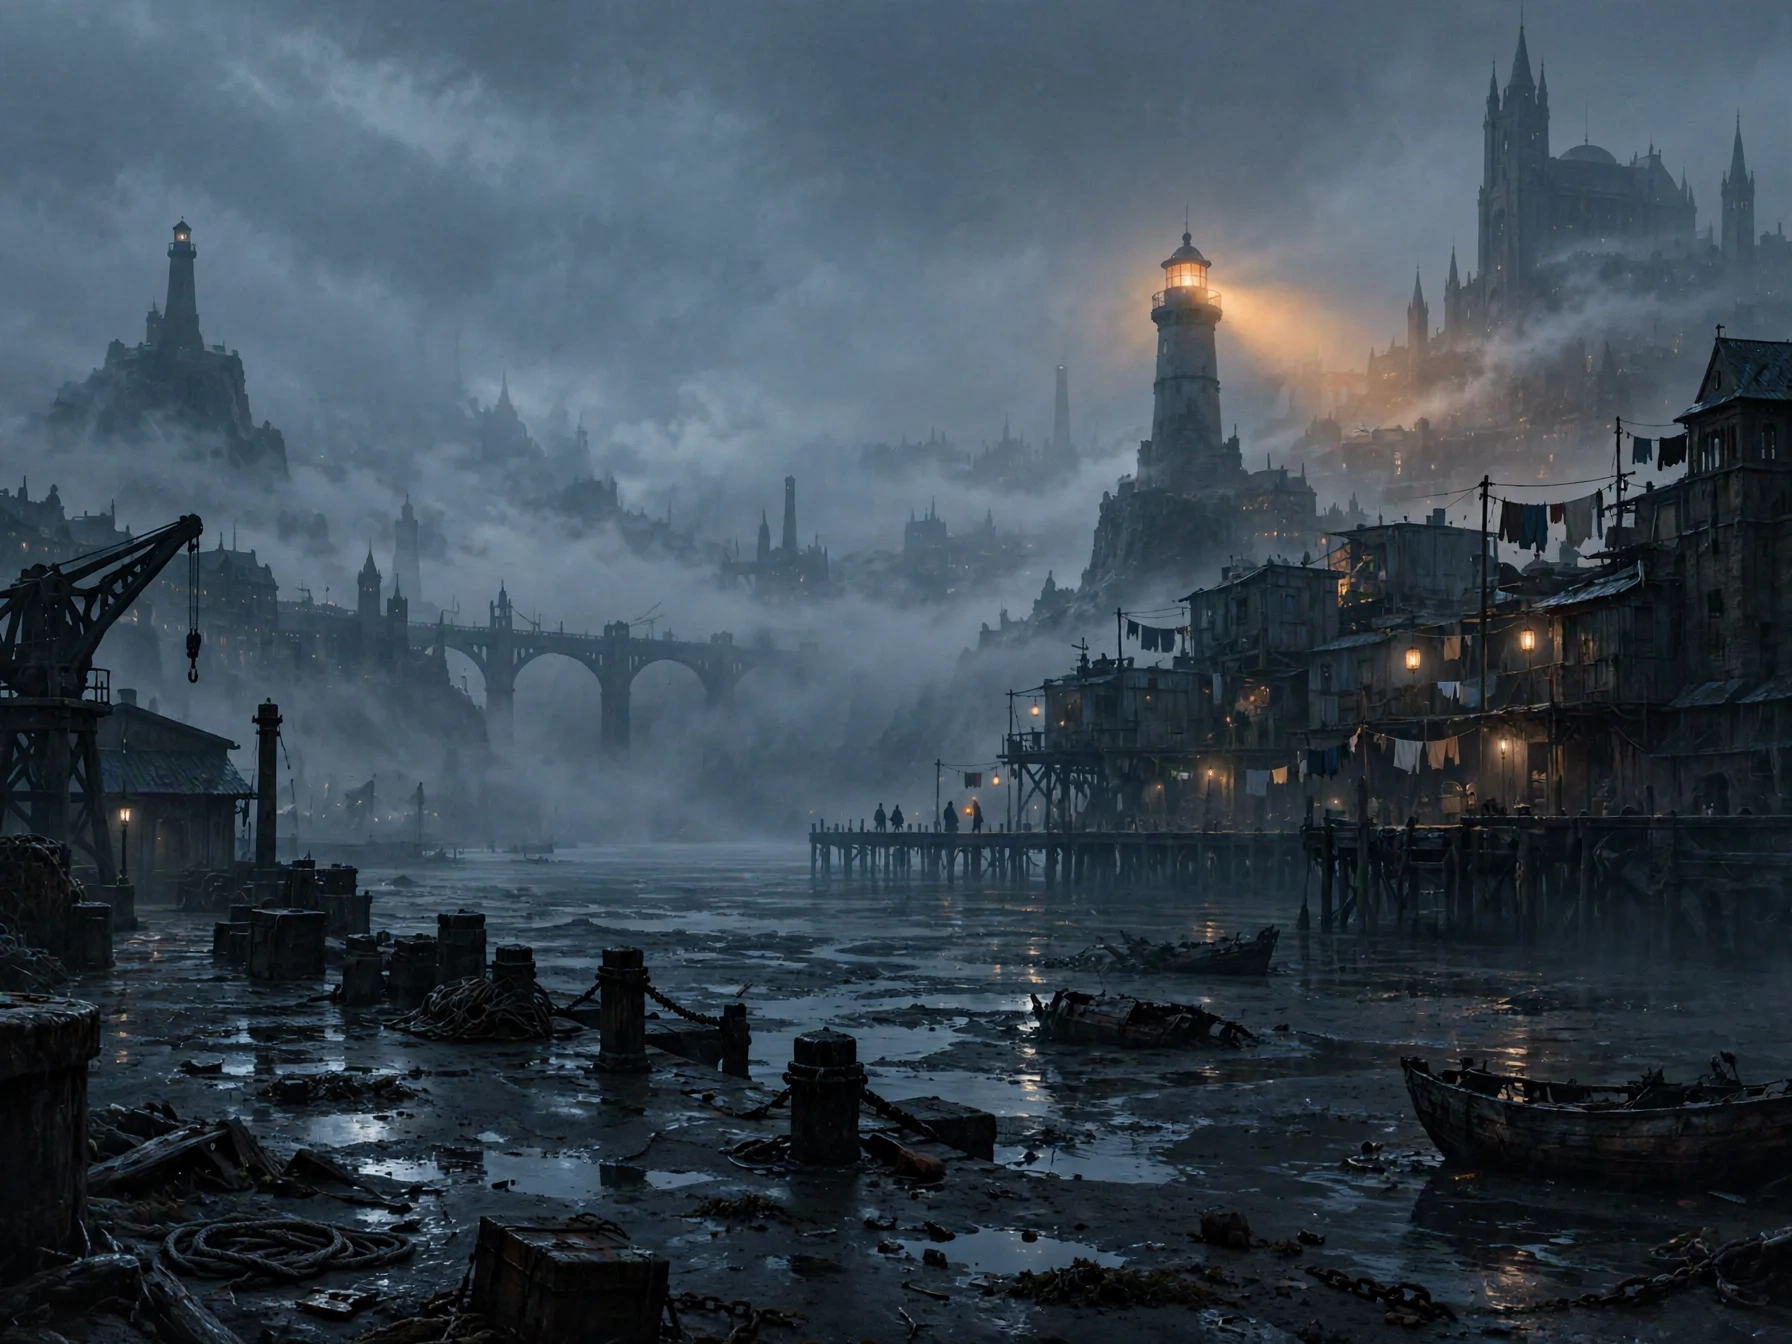
Weltbild-Konzeptkunst: Atmosphärische Erkundung der Aschentiden-Stadt
Stil Konzeptkunst · Weltbau · Stimmungsboard
Referenz-Eingaben
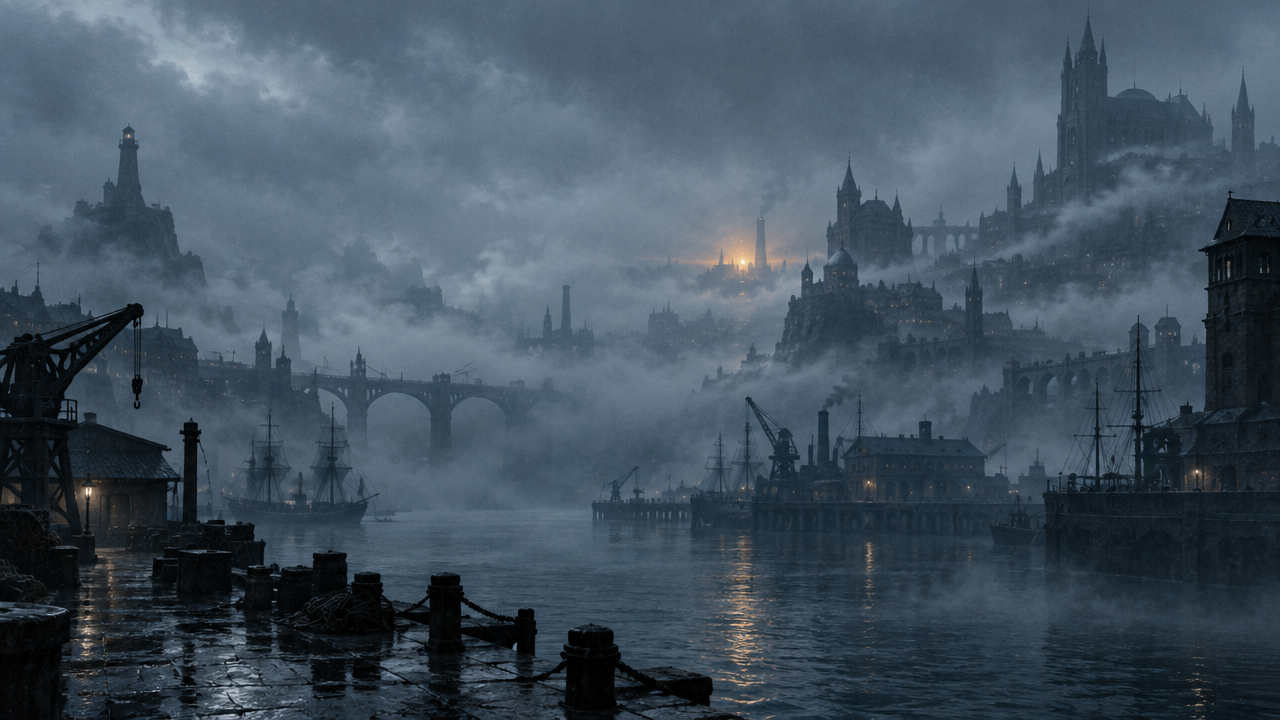
image_urls
Prompt
Filmische Konzeptkunst einer Küstenstadt bei Ebbe, 16:9-Breitbildkomposition. Vordergrund: nach der Ebbe freigelegte, feuchte Straßen aus schwarzem Sand, übersät mit salzbedeckten Rümpfen und Tauen, dünne Spiegelungen des kühlen Mondlichts. Mittelgrund: von Salz zerfressene Stahlbögen und gestapelte modulare Behausungen auf Pfählen, Wäscheleinen und hängende Laternen, einige Silhouetten, die entlang eines Holzstegs gehen. Hintergrund: ein hoher Tidenleuchtturm, dessen gedämpfter bernsteinfarbener Lichtstrahl den dichten Seenebel durchdringt, eine verfallene Wellenbrechermauer in der Ferne, die im Nebel verschwimmt. Bewahre die kühlen blaugrauen Töne, die geringe Sättigung und die atmosphärische Nebeldichte des Referenzbildes; lasse die warmen bernsteinfarbenen Akzentlichter auf den Laternen und dem Leuchtturmstrahl fortbestehen. Volumetrisches Licht, sanftes Filmkorn, malerische digitale Matte-Painting-Textur, zurückhaltende Details, weicher Kontrast, kein Text, keine Logos.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
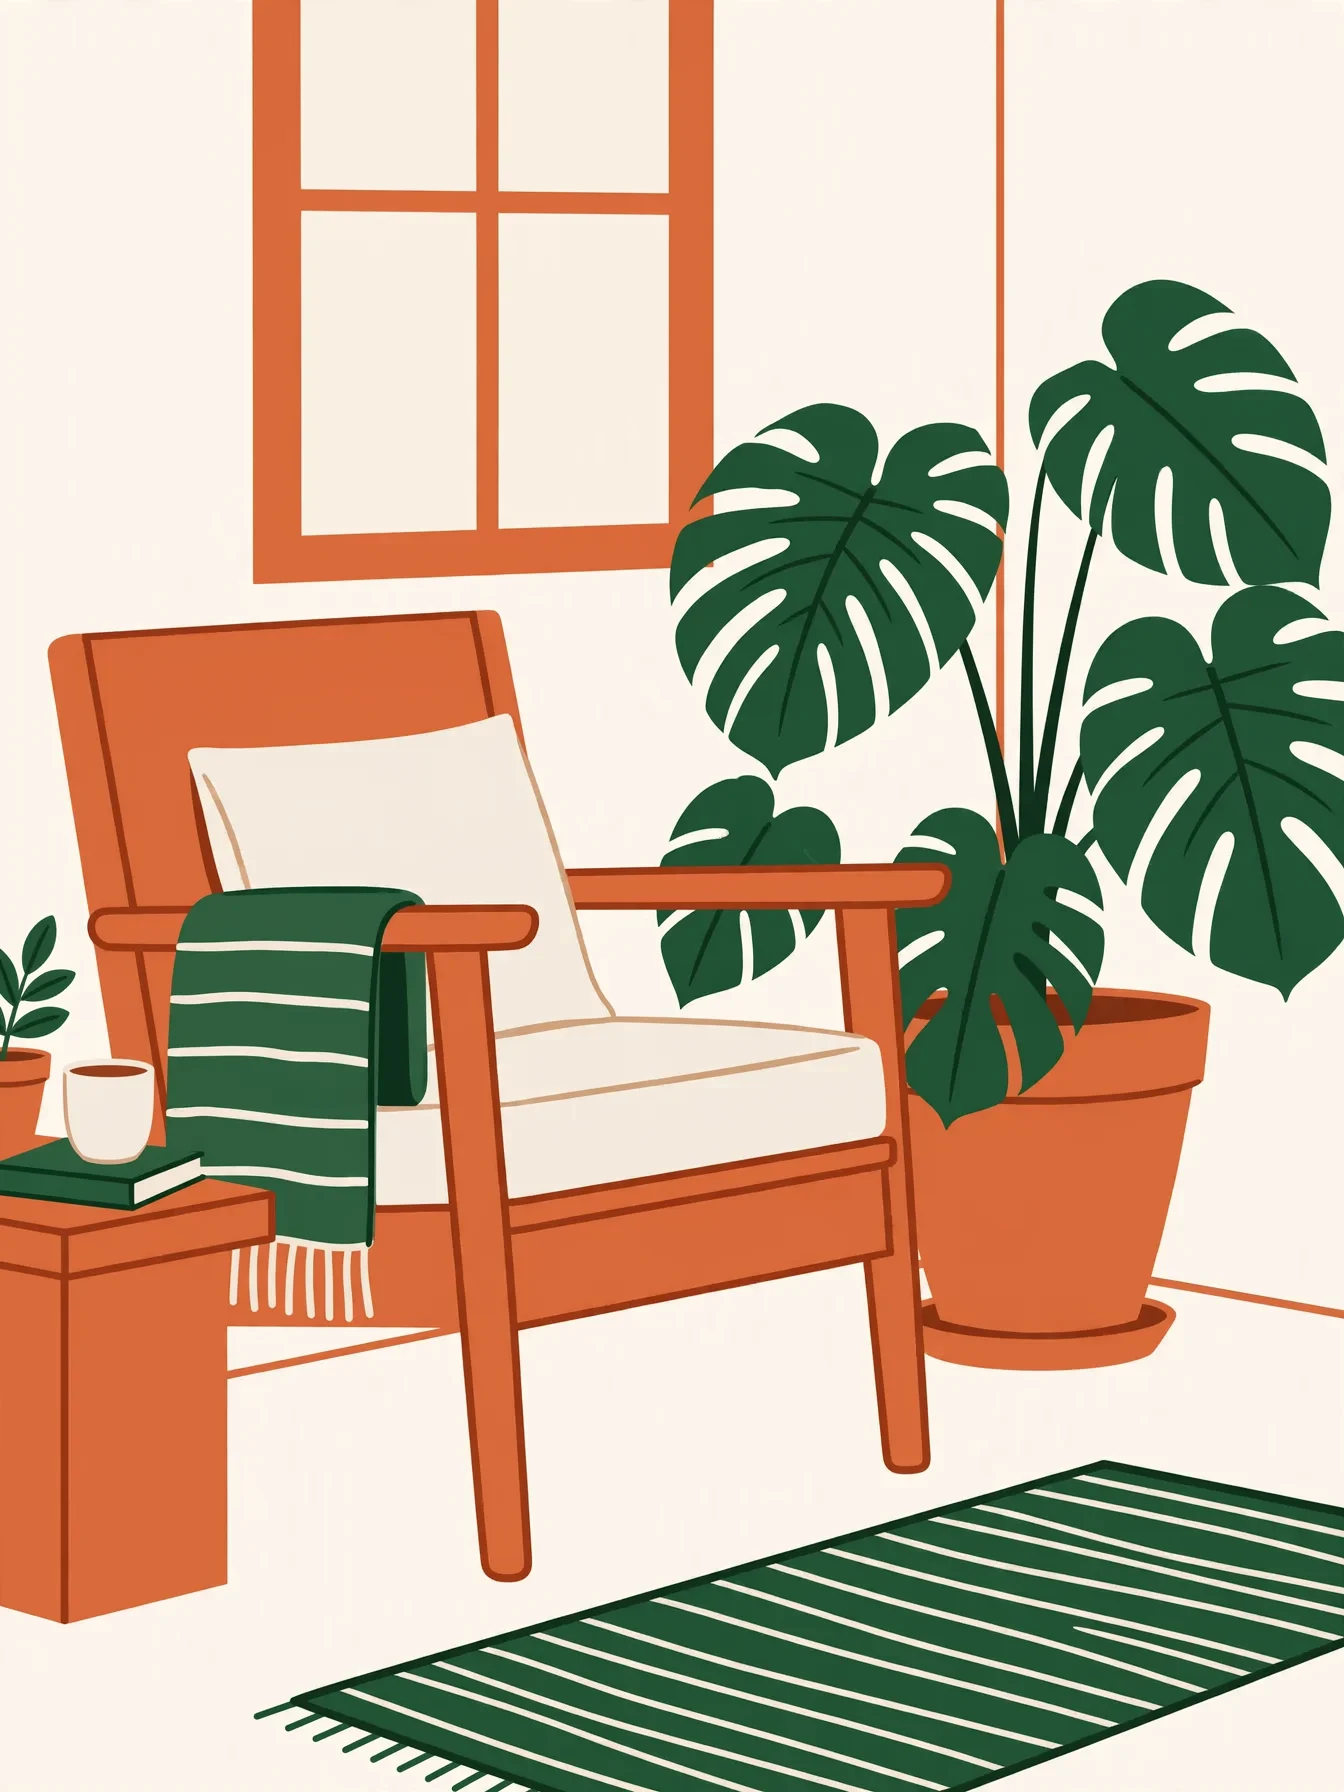
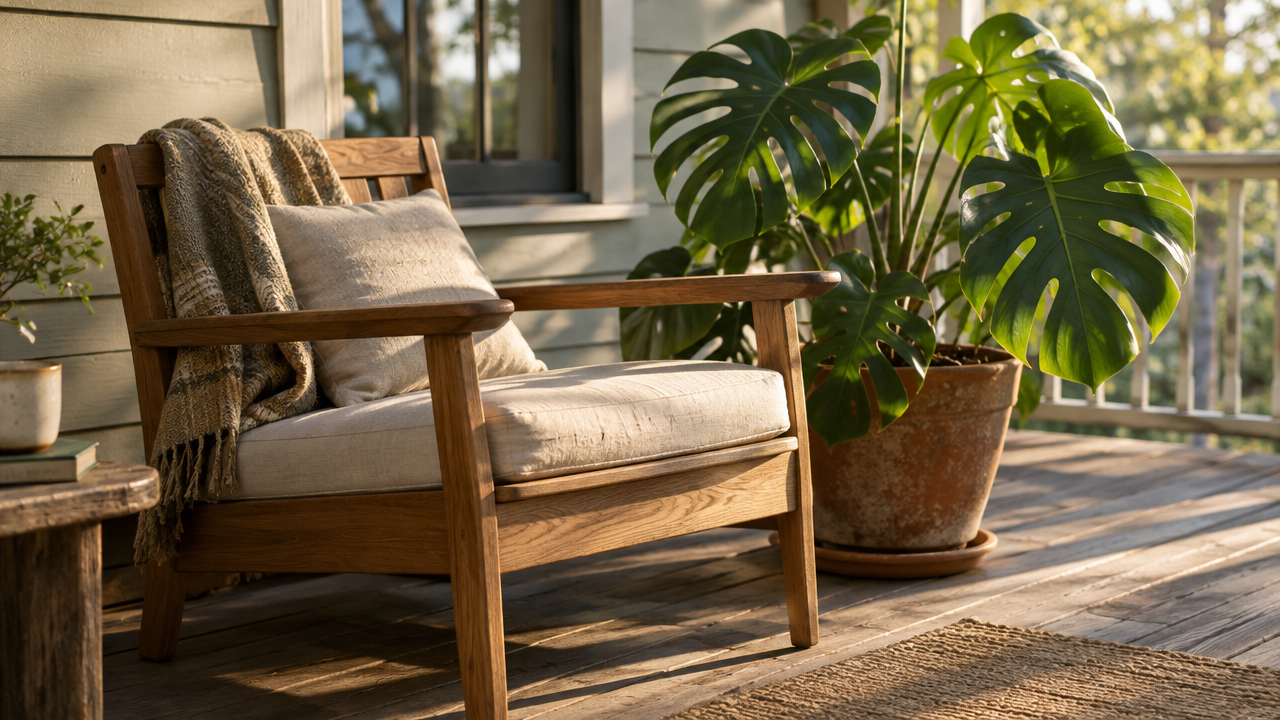
Stilspektrum: schrittweise Übersetzung vom realistischen Foto zur flachen Illustration
Stil Stiltransfer · Flache Illustration · Referenzführung
Referenz-Eingaben
image_urls
Prompt
Eine aus dem Referenzfoto umgesetzte flache Vektorillustration: Die Identität des Motivs, die Kontur des Stuhls und die Position der Pflanzen bleiben exakt wie im Referenzbild, alles Übrige wird vollständig verflacht. Fotografische Beleuchtung wird durch zwei bis drei Volltöne ersetzt, die Schärfentiefe zu sich überlappenden Flächen verdichtet, Textur und Korn entfallen, es kommen saubere, prägnante Konturlinien sowie eine zurückhaltende Farbpalette aus warmem Terrakotta, Off-White und Dunkelgrün zum Einsatz. Keine Verläufe, keine Schlagschatten, keine Fotodetails. Zentrierte Komposition mit reichlich Negativraum, redaktioneller Illustrationsstil.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
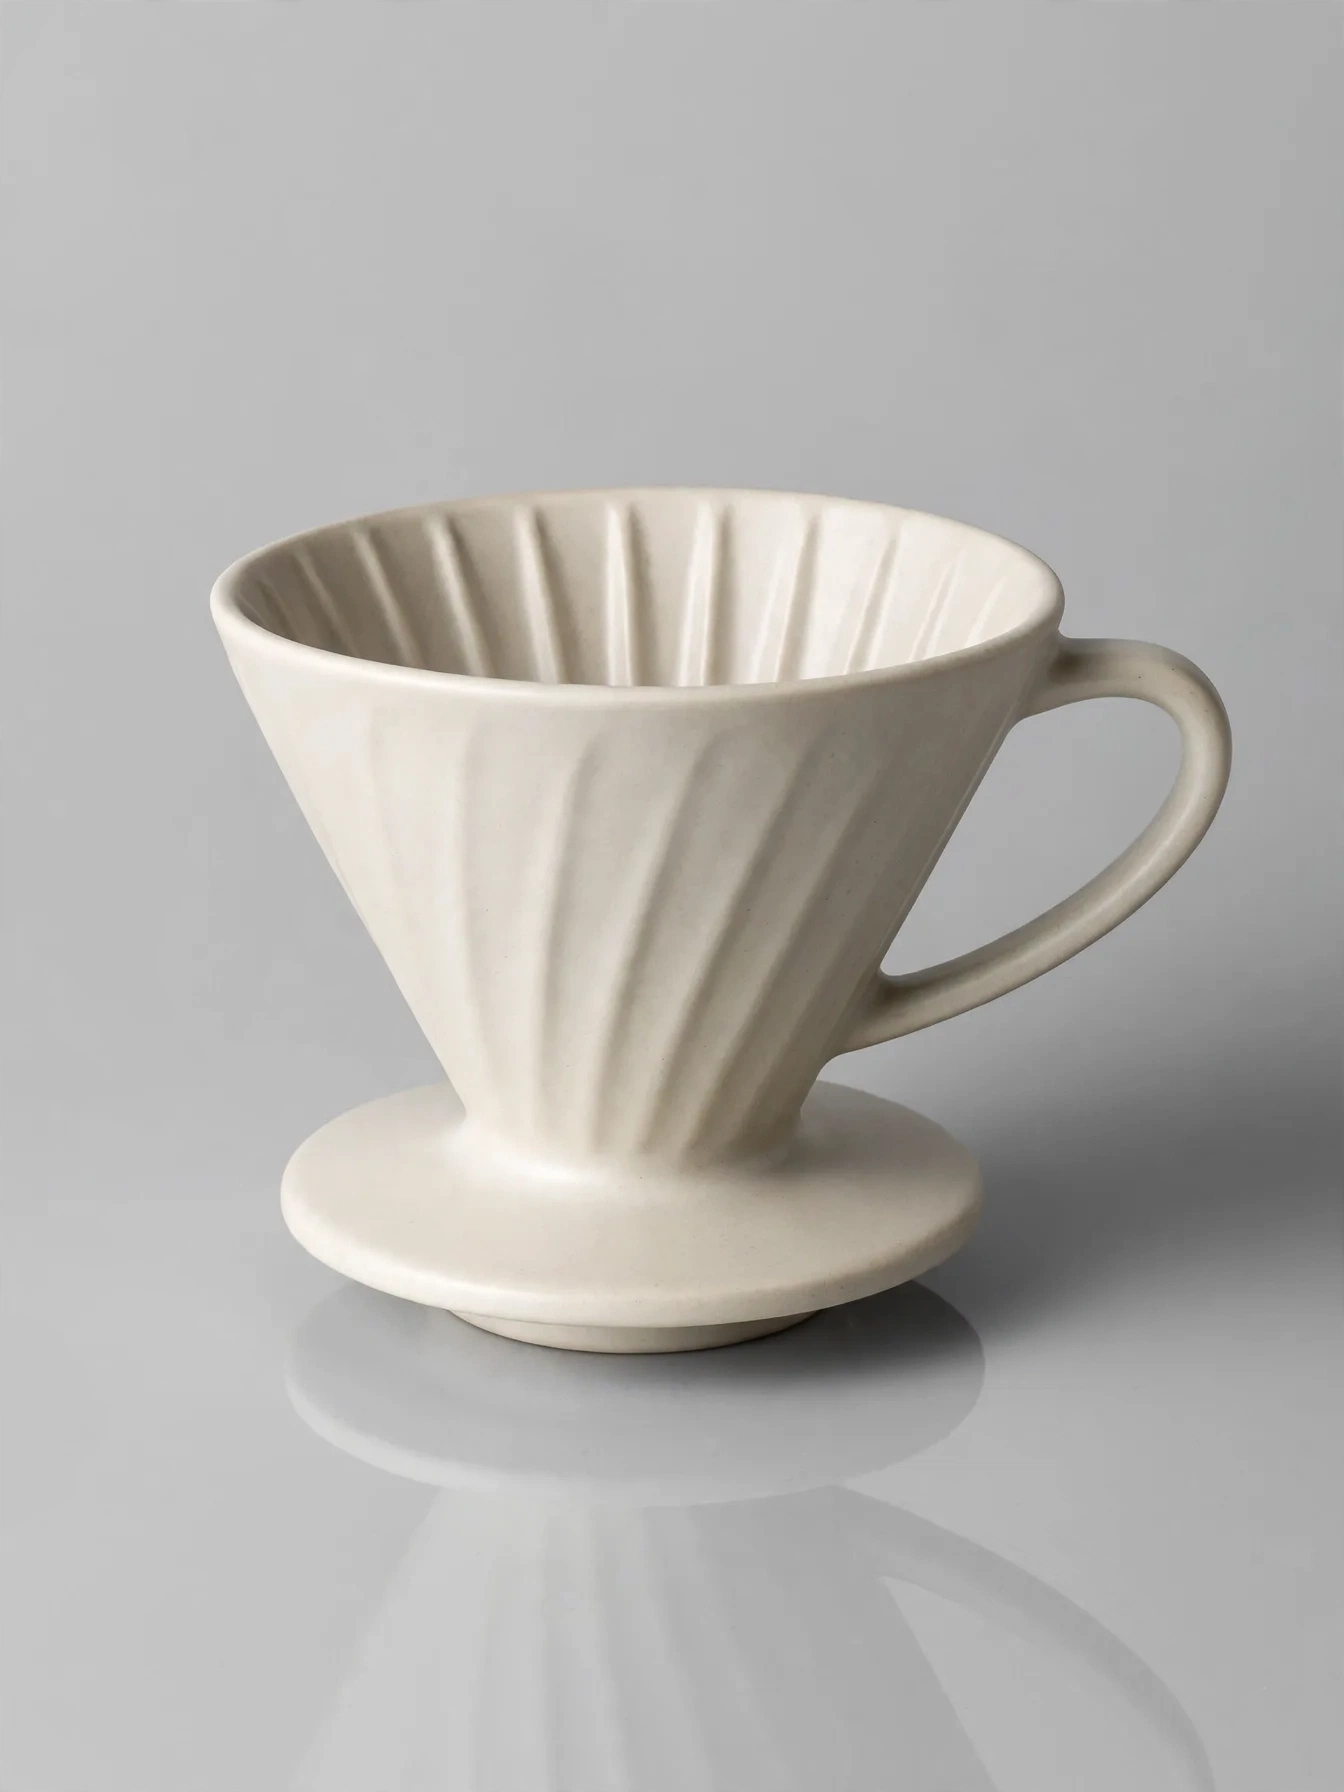
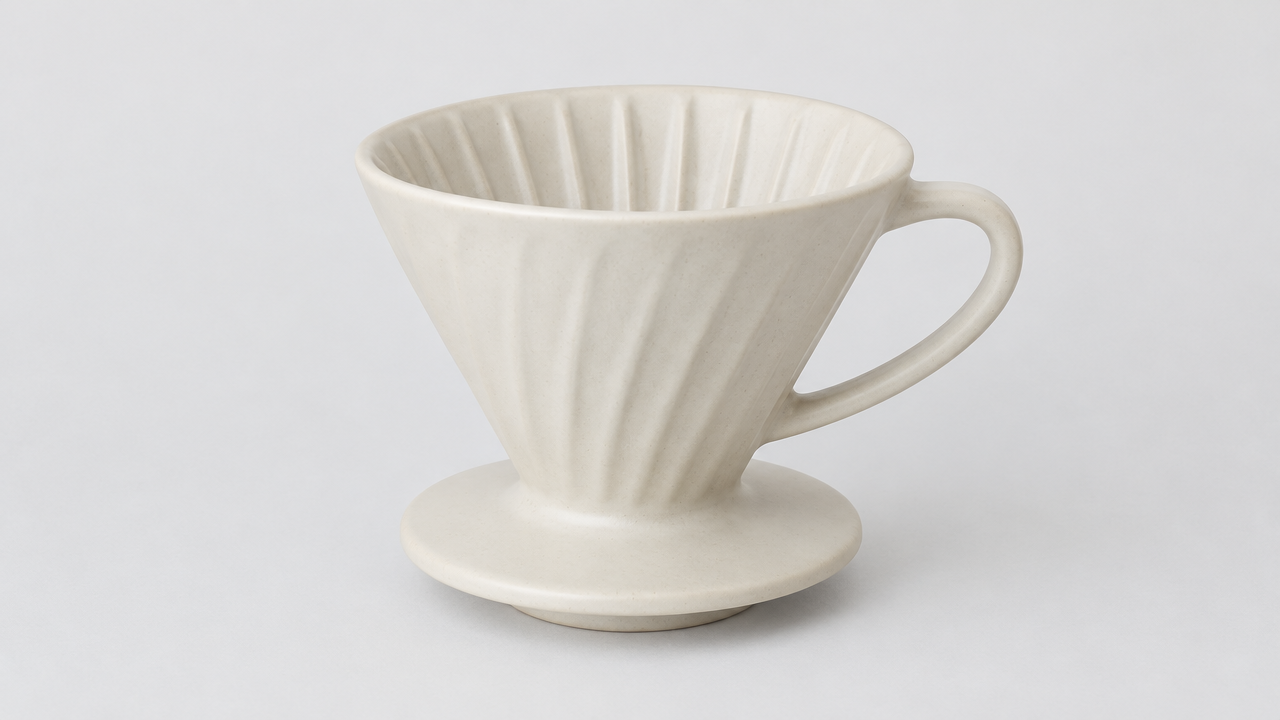
Produktfotografie in E-Commerce-Qualität: Von einer Referenzaufnahme zum kommerziell nutzbaren Bild
Stil Produktbild · ecommerce · Studiobeleuchtung
Referenz-Eingaben
image_urls
Prompt
Stilisiere das Produkt im Referenzbild zu einem kommerziellen E-Commerce-Produktfoto um. Bewahre die exakte Form, Proportionen, Farben, Logo-Position und Materialdetails des Produkts vollständig identisch zum Referenzbild; füge keine Merkmale hinzu, entferne keine und gestalte keine neu. Platziere es auf einem matten, hellgrauen, nahtlosen Studiohintergrund mit einer dezenten weichen Reflexion am unteren Rand. Beleuchtung: große Softbox als Hauptlicht oben links, die nach rechts weich ausläuft, ein schmaler Konturlicht-Streifen entlang der Produktkanten zur Trennung vom Hintergrund, keine grellen Glanzlichter auf dem Etikett. Kamera: 85-mm-Produktobjektiv (äquivalent), auf Augenhöhe des Produkts, leicht im Dreiviertelwinkel, ausreichend große Schärfentiefe, damit das gesamte Produkt scharf bleibt. Komposition: Produkt zentriert, großzügiger sauberer Negativraum, Querformat 16:9, geeignet für ein Shop-Banner. Nachbearbeitung: klare Kanten, neutraler Weißabgleich, akkurate Farben, kein Staub, keine Fingerabdrücke, keine Requisiten, keine Texteinblendungen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
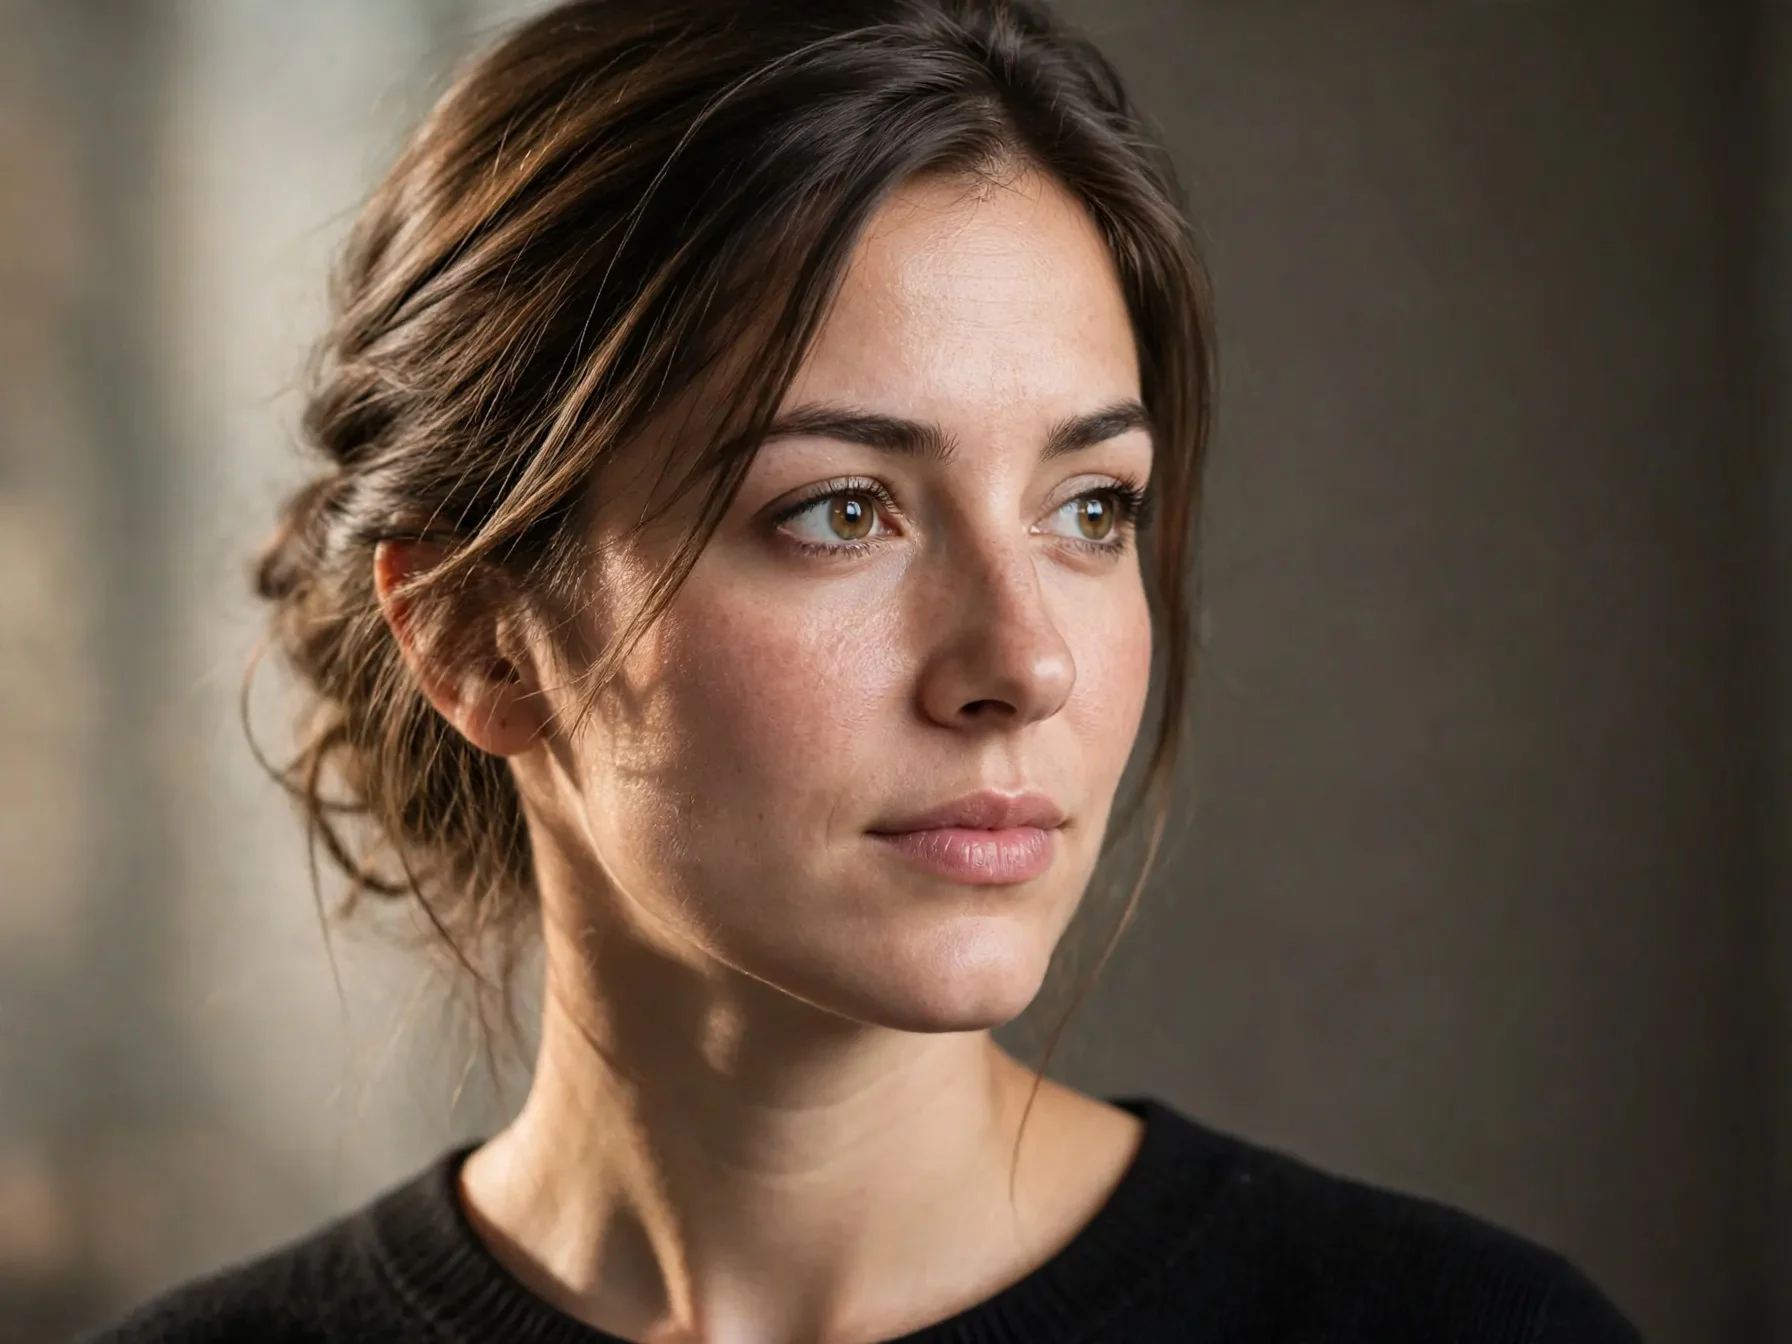
Referenzbasierte realistische und künstlerische Porträt-Neuzzeichnung
Stil Porträt und Fotografie · Stiltransfer · Fotorealistisch
Referenz-Eingaben
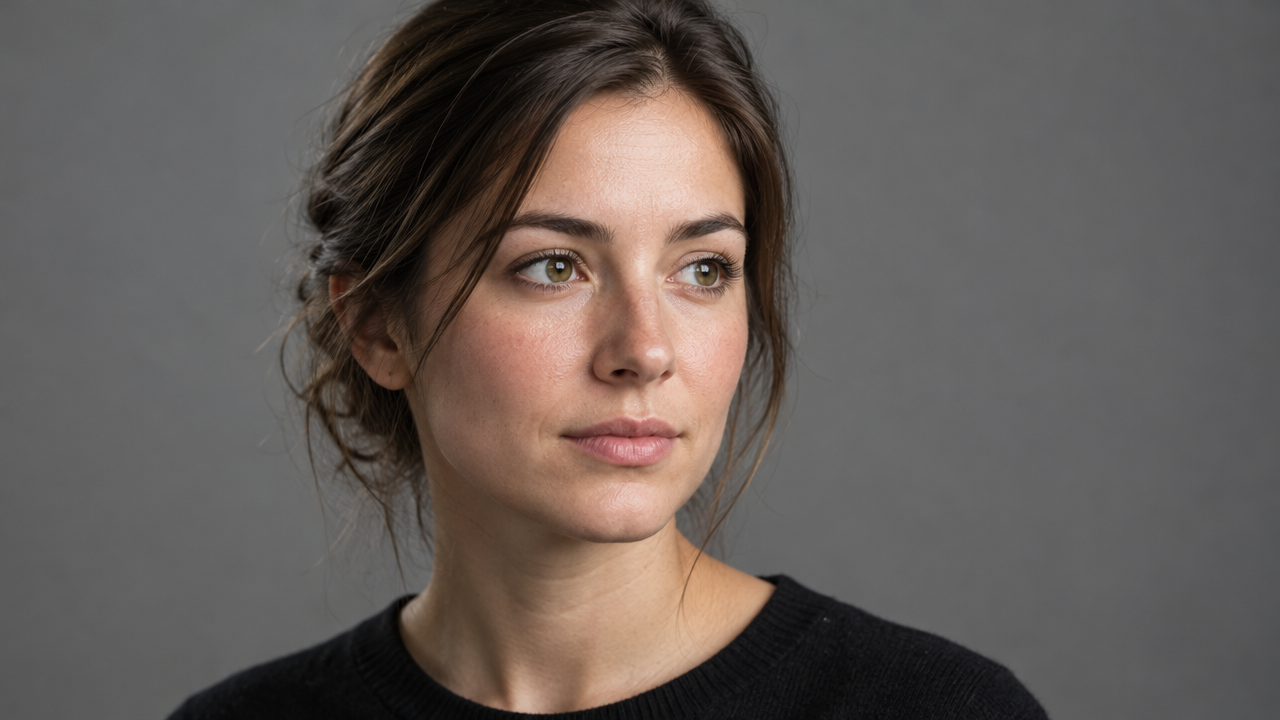
image_urls
Prompt
Bild-zu-Bild-Porträt-Neuzzeichnungsstil. Verwende das bereitgestellte Referenzfoto als einzige Quelle für Identität und Komposition der Person: Behalte dieselbe Gesichtsstruktur, denselben Frisurumriss, denselben Kopfwinkel und dieselbe Schulterhaltung bei. Rendere ein einzelnes Halbporträt im Hochformat 3:4, mit weichem gerichtetem Hauptlicht von der linken Kameraseite, das sanft in einen neutralen warmgrauen nahtlosen Hintergrund übergeht. Bewahre eine natürliche Hauttextur mit sichtbaren Poren und feinen Härchen, subtile Glanzlichter auf Wangenknochen und Nasenrücken, realistische Augen mit sichtbarem Augenlicht und lebensechte Farbtonübergänge. Zurückhaltende Farbabstimmung mit leichtem Filmkorn-Kontrast; keine Überstilisierung, keine plastische Hautretusche, keine zusätzlichen Requisiten oder Text. Geringe Schärfentiefe, scharfer Fokus auf den Augen, 85-mm-Porträtobjektiv-Effekt.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
muse-image-1.0/image-to-image per task
| Einzelpreis | $0.015 |
|---|
Positionsübersicht
muse-image-1.0/image-to-image ist ein von Meta eingeführtes, referenzbildgesteuertes Modell zur Bilderzeugung und -bearbeitung, das über die einheitliche Schnittstelle von HiAPI.ai aufgerufen wird. Es nimmt ein oder mehrere Referenzbilder als Eingabe und erzeugt zusammen mit einer Textaufforderung Bilder, ersetzt Elemente und schreibt Stile um; mehrteilige komplexe Anweisungen werden dabei zunächst zerlegt und layoutgeplant und anschließend gerendert. Es eignet sich für Entwickler, die vorhandenes Material als Basisbild verwenden und Wert auf Prompt-Treue sowie Effizienz bei der Massenproduktion legen, etwa für Materialvarianten, Produktszenenbilder und personalisierte Kompositionen.
Kernhighlights
- Generierungsprozess mit erstem Reasoning, dann Rendering – vor dem Rendern werden mehrteilige Prompts zerlegt und das Layout geplant, wodurch die Wahrscheinlichkeit sinkt, dass komplexe Anweisungen bei einem einzelnen Vorwärtsdurchlauf verworfen werden.
- Generierung und Bearbeitung in einem Modell – Referenzbildfusion und anweisungsbasierte Umformulierung benötigen keine zusätzliche Bearbeitungstoolchain, was die Anzahl der Aufrufschritte reduziert.
- Mehrere Referenzbilder pro Anfrage möglich – akzeptiert bis zu 10 Referenzbilder; im Prompt kann für jedes Bild eine Rolle als Motiv, Stil oder Kompositionselement festgelegt werden.
- Ausgabespezifikationen direkt über Parameter steuerbar – Seitenverhältnis sowie Ausgabeformat (jpeg, png, webp) lassen sich angeben, was die Anbindung an nachgelagerte Materialprozesse erleichtert.
Funktionsbeschreibung
Referenzbildgesteuerte Bildbearbeitung: Nimmt Referenzbilder plus Textaufforderung als Eingabe und ändert oder bewahrt Bildinhalte gemäß der Aufforderung – geeignet für gezielte Anpassungen an vorhandenem Material statt für die Generierung von Grund auf.
Multibild-Fusion: Eine einzelne Anfrage kann 1 bis 10 Referenzbilder enthalten, wobei im Prompt für jedes Bild eine Rolle als Motiv, Stil oder Kompositionselement angegeben wird – für Kompositionsaufgaben.
Zerlegte Ausführung komplexer Prompts: Mehrteilige Beschreibungen werden erst geplant und dann gerendert, sodass Prompts mit mehreren Motiven und Layoutanforderungen eher vollständig umgesetzt werden.
Steuerung der Ausgabespezifikationen: Unterstützt neun Seitenverhältnisse von 1:1 bis 21:9 sowie die Formate jpeg, png und webp; die Ausgabe erfolgt direkt gemäß Verbreitungs- oder Speicheranforderungen.
Anwendungsszenarien
- Werbe- und Kampagnenteams: Varianten in Serie aus vorhandenem Material erzeugen – Markenbasisbilder hochladen und gemäß Kanal-Prompt Bildinhalt und Seitenverhältnis umformulieren, um mehrere Materialsets für A/B-Tests und die Verteilung über mehrere Kanäle zu erzeugen.
- E-Commerce-Betrieb: szenische Umgestaltung von Produktbildern – Produktfotos als Referenz verwenden, per Prompt Hintergrund und Szene austauschen und Katalog- oder Szenenbilder für Produktdetailseiten ausgeben.
- Personalisierte Komposition: Nutzerfotos in neue Bilder einbetten – vom Nutzer hochgeladene Fotos als Referenzbilder für thematische Kompositionen verwenden und maßgeschneiderte Bilder für Aktionsseiten oder Social-Media-Sharing erzeugen.
Einschränkungen und Auswahlhinweise
Öffentlich zugängliche Materialien enthalten keine technischen Details zu Modellarchitektur und Ausgabauflösung; die Ergebnisse sind anhand der tatsächlichen Effekte zu bewerten. Mehrstufiges Reasoning verursacht zusätzliche Latenz und ist für Szenarien mit äußerst empfindlicher Antwortzeit nicht geeignet; die Ausgabe beschränkt sich auf Bilder, ohne Video oder Audio. Wenn die Aufgabe lediglich eine reine Text-zu-Bild-Generierung ohne Referenzbild erfordert, kann die Text-zu-Bild-Variante derselben Familie gewählt werden; wenn Videogenerierung oder geringere Latenz benötigt wird, sollten andere Modelle in Betracht gezogen werden.
Häufige Fragen
Alle Fragen ansehen →-
Wie wählt man zwischen Text-zu-Bild und Bildbearbeitung?
Wenn nur Text vorliegt und man von Null anfängt, wählt man Text-zu-Bild; wenn ein vorhandenes Motiv oder Layout beibehalten werden soll, wählt man die Bildbearbeitung und stellt ein Referenzbild bereit.
-
Wie viele Bilder erhalte ich pro Vorgang?
Jeder Auftrag liefert ein Bild; es gibt keine Auswahl der Bildanzahl. Wenn Sie eine andere Bildkomposition vergleichen möchten, passen Sie den Prompt an und reichen Sie einen neuen Auftrag ein.
-
Kann man 1K, 2K oder 4K wählen?
Dieser Einstiegspunkt bietet keine Auflösungsstufen. Das Bildformat wählst du, die Pixelabmessungen bestimmen das Modell, üblicherweise etwa 2,5 MP; maßgeblich sind die tatsächlichen Abmessungen der heruntergeladenen Datei.
-
Welche Dateiformate kann ich auswählen?
Sie können JPEG, PNG oder WebP auswählen; wenn keine Auswahl getroffen wird, wird WebP verwendet. Wählen Sie das Format je nach Bedarf für spätere Webbenutzeroberflächen-Assets oder Design-Tools.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: muse-image-1.0/image-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für muse-image-1.0/image-to-image und Route default — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 5000Text-Prompt zur Beschreibung des gewünschten Bildes oder zur Angabe, welche Inhalte in den Referenzbildern geändert und welche beibehalten werden sollen; bei Verwendung von Referenzbildern sollte darin angegeben werden, welche Rolle Subjekt, Stil oder Komposition der einzelnen Bilder spielen.
image_urlsarrayPflichtminItems 1maxItems 10Array von Referenzbildern, dessen Elemente Bildadressen sind, die als Referenzbilder für die Bild-zu-Bild-Generierung dienen; es wird empfohlen, im Prompt anzugeben, welche Rolle Subjekt, Stil oder Komposition der einzelnen Bilder spielen.
Array [ string ]
aspect_ratiostringOptionalSeitenverhältnis des Ausgabebildes; bestimmt nur das Verhältnis, nicht die exakte Pixelgröße.
1:14:33:416:99:163:22:321:9Alle anzeigen (1)
9:21output_formatstringOptionalStandard: "webp"Dateiformat des heruntergeladenen Bildes, standardmäßig webp.
jpegpngwebpcallbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/image-to-image",
  "input": {
    "prompt": "…",
    "image_urls": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/image-to-image",
input: {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/image-to-image",
"input": {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Wan 2.7 Image Alibaba $0.035 /Bild
-
 Krea 3 Krea $0.036 /Bild
-
 Seedream 5.0 ByteDance $0.025 /Bild
-
 FIBO 1.5 Bria $0.058 /Bild
-
 Nano Banana 2 Google $0.036 /Bild
-
 Qwen Image 2.0 Alibaba $0.042 /Bild
-
 Seedream 4.5 ByteDance $0.045 /Bild
-
 851 Labs Background Remover 851 Labs $0.002 /Bild
-
 Qwen Image 3.0 Alibaba $0.036 /Bild
-
 Nano Banana Google $0.021 /Bild
-
 BRIA Eraser Bria $0.058 /Bild
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /Bild