
Сравнительный обзор
gemini-4-argon: руководство по выбору и миграции — возможности API, контекст и стоимость
От возможностей интерфейса, контекста и силы рассуждения до стоимости — практическая рамка выбора модели из той же линейки

На этой странице
Сначала определим границы gemini-4-argon
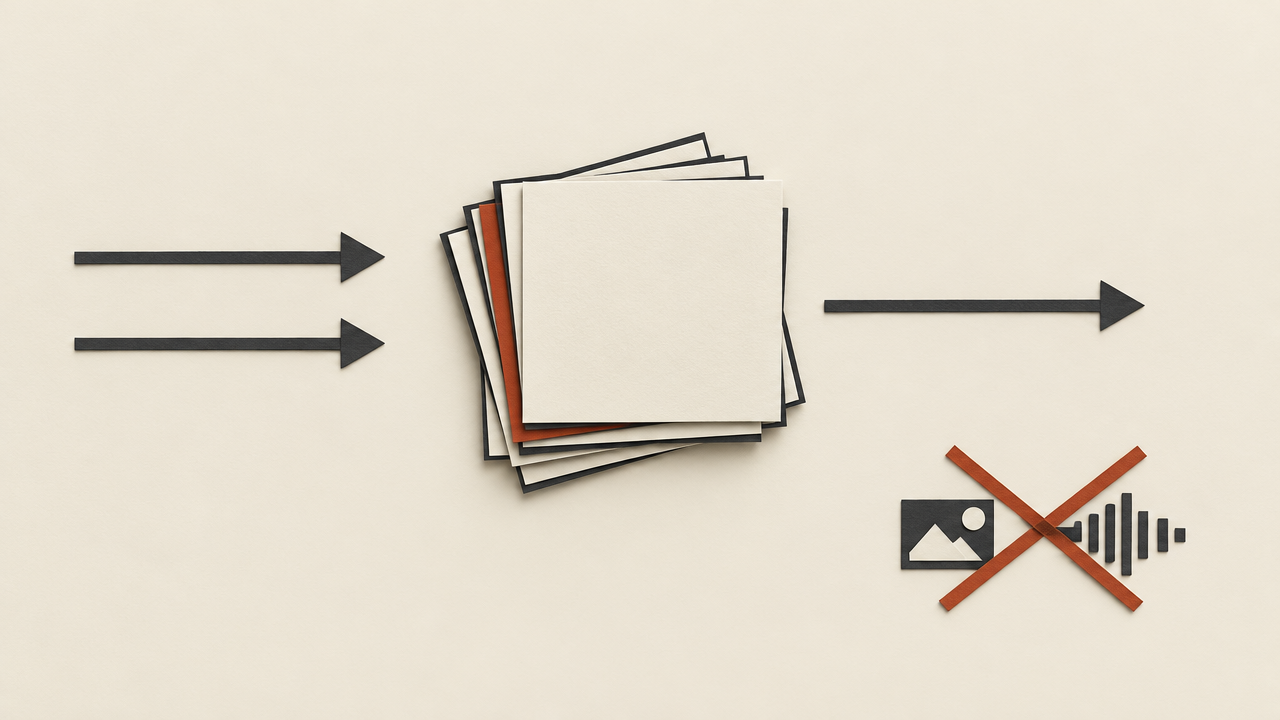
Первый шаг выбора — не смотреть, насколько модель мощна, а понять, применима ли она в вашей текущей цепочке. gemini-4-argon вызывается через интерфейс, совместимый с Chat Completions (https://api.hiapi.ai/v1/chat/completions), и поддерживает потоковый вывод; у каждой модели есть два маршрута: стандартный (имя модели без суффикса) и маршрут Vertex (имя модели с суффиксом @vertex, например gemini-4-carbon@vertex). Ввод поддерживает только текст и изображения, вывод — только текст.
Форма интерфейса: что значит совместимость с Chat Completions
Если технологический стек уже использует клиент, совместимый с Chat Completions, то подключение сводится к тому, чтобы направить base_url SDK на https://api.hiapi.ai/v1, обращаться к https://api.hiapi.ai/v1/chat/completions и выбрать имя модели. Стандартный маршрут использует имя модели без суффикса, маршрут Vertex — с суффиксом @vertex; маршруты тарифицируются отдельно, и при выборе модели это нужно включать в модель затрат. Потоковый вывод подходит для интерактивных сценариев: можно непрерывно читать приращения результатов по мере генерации.
Границы ввода: текст и изображения
Ввод поддерживает только текст и изображения. Если цепочка задействует другие модальности, перед вызовом их нужно преобразовать в текст или изображение; передавать исходный файл напрямую этому интерфейсу нельзя. Ввод изображений можно использовать для задач, требующих чтения картинок; на выходе — только текст, поэтому этапы, где нужны изображения, аудио или видео, должны обеспечиваться другими сервисами.
Границы возможностей: нет вызова инструментов и структурированного вывода
Данный интерфейс сейчас не поддерживает вызов инструментов / function calling, поиск в интернете, computer use, структурированный вывод / JSON-режим. Цепочки, которым нужны внешние инструменты, поиск в реальном времени или строгий JSON-вывод, должны организовываться на уровне приложения: ваш код выполняет инструменты и поиск, а затем передаёт результаты как текстовый ввод; структура JSON задаётся через промпт, а на уровне парсинга выполняется валидация и запасной обработчик.
Контекст и верхний предел вывода
Контекст — 1 048 576 токенов, максимальный вывод за один раз — 65 536 токенов. Задачи с длинными документами можно подавать целиком, но всё равно нужно оценивать стоимость по длине ввода и вывода; верхний предел вывода — жёсткое ограничение, слишком длинную генерацию нужно разбивать на задачи.
Быстрый метод исключения
В верхней части оценочной таблицы напишите три строки: содержит ли ввод только текст и изображения; зависит ли цепочка от вызова инструментов или JSON-режима; хватает ли контекста и верхнего предела вывода. Если какая-либо строка не проходит, помечайте gemini-4-argon как «пока не подходит» и фиксируйте причину, а не продолжайте оценку качества — это сэкономит массу времени на бесплодные пробы.
Какие измерения учитывать при сравнении
Самая частая ошибка при сравнении моделей — принимать решение по единственной оценке из публичного рейтинга. Рейтинг измеряет общие способности, а ваша система заботится о конкретных задачах, конкретном бюджете задержки и конкретных режимах отказа. Рекомендуется зафиксировать пять измерений, для каждого дать измеримый прокси-показатель.
Внутри HiAPI позиционирование трёх моделей можно сразу использовать как первый уровень отбора: Carbon — самая мощная модель линейки Gemini 4, ориентирована на самые сложные многошаговые длительные задачи; Argon подходит для большинства задач программной инженерии и интеллектуальной работы, балансируя способности и стоимость; 3.8 Flash быстрая и дешёвая, подходит для задач с высокой конкурентностью и низкой задержкой.
Качество
Не описывайте качество словами «кажется лучше», а привязывайте его к доле успешных прохождений на конкретных задачах: точность полей в задачах извлечения, матрица ошибок в задачах классификации, человеческая оценка или доля прохождения правил в задачах генерации. Качество нужно измерять на своём наборе оценки, а не ссылаться на чужие выводы.
Задержка
Различайте задержку первого токена и общее время завершения. Интерактивные сценарии (дополнение в реальном времени, диалог) чувствительны к задержке первого токена; пакетные сценарии больше заботятся о пропускной способности и общем времени. Также фиксируйте изменение задержки при длинном вводе, поскольку модель тарификации по токенам часто сопровождается падением производительности при удлинении контекста.
Стабильность
Включает долю тайм-аутов, долю ошибок, частоту срабатывания ограничений скорости, долю соответствия формата вывода. Многие проблемы «плохого эффекта» на деле вызваны случайным несоответствием формата вывода, из-за чего парсинг терпит неудачу; при высокой конкурентности такие проблемы усиливаются.
Стоимость
Стоимость нельзя смотреть только по цене за единицу — нужно смотреть на стоимость единицы бизнес-результата: сколько токенов в среднем расходуется на выполнение одной реальной задачи, какова доля повторов, нужны ли более длинные промпты для компенсации разрыва в способностях. Дешёвая модель, требующая двух повторов, на деле может обходиться дороже. Текущие цены трёх моделей следующие (доллары США / миллион токенов, ввод / кешированный ввод / вывод):
- gemini-4-carbon и gemini-4-argon: стандартный маршрут 1.00 / 0.05 / 5.00; маршрут @vertex 1.64 / 0.09 / 8.20.
- gemini-3.8-flash: стандартный маршрут 0.19 / 0.02 / 0.92; маршрут @vertex 0.62 / 0.07 / 3.08.
При выборе модели оценивайте ввод и вывод отдельно: вопрос-ответ по длинным документам в основном расходует ввод, генеративные задачи — в основном вывод.
Границы возможностей
Чётко фиксируйте, в чём модель слаба: склонна ли терять промежуточную информацию в длинных текстах, склонна ли чрезмерно разворачивать вывод, нестабильна ли на конкретном языке или терминологии предметной области. Информация о границах ценнее информации о преимуществах, потому что определяет, сколько инженерных запасных механизмов вам нужно добавить. Верхний предел контекста 1 048 576 токенов и верхний предел вывода за один раз 65 536 токенов — жёсткие границы; reasoning_effort имеет варианты low / medium / high, уровень следует выбирать на основе оценки реальных задач, а при сравнении фиксировать один и тот же уровень и затем сравнивать качество и расход токенов. Интерфейс не поддерживает вызов инструментов, поиск в интернете, computer use и структурированный вывод; цепочки, затрагивающие эти возможности, требуют доработки на уровне приложения.
Сделайте эти пять измерений фиксированным шаблоном и при каждой оценке однотипных моделей заполняйте одну и ту же таблицу — только тогда выводы будут сопоставимы.
Подбор модели по типу задачи
Разные типы задач по-разному чувствительны к модели; ниже приведены подходы к выбору для типичных текстовых задач, помогающие выбрать между Carbon, Argon и 3.8 Flash.
Извлечение и структурированное преобразование
Преобразование неструктурированного текста в JSON, сущности, значения полей. Данный интерфейс не поддерживает структурированный вывод / JSON-режим, поэтому доля соответствия формату обеспечивается ограничениями промпта и валидацией на уровне парсинга; требования к «креативности» модели низкие, к следованию инструкциям — высокие. Если основная боль текущей модели — случайный вывод лишних пояснений, из-за которого парсинг терпит неудачу, стоит включить Argon или Flash в набор кандидатов для одного раунда сравнения, но долю неудач парсинга нужно учитывать как отдельный показатель.
Классификация и маршрутизация
Определение меток, распознавание намерений, классификация контента. Задачи короткие, вызовов много; скорость и цена 3.8 Flash больше подходят для сценариев с высокой конкурентностью и низкой задержкой; если классификация требует многошагового рассуждения или более высокой точности, тогда оценивайте Argon. Таким задачам обычно не нужна частая смена модели, если только доля ошибок не стала узким местом.
Суммирование и переписывание
Длина вывода контролируема, качество можно оценить вручную. Argon подходит для большинства задач интеллектуальной работы, Carbon — для длинных текстов, требующих многошагового рассуждения; в таких задачах особенно важно следить за объёмом выходных токенов: склонна ли модель к многословию, соблюдает ли ограничения по числу слов — это напрямую определяет стоимость. При оценке используйте «долю соблюдения ограничений по длине» как отдельный показатель.
Вопрос-ответ по длинным документам
Многосоставный ввод, требуется locate ключевой информации. Контекст 1 048 576 токенов вмещает целый длинный документ, но при тарификации по токенам нужно тщательно оценивать стоимость ввода; это также типичный сценарий проверки, теряет ли модель промежуточную информацию. Рекомендуется отдельно подготовить образцы, где «ответ находится в середине документа».
Генеративные задачи (тексты, пояснения, комментарии к коду)
Оценка качества субъективна; рекомендуется использовать проверку правилами плюс выборочную ручную оценку, чтобы не делать вывод по одному примеру. Carbon ориентирована на самые сложные многошаговые длительные задачи, Argon подходит для большинства задач программной инженерии и интеллектуальной работы, 3.8 Flash — для генерации с высокой конкурентностью и низкой задержкой; если ниже по потоку есть зависимость от формата, всё равно нужно уделять особое внимание мониторингу стабильности вывода.
Принцип решения: чем более структурирована задача, чем короче вывод и строже требования к формату, тем больше подходит для сравнения с Flash или Argon; чем сложнее задача, чем больше шагов и чем больше нужен длительный многошаговый вывод, тем больше следует оценивать Carbon; цепочки, зависящие от вызова инструментов, поиска в интернете или строгого JSON-режима, требуют сначала доработки возможностей на уровне приложения.
Метод оценки стоимости при тарификации по токенам
Погрешность оценки стоимости при тарификации по токенам в основном возникает из трёх мест: замена распределения средним значением, игнорирование повторов, игнорирование раздувания промпта. Ниже — воспроизводимый процесс оценки.
Шаг первый: получить реальное распределение длин
По онлайн-логам или офлайн-образцам соберите статистику распределения длины ввода и длины вывода, как минимум смотрите P50 и P90. Среднее значение существенно занижает стоимость, поскольку небольшое число сверхдлинных запросов часто даёт большую часть расхода токенов. Если в вашем бизнесе есть случаи «несколько пользователей загружают целый документ», это нужно моделировать отдельно.
Шаг второй: выделить состав токенов каждого вызова
Общее число токенов одного вызова обычно включает: системный промпт, историю диалога или контекст, пользовательский ввод, вывод модели. Системный промпт и контекст — скрытые затраты: чем больше раундов диалога, тем больше накопленный расход. В многораундовых сценариях оценивайте по общему числу токенов сессии, а не по одному раунду.
Шаг третий: ввести коэффициент повторов и неудач
Фактический расход = расход успешных вызовов + расход, порождённый повторами. Доля повторов возникает из-за тайм-аутов, ограничений скорости, повторных запросов после несоответствия формату. Этот коэффициент часто игнорируется, но при высокой конкурентности влияние существенно. При оценке новой модели фиксируйте и её долю повторов, поскольку «более дешёвая, но более склонная к сбоям» модель может на деле обходиться дороже.
Шаг четвёртый: учесть структуру промпта
Неизменный системный промпт и фрагменты общих знаний можно размещать в начале, изменяемое содержимое — в конце; это в основном влияет на поддержку и задержку и не рассматривается как механизм снижения стоимости.
Шаг пятый: перевести в стоимость единицы бизнеса
В итоге не останавливайтесь на «сколько стоит миллион токенов», а переводите в бизнес-показатели: сколько токенов на одну сессию поддержки, сколько токенов на одну сгенерированную единицу контента, сколько токенов на одну заявку. Только цифры в бизнес-показателях можно сравнивать с доходом и затратами на персонал. Подставьте указанные выше цены ввода и вывода в своё распределение длин.
Вывод: выбор модели при тарификации по токенам по сути заключается в сравнении «объём токенов, необходимый для выполнения одного и того же бизнес-действия × цена за единицу × коэффициент повторов», а не в сравнении самой цены за единицу.
Постройте собственную небольшую оценку
Публичные рейтинги не заменят вашу оценку. Хорошая новость в том, что достаточный набор оценки не обязан быть большим; главное — фиксированность и воспроизводимость.
Построение фиксированного набора оценки
Сделайте выборку из реальных запросов, покройте интересующие вас типы задач, диапазоны длин и сценарии ввода изображений, а для каждого образца подготовьте ожидаемый результат или правила проверки. Размер выборки должен покрывать основные режимы отказа, при этом сохраняйте долгоживущий неизменный «основной набор» для сопоставления моделей и во времени.
Параллельный вызов моделей-кандидатов
Для одной и той же партии образцов с одинаковыми промптами и одинаковыми параметрами (включая уровень reasoning_effort и выбор маршрута) вызывайте модели-кандидаты (включая gemini-4-argon и существующие модели), фиксируйте вывод, время выполнения, расход токенов и сообщения об ошибках. Главное — контролировать переменные: не оптимизируйте промпт отдельно под какую-то модель, иначе сравнение теряет смысл; если нужна оптимизация, проведите отдельный раунд сравнения «лучших промптов для каждой».
Автоматизированная оценка
Что можно проверить правилами (формат, поля, длина, покрытие ключевых слов) — автоматизируйте, оставшуюся субъективную часть оценивайте вручную на малой выборке. Таблица оценки организуется по пяти измерениям выше, на выходе — сравнительная таблица, по одному баллу или доле прохождения на каждую модель и каждый пункт.
Смотрите на различия, а не на абсолютные баллы
Главное в сравнении — «на каких образцах две модели ведут себя по-разному»; проверяя расходящиеся образцы по одному, часто можно обнаружить реальные различия в границах возможностей. Именно эти расхождения — основа решения о миграции.
Фиксируйте воспроизводимую информацию
Сохраняйте версию образцов, версию промптов, параметры вызова (включая стандартный маршрут или @vertex и уровень reasoning_effort) и время. Модели обновляются, выводы устаревают; сохранение метаинформации позволяет понять при следующей переоценке, откуда взялись различия.
Небольшой, но фиксированный набор оценки гораздо ценнее, чем крупномасштабное, но невоспроизводимое «ощущение от проб».
Особенности миграции на gemini-4-argon
Сложность миграции обычно не в самом вызове, а в адаптации промптов, парсинга вывода и стратегии отказоустойчивости.
Адаптация промптов
Разные модели по-разному реагируют на инструкции: одни склонны к кратким ответам, другие — к развёрнутым пояснениям. При миграции сначала прогоните существующие промпты и зафиксируйте, какие инструкции перестали работать. Типичные корректировки: записать неявные требования как явные ограничения, разместить требования к формату вывода ближе к началу, уменьшить зависимость от «модель сама поймёт». Не переписывайте все промпты сразу — меняйте по одному и проверяйте по одному.
Парсинг вывода
Исходите из того, что вывод может содержать лишний обёрточный текст; уровень парсинга должен уметь обрабатывать ошибки: сначала попытка структурированного парсинга, при неудаче — запасное извлечение, и только при повторной неудаче — повтор. Поскольку интерфейс не поддерживает JSON-режим, долю неудач парсинга особенно важно использовать как метрику мониторинга в период миграции — она лучше самооценки модели отражает реальную пригодность.
Тайм-ауты и повторы
Заново задайте пороги тайм-аутов, не переносите конфигурацию старой модели. У повторов должны быть верхний предел и задержка (backoff), а также различение повторяемых ошибок (тайм-аут, ограничение скорости) и неповторяемых (ошибка параметров, нарушение контента). Стратегия повторов напрямую влияет на расход токенов; в период миграции её нужно включать в расчёт стоимости.
Поэтапное развёртывание и откат
Сначала небольшой объём трафика, разбитый по бизнес-измерениям (например, определённый вход, определённый тип задачи), сравните показатели новой и старой модели на одном и том же трафике. Сохраняйте путь отката: выбор модели и маршрута (стандартный или @vertex) должен быть элементом конфигурации, а не жёстко зашитым в код; при откате меняйте только конфигурацию, не код. При этом подготовьте обработку согласованности данных после отката, чтобы смешение старых и новых выводов не вызвало сбоев ниже по потоку.
Регрессионные сценарии
Зафиксируйте ключевые образцы из набора оценки как регрессионные сценарии и прогоняйте их при каждом изменении промпта или параметров. Миграция — не разовое действие; последующие обновления моделей также требуют этой регрессионной защиты.
Многоразовый чек-лист для ревью выбора модели
Приведённый ниже чек-лист используется для поочерёдного подтверждения перед запуском, а также может служить фиксированным приложением к документу о выборе модели для последующего разбора в команде.
Подтверждение границ
- Содержит ли ввод этой цепочки только текст и изображения? Преобразованы ли другие модальности перед вызовом?
- Требует ли эта цепочка вызова инструментов, поиска в интернете, computer use или структурированного вывода? Если да, доработано ли это на уровне приложения?
- Покрывают ли контекст 1 048 576 токенов и вывод 65 536 токенов за один раз реальное распределение длин?
- Подтверждён ли стандартный маршрут или @vertex, и включена ли соответствующая цена за единицу в бюджет?
Эффективность оценки
- Использован ли фиксированный набор оценки, и взяты ли образцы из распределения реальных запросов?
- Есть ли измеримые показатели по всем пяти измерениям (качество, задержка, стабильность, стоимость, границы возможностей)?
- Зафиксированы ли уровень reasoning_effort и маршрут перед сравнением?
- Проверены ли поочерёдно расходящиеся образцы с существующей моделью, и зафиксированы ли границы возможностей?
Показатели стоимости
- Оценка выполнена по распределению длин P50 и P90, а не по среднему?
- Учтены ли системный промпт, накопление контекста, повторы и коэффициент неудач?
- Использованы ли цены ввода и вывода, а не оценка только по цене ввода?
- Переведено ли в стоимость единицы бизнеса, а не остановлено на цене за токен?
Инженерная адаптация
- Проверены ли промпты на новой модели и скорректированы ли по одному?
- Есть ли у парсинга вывода путь обработки ошибок и запасной вариант?
- Заново ли заданы стратегии тайм-аутов, повторов и backoff и есть ли у них верхние пределы?
- Абстрагированы ли модель и маршрут в элементы конфигурации, чтобы при откате не требовалось менять код?
Запуск и наблюдение
- Сначала ли небольшой объём трафика с постепенным включением, определены ли окно наблюдения и метрики сравнения?
- Зафиксированы ли регрессионные сценарии, покрывающие последующие изменения промптов и параметров?
- Зафиксированы ли версия образцов, версия промптов и параметры вызова для воспроизводимости выводов?
Смысл этого чек-листа не только в предотвращении пропусков, но и в превращении вывода одного выбора модели в многоразовый актив команды: при выпуске следующей модели можно обновить только данные оценки, а не выстраивать рамку решения с нуля. Конечная точка выбора — не «какую модель выбрали», а «сформировали процесс, позволяющий постоянно делать выбор».
Похожие статьи
Все статьи →-

Сравнительный обзор
Серия Gemini 4 и выбор 3.8 Flash: интерфейс, стоимость и миграция
На основе совместимого с Chat Completions интерфейса сравниваются задачи, сила рассуждения и стоимость токенов трёх модельных линий
-

Сравнительный обзор
Как выбрать gemini-4-carbon: руководство по подбору модели по задачам, контексту, интенсивности рассуждений и стоимости
Принимайте решения по четырём измерениям: требования задачи, контекст, интенсивность рассуждений и стоимость
-

Сравнительный обзор
HiAPI vs KIE: сравнение цен по 10 моделям (ноябрь 2026)
Сравнение цен по 10 моделям плюс правила пополнения и пример недельного расхода