
比較レビュー
gemini-4-argon のモデル選定と移行ガイド:API 機能、コンテキスト、コスト
API 機能、コンテキスト、推論強度からコストまで、実行可能な同シリーズモデル選定フレームワークを提示

このページの内容
まず gemini-4-argon の境界を明確にする
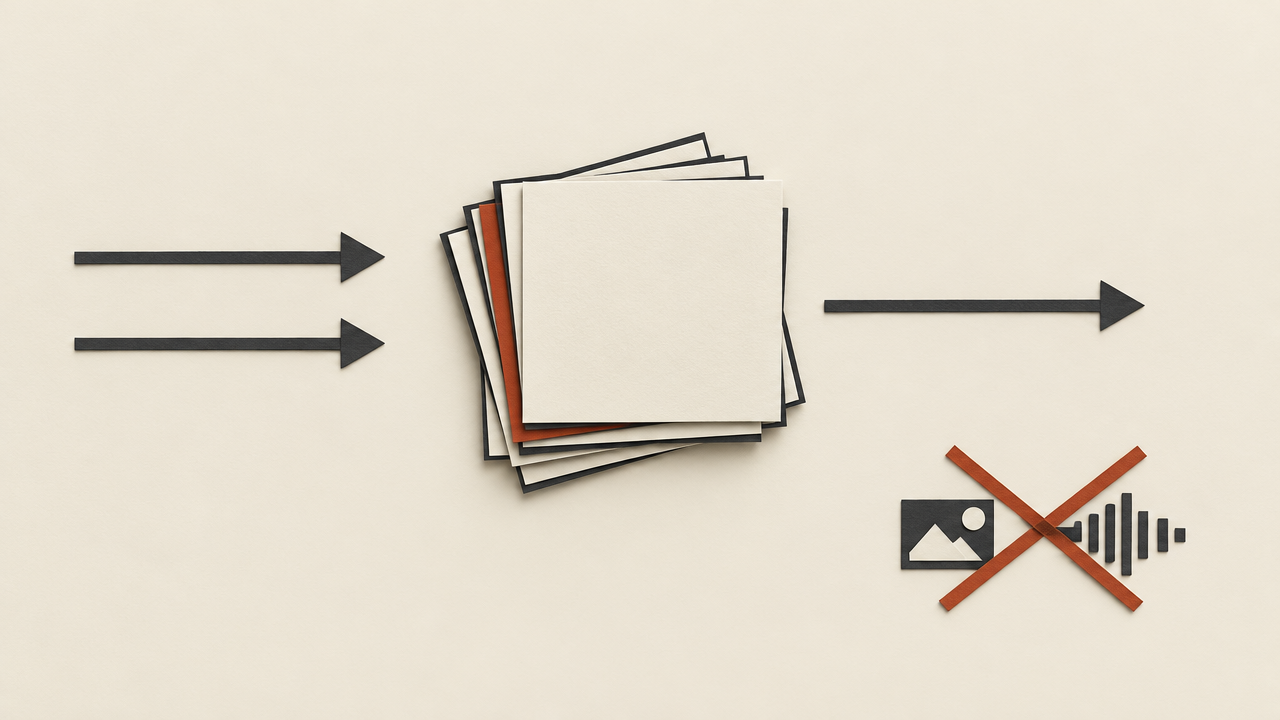
モデル選定の第一歩は、そのモデルがどれほど強力かを見ることではなく、現在の経路で使えるかどうかを見ることである。gemini-4-argon は Chat Completions 互換 API(https://api.hiapi.ai/v1/chat/completions)で呼び出され、ストリーミング出力をサポートする。各モデルには 2 系統があり、標準系統(モデル名にサフィックスなし)と Vertex 系統(モデル名に @vertex を付加、例:gemini-4-carbon@vertex)である。入力はテキストと画像のみをサポートし、出力はテキストである。
API 形態:Chat Completions 互換が意味するもの
技術スタックがすでに Chat Completions 互換クライアントを使用している場合、接続は主に SDK の base_url を https://api.hiapi.ai/v1 に設定し、https://api.hiapi.ai/v1/chat/completions をリクエストして、モデル名を選択するだけである。標準系統はサフィックスなしのモデル名を使い、Vertex 系統は @vertex サフィックスを使う。2 系統はそれぞれ課金されるため、選定時にはコストモデルに併せて組み込む必要がある。ストリーミング出力は対話型シーンに適しており、生成過程中に増分結果を継続的に読み取ることができる。
入力境界:テキストと画像
入力はテキストと画像のみをサポートする。経路が他のモダリティに関わる場合、呼び出し前にテキストまたは画像に変換する必要があり、元のファイルをそのままこの API に渡すことはできない。画像入力は画像を読む必要があるタスクに使用できる。出力側はテキストのみであるため、画像、音声、動画の成果物が必要な部分は他のサービスが担う必要がある。
機能境界:ツール呼び出しと構造化出力をサポートしない
本 API は現在、ツール呼び出し / function calling、Web 検索、computer use、構造化出力 / JSON モードをサポートしていない。外部ツール、リアルタイム検索、厳密な JSON 出力が必要な経路では、アプリケーション層で独自に編成する必要がある。ツールと検索は自分のコードで実行し、結果をテキスト入力として渡す。JSON 構造はプロンプトで制約し、解析層で検証とフォールバックを行う。
コンテキストと出力上限
コンテキストは 1,048,576 トークン、1 回あたりの最大出力は 65,536 トークンである。長文ドキュメントのタスクは全文を入れることができるが、入力と出力の長さからコストを見積もる必要がある。出力上限は厳格な制約であり、超長生成はタスクを分割する必要がある。
簡単な除外法
評価表の最上部に 3 行を書く:入力がテキストと画像のみか、経路がツール呼び出しや JSON モードに依存しているか、コンテキストと出力上限が足りるか。いずれかの行が不合格なら、gemini-4-argon を「現時点では不適用」とマークして理由を記録し、品質評価を続けない。これにより大量の無駄な試行錯誤時間を節約できる。
横断比較で見るべき次元
モデル比較で最も犯しやすい誤りは、公開ベンチマークの単一スコアで意思決定することである。ベンチマークが測るのは汎用能力であり、あなたのシステムが関心を持つのは特定タスク、特定のレイテンシ予算、特定の失敗モードでの性能である。5 つの次元を固定し、各次元に測定可能な代理指標を設けることを推奨する。
HiAPI 内部では、3 モデルの位置づけを第一層のスクリーニングとして直接利用できる。Carbon は Gemini 4 シリーズ最強のモデルで、最も複雑な多段階・長周期タスク向け。Argon は大多数のソフトウェアエンジニアリングと知識作業に適し、能力とコストのバランスが良い。3.8 Flash は高速で低価格、高並列・低レイテンシのタスクに適する。
品質
品質を「感覚的に良い」で表現せず、具体的タスクでの通過率に落とし込む。抽出タスクのフィールド精度、分類タスクの混同行列、生成タスクの人手評価またはルール検証通過率などである。品質は自分の評価セットで測定する必要があり、他人の結論を引用してはならない。
レイテンシ
初回トークンレイテンシと全体完了時間を区別する。対話型シーン(リアルタイム補完、会話)は初回トークンレイテンシに敏感で、バッチ処理シーンはスループットと総所要時間をより重視する。同時に長入力下でのレイテンシ変化を記録する。トークン課金モデルはコンテキストが長くなると性能劣化を伴うことが多いためである。
安定性
タイムアウト率、エラー率、レート制限の発動頻度、出力フォーマットの準拠率を含む。「効果が悪い」問題の多くは、実は出力フォーマットが偶発的に非準拠となり解析失敗するものであり、こうした問題は高並列下で増幅される。
コスト
コストは単価だけでなく、単位業務あたりのコストを見る。1 回の実タスク完了に平均どれだけトークンを消費するか、リトライ率はどれだけか、能力差を補うためにより長いプロンプトが必要か。安価でも 2 回リトライが必要なモデルは、実コストが高くなる可能性がある。現在の 3 モデルの価格は以下の通り(米ドル / 百万トークン、入力 / キャッシュ入力 / 出力):
- gemini-4-carbon と gemini-4-argon:標準系統 1.00 / 0.05 / 5.00、@vertex 系統 1.64 / 0.09 / 8.20。
- gemini-3.8-flash:標準系統 0.19 / 0.02 / 0.92、@vertex 系統 0.62 / 0.07 / 3.08。
選定時には入力と出力を分けて見積もる。長文ドキュメント Q&A は主に入力を消費し、生成系タスクは主に出力を消費する。
機能境界
モデルが何を得意としないかを明確に記録する。長文で中間情報を見失いやすいか、出力を過度に拡張する傾向があるか、特定の言語やドメイン語彙で不安定か。境界情報は優位性情報よりも意思決定価値が高い。なぜなら、どれだけのエンジニアリングフォールバックが必要かを決めるからである。コンテキスト上限 1,048,576 トークン、1 回の出力上限 65,536 トークンは厳格な境界である。reasoning_effort は low / medium / high から選択でき、段階は実際のタスク評価に基づいて選ぶべきで、比較時には同一段階に固定してから品質とトークン消費を比較する。API はツール呼び出し、Web 検索、computer use、構造化出力をサポートしないため、これらに関わる経路はアプリケーション層で補完する必要がある。
これら 5 次元を固定テンプレートにし、同類モデルを評価するたびに同じ表を埋めることで、結論に比較可能性が生まれる。
タスクタイプ別のモデルマッチング
タスクタイプごとにモデルの敏感な点は異なる。以下では一般的なテキストタスク別に判断の考え方を示し、Carbon、Argon、3.8 Flash の間での選択を支援する。
抽出と構造化変換
非構造化テキストを JSON、エンティティ、フィールド値に変換する。本 API は構造化出力 / JSON モードをサポートしないため、フォーマット準拠率はプロンプト制約と解析層の検証で担保する必要があり、モデルの「創造性」への要求は低く、指示遵守への要求は高い。現在のモデルの主な課題が時折余計な説明を出力して解析失敗することなら、Argon や Flash を候補セットに入れて 1 回比較する価値があるが、解析失敗率を独立指標にする必要がある。
分類とルーティング
ラベル判定、意図認識、コンテンツ分類。タスクは短く呼び出し量が多いため、3.8 Flash の速度と価格は高並列・低レイテンシシーンに適する。分類に多段推論が必要か精度要求が高い場合は、Argon を評価する。こうしたタスクは通常、エラー率がボトルネックにならない限り、頻繁なモデル変更は不要である。
要約と書き換え
出力長は制御可能で、品質は人手評価できる。Argon は大多数の知識作業に適し、Carbon は多段推論が必要な長文タスクに使う。こうしたタスクでは出力トークン量に特に注意する。モデルが冗長になりやすいか、文字数制約を守れるかがコストを直接左右する。評価時には「長さ制約を満たす割合」を独立指標にする。
長文ドキュメント Q&A
複数段落の入力で、重要情報を特定する必要がある。1,048,576 トークンのコンテキストは長文ドキュメント全体を収容できるが、トークン課金下では入力コストを精密に見積もる必要があり、モデルが中間情報を見失うかを検証する典型シーンでもある。「答えがドキュメント中央部にある」サンプルを別途用意することを推奨する。
生成系タスク(コピー、説明、コードコメント)
品質評価は主観寄りであるため、ルール検証とサンプリング人手評価を組み合わせ、単一サンプルで結論を出さないようにする。Carbon は最も複雑な多段階・長周期タスク向け、Argon は大多数のソフトウェアエンジニアリングと知識作業に適し、3.8 Flash は高並列・低レイテンシの生成に適する。下流にフォーマット依存がある場合、出力安定性の重点監視は依然として必要である。
判断原則:タスクが構造化されているほど、出力が短いほど、フォーマット要求が厳しいほど、Flash や Argon での比較が適する。タスクが複雑でステップが多く、長周期推論が必要なほど、Carbon を評価すべきである。ツール呼び出し、Web 検索、厳密な JSON モードに依存する経路は、まずアプリケーション層で機能を補完する必要がある。
トークン課金のコスト見積もり方法
トークン課金のコスト見積もりで、誤差は主に 3 つの場所から生じる。平均値で分布を代替すること、リトライを無視すること、プロンプト膨張を無視することである。以下は再利用可能な見積もりプロセスである。
ステップ 1:実際の長さ分布を取得する
オンラインログまたはオフラインサンプルから入力長と出力長の分布を統計し、少なくとも P50 と P90 を見る。平均値はコストを著しく過小評価する。少数の超長リクエストがほとんどのトークン消費を占めることが多いためである。業務に「少数のユーザーがドキュメント全体をアップロードする」ケースがある場合、別途モデル化する必要がある。
ステップ 2:呼び出しごとのトークン構成を分解する
1 回の呼び出しの総トークンは通常、システムプロンプト、会話履歴またはコンテキスト、ユーザー入力、モデル出力を含む。このうちシステムプロンプトとコンテキストは隠れたコストであり、会話ターンが増えるほど累積消費が大きくなる。マルチターンシーンでは単一ターンではなくセッション総トークンで見積もる。
ステップ 3:リトライと失敗係数を導入する
実消費 = 成功呼び出し消費 + リトライによる消費。リトライ率はタイムアウト、レート制限、フォーマット非準拠後の再リクエストから生じる。この係数は見落とされがちだが、高並列下では影響が顕著である。新モデルを評価する際にはそのリトライ率も記録する。なぜなら「より安価だが失敗しやすい」モデルは実コストが高くなる可能性があるからである。
ステップ 4:プロンプト構造を考慮する
固定不変のシステムプロンプトや共通知識断片は前方に置き、可変内容は後方に置く。これは主に保守とレイテンシに影響し、コスト削減の仕組みとしては扱わない。
ステップ 5:単位業務コストに換算する
最終的には「百万トークンあたりいくらか」に留まらず、業務単位に換算する。1 回のカスタマーサポート会話あたり何トークン、1 本の生成コンテンツあたり何トークン、1 件のチケットあたり何トークンなどである。業務単位の数字だけが、収益や人件費と並べて比較できる。上記の入力・出力単価を自分の長さ分布に代入すればよい。
結論:トークン課金下での選定は、本質的に「同一業務アクションの完了に必要なトークン量 × 単価 × リトライ係数」を比較することであり、単価そのものを比較することではない。
自分だけの小規模評価を構築する
公開ベンチマークは自分の評価の代替にはならない。幸いなことに、十分に使える評価セットは大きくなくてよく、鍵は固定と再現可能性である。
固定評価セットの構築
実際のリクエストからサンプリングし、関心のあるタスクタイプ、長さ区間、画像入力シーンをカバーし、各サンプルに期待結果または検証ルールを用意する。サンプル規模は主要な失敗モードをカバーできることを基準とし、同時に長期間不変の「コアセット」を保持し、モデル横断・時間横断の比較に使う。
候補モデルの並列呼び出し
同一サンプル群に対し、同じプロンプト、同じパラメータ(reasoning_effort 段階と系統選択を含む)で、候補モデル(gemini-4-argon と既存モデルを含む)をそれぞれ呼び出し、出力、所要時間、トークン使用量、エラー情報を記録する。鍵は変数の制御である。プロンプトを特定モデル向けに個別最適化してはならない。さもなければ比較の意味が失われる。最適化が必要なら、「それぞれ最適プロンプト」の比較を別途 1 回行う。
自動スコアリング
ルール検証できるもの(フォーマット、フィールド、長さ、キーワード網羅)は自動化し、残りの主観部分は小サンプルの人手評価を行う。評価表は前述の 5 次元で構成し、比較表を出力し、各モデル各項目にスコアまたは通過率を付ける。
絶対スコアではなく差異を見る
比較の重点は「どのサンプルで 2 モデルの挙動が異なるか」であり、分歧サンプルを 1 件ずつ確認すると、能力境界の真の差異を発見できることが多い。これらの分歧点こそが移行判断の根拠である。
再現可能な情報の記録
サンプルバージョン、プロンプトバージョン、呼び出しパラメータ(標準または @vertex 系統、reasoning_effort 段階を含む)と時刻を保存する。モデルは更新され、結論も陳腐化する。メタ情報を保持してこそ、次回再評価時に差異がどこから来たかを知ることができる。
小規模でも固定された評価セットの価値は、大規模でも再現不可能な「試用感」をはるかに上回る。
gemini-4-argon への移行時の注意点
移行の複雑さは通常、呼び出し自体ではなく、プロンプト、出力解析、フォールトトレランス戦略の適応にある。
プロンプト適応
モデルによって指示への応答スタイルは異なる。簡潔な回答を好むものもあれば、展開説明を好むものもある。移行時にはまず既存プロンプトを実行し、どの指示が無効になったかを記録する。一般的な調整には、暗黙の要求を明示的制約として書く、出力フォーマット要求をより前方に置く、「モデルが自分で理解する」への依存を減らす、などがある。すべてのプロンプトを一度に書き直さず、1 条ずつ変更し 1 条ずつ検証する。
出力解析
出力に余計な包装テキストが付く可能性を前提とし、解析層はフォールトトレラントであるべきである。まず構造化解析を試み、失敗したらフォールバック抽出を行い、それでも失敗した場合にのみリトライする。API が JSON モードをサポートしないため、解析失敗率は特に移行期間の監視指標とすべきであり、モデルの自己評価よりも実際の可用性を反映する。
タイムアウトとリトライ
タイムアウト閾値を再設定し、旧モデルの設定を流用しない。リトライには上限とバックオフを設け、リトライ可能エラー(タイムアウト、レート制限)とリトライ不可エラー(パラメータエラー、コンテンツ違反)を区別する。リトライ戦略はトークン消費に直接影響するため、移行評価期間中にコスト試算へ組み込む必要がある。
カナリアとロールバック
まず小トラフィックでカナリアを行い、業務次元(例:特定の入口、特定のタスク種別)で分割し、新旧モデルを同一トラフィック上で指標比較する。ロールバック経路を保持する。モデル選択と系統(標準または @vertex)はハードコードではなく設定項目とすべきで、ロールバック時はコードを変えず設定のみ変更する。同時にロールバック後のデータ整合性処理を準備し、新旧出力が混在して下流異常を引き起こさないようにする。
回帰ケース
評価セットのコアサンプルを回帰ケースとして固定化し、プロンプトやパラメータの変更ごとに実行する。移行は一度きりの動作ではなく、その後のモデル更新にも同じ回帰保護が必要である。
再利用可能な選定レビューチェックリスト
以下のチェックリストはリリース前に項目ごとに確認するために使い、選定ドキュメントの固定付録としてチームの振り返りにも利用できる。
境界確認
- その経路の入力はテキストと画像のみか?他のモダリティは呼び出し前に変換済みか?
- その経路はツール呼び出し、Web 検索、computer use、構造化出力を必要とするか?必要ならアプリケーション層で補完済みか?
- コンテキスト 1,048,576 トークンと 1 回の出力 65,536 トークンは実際の長さ分布をカバーするか?
- 標準系統または @vertex 系統を確認し、対応する単価を予算に組み込んだか?
評価の有効性
- 固定評価セットを使用し、サンプルは実際のリクエスト分布から取得したか?
- 5 次元(品質、レイテンシ、安定性、コスト、機能境界)のすべてに測定可能な指標があるか?
- reasoning_effort 段階と系統を固定してから比較したか?
- 既存モデルとの分歧サンプルを 1 件ずつ確認し、能力境界を記録したか?
コスト基準
- 平均値ではなく P50 と P90 の長さ分布に基づいて見積もったか?
- システムプロンプト、コンテキスト累積、リトライ、失敗係数を計上したか?
- 入力単価のみでなく、入力と出力の単価を使用したか?
- トークン単価に留まらず、単位業務コストに換算したか?
エンジニアリング適応
- プロンプトは新モデルで検証し、1 条ずつ調整済みか?
- 出力解析にフォールトトレランスとフォールバック経路があるか?
- タイムアウト、リトライ、バックオフ戦略を再設定し、上限を設けたか?
- モデルと系統を設定項目として抽象化し、ロールバック時にコード変更が不要か?
リリースと観測
- まず小トラフィックでカナリアを行い、観測ウィンドウと比較指標を定義したか?
- 回帰ケースを固定化し、その後のプロンプトとパラメータ変更をカバーしたか?
- サンプルバージョン、プロンプトバージョン、呼び出しパラメータを記録し、結論の再現性を確保したか?
このチェックリストの意義は見落としを防ぐだけでなく、1 回の選定結論をチームが再利用できる資産に変えることにある。次のモデルがリリースされたとき、判断フレームワークをゼロから再構築する必要はなく、評価データを更新するだけでよい。選定の終点は「どのモデルを選んだか」ではなく、「継続的に選択できるプロセスを形成したか」である。


