
Comparatif et évaluation
Guide de sélection et de migration de gemini-4-argon : capacités de l'API, contexte et coûts
De l'API, du contexte et de l'intensité de raisonnement jusqu'au coût, un cadre de sélection applicable pour les modèles d'une même série

Sur cette page
Délimiter d'abord le périmètre de gemini-4-argon
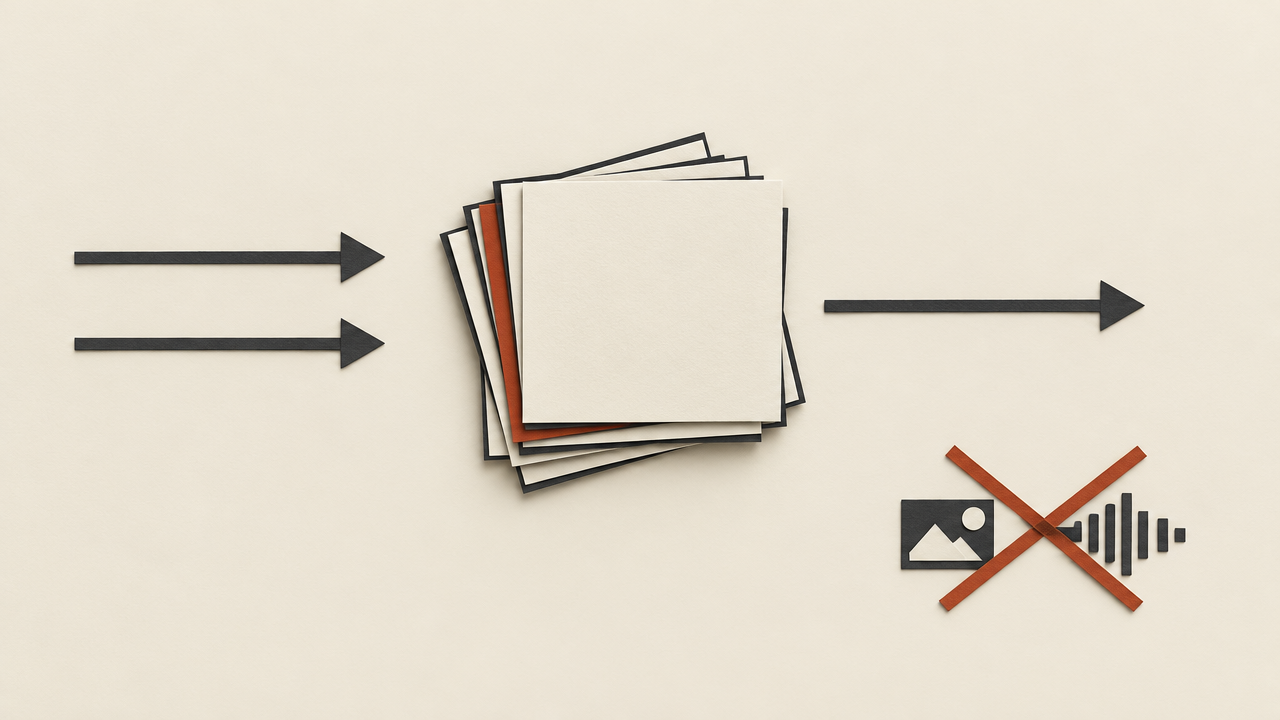
La première étape de la sélection n'est pas de voir à quel point il est puissant, mais s'il peut s'insérer dans votre chaîne actuelle. gemini-4-argon est appelé via l'interface compatible Chat Completions (https://api.hiapi.ai/v1/chat/completions) et prend en charge la sortie en streaming ; chaque modèle dispose de deux voies : la voie standard (nom de modèle sans suffixe) et la voie Vertex (nom de modèle avec @vertex, par exemple gemini-4-carbon@vertex). L'entrée ne prend en charge que le texte et l'image, la sortie est du texte.
Forme de l'API : ce que signifie la compatibilité Chat Completions
Si votre stack technique utilise déjà un client compatible Chat Completions, l'intégration consiste principalement à pointer le base_url du SDK vers https://api.hiapi.ai/v1, à appeler https://api.hiapi.ai/v1/chat/completions et à choisir le nom du modèle. La voie standard utilise le nom de modèle sans suffixe, la voie Vertex utilise le suffixe @vertex ; les deux voies sont facturées séparément et doivent toutes deux être intégrées au modèle de coûts lors de la sélection. La sortie en streaming convient aux scénarios interactifs, permettant de lire en continu les résultats incrémentaux pendant la génération.
Frontière des entrées : texte et image
L'entrée ne prend en charge que le texte et l'image. Si la chaîne implique d'autres modalités, elles doivent être converties en texte ou en image avant l'appel, et non transmises telles quelles à cette interface. L'entrée image peut servir aux tâches nécessitant la lecture d'images ; côté sortie, seuls du texte est produit, donc les étapes nécessitant des images, de l'audio ou de la vidéo doivent être prises en charge par d'autres services.
Frontière des capacités : pas d'appel d'outils ni de sortie structurée
Cette interface ne prend actuellement pas en charge l'appel d'outils / function calling, la recherche en ligne, le computer use, la sortie structurée / mode JSON. Les chaînes nécessitant des outils externes, une récupération en temps réel ou une sortie JSON stricte doivent être orchestrées au niveau applicatif : votre code exécute les outils et la recherche, puis transmet les résultats comme entrée texte ; la structure JSON est contrainte par le prompt et validée avec un mécanisme de secours au niveau de l'analyseur.
Contexte et plafond de sortie
Le contexte est de 1 048 576 tokens, la sortie maximale par appel est de 65 536 tokens. Les tâches sur documents longs peuvent placer l'intégralité du document, mais il faut toujours estimer le coût selon la longueur d'entrée et de sortie ; le plafond de sortie est une contrainte stricte, les générations trop longues doivent être découpées en tâches.
Une méthode d'exclusion rapide
Écrivez trois lignes en haut du tableau d'évaluation : l'entrée est-elle uniquement du texte et de l'image, la chaîne dépend-elle d'un appel d'outils ou du mode JSON, le contexte et le plafond de sortie sont-ils suffisants. Si une ligne échoue, marquez gemini-4-argon comme « non applicable pour l'instant » et consignez la raison, au lieu de poursuivre l'évaluation de qualité — cela permet d'économiser beaucoup de temps d'essais infructueux.
Quelles dimensions examiner dans une comparaison transversale
L'erreur la plus fréquente dans la comparaison de modèles est de décider à partir d'un score unique d'un classement public. Un classement mesure des capacités générales, alors que votre système se soucie de la performance sur des tâches spécifiques, un budget de latence spécifique, des modes de défaillance spécifiques. Nous recommandons de fixer cinq dimensions, chacune avec un indicateur proxy mesurable.
En interne chez HiAPI, le positionnement des trois modèles peut servir directement de premier filtre : Carbon est le modèle le plus puissant de la série Gemini 4, destiné aux tâches multi-étapes les plus complexes et de longue durée ; Argon convient à la plupart des travaux d'ingénierie logicielle et de travail intellectuel, avec un équilibre entre capacité et coût ; 3.8 Flash est rapide et bon marché, adapté aux tâches à forte concurrence et faible latence.
Qualité
Ne décrivez pas la qualité par « meilleure sensation », mais par le taux de réussite sur des tâches concrètes : précision des champs pour les tâches d'extraction, matrice de confusion pour les tâches de classification, score humain ou taux de validation par règles pour les tâches de génération. La qualité doit être mesurée sur votre propre jeu d'évaluation, et non en citant les conclusions d'autrui.
Latence
Distinguez la latence du premier token du temps d'achèvement global. Les scénarios interactifs (autocomplétion en temps réel, conversation) sont sensibles à la latence du premier token ; les scénarios par lots se soucient davantage du débit et du temps total. Enregistrez aussi l'évolution de la latence avec des entrées longues, car les modèles de facturation au token s'accompagnent souvent d'une dégradation des performances lorsque le contexte s'allonge.
Stabilité
Cela inclut le taux de dépassement de délai, le taux d'erreur, la fréquence de déclenchement de la limitation de débit, le taux de conformité du format de sortie. Beaucoup de problèmes de « mauvais résultats » sont en réalité dus à une non-conformité intermittente du format de sortie provoquant un échec d'analyse, et ces problèmes sont amplifiés à forte concurrence.
Coût
Le coût ne se limite pas au prix unitaire, il faut considérer le coût par unité de production métier : combien de tokens en moyenne pour accomplir une tâche réelle, quel taux de nouvelle tentative, faut-il des prompts plus longs pour compenser l'écart de capacité. Un modèle bon marché mais nécessitant deux nouvelles tentatives peut avoir un coût réel plus élevé. Les prix actuels des trois modèles sont les suivants (USD / million de tokens, entrée / entrée en cache / sortie) :
- gemini-4-carbon et gemini-4-argon : voie standard 1,00 / 0,05 / 5,00 ; voie @vertex 1,64 / 0,09 / 8,20.
- gemini-3.8-flash : voie standard 0,19 / 0,02 / 0,92 ; voie @vertex 0,62 / 0,07 / 3,08.
Lors de la sélection, estimez séparément l'entrée et la sortie : les questions-réponses sur documents longs consomment principalement de l'entrée, les tâches de génération principalement de la sortie.
Frontière des capacités
Consignez clairement ce que le modèle ne sait pas bien faire : perd-il facilement les informations intermédiaires dans un texte long, a-t-il tendance à trop développer la sortie, est-il instable sur certaines langues ou vocabulaires de domaine. Les informations de frontière ont plus de valeur décisionnelle que les informations d'avantage, car elles déterminent combien de mécanismes de secours d'ingénierie vous devez ajouter. Le contexte maximal de 1 048 576 tokens et la sortie maximale de 65 536 tokens par appel sont des frontières strictes ; reasoning_effort propose low / medium / high, le niveau doit être choisi en fonction de l'évaluation réelle de la tâche, et il faut fixer le même niveau pour comparer qualité et consommation de tokens. L'interface ne prend pas en charge l'appel d'outils, la recherche en ligne, le computer use ni la sortie structurée, les chaînes impliquant ces capacités doivent être complétées au niveau applicatif.
Faites de ces cinq dimensions un modèle fixe, et remplissez le même tableau à chaque évaluation de modèles similaires, pour que les conclusions soient comparables.
Faire correspondre les modèles aux types de tâches
Différents types de tâches n'ont pas les mêmes points sensibles pour les modèles ; voici une démarche de jugement pour les tâches textuelles courantes, afin d'aider à choisir entre Carbon, Argon et 3.8 Flash.
Extraction et conversion structurée
Transformer du texte non structuré en JSON, en entités, en valeurs de champs. Cette interface ne prend pas en charge la sortie structurée / le mode JSON, donc le taux de conformité du format doit être garanti par les contraintes du prompt et la validation de l'analyseur ; elle demande peu de « créativité » au modèle et beaucoup au respect des instructions. Si le principal point faible du modèle actuel est d'output parfois des explications superflues provoquant des échecs d'analyse, il vaut la peine d'inclure Argon ou Flash dans un cycle de comparaison, mais en faisant du taux d'échec d'analyse un indicateur indépendant.
Classification et routage
Détermination d'étiquettes, reconnaissance d'intention, classification de contenu. La tâche est courte et le volume d'appels élevé, la vitesse et le prix de 3.8 Flash conviennent mieux aux scénarios à forte concurrence et faible latence ; si la classification nécessite un raisonnement multi-étapes ou exige une précision plus élevée, évaluez alors Argon. Ces tâches ne nécessitent généralement pas de changer fréquemment de modèle, sauf si le taux d'erreur devient un goulot d'étranglement.
Résumé et reformulation
La longueur de sortie est contrôlable et la qualité peut être évaluée manuellement. Argon convient à la plupart des travaux de connaissance, Carbon aux tâches sur textes longs nécessitant un raisonnement multi-étapes ; pour ces tâches, il faut particulièrement surveiller le volume de tokens de sortie : la tendance du modèle à être verbeux et sa capacité à respecter les contraintes de longueur déterminent directement le coût. Lors de l'évaluation, faites de la « proportion de réponses respectant la contrainte de longueur » un indicateur indépendant.
Questions-réponses sur documents longs
Entrée en plusieurs segments, nécessité de localiser les informations clés. Le contexte de 1 048 576 tokens peut contenir un document long entier, mais sous une facturation au token, il faut estimer finement le coût d'entrée ; c'est aussi un scénario typique pour tester si le modèle perd des informations intermédiaires. Il est recommandé de préparer séparément des échantillons où « la réponse se trouve au milieu du document ».
Tâches de génération (textes, explications, commentaires de code)
L'évaluation de la qualité est plutôt subjective ; il est recommandé de combiner validation par règles et notation humaine par échantillonnage, pour éviter de conclure à partir d'un seul exemple. Carbon est destiné aux tâches multi-étapes les plus complexes et de longue durée, Argon convient à la plupart des travaux d'ingénierie logicielle et de connaissance, 3.8 Flash convient à la génération à forte concurrence et faible latence ; si l'aval dépend d'un format, il faut surveiller particulièrement la stabilité de la sortie.
Principe de décision : plus la tâche est structurée, la sortie courte, et les exigences de format strictes, plus il convient d'utiliser Flash ou Argon pour la comparaison ; plus la tâche est complexe, comporte d'étapes et nécessite un raisonnement de longue durée, plus il faut évaluer Carbon ; les chaînes dépendant de l'appel d'outils, de la recherche en ligne ou d'un mode JSON strict doivent d'abord compléter les capacités au niveau applicatif.
Méthode d'estimation des coûts avec facturation au token
Dans l'estimation des coûts à la facturation au token, l'erreur provient principalement de trois sources : remplacer une distribution par une moyenne, ignorer les nouvelles tentatives, ignorer l'expansion des prompts. Voici une procédure d'estimation réutilisable.
Première étape : obtenir la distribution réelle des longueurs
À partir des journaux en ligne ou des échantillons hors ligne, comptez la distribution des longueurs d'entrée et de sortie, en regardant au moins P50 et P90. La moyenne sous-estime gravement le coût, car un petit nombre de requêtes très longues contribue souvent à la majeure partie de la consommation de tokens. Si votre activité comporte des cas où « quelques utilisateurs téléversent le document complet », il faut les modéliser séparément.
Deuxième étape : décomposer la composition des tokens par appel
Le total de tokens d'un appel comprend généralement : le prompt système, l'historique de conversation ou le contexte, l'entrée utilisateur, la sortie du modèle. Le prompt système et le contexte sont des coûts cachés — plus il y a de tours de conversation, plus la consommation cumulée est élevée. Dans un scénario multi-tours, estimez selon le total de tokens de la session, et non par tour individuel.
Troisième étape : introduire les coefficients de nouvelle tentative et d'échec
Consommation réelle = consommation des appels réussis + consommation due aux nouvelles tentatives. Le taux de nouvelle tentative provient des redemandes après dépassement de délai, limitation de débit ou non-conformité de format. Ce coefficient est souvent négligé, mais son impact est significatif à forte concurrence. Lors de l'évaluation d'un nouveau modèle, enregistrez aussi son taux de nouvelle tentative, car un modèle « moins cher mais plus sujet aux échecs » peut avoir un coût réel plus élevé.
Quatrième étape : considérer la structure du prompt
Le prompt système invariable et les segments de connaissances communes peuvent être placés en tête, le contenu variable en queue ; cela affecte principalement la maintenance et la latence, et ne doit pas être considéré comme un mécanisme de réduction des coûts.
Cinquième étape : convertir en coût unitaire métier
Au final, ne restez pas au « combien coûte un million de tokens », mais convertissez en unité métier : combien de tokens par session de service client, combien de tokens par contenu généré, combien de tokens par ticket. Seuls les chiffres en unité métier peuvent être comparés aux revenus et aux coûts de main-d'œuvre. Il suffit d'appliquer les prix d'entrée et de sortie ci-dessus à votre propre distribution de longueurs.
Conclusion : la sélection sous facturation au token consiste essentiellement à comparer « le volume de tokens nécessaire × le prix unitaire × le coefficient de nouvelle tentative » pour accomplir la même action métier, et non à comparer les prix unitaires eux-mêmes.
Construire votre propre petite évaluation
Les classements publics ne peuvent pas remplacer votre évaluation. La bonne nouvelle, c'est qu'un jeu d'évaluation suffisant n'a pas besoin d'être très grand ; l'essentiel est qu'il soit fixe et reproductible.
Construire un jeu d'évaluation fixe
Échantillonnez à partir des requêtes réelles, en couvrant les types de tâches, les plages de longueur et les scénarios d'entrée image qui vous intéressent, et préparez pour chaque échantillon le résultat attendu ou une règle de validation. La taille de l'échantillon doit être suffisante pour couvrir les principaux modes de défaillance, tout en conservant un « noyau » stable à long terme, pour les comparaisons transversales entre modèles et dans le temps.
Appeler les modèles candidats en parallèle
Sur le même lot d'échantillons, avec les mêmes prompts et les mêmes paramètres (y compris le niveau reasoning_effort et le choix de la voie), appelez séparément les modèles candidats (y compris gemini-4-argon et les modèles existants), en enregistrant la sortie, la durée, la consommation de tokens et les informations d'erreur. L'essentiel est de contrôler les variables : ne pas optimiser les prompts séparément pour chaque modèle, sinon la comparaison perd son sens ; si nécessaire, faites un cycle séparé de comparaison « prompt optimal pour chacun ».
Notation automatisée
Ce qui peut être validé par règles (format, champs, longueur, couverture des mots-clés) doit être automatisé, le reste subjectif fait l'objet d'une notation humaine sur un petit échantillon. La grille de notation est organisée selon les cinq dimensions précédentes, produisant un tableau comparatif, avec pour chaque modèle une note ou un taux de réussite par critère.
Regarder les différences plutôt que les scores absolus
L'intérêt de la comparaison est de voir « sur quels échantillons les deux modèles diffèrent » ; examiner un par un les échantillons divergents permet souvent de découvrir les vraies différences de frontière des capacités. Ces points de divergence sont précisément la base de la décision de migration.
Enregistrer les informations reproductibles
Conservez la version des échantillons, la version des prompts, les paramètres d'appel (y compris la voie standard ou @vertex, le niveau reasoning_effort) et la date. Les modèles évoluent et les conclusions deviennent obsolètes ; conserver les métadonnées permet de savoir d'où viennent les différences lors de la prochaine réévaluation.
Un jeu d'évaluation petit mais fixe a beaucoup plus de valeur qu'un « essai ressenti » à grande échelle mais non reproductible.
Points d'attention pour migrer vers gemini-4-argon
La complexité de la migration ne réside généralement pas dans l'appel lui-même, mais dans l'adaptation des prompts, de l'analyse des sorties et des stratégies de tolérance aux pannes.
Adaptation des prompts
Les différents modèles répondent aux instructions avec des styles différents : certains préfèrent une réponse concise, d'autres une explication développée. Lors de la migration, exécutez d'abord les prompts existants et notez quelles instructions ne fonctionnent plus. Les ajustements courants incluent : formuler les exigences implicites en contraintes explicites, placer les exigences de format de sortie plus en amont, réduire la dépendance au « le modèle comprendra de lui-même ». Ne réécrivez pas tous les prompts d'un coup ; modifiez et validez un par un.
Analyse des sorties
Supposez que la sortie peut contenir du texte d'enrobage superflu ; la couche d'analyse doit tolérer les erreurs : essayez d'abord une analyse structurée, puis en cas d'échec une extraction de secours, et seulement en cas de nouvel échec une nouvelle tentative. Comme l'interface ne prend pas en charge le mode JSON, le taux d'échec d'analyse doit surtout être un indicateur de surveillance pendant la migration ; il reflète mieux la disponibilité réelle que l'auto-évaluation du modèle.
Délais et nouvelles tentatives
Redéfinissez les seuils de délai, ne reprenez pas la configuration de l'ancien modèle. Les nouvelles tentatives doivent avoir une limite et un backoff, et distinguer les erreurs réessayables (délai, limitation de débit) des erreurs non réessayables (erreur de paramètre, contenu illicite). La stratégie de nouvelle tentative affecte directement la consommation de tokens ; il faut l'intégrer au calcul de coût dès la phase d'évaluation de la migration.
Déploiement progressif et retour arrière
Commencez par un déploiement progressif à faible trafic, en le segmentant par dimension métier (par exemple une entrée, un type de tâche), en comparant les indicateurs des anciens et nouveaux modèles sur le même trafic. Conservez un chemin de retour arrière : la sélection du modèle et de la voie (standard ou @vertex) doit être un élément de configuration et non codée en dur, afin de ne modifier que la configuration et non le code lors d'un retour arrière. Préparez aussi la gestion de la cohérence des données après le retour arrière, pour éviter que l'ancienne et la nouvelle sortie ne se mélangent et ne provoquent des anomalies en aval.
Cas de régression
Figez les échantillons centraux du jeu d'évaluation en cas de régression, et exécutez-les à chaque changement de prompt ou de paramètre. La migration n'est pas une action ponctuelle ; les mises à jour ultérieures des modèles nécessitent également cette protection par régression.
Liste de contrôle réutilisable pour la revue de sélection
Cette liste sert à confirmer point par point avant la mise en production ; elle peut aussi servir d'annexe fixe au document de sélection, pour faciliter la rétrospective de l'équipe.
Confirmation des frontières
- L'entrée de cette chaîne est-elle uniquement du texte et de l'image ? Les autres modalités ont-elles été converties avant l'appel ?
- Cette chaîne nécessite-t-elle un appel d'outils, une recherche en ligne, un computer use ou une sortie structurée ? Si oui, ont-ils été complétés au niveau applicatif ?
- Le contexte de 1 048 576 tokens et la sortie de 65 536 tokens par appel couvrent-ils la distribution réelle des longueurs ?
- A-t-on confirmé la voie standard ou @vertex et intégré le prix unitaire correspondant au budget ?
Validité de l'évaluation
- Utilise-t-on un jeu d'évaluation fixe, dont les échantillons proviennent de la distribution réelle des requêtes ?
- Les cinq dimensions (qualité, latence, stabilité, coût, frontière des capacités) ont-elles toutes des indicateurs mesurables ?
- A-t-on fixé le niveau reasoning_effort et la voie avant de comparer ?
- A-t-on examiné un par un les échantillons divergents avec le modèle existant et consigné les frontières des capacités ?
Référentiel de coût
- L'estimation se fonde-t-elle sur les distributions de longueur P50 et P90 plutôt que sur la moyenne ?
- Le prompt système, l'accumulation du contexte, les nouvelles tentatives et le coefficient d'échec sont-ils pris en compte ?
- Utilise-t-on les prix d'entrée et de sortie, et non une estimation uniquement basée sur le prix d'entrée ?
- A-t-on converti en coût unitaire métier au lieu de rester au prix unitaire par token ?
Adaptation d'ingénierie
- Les prompts ont-ils été validés avec le nouveau modèle et ajustés un par un ?
- L'analyse des sorties dispose-t-elle de chemins de tolérance et de secours ?
- Les stratégies de délai, de nouvelle tentative et de backoff ont-elles été redéfinies avec des limites ?
- Le modèle et la voie sont-ils abstraits en éléments de configuration, sans modification de code lors d'un retour arrière ?
Mise en production et observation
- A-t-on d'abord fait un déploiement progressif à faible trafic, en définissant une fenêtre d'observation et des indicateurs de comparaison ?
- A-t-on figé des cas de régression couvrant les changements ultérieurs de prompts et de paramètres ?
- A-t-on enregistré la version des échantillons, la version des prompts et les paramètres d'appel pour garantir la reproductibilité des conclusions ?
L'intérêt de cette liste n'est pas seulement d'éviter les oublis, mais de transformer une conclusion de sélection en un actif réutilisable par l'équipe : au lancement du prochain modèle, vous pourrez simplement mettre à jour les données d'évaluation, sans reconstruire de zéro le cadre de jugement. Le but final de la sélection n'est pas « quel modèle a été choisi », mais « avoir formé un processus capable de faire des choix en continu ».
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Sélection Gemini 4 et 3.8 Flash : interfaces, coûts et migration
Basé sur l'interface compatible Chat Completions, comparer le positionnement de tâche, l'intensité de raisonnement et le coût en tokens des trois lignes de modèles
-

Comparatif et évaluation
Comment choisir gemini-4-carbon : guide de sélection selon la tâche, le contexte, l'intensité de raisonnement et le coût
Décider selon quatre dimensions : besoins de la tâche, contexte, intensité de raisonnement et coût
-

Comparatif et évaluation
HiAPI vs KIE : comparatif tarifaire détaillé de 10 modèles (novembre 2026)
Comparatif tarifaire détaillé de 10 modèles, avec les règles de recharge et un exemple de calcul sur une semaine d'usage