
Руководство
Как пользоваться HeyGen Avatar V API? От выбора аватара до скачивания готового видео
Два пути — текст и аудио; поиск значений аватара и голоса, cURL, структура ответа, ограниченный опрос и скачивание видео/SRT.
В HeyGen Avatar V выберите готового цифрового человека, введите текст или аудио — и получите видео с синхронизацией губ. HiAPI берёт плату по длительности вывода: $0.15 за секунду, $1.50 за 10-секундное видео.
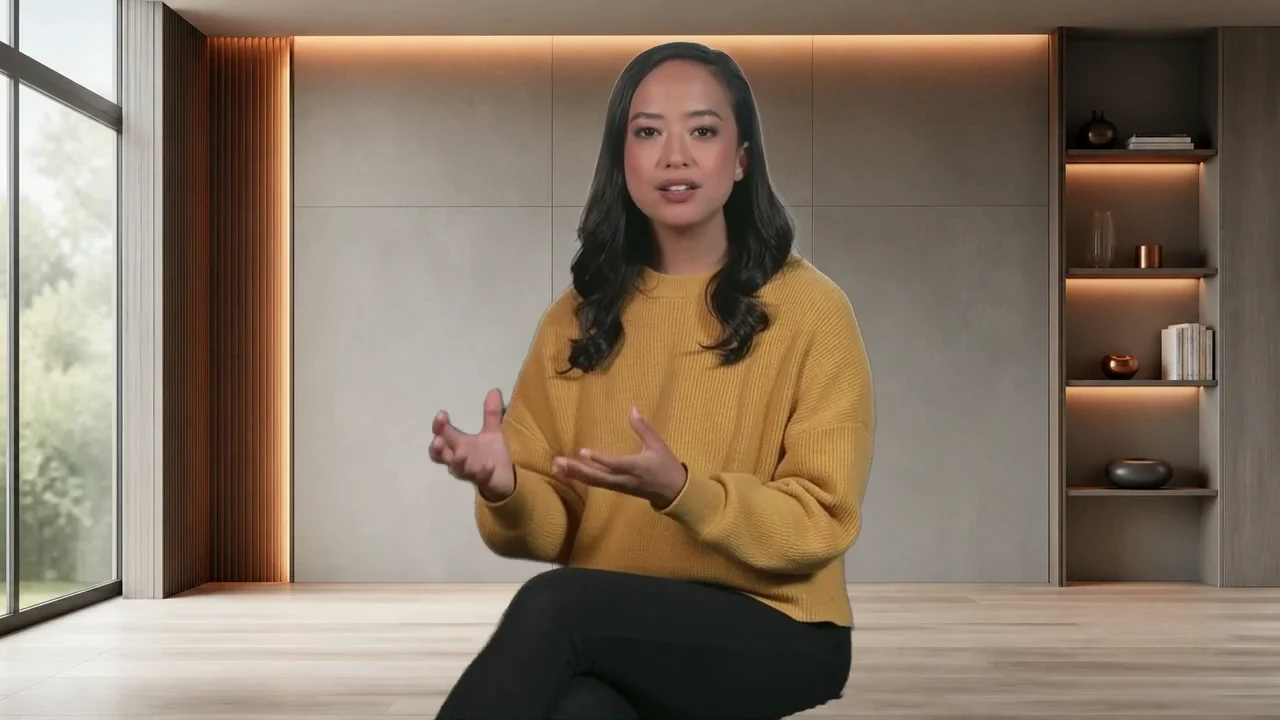
HeyGen Avatar V уже доступен в HiAPI. Откройте страницу модели, сначала выберите аватар и голос, затем подключайте API. Вот этот деловой ролик — уже готовое видео:
Brandon Office Sitting Front, Dexter - Professional; 16:9, готовое видео 1280×720, около 8 секунд. Исходный запрос был на 1080p, на этой странице — веб-версия 720p.
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
Сгенерировать с этим промптом → Текст уже заполнен; вручную выберите указанные выше аватар, голос, 1080p и 16:9, на выходе выберите MP4.
Как попробовать онлайн?
- Откройте ссылку с предзаполненными полями, оставьте эту короткую реплику.
- Выберите аватар и голос; эти параметры нужно выбирать вручную, ссылка подставляет только текст.
- Задайте соотношение сторон, разрешение и формат; для первого раза подойдёт указанная выше комбинация.
- После генерации прослушайте озвучку, проверьте синхронизацию губ, скачайте готовое видео, затем замените текст на свой.
Запишите аватар, голос и соотношение сторон этой пробной генерации — при пакетной генерации используйте их же, меняя только текст, чтобы ведущий и голос оставались неизменными.
V выбирает ведущего из готовых аватаров; чтобы в кадре было ваше фото, выберите Avatar IV.
Все разрешения оплачиваются по фактической длительности вывода, при неудаче — полный возврат; полную стоимость см. в таблице цен и бюджета.
Что подготовить для API?
Создайте API key в консоли. В запросе явно укажите model, обязательный input.avatar, а затем выберите одно из prompt и audio_url. Для аватара и голоса используйте английские значения запроса из карточек документации; китайские названия нужны только для распознавания.
Текст читается напрямую, не помещайте в prompt команды для камеры. При управлении аудио передайте доступный HTTP(S)-адрес и удалите prompt и voice. duration передавать не нужно, длительность определяется чтением текста или аудио.
| Что у вас есть | Какие управляющие поля передать |
|---|---|
| Текст для чтения | avatar + prompt; voice необязателен |
| Готовая запись голоса | avatar + audio_url; опустите prompt и voice |
Поиск значения аватара: документация параметров → цифровой аватар, разверните всё, найдите и скопируйте английское «значение запроса»; голос ищите там же в разделе готовые голоса. На английской странице это Request value; не вставляйте в запрос китайское отображаемое имя.
**Минимальный полный запрос с управлением аудио:** замените адрес-заполнитель на свой публично доступный URL аудио. Опущенные соотношение сторон, разрешение и формат используют значения по умолчанию из документации; аудио — до 600 секунд, максимум 32 MiB.
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
Создание и опрос задачи через cURL
Замените заполнитель Key на своё значение; этот запрос использует параметры делового примера:
export HIAPI_API_KEY="sk-YOUR_KEY"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Brandon Office Sitting Front",
      "prompt": "Hi, I\u0027m Daniel. Send me your quarterly numbers, and I\u0027ll walk your team through what changed and what to do next.",
      "voice": "Dexter - Professional",
      "aspect_ratio": "16:9",
      "resolution": "1080p",
      "caption": false,
      "output_format": "mp4"
    }
  }'
Проверьте HTTP-статус и code в JSON, после успешного создания сохраните data.taskId. Затем опрашивайте только эту же задачу:
TASK_ID="REPLACE_WITH_data.taskId"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  "https://api.hiapi.ai/v1/tasks/$TASK_ID" \
  -H "Authorization: Bearer $HIAPI_API_KEY"
queued, handling, archiving означают обработку; конечные состояния — success или fail. После успеха найдите video по data.output[].type, а при включённых субтитрах — ещё и caption. Прочитайте url артефакта и скачайте его вовремя согласно expireAt.
**Пример структуры ответа:** первый фрагмент — успешное создание, второй — успешный опрос с включёнными субтитрами; ID задачи, URL и время истечения — условные значения; expireAt — число, Unix-секунды. При таймауте POST или потере ответа сначала проверьте запись задачи, не повторяйте POST вслепую; если ID есть, продолжайте GET.
{
  "code": 200,
  "data": {"taskId": "TASK_ID_FROM_CREATE"}
}
{
  "code": 200,
  "data": {
    "taskId": "TASK_ID_FROM_CREATE",
    "status": "success",
    "output": [
      {"type": "video", "url": "https://example.com/result.mp4", "expireAt": 4070908800},
      {"type": "caption", "url": "https://example.com/result.srt", "expireAt": 4070908800}
    ]
  }
}
Python: создание, ограниченный опрос, скачивание
Сначала установите requests, задайте Key в переменной окружения HIAPI_API_KEY. Код отправляет запрос только один раз, опрос — не более 30 минут; при таймауте сохраните ID задачи и продолжайте опрос.
import os
import time
from pathlib import Path
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}
payload = {
    "model": "heygen-avatar-v",
    "input": {
        "avatar": "Brandon Office Sitting Front",
        "prompt": "Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.",
        "voice": "Dexter - Professional",
        "aspect_ratio": "16:9",
        "resolution": "1080p",
        "caption": False,
        "output_format": "mp4",
    },
}

def api_request(method, url, **kwargs):
    advice = (
        "Submission state may be unknown; check task history before another POST."
        if method == "POST"
        else f"Continue GET with the saved task ID: {url.rsplit('/', 1)[-1]}."
    )
    try:
        response = requests.request(
            method, url, headers=HEADERS, timeout=(10, 30), **kwargs
        )
    except requests.RequestException:
        raise RuntimeError(f"Network error. {advice}") from None
    if not response.ok:
        raise RuntimeError(f"HTTP {response.status_code}. {advice}")
    try:
        body = response.json()
    except ValueError:
        raise RuntimeError(f"Response is not JSON. {advice}") from None
    if not isinstance(body, dict):
        raise RuntimeError(f"Unexpected response shape. {advice}")
    if body.get("code") != 200 or not isinstance(body.get("data"), dict):
        raise RuntimeError(f"API error: code={body.get('code')}. {advice}")
    return body["data"]

# Submit once. No automatic POST retries.
created = api_request("POST", API, json=payload)
task_id = created.get("taskId")
if not isinstance(task_id, str) or not task_id:
    raise RuntimeError("Missing taskId; check task history before resubmitting.")
print("taskId:", task_id)  # Keep this ID to resume GET queries.
deadline = time.monotonic() + 1800
while time.monotonic() < deadline:
    data = api_request("GET", f"{API}/{task_id}")
    status = data.get("status")
    if status == "fail":
        raise RuntimeError(f"Task failed: {task_id}; inspect its task record.")
    if status == "success":
        break
    if status not in ("queued", "handling", "archiving"):
        raise RuntimeError(f"Unexpected task status: {status}")
    time.sleep(8)
else:
    raise TimeoutError(f"Polling timed out; continue GET for taskId={task_id}.")

raw_outputs = data.get("output")
if not isinstance(raw_outputs, list):
    raise RuntimeError(f"Missing output list; inspect taskId={task_id}.")
outputs = {
    item["type"]: item
    for item in raw_outputs
    if isinstance(item, dict) and item.get("type") in ("video", "caption")
}
if "video" not in outputs:
    raise RuntimeError("Successful task has no video artifact.")
for kind, artifact in outputs.items():
    if not isinstance(artifact.get("url"), str) or not artifact["url"]:
        raise RuntimeError(f"Missing {kind} URL; inspect taskId={task_id}.")
    suffix = payload["input"]["output_format"] if kind == "video" else "srt"
    target = Path(f"avatar-v.{suffix}")
    # Artifact downloads do not need the API Authorization header.
    with requests.get(artifact["url"], stream=True, timeout=(10, 120)) as response:
        response.raise_for_status()
        with target.open("wb") as file:
            for chunk in response.iter_content(chunk_size=1024 * 1024):
                if chunk:
                    file.write(chunk)
    print("saved:", target)
Какие параметры нужно задавать явно?
| Поле | Правила и значения по умолчанию |
|---|---|
avatar |
Обязательно, английское значение запроса аватара |
prompt / audio_url |
Одно из двух; текст до 5 000 символов, аудио до 600 секунд, максимум 32 MiB |
voice |
Необязательно для текстового пути, по умолчанию Warm Pro Narrator |
resolution |
По умолчанию 720p, доступны 1080p, 4k в нижнем регистре |
aspect_ratio |
По умолчанию 16:9; также 9:16, 4:5, 5:4, 1:1, auto |
fit |
По умолчанию cover, доступен contain |
caption |
По умолчанию false; true возвращает отдельный SRT |
output_format |
По умолчанию mp4, доступен webm |
remove_background |
По умолчанию false; для прозрачности выберите true вместе с webm, сначала проверьте выбранный аватар на коротком ролике |
background |
Объект; type — color или image, value — hex-цвет или HTTP(S) URL изображения |
Разрешение и соотношение сторон — два параметра: для горизонтального рассказа используйте 16:9, для вертикальной речи 9:16, указывайте их в запросе. После скачивания проверьте фактические размеры файла. Для прозрачного WebM сначала убедитесь в эффекте удаления фона у выбранного аватара, затем импортируйте в редактор.
Субтитры не вшиваются в изображение, их нужно накладывать в плеере или видеоредакторе. В примере ниже для вертикального видео задано caption=true, возвращается отдельный SRT; видео 1080×1920, 6,52 секунды, запрос был на 1080p, 9:16. Отдельный SRT-файл субтитров можно импортировать при монтаже.
New drop just landed: our travel mug keeps coffee hot for twelve hours. Swipe up and grab yours today!
Сгенерировать с этим промптом → Текст уже заполнен; вручную выберите Riley Casual Front, Charming Charles - Friendly, 9:16 и 1080p, включите субтитры, на выходе выберите MP4.
Что проверить перед запуском? Четыре пункта
- Проверьте входные данные: аватар, способ управления, английские значения запроса и ограничения длины.
- Сохраните ID задачи: при ошибке опроса или таймауте продолжайте GET с тем же ID.
- Соберите все артефакты: после успеха найдите video по
type, при включённых субтитрах — caption. - Проверка скачивания: убедитесь в фактических размерах, звуке и файле субтитров, затем передавайте.
Как обрабатывать частые проблемы?
- **Проблемы с валидацией ввода:** проверьте
avatar, одно из полей управления, английские значения запроса, лимиты текста и аудио; разрешение пишите как4k, удалитеduration. - **Таймаут POST:** сначала проверьте запись задачи; если
taskIdуже есть, продолжайте GET, каждый POST создаёт новую задачу. - **Задача в
fail:** посмотрите причину ошибки в записи задачи, исправьте соответствующий ввод и отправьте снова. - **Ссылка на скачивание истекла:** сохраняйте артефакты сразу после успеха; субтитры читайте из
type=caption.
Сервер может добавить на уровне input "callback": {"url": "https://yourapp.com/webhook", "when": "final"}, чтобы получать объект задачи в конечном состоянии и компенсировать опрос через GET.
Подробности о ценах см. в цене за секунду и таблице бюджета, о смене аватара — в двух примерах, полный набор значений — в документации параметров API.
Сгенерировать с этим промптом → Текст уже заполнен; вручную выберите деловой аватар и голос, 1080p, 16:9, MP4, сначала сгенерируйте одну фразу, затем подключайте полный сценарий.
Похожие статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата