
Tutoriale
Come si usa l'API HeyGen Avatar V? Dalla scelta dell'avatar al download del video finale
Due percorsi: testo o audio, con ricerca dei valori di avatar e voce, cURL, struttura della risposta, polling limitato e download di video/SRT.
Con HeyGen Avatar V scegli un avatar predefinito, inserisci un testo o un audio e generi un video con sincronizzazione labiale. HiAPI addebita in base alla durata dell'output, $0.15 al secondo, $1.50 per un video da 10 secondi.
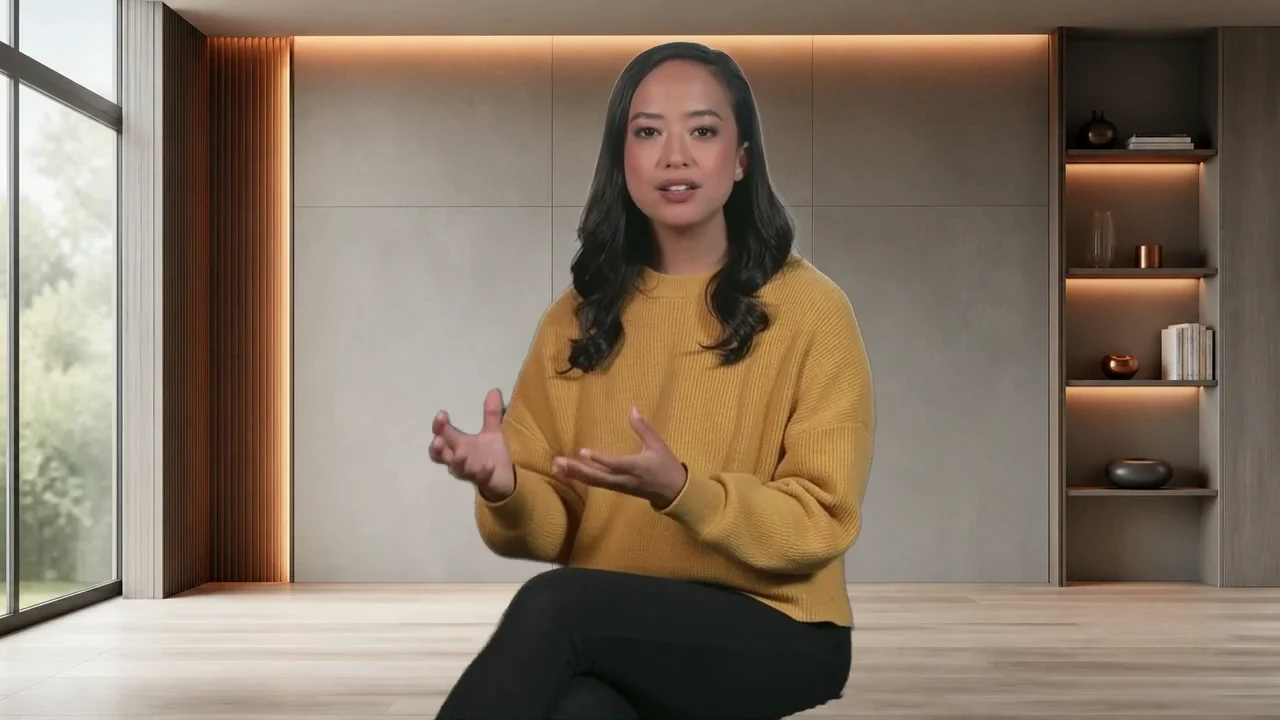
HeyGen Avatar V è disponibile su HiAPI: apri la pagina del modello per scegliere prima avatar e voce, poi collega l'API. Il seguente video di presentazione aziendale è già un risultato finale:
Brandon Office Sitting Front, Dexter - Professional; 16:9, video finale 1280×720, circa 8 secondi. La richiesta originale era in 1080p, questa pagina mostra la versione web in 720p.
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
Genera con questo prompt → il testo è già compilato; seleziona manualmente l'avatar, la voce, 1080p e 16:9 indicati sopra, e scegli MP4 come output.
Come provarlo online?
- Apri il link precompilato e mantieni questa breve battuta.
- Scegli avatar e voce; questi parametri vanno selezionati manualmente, il link inserisce solo il testo.
- Imposta formato, risoluzione e formato file; per la prima prova puoi usare la combinazione sopra.
- Dopo la generazione ascolta il doppiaggio, controlla la sincronizzazione labiale, scarica il video finale e poi sostituisci con il tuo testo.
Annota avatar, voce e formato usati in questa prova: riutilizzali per la generazione in batch, cambiando solo il testo, così la persona in video e la voce restano coerenti.
La V seleziona la persona in video tra gli avatar predefiniti; per far apparire la tua foto, scegli Avatar IV.
Tutte le risoluzioni vengono addebitate in base ai secondi effettivi di output, con rimborso completo in caso di errore; per i costi completi vedi la tabella prezzi e budget.
Cosa serve preparare per l'API?
Crea una API key nella console. Nella richiesta specifica chiaramente model, il campo obbligatorio input.avatar, e scegli uno tra prompt e audio_url. Per avatar e voce usa i valori di richiesta in inglese delle schede della documentazione, i nomi in cinese servono solo per il riconoscimento.
Il testo viene letto direttamente, non inserire istruzioni di regia in prompt. Per l'audio passa un indirizzo HTTP(S) accessibile e rimuovi prompt e voice. Non è necessario passare duration, la durata è determinata dalla lettura del testo o dall'audio.
| Cosa hai a disposizione | Quali campi di guida passare |
|---|---|
| Il testo da leggere | avatar + prompt; voice facoltativo |
| Una voce già registrata | avatar + audio_url; ometti prompt e voice |
Ricerca valori avatar: documentazione parametri → Avatar digitali, espandi tutto, cerca e copia il «valore di richiesta» in inglese; anche la voce si cerca in Voci predefinite. Nella pagina in inglese corrisponde a Request value, non inserire i nomi visualizzati in cinese nella richiesta.
**Richiesta completa minima con audio:** sostituisci l'indirizzo segnaposto con l'URL audio pubblico accessibile. Formato, risoluzione e formato file omessi usano i valori predefiniti della documentazione; l'audio può durare al massimo 600 secondi e 32 MiB.
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
Creare e interrogare le attività con cURL
Sostituisci il segnaposto della Key con il tuo valore; questa richiesta usa i parametri dell'esempio aziendale:
export HIAPI_API_KEY="sk-YOUR_KEY"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Brandon Office Sitting Front",
      "prompt": "Hi, I\u0027m Daniel. Send me your quarterly numbers, and I\u0027ll walk your team through what changed and what to do next.",
      "voice": "Dexter - Professional",
      "aspect_ratio": "16:9",
      "resolution": "1080p",
      "caption": false,
      "output_format": "mp4"
    }
  }'
Controlla lo stato HTTP e il code del JSON, dopo la creazione riuscita salva data.taskId. Poi interroga solo la stessa attività:
TASK_ID="REPLACE_WITH_data.taskId"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  "https://api.hiapi.ai/v1/tasks/$TASK_ID" \
  -H "Authorization: Bearer $HIAPI_API_KEY"
queued, handling, archiving indicano elaborazione in corso; gli stati finali sono success o fail. In caso di successo cerca video in base a data.output[].type, e caption se i sottotitoli sono abilitati. Leggi l'url del file prodotto e scaricalo in tempo secondo expireAt.
**Esempio di struttura della risposta:** il primo blocco è la creazione riuscita, il secondo è la query riuscita con sottotitoli abilitati; ID attività, URL e tempo di scadenza sono valori illustrativi; expireAt è un numero in secondi Unix. In caso di timeout o risposta persa del POST, interroga prima il record dell'attività, non riprovare il POST alla cieca; se hai l'ID continua con GET.
{
  "code": 200,
  "data": {"taskId": "TASK_ID_FROM_CREATE"}
}
{
  "code": 200,
  "data": {
    "taskId": "TASK_ID_FROM_CREATE",
    "status": "success",
    "output": [
      {"type": "video", "url": "https://example.com/result.mp4", "expireAt": 4070908800},
      {"type": "caption", "url": "https://example.com/result.srt", "expireAt": 4070908800}
    ]
  }
}
Python: creazione, polling limitato, download
Installa prima requests, imposta la Key nella variabile d'ambiente HIAPI_API_KEY. Il codice invia una sola volta, esegue polling per massimo 30 minuti; in caso di timeout conserva l'ID attività e continua a interrogare.
import os
import time
from pathlib import Path
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}
payload = {
    "model": "heygen-avatar-v",
    "input": {
        "avatar": "Brandon Office Sitting Front",
        "prompt": "Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.",
        "voice": "Dexter - Professional",
        "aspect_ratio": "16:9",
        "resolution": "1080p",
        "caption": False,
        "output_format": "mp4",
    },
}

def api_request(method, url, **kwargs):
    advice = (
        "Submission state may be unknown; check task history before another POST."
        if method == "POST"
        else f"Continue GET with the saved task ID: {url.rsplit('/', 1)[-1]}."
    )
    try:
        response = requests.request(
            method, url, headers=HEADERS, timeout=(10, 30), **kwargs
        )
    except requests.RequestException:
        raise RuntimeError(f"Network error. {advice}") from None
    if not response.ok:
        raise RuntimeError(f"HTTP {response.status_code}. {advice}")
    try:
        body = response.json()
    except ValueError:
        raise RuntimeError(f"Response is not JSON. {advice}") from None
    if not isinstance(body, dict):
        raise RuntimeError(f"Unexpected response shape. {advice}")
    if body.get("code") != 200 or not isinstance(body.get("data"), dict):
        raise RuntimeError(f"API error: code={body.get('code')}. {advice}")
    return body["data"]

# Submit once. No automatic POST retries.
created = api_request("POST", API, json=payload)
task_id = created.get("taskId")
if not isinstance(task_id, str) or not task_id:
    raise RuntimeError("Missing taskId; check task history before resubmitting.")
print("taskId:", task_id)  # Keep this ID to resume GET queries.
deadline = time.monotonic() + 1800
while time.monotonic() < deadline:
    data = api_request("GET", f"{API}/{task_id}")
    status = data.get("status")
    if status == "fail":
        raise RuntimeError(f"Task failed: {task_id}; inspect its task record.")
    if status == "success":
        break
    if status not in ("queued", "handling", "archiving"):
        raise RuntimeError(f"Unexpected task status: {status}")
    time.sleep(8)
else:
    raise TimeoutError(f"Polling timed out; continue GET for taskId={task_id}.")

raw_outputs = data.get("output")
if not isinstance(raw_outputs, list):
    raise RuntimeError(f"Missing output list; inspect taskId={task_id}.")
outputs = {
    item["type"]: item
    for item in raw_outputs
    if isinstance(item, dict) and item.get("type") in ("video", "caption")
}
if "video" not in outputs:
    raise RuntimeError("Successful task has no video artifact.")
for kind, artifact in outputs.items():
    if not isinstance(artifact.get("url"), str) or not artifact["url"]:
        raise RuntimeError(f"Missing {kind} URL; inspect taskId={task_id}.")
    suffix = payload["input"]["output_format"] if kind == "video" else "srt"
    target = Path(f"avatar-v.{suffix}")
    # Artifact downloads do not need the API Authorization header.
    with requests.get(artifact["url"], stream=True, timeout=(10, 120)) as response:
        response.raise_for_status()
        with target.open("wb") as file:
            for chunk in response.iter_content(chunk_size=1024 * 1024):
                if chunk:
                    file.write(chunk)
    print("saved:", target)
Quali parametri vanno impostati esplicitamente?
| Campo | Regole e valori predefiniti |
|---|---|
avatar |
Obbligatorio, valore di richiesta dell'avatar in inglese |
prompt / audio_url |
Scegli uno dei due; testo massimo 5.000 caratteri, audio massimo 600 secondi e 32 MiB |
voice |
Facoltativo per il percorso testo, predefinito Warm Pro Narrator |
resolution |
Predefinito 720p, disponibili 1080p, 4k minuscolo |
aspect_ratio |
Predefinito 16:9; inoltre 9:16, 4:5, 5:4, 1:1, auto |
fit |
Predefinito cover, disponibile contain |
caption |
Predefinito false; true restituisce un SRT separato |
output_format |
Predefinito mp4, disponibile webm |
remove_background |
Predefinito false; per uso trasparente scegli true insieme a webm, verifica prima l'avatar scelto con un video breve |
background |
Oggetto; type è color o image, value contiene il colore esadecimale o l'URL immagine HTTP(S) |
Risoluzione e formato sono due parametri distinti: per una presentazione orizzontale usa 16:9, per un video verticale usa 9:16, specificali entrambi nella richiesta. Dopo il download controlla le dimensioni effettive del file. Per il WebM trasparente verifica prima l'effetto di rimozione dello sfondo sull'avatar scelto, poi importalo nel software di montaggio.
I sottotitoli non vengono incisi nel video, vanno sovrapposti nel player o nel software di montaggio. L'esempio verticale seguente imposta caption=true e restituisce un SRT separato; il video è 1080×1920, 6,52 secondi, la richiesta era 1080p, 9:16. Il file SRT dei sottotitoli separato può essere importato in fase di montaggio.
New drop just landed: our travel mug keeps coffee hot for twelve hours. Swipe up and grab yours today!
Genera con questo prompt → il testo è già compilato; seleziona manualmente Riley Casual Front, Charming Charles - Friendly, 9:16 e 1080p, abilita i sottotitoli e scegli MP4 come output.
Quali quattro controlli fare prima della pubblicazione?
- Verifica gli input: avatar, modalità di guida, valori di richiesta in inglese e limiti di lunghezza.
- Salva l'ID attività: se la query fallisce o va in timeout continua il GET con lo stesso ID.
- Trova tutti i file prodotti: in caso di successo cerca video in base a
type, e caption se i sottotitoli sono abilitati. - Controllo del download: verifica dimensioni effettive, audio e file dei sottotitoli, poi consegna.
Come gestire i problemi comuni?
- **Problemi di validazione degli input:** controlla
avatar, il campo di guida scelto tra i due, i valori di richiesta in inglese, i limiti di testo e audio; scrivi la risoluzione come4ke rimuoviduration. - **Timeout del POST:** interroga prima il record dell'attività; se hai già un
taskIdcontinua con GET, ogni POST crea una nuova attività. - **Attività in
fail:** consulta il motivo dell'errore nel record dell'attività, modifica gli input corrispondenti e invia di nuovo. - **Link di download scaduto:** salva i file prodotti in tempo dopo il successo; i sottotitoli si leggono da
type=caption.
Il server può aggiungere "callback": {"url": "https://yourapp.com/webhook", "when": "final"} allo stesso livello di input, per ricevere l'oggetto attività in stato finale e compensare con una query GET.
Per i dettagli sui prezzi vedi la tabella del prezzo al secondo e del budget, per cambiare avatar consulta i due esempi, per tutti i valori vedi la documentazione dei parametri API.
Genera con questo prompt → il testo è già compilato; seleziona manualmente avatar e voce aziendali, 1080p, 16:9, MP4, genera prima una frase, poi collega lo script completo.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato