
チュートリアル
HeyGen Avatar V API の使い方:アバター選択から完成動画のダウンロードまで
セリフと音声の2つの経路、アバターと音声の値の調べ方、cURL、レスポンス構造、有限ポーリング、動画/SRTのダウンロード付き。
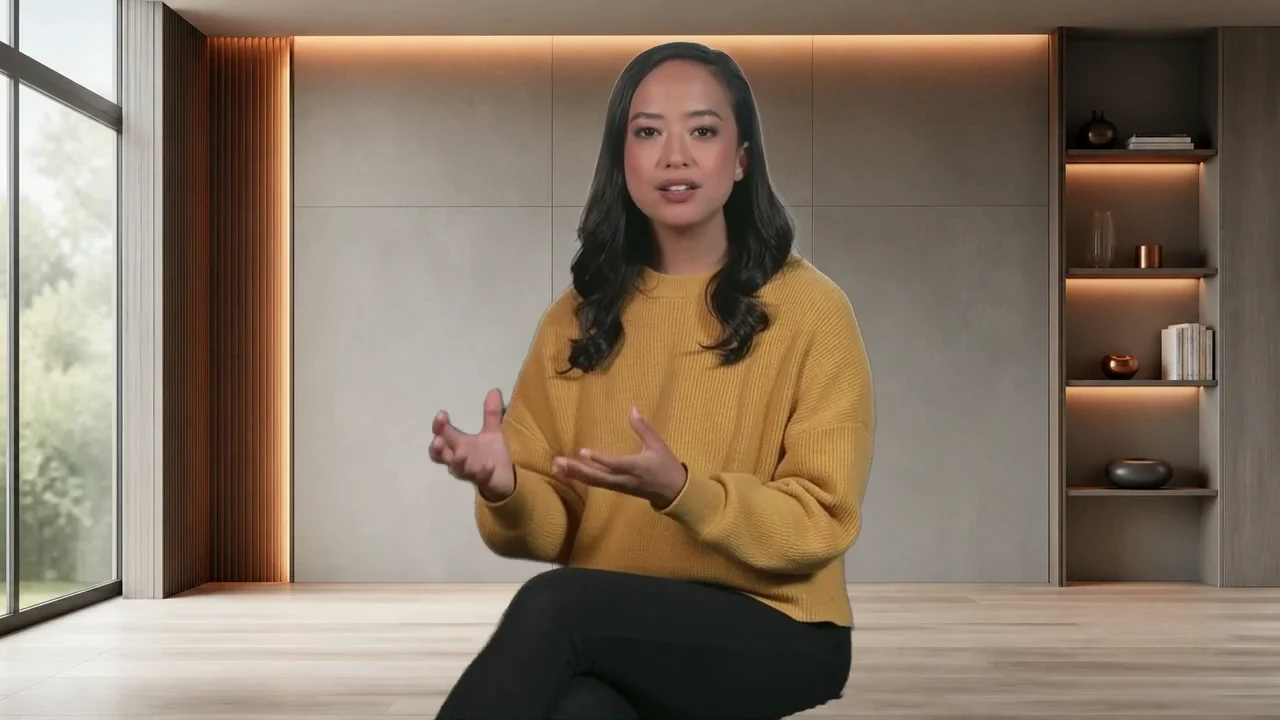
HeyGen Avatar V はプリセットのデジタルヒューマンを1つ選び、セリフまたは音声を入力するだけで、リップシンク動画を生成できます。HiAPI は出力時間に応じた課金で、1秒あたり $0.15、10秒の動画で $1.50 です。
HeyGen Avatar V は HiAPI で提供開始済みです。モデルページを開くとまずアバターと音声を選べ、その後 API に接続できます。次のビジネス解説はすでに完成した動画です:
Brandon Office Sitting Front、Dexter - Professional;16:9、完成動画は1280×720、約8秒。元のリクエストは1080pで、本ページは720pのWeb版です。
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
このプロンプトで生成 → セリフは入力済みです。上記のアバター、音声、1080p、16:9 を手動で選び、出力は MP4 を選択してください。
オンラインで試すには?
- プリセット済みリンクを開き、この短いセリフをそのまま使います。
- アバターと音声を選択します。これらのパラメータは手動で選ぶ必要があり、リンクで引き継がれるのはセリフだけです。
- アスペクト比、解像度、フォーマットを設定します。初回は上記の組み合わせで構いません。
- 生成後に音声を試聴し、リップシンクを確認して完成動画をダウンロードし、その後自分の原稿に差し替えます。
今回試したアバター、音声、アスペクト比を控えておき、一括生成時にも同じものを使い、セリフだけを変えれば、出演者と声を一貫させられます。
V はプリセットのアバターから出演者を選びます。自分の写真を出演させるには Avatar IV を選んでください。
すべての解像度で実際の出力秒数に応じて課金され、失敗時は全額返金されます。詳細な費用は料金と予算表をご覧ください。
API には何が必要?
コンソールで API key を作成します。リクエストには model、必須の input.avatar を明記し、さらに prompt と audio_url のどちらか一方を選びます。アバターと音声はドキュメントカードの英語のリクエスト値を使い、中国語名は識別用にすぎません。
セリフはそのまま読み上げられ、カメラ指示を prompt に入れないでください。音声駆動の場合はアクセス可能な HTTP(S) アドレスを渡し、prompt と voice を削除します。duration を渡す必要はなく、長さはセリフの読み上げまたは音声によって決まります。
| 手元にあるもの | 渡す駆動フィールド |
|---|---|
| 読み上げるセリフ | avatar + prompt;voice は任意 |
| 録音済みの音声 | avatar + audio_url;prompt と voice は省略 |
アバターの値の調べ方:パラメータドキュメント → デジタルヒューマン形象で全てを展開し、英語の「リクエスト値」を検索してコピーします。音声も同様にプリセット音声で探します。英語ページでは Request value に対応するので、中国語の表示名をリクエストに入れないでください。
**音声駆動の最小完全リクエスト:**プレースホルダのアドレスを自分の公開アクセス可能な音声 URL に置き換えます。省略したアスペクト比、解像度、フォーマットにはドキュメントのデフォルト値が使われます。音声は最長600秒、最大32 MiBです。
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
cURL でタスクを作成・照会する
Key のプレースホルダを自分の値に置き換えます。このリクエストはビジネスケースのパラメータをそのまま使います:
export HIAPI_API_KEY="sk-YOUR_KEY"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Brandon Office Sitting Front",
      "prompt": "Hi, I\u0027m Daniel. Send me your quarterly numbers, and I\u0027ll walk your team through what changed and what to do next.",
      "voice": "Dexter - Professional",
      "aspect_ratio": "16:9",
      "resolution": "1080p",
      "caption": false,
      "output_format": "mp4"
    }
  }'
HTTP ステータスと JSON の code を確認し、作成に成功したら data.taskId を保存します。その後は同じタスクだけを照会します:
TASK_ID="REPLACE_WITH_data.taskId"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  "https://api.hiapi.ai/v1/tasks/$TASK_ID" \
  -H "Authorization: Bearer $HIAPI_API_KEY"
queued、handling、archiving は処理中を表し、終状態は success または fail です。成功後は data.output[].type で video を探し、字幕を有効にした場合はさらに caption を探します。成果物の url を読み取り、expireAt に従って早めにダウンロードしてください。
**レスポンス構造の例:**1つ目は作成成功、2つ目は字幕を有効にした後の成功照会です。タスク ID、URL、有効期限はすべて例示値です。expireAt は数値で、単位は Unix 秒です。POST がタイムアウトしたりレスポンスが失われたりした場合は、まずタスク記録を照会し、むやみに再度 POST しないでください。ID があれば GET を続けます。
{
  "code": 200,
  "data": {"taskId": "TASK_ID_FROM_CREATE"}
}
{
  "code": 200,
  "data": {
    "taskId": "TASK_ID_FROM_CREATE",
    "status": "success",
    "output": [
      {"type": "video", "url": "https://example.com/result.mp4", "expireAt": 4070908800},
      {"type": "caption", "url": "https://example.com/result.srt", "expireAt": 4070908800}
    ]
  }
}
Python:作成、有限ポーリング、ダウンロード
まず requests をインストールし、環境変数 HIAPI_API_KEY に Key を設定します。コードは一度だけ送信し、ポーリングは最大30分です。タイムアウトしたらタスク ID を保持して照会を続けます。
import os
import time
from pathlib import Path
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}
payload = {
    "model": "heygen-avatar-v",
    "input": {
        "avatar": "Brandon Office Sitting Front",
        "prompt": "Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.",
        "voice": "Dexter - Professional",
        "aspect_ratio": "16:9",
        "resolution": "1080p",
        "caption": False,
        "output_format": "mp4",
    },
}

def api_request(method, url, **kwargs):
    advice = (
        "Submission state may be unknown; check task history before another POST."
        if method == "POST"
        else f"Continue GET with the saved task ID: {url.rsplit('/', 1)[-1]}."
    )
    try:
        response = requests.request(
            method, url, headers=HEADERS, timeout=(10, 30), **kwargs
        )
    except requests.RequestException:
        raise RuntimeError(f"Network error. {advice}") from None
    if not response.ok:
        raise RuntimeError(f"HTTP {response.status_code}. {advice}")
    try:
        body = response.json()
    except ValueError:
        raise RuntimeError(f"Response is not JSON. {advice}") from None
    if not isinstance(body, dict):
        raise RuntimeError(f"Unexpected response shape. {advice}")
    if body.get("code") != 200 or not isinstance(body.get("data"), dict):
        raise RuntimeError(f"API error: code={body.get('code')}. {advice}")
    return body["data"]

# Submit once. No automatic POST retries.
created = api_request("POST", API, json=payload)
task_id = created.get("taskId")
if not isinstance(task_id, str) or not task_id:
    raise RuntimeError("Missing taskId; check task history before resubmitting.")
print("taskId:", task_id)  # Keep this ID to resume GET queries.
deadline = time.monotonic() + 1800
while time.monotonic() < deadline:
    data = api_request("GET", f"{API}/{task_id}")
    status = data.get("status")
    if status == "fail":
        raise RuntimeError(f"Task failed: {task_id}; inspect its task record.")
    if status == "success":
        break
    if status not in ("queued", "handling", "archiving"):
        raise RuntimeError(f"Unexpected task status: {status}")
    time.sleep(8)
else:
    raise TimeoutError(f"Polling timed out; continue GET for taskId={task_id}.")

raw_outputs = data.get("output")
if not isinstance(raw_outputs, list):
    raise RuntimeError(f"Missing output list; inspect taskId={task_id}.")
outputs = {
    item["type"]: item
    for item in raw_outputs
    if isinstance(item, dict) and item.get("type") in ("video", "caption")
}
if "video" not in outputs:
    raise RuntimeError("Successful task has no video artifact.")
for kind, artifact in outputs.items():
    if not isinstance(artifact.get("url"), str) or not artifact["url"]:
        raise RuntimeError(f"Missing {kind} URL; inspect taskId={task_id}.")
    suffix = payload["input"]["output_format"] if kind == "video" else "srt"
    target = Path(f"avatar-v.{suffix}")
    # Artifact downloads do not need the API Authorization header.
    with requests.get(artifact["url"], stream=True, timeout=(10, 120)) as response:
        response.raise_for_status()
        with target.open("wb") as file:
            for chunk in response.iter_content(chunk_size=1024 * 1024):
                if chunk:
                    file.write(chunk)
    print("saved:", target)
どのパラメータを明示的に設定する必要がある?
| フィールド | ルールとデフォルト値 |
|---|---|
avatar |
必須、英語のアバターリクエスト値 |
prompt / audio_url |
どちらか一方;セリフは最大5,000文字、音声は最長600秒、最大32 MiB |
voice |
セリフ経路では任意、デフォルトは Warm Pro Narrator |
resolution |
デフォルトは 720p、1080p、小文字の 4k が選択可能 |
aspect_ratio |
デフォルトは 16:9;他に 9:16、4:5、5:4、1:1、auto |
fit |
デフォルトは cover、contain が選択可能 |
caption |
デフォルトは false;true で独立した SRT を返す |
output_format |
デフォルトは mp4、webm が選択可能 |
remove_background |
デフォルトは false;透過用途では true を webm と組み合わせ、まず短い動画で選択したアバターを確認 |
background |
オブジェクト;type は color または image、value には16進カラーまたは HTTP(S) 画像 URL を指定 |
解像度とアスペクト比は別々のパラメータです。横長の解説には16:9、縦長の口播には9:16を使い、いずれもリクエストに明記します。ダウンロード後にファイルの実際のサイズを確認してください。透過 WebM は、選択したアバターの背景除去効果を確認してから編集ソフトにインポートします。
字幕は画面に焼き込まれないため、プレーヤーや編集ソフトで重ねる必要があります。次の縦長ケースは caption=true を設定し、独立した SRT を返します。動画は1080×1920、6.52秒で、リクエストは1080p、9:16です。独立したSRT 字幕は編集時にインポートできます。
New drop just landed: our travel mug keeps coffee hot for twelve hours. Swipe up and grab yours today!
このプロンプトで生成 → セリフは入力済みです。Riley Casual Front、Charming Charles - Friendly、9:16、1080p を手動で選び、字幕を有効にし、出力は MP4 を選択してください。
公開前に確認する4項目は?
- 入力の検証:アバター、駆動方式、英語のリクエスト値、長さ制限。
- タスク ID の保存:照会失敗やタイムアウト後も同じ ID で GET を続ける。
- 成果物を揃える:成功後は
typeで video を探し、字幕有効時は caption を探す。 - ダウンロード確認:実際のサイズ、音声、字幕ファイルを確認してから納品する。
よくある問題の対処法は?
- **入力検証に問題がある:**
avatar、どちらか一方の駆動フィールド、英語のリクエスト値、セリフと音声の上限を確認します。解像度は4kと書き、durationを削除します。 - **POST がタイムアウト:**まずタスク記録を照会します。
taskIdが既にあれば GET を続けます。POST のたびに新しいタスクが作成されるためです。 - **タスクが
fail:**タスク記録のエラー原因を確認し、該当する入力を修正してから再送信します。 - **ダウンロードリンクの期限切れ:**成功後は早めに成果物を保存します。字幕は
type=captionから読み取ります。
サーバー側では input と同じ階層に "callback": {"url": "https://yourapp.com/webhook", "when": "final"} を追加でき、終状態のタスクオブジェクトを受け取り、GET で補完照会できます。
料金の詳細は秒単価と予算表、アバターの変更は2つのケース、完全な値はAPI パラメータドキュメントをご覧ください。
このプロンプトで生成 → セリフは入力済みです。ビジネス向けのアバターと音声、1080p、16:9、MP4 を手動で選び、まず1文だけ生成してから完全なスクリプトに接続してください。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする