
튜토리얼
HeyGen Avatar V API는 어떻게 사용하나요? 아바타 선택부터 완성 영상 다운로드까지
대사와 오디오 두 가지 경로, 아바타·음성 값 조회, cURL, 응답 구조, 제한된 폴링, 영상/SRT 다운로드 포함.
HeyGen Avatar V는 프리셋 디지털 휴먼을 하나 선택하고 대사나 오디오를 입력하면 입모양이 동기화된 영상을 생성합니다. HiAPI는 출력 길이 기준으로 초당 $0.15, 10초 영상은 $1.50를 청구합니다.
HeyGen Avatar V는 HiAPI에 출시되었습니다. 모델 페이지 열기에서 먼저 아바타와 음성을 선택한 뒤 API를 연동하세요. 아래 비즈니스 설명 영상은 이미 완성된 결과물입니다:
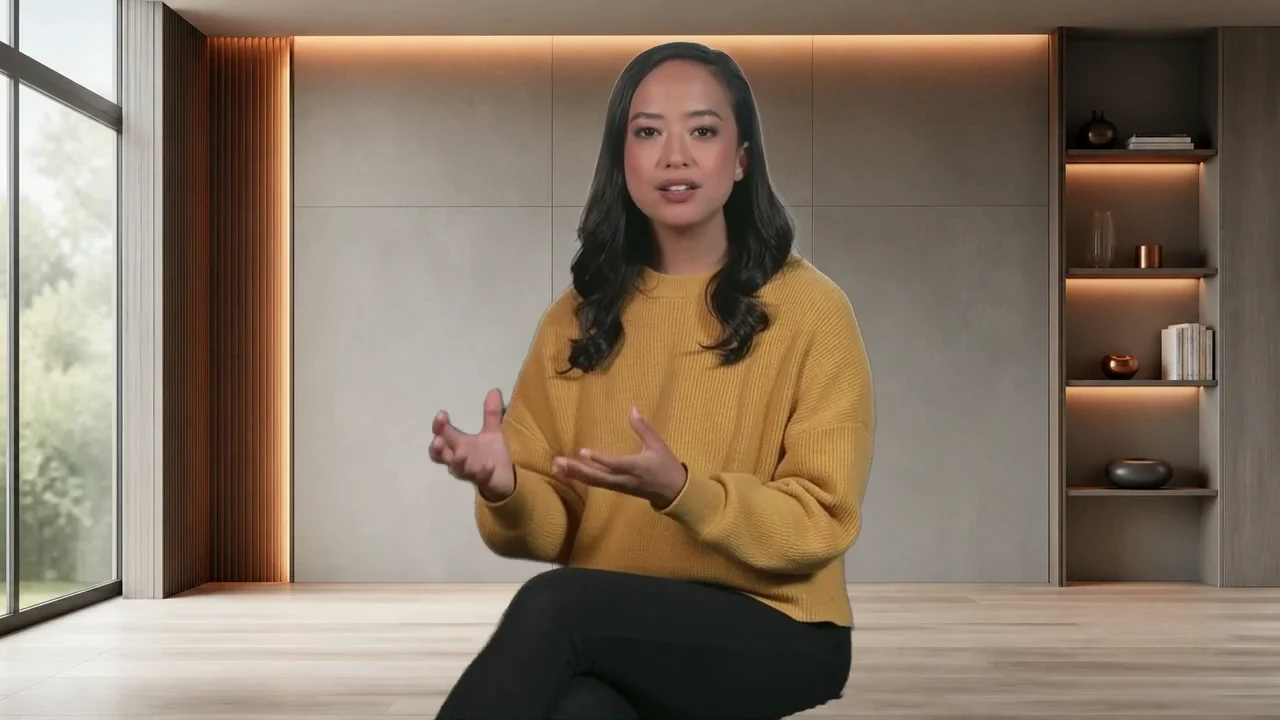
Brandon Office Sitting Front, Dexter - Professional; 16:9, 완성 영상 1280×720, 약 8초. 원래 요청은 1080p이며, 이 페이지는 720p 웹 버전입니다.
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.
이 프롬프트로 생성하기 → 대사는 이미 입력되어 있습니다. 위에서 아바타, 음성, 1080p, 16:9를 직접 선택하고 출력은 MP4를 선택하세요.
온라인에서 어떻게 시험하나요?
- 미리 채워진 링크를 열고 이 짧은 대사를 유지합니다.
- 아바타와 음성을 선택하세요. 이 매개변수는 직접 선택해야 하며, 링크는 대사만 불러옵니다.
- 화면 비율, 해상도, 형식을 설정하세요. 첫 시도에는 위 조합을 사용하면 됩니다.
- 생성 후 더빙을 들어보고 입모양을 확인한 뒤 완성 영상을 다운로드하고, 자신의 문구로 바꾸세요.
이번 시험에서 사용한 아바타, 음성, 화면 비율을 기록해 두고 일괄 생성 시 그대로 유지하면서 대사만 바꾸면 출연자와 음성을 일관되게 유지할 수 있습니다.
V는 프리셋 아바타 중에서 출연자를 선택합니다. 자신의 사진을 출연시키려면 Avatar IV를 선택하세요.
모든 해상도는 실제 출력 초 단위로 청구되며, 실패 시 전액 환불됩니다. 전체 비용은 가격 및 예산표를 참고하세요.
API에 무엇을 준비해야 하나요?
콘솔에서 API key를 생성하세요. 요청에 model, 필수인 input.avatar를 명시하고, prompt와 audio_url 중 하나를 선택하세요. 아바타와 음성은 문서 카드의 영문 요청값을 사용하며, 중국어 이름은 식별용으로만 사용합니다.
대사는 그대로 읽히므로 카메라 지시문을 prompt에 넣지 마세요. 오디오 구동 시 접근 가능한 HTTP(S) 주소를 전달하고 prompt와 voice를 제거하세요. duration은 전달할 필요가 없으며, 길이는 대사 낭독이나 오디오에 따라 결정됩니다.
| 가진 것 | 전달할 구동 필드 |
|---|---|
| 읽어야 할 대사 | avatar + prompt; voice 선택 사항 |
| 이미 녹음한 음성 | avatar + audio_url; prompt와 voice 생략 |
아바타 값 조회: 매개변수 문서 → 디지털 휴먼 아바타에서 전체를 펼친 뒤 검색하여 영문 'Request value'를 복사하세요. 음성도 마찬가지로 프리셋 음성에서 찾으세요. 영문 페이지에서는 Request value에 해당하며, 중국어 표시 이름을 요청에 넣지 마세요.
**오디오 구동 최소 전체 요청:** 자리 표시자 주소를 자신의 공개 접근 가능한 오디오 URL로 바꾸세요. 생략한 화면 비율, 해상도, 형식은 문서 기본값을 사용합니다. 오디오는 최대 600초, 최대 32 MiB입니다.
{
  "model": "heygen-avatar-v",
  "input": {
    "avatar": "Brandon Office Sitting Front",
    "audio_url": "https://example.com/your-recording.mp3"
  }
}
cURL로 작업 생성 및 조회하기
Key 자리 표시자를 자신의 값으로 바꾸세요. 이 요청은 비즈니스 사례 매개변수를 그대로 사용합니다:
export HIAPI_API_KEY="sk-YOUR_KEY"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-v",
    "input": {
      "avatar": "Brandon Office Sitting Front",
      "prompt": "Hi, I\u0027m Daniel. Send me your quarterly numbers, and I\u0027ll walk your team through what changed and what to do next.",
      "voice": "Dexter - Professional",
      "aspect_ratio": "16:9",
      "resolution": "1080p",
      "caption": false,
      "output_format": "mp4"
    }
  }'
HTTP 상태와 JSON의 code를 확인하고, 성공적으로 생성되면 data.taskId를 저장하세요. 이후에는 동일한 작업만 조회합니다:
TASK_ID="REPLACE_WITH_data.taskId"
curl --fail-with-body --connect-timeout 10 --max-time 60 \
  "https://api.hiapi.ai/v1/tasks/$TASK_ID" \
  -H "Authorization: Bearer $HIAPI_API_KEY"
queued, handling, archiving은 처리 중을 의미하며, 종료 상태는 success 또는 fail입니다. 성공 후 data.output[].type을 기준으로 video를 찾고, 자막을 활성화한 경우 caption도 찾으세요. 산출물의 url을 읽고 expireAt에 맞춰 제때 다운로드하세요.
**응답 구조 예시:** 첫 번째는 생성 성공, 두 번째는 자막 활성화 후 성공 조회입니다. 작업 ID, URL, 만료 시간은 모두 예시 값이며, expireAt은 숫자로 Unix 초 단위입니다. POST가 타임아웃되거나 응답이 유실된 경우 먼저 작업 기록을 조회하고, 무작정 다시 POST하지 마세요. ID가 있으면 GET을 계속하세요.
{
  "code": 200,
  "data": {"taskId": "TASK_ID_FROM_CREATE"}
}
{
  "code": 200,
  "data": {
    "taskId": "TASK_ID_FROM_CREATE",
    "status": "success",
    "output": [
      {"type": "video", "url": "https://example.com/result.mp4", "expireAt": 4070908800},
      {"type": "caption", "url": "https://example.com/result.srt", "expireAt": 4070908800}
    ]
  }
}
Python: 생성, 제한된 폴링, 다운로드
먼저 requests를 설치하고 환경 변수 HIAPI_API_KEY에 Key를 설정하세요. 코드는 한 번만 제출하며, 폴링은 최대 30분입니다. 타임아웃 시 작업 ID를 보관하고 조회를 계속하세요.
import os
import time
from pathlib import Path
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}
payload = {
    "model": "heygen-avatar-v",
    "input": {
        "avatar": "Brandon Office Sitting Front",
        "prompt": "Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.",
        "voice": "Dexter - Professional",
        "aspect_ratio": "16:9",
        "resolution": "1080p",
        "caption": False,
        "output_format": "mp4",
    },
}

def api_request(method, url, **kwargs):
    advice = (
        "Submission state may be unknown; check task history before another POST."
        if method == "POST"
        else f"Continue GET with the saved task ID: {url.rsplit('/', 1)[-1]}."
    )
    try:
        response = requests.request(
            method, url, headers=HEADERS, timeout=(10, 30), **kwargs
        )
    except requests.RequestException:
        raise RuntimeError(f"Network error. {advice}") from None
    if not response.ok:
        raise RuntimeError(f"HTTP {response.status_code}. {advice}")
    try:
        body = response.json()
    except ValueError:
        raise RuntimeError(f"Response is not JSON. {advice}") from None
    if not isinstance(body, dict):
        raise RuntimeError(f"Unexpected response shape. {advice}")
    if body.get("code") != 200 or not isinstance(body.get("data"), dict):
        raise RuntimeError(f"API error: code={body.get('code')}. {advice}")
    return body["data"]

# Submit once. No automatic POST retries.
created = api_request("POST", API, json=payload)
task_id = created.get("taskId")
if not isinstance(task_id, str) or not task_id:
    raise RuntimeError("Missing taskId; check task history before resubmitting.")
print("taskId:", task_id)  # Keep this ID to resume GET queries.
deadline = time.monotonic() + 1800
while time.monotonic() < deadline:
    data = api_request("GET", f"{API}/{task_id}")
    status = data.get("status")
    if status == "fail":
        raise RuntimeError(f"Task failed: {task_id}; inspect its task record.")
    if status == "success":
        break
    if status not in ("queued", "handling", "archiving"):
        raise RuntimeError(f"Unexpected task status: {status}")
    time.sleep(8)
else:
    raise TimeoutError(f"Polling timed out; continue GET for taskId={task_id}.")

raw_outputs = data.get("output")
if not isinstance(raw_outputs, list):
    raise RuntimeError(f"Missing output list; inspect taskId={task_id}.")
outputs = {
    item["type"]: item
    for item in raw_outputs
    if isinstance(item, dict) and item.get("type") in ("video", "caption")
}
if "video" not in outputs:
    raise RuntimeError("Successful task has no video artifact.")
for kind, artifact in outputs.items():
    if not isinstance(artifact.get("url"), str) or not artifact["url"]:
        raise RuntimeError(f"Missing {kind} URL; inspect taskId={task_id}.")
    suffix = payload["input"]["output_format"] if kind == "video" else "srt"
    target = Path(f"avatar-v.{suffix}")
    # Artifact downloads do not need the API Authorization header.
    with requests.get(artifact["url"], stream=True, timeout=(10, 120)) as response:
        response.raise_for_status()
        with target.open("wb") as file:
            for chunk in response.iter_content(chunk_size=1024 * 1024):
                if chunk:
                    file.write(chunk)
    print("saved:", target)
어떤 매개변수를 명시적으로 설정해야 하나요?
| 필드 | 규칙 및 기본값 |
|---|---|
avatar |
필수, 영문 아바타 요청값 |
prompt / audio_url |
둘 중 하나; 대사 최대 5,000자, 오디오 최대 600초, 최대 32 MiB |
voice |
대사 경로에서 선택 사항, 기본값 Warm Pro Narrator |
resolution |
기본값 720p, 선택 가능 1080p, 소문자 4k |
aspect_ratio |
기본값 16:9; 그 외 9:16, 4:5, 5:4, 1:1, auto |
fit |
기본값 cover, 선택 가능 contain |
caption |
기본값 false; true이면 별도 SRT 반환 |
output_format |
기본값 mp4, 선택 가능 webm |
remove_background |
기본값 false; 투명 용도에는 true와 webm을 함께 사용하고, 먼저 짧은 영상으로 선택한 아바타를 확인하세요 |
background |
객체; type은 color 또는 image, value에는 16진수 색상 또는 HTTP(S) 이미지 URL 입력 |
해상도와 화면 비율은 별개의 매개변수입니다. 가로형 설명에는 16:9, 세로형 구두 방송에는 9:16을 사용하며, 모두 요청에 명시하세요. 다운로드 후 파일의 실제 크기를 한번 확인하세요. 투명 WebM은 선택한 아바타의 배경 제거 효과를 먼저 확인한 뒤 편집 소프트웨어로 가져오세요.
자막은 영상에 직접 새겨지지 않으며, 플레이어나 편집 소프트웨어에서 오버레이해야 합니다. 아래 세로형 사례는 caption=true로 설정하여 별도 SRT를 반환합니다. 영상은 1080×1920, 6.52초이며, 요청은 1080p, 9:16입니다. 별도 SRT 자막은 편집 시 가져올 수 있습니다.
New drop just landed: our travel mug keeps coffee hot for twelve hours. Swipe up and grab yours today!
이 프롬프트로 생성하기 → 대사는 이미 입력되어 있습니다. Riley Casual Front, Charming Charles - Friendly, 9:16, 1080p를 직접 선택하고 자막을 켜고 출력은 MP4를 선택하세요.
출시 전에 무엇을 점검해야 하나요?
- 입력 검증: 아바타, 구동 방식, 영문 요청값, 길이 제한을 확인하세요.
- 작업 ID 저장: 조회 실패나 타임아웃 시 같은 ID로 GET을 계속하세요.
- 산출물 모두 찾기: 성공 후
type을 기준으로 video를 찾고, 자막을 켠 경우 caption도 찾으세요. - 다운로드 점검: 실제 크기, 소리, 자막 파일을 확인한 뒤 전달하세요.
일반적인 문제는 어떻게 처리하나요?
- **입력 검증 문제:**
avatar, 둘 중 하나의 구동 필드, 영문 요청값, 대사와 오디오 상한을 확인하세요. 해상도는4k로 쓰고,duration은 삭제하세요. - **POST 타임아웃:** 먼저 작업 기록을 조회하세요. 이미
taskId가 있으면 GET을 계속하세요. 매번 POST할 때마다 새 작업이 생성됩니다. - **작업
fail:** 작업 기록에서 오류 원인을 확인하고, 해당 입력을 수정한 뒤 다시 제출하세요. - **다운로드 링크 만료:** 성공 후 산출물을 제때 저장하세요. 자막은
type=caption에서 읽으세요.
서버 측에서는 input과 같은 레벨에 "callback": {"url": "https://yourapp.com/webhook", "when": "final"}를 추가하여 종료 상태 작업 객체를 받고, GET으로 보완 조회할 수 있습니다.
가격 세부 사항은 초당 단가 및 예산표를, 아바타 교체는 두 가지 사례를, 전체 값은 API 매개변수 문서를 참고하세요.
이 프롬프트로 생성하기 → 대사는 이미 입력되어 있습니다. 비즈니스 아바타와 음성, 1080p, 16:9, MP4를 직접 선택하고 먼저 한 문장을 생성한 뒤 전체 스크립트를 연동하세요.
관련 글
모든 아티클 보기 →-

튜토리얼
HiAPI API로 hailuo-2.3-fast/image-to-video 호출하는 방법: curl과 Python 실전
빠르고 저렴한 이미지-투-비디오 등급의 첫 실행 요청 — 모델 ID부터 MP4 다운로드까지
-

튜토리얼
HiAPI API로 hailuo-2.3/text-to-video를 호출하는 방법: curl, Python 및 실행 가능한 요청 예시
-

튜토리얼
HiAPI에서 Kandinsky 6.0 Pro 텍스트-투-비디오 사용하기: curl 및 Python 튜토리얼
요청 우선 실전 데모: 프롬프트에서 비디오 클립까지의 호출 구성, 요청 제출, 완료 상태 폴링 및 결과 다운로드