
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Загрузите одно фото и сценарий, чтобы создать видео с говорящим аватаром с синхронизацией губ, мимикой и жестами; поддерживается вывод в разрешении 1280p+, что подходит для цифровых ведущих и озвученного контента
Попробовать heygen-avatar-iv
Ввод
Работы
Все работыВывод
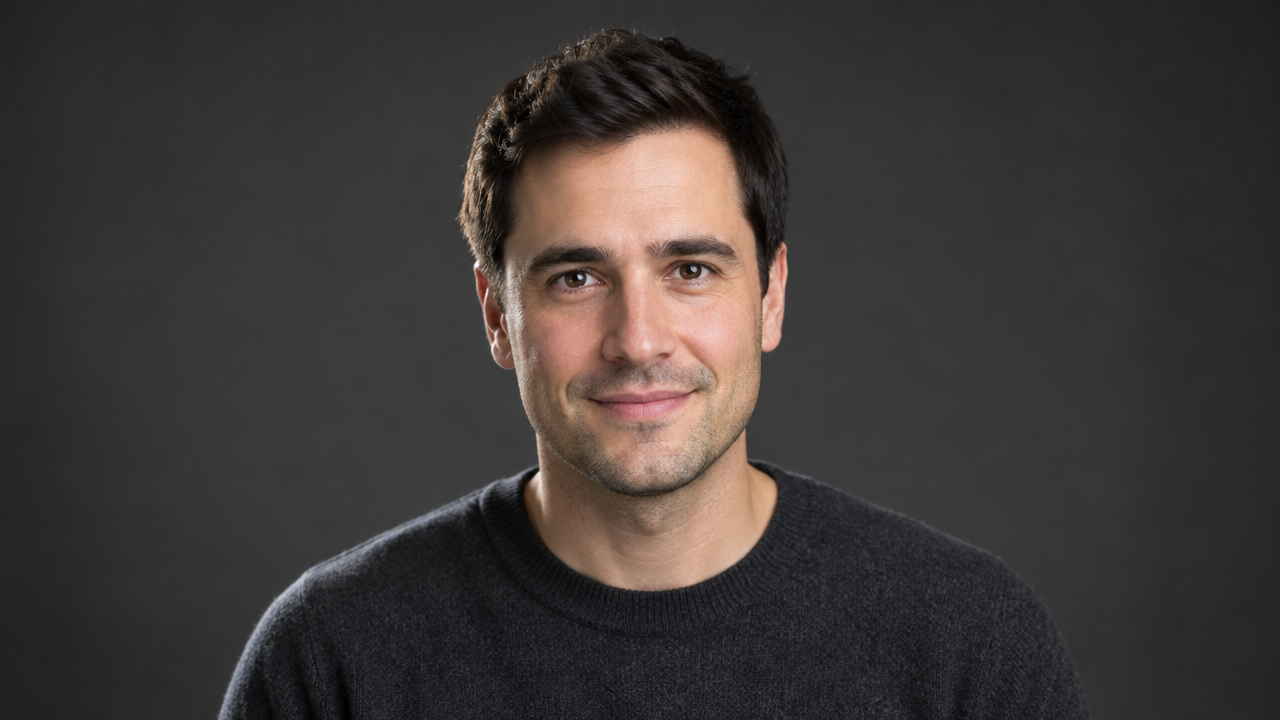
videoHeyGen Avatar IV: иллюстрация возможностей преобразования текста в видео
Стиль Голосовое озвучивание · Пояснения · Видео с аватаром
Референсные входы
image_url
Промпт
Ведущий говорит прямо в камеру в лаконичной студийной обстановке: поясной портрет, фронтальный ракурс, устойчивый зрительный контакт с камерой, лёгкие движения головы и естественные жесты в такт речи; мягкий основной свет слева спереди с деликатным заполняющим светом, нейтральный тёмно-серый бесшовный фон, малая глубина резкости, широкоэкранный кадр 1080p 16:9, реалистичный корпоративный стиль объяснения, спокойный уверенный темп.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
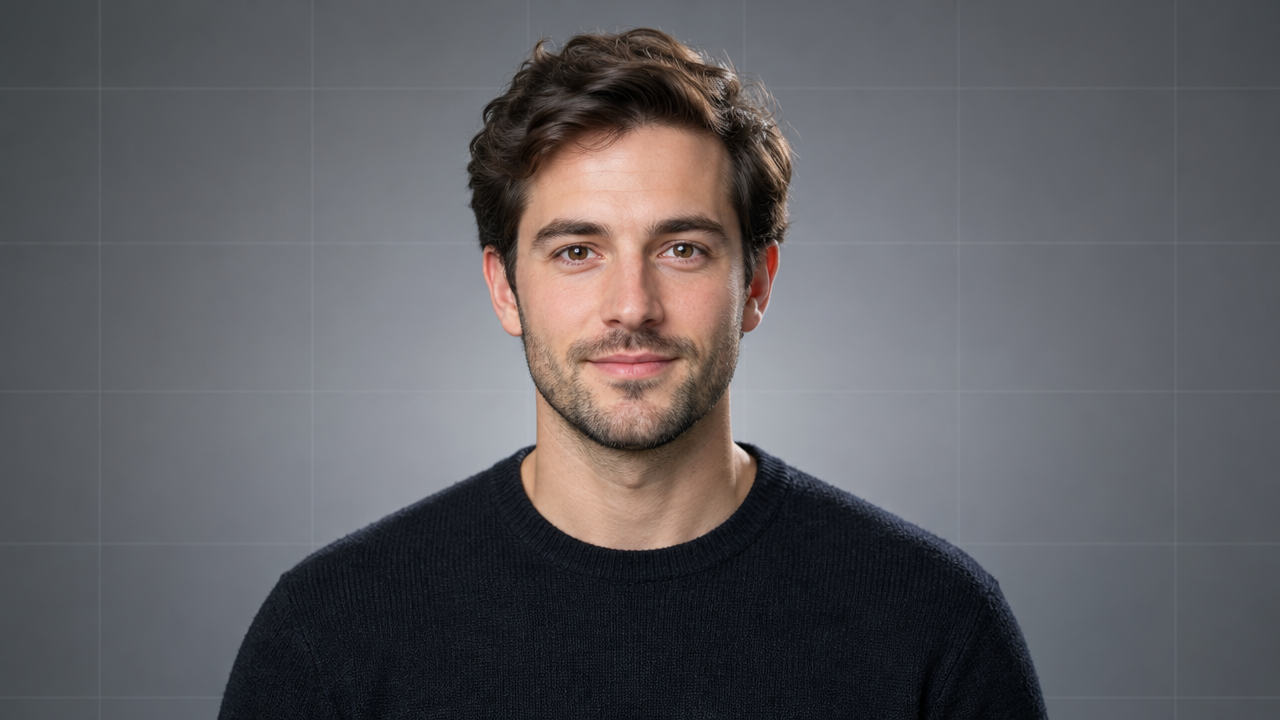
Карточка формулы промпта HeyGen Avatar IV: визуальное руководство по структурированной записи
Стиль Пояснения · Промпт-инжиниринг · говорящий аватар
Референсные входы
image_url
Промпт
Ведущий анфас в аккуратной студийной декорации говорит прямо в камеру, поднимая распечатанную карточку-шпаргалку с формулой промпта; средне-крупный план, медленный лёгкий наезд камеры и мягкое ручное покачивание, мягкий основной свет с контровым светом для отделения от фона, малая глубина резкости, благодаря которой края карточки остаются чёткими и читаемыми, а лицо — резким; спокойный, обучающий ритм, в каждом абзаце небольшой естественный жест в сторону карточки, фон — мягкий нейтральный градиент с едва заметными линиями сетки, намекающими на макет документа; изображение чёткое, высокая детализация, качество 1080p.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Визуальные заметки о языке движения камеры: демонстрация закадровой речи Avatar IV
Стиль язык-камеры · говорящий аватар · Пояснения
Референсные входы
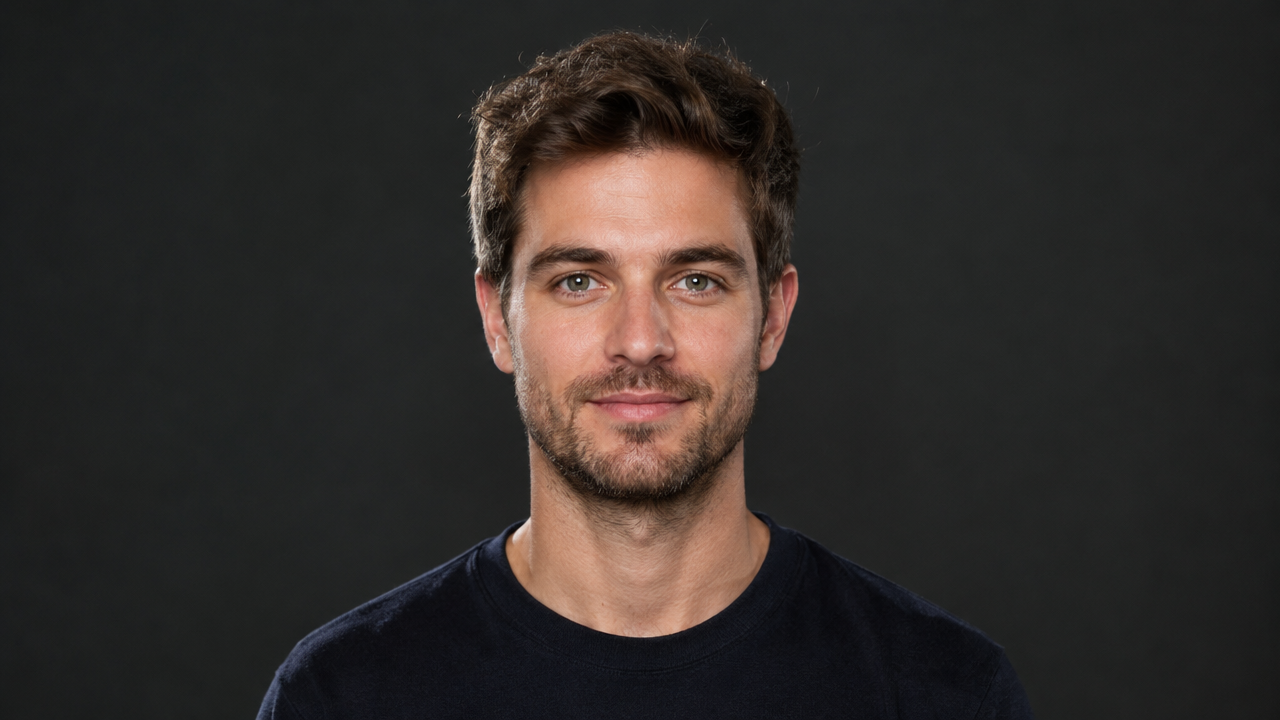
image_url
Промпт
Человек в кадре, обращённый лицом к камере, говорит прямо в объектив спокойным, пояснительным тоном, словно комментирует перед камерой визуальные заметки о движении камеры. Взгляд устойчиво направлен в объектив, голова слегка и естественно двигается, время от времени он делает пояснительные жесты, показывая панорамирование, наезд и наклон камеры. Нейтральная студийная композиция с равномерным освещением, фон тёмный и малосатурированный, общая атмосфера записи экрана, размеренный темп, с короткими паузами между каждым термином движения камеры.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Концепция раскадровки HeyGen Avatar IV: от текста к говорящему изображению
Стиль говорящий аватар · Раскадровка · Повествование
Референсные входы
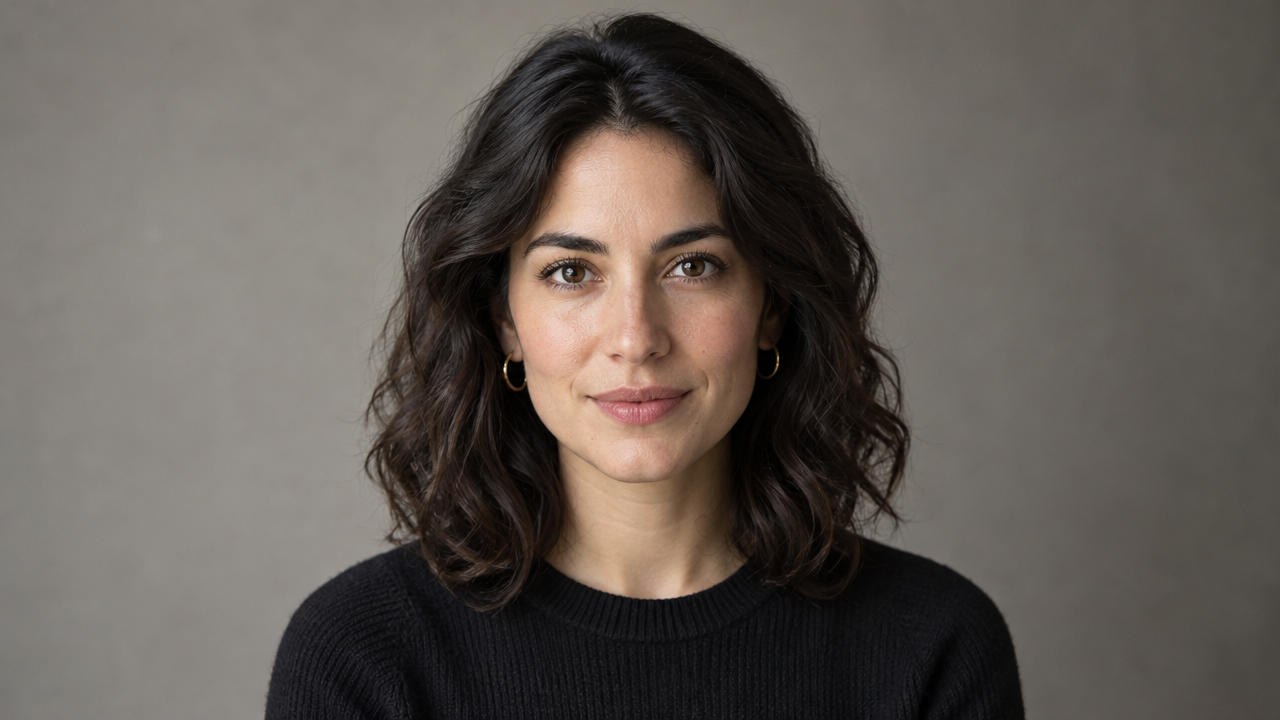
image_url
Промпт
Фронтальный одиночный портрет превращается в говорящее видео: человек естественно синхронизирует артикуляцию, произнося короткий закадровый текст раскадровки, с лёгкими движениями головы и выразительной жестикуляцией, в кадре 16:9 на чистом нейтральном фоне, стабильный средне-крупный план, мягкий основной свет, сдержанный уверенный ритм.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
heygen-avatar-iv per second
| Цена за единицу | $0.150 |
|---|
Описание позиционирования
heygen-avatar-iv — это модель видео с говорящей головой от HeyGen, вызываемая через единый интерфейс HiAPI.ai. Разработчик загружает одну фотографию лица анфас, а затем передаёт текст сценария или аудио, и модель генерирует говорящее видео с синхронизацией губ, мимикой и жестами. Поддерживается вывод в 720p и 1080p, а также различные соотношения сторон, что подходит разработчикам и контент-командам, которым нужно быстро создавать цифровых спикеров или материалы с речью персонажей.
Ключевые возможности
- Одна фотография создаёт полноценное говорящее видео — достаточно одной фотографии анфас вместе со сценарием или аудио; съёмка или создание трёхмерных ассетов не требуются, результат получается сразу.
- Мимика и жесты синхронизируются с речью — результат не ограничивается совпадением движения губ: выражения лица и движения головы естественно меняются вслед за речью, создавая ощущение, близкое к выступлению реального человека.
- Два варианта ввода: текст сценария и аудио — можно напрямую указать сценарий и выбрать тембр голоса либо передать HTTPS-аудио для синхронизации губ, что удобно для существующих процессов озвучивания.
- Настраиваемые пропорции и фон — доступны соотношения 16:9, 9:16, 1:1 и другие, а также заполнение кадра сплошным цветом или изображением.
Описание возможностей
Генерация говорящего видео по фотографии: при передаче одной фотографии лица анфас модель создаёт говорящее видео; результат — видеофайл, который можно использовать как готовый материал или для последующего монтажа.
Преобразование сценария в речь с синхронизацией губ: укажите текст сценария и выберите встроенный тембр голоса — модель синтезирует речь и заставит аватар говорить; максимальная длина одного сценария — 5000 символов.
Синхронизация губ по аудио: при передаче HTTPS-ссылки на аудио фотография будет говорить в соответствии с движением губ из аудио; максимальная длина одной аудиозаписи — 600 секунд, при этом параметры сценария и тембра голоса не применяются.
Управление параметрами вывода: можно выбрать разрешение 720p или 1080p и задать соотношение сторон 16:9, 9:16, 4:5, 5:4, 1:1 или следовать пропорциям исходного изображения, что подходит для горизонтальных, вертикальных и квадратных площадок публикации.
Заполнение фона изображения: если пропорции вывода не совпадают с пропорциями фотографии, пустые области можно заполнить сплошным цветом или изображением, чтобы избежать пустых полей в кадре.
Сценарии применения
- Маркетинговые команды создают видео с цифровым спикером — используйте продуктовый сценарий вместе с фотографией фирменного персонажа для генерации видео с речью, чтобы размещать его на сайте, в рекламных блоках и соцсетях без необходимости съёмок с реальным человеком и составления графика.
- Учебные отделы создают материалы для объясняющих курсов — преобразуйте учебные материалы в сценарии и пакетно создавайте видео с единым образом преподавателя для встраивания в обучающую платформу или учебные материалы.
- Авторы коротких видео создают вертикальные ролики с речью — выбирайте формат 9:16 и нужный тембр голоса для создания вертикального материала с речью, который сразу подходит для обновления контента на платформах коротких видео.
- Адаптация многоязычного контента с уже готовой озвучкой — передавайте уже готовое аудио для синхронизации губ и вместе с фотографией создавайте видео с речью на соответствующем языке для локализации контента.
Ограничения и рекомендации по выбору
Входная фотография должна содержать чёткое лицо анфас; профиль, перекрытия или групповые снимки заметно ухудшают результат, и качество генерации сильно зависит от исходного изображения. На выходе получается видео, а не готовый текстовый материал, поэтому сценарий или аудио нужно подготовить заранее. Максимальная длина одной аудиозаписи — 600 секунд, сценария — 5000 символов; слишком длинный контент нужно генерировать по частям. Если нужен только предустановленный аватар или цифровой двойник реального человека, следует выбрать соответствующие другие линейки моделей.
Новости
Смотреть changelog →- Новая модель Новая модель: heygen-avatar-iv — загрузите портретную фотографию и создайте говорящее видео с синхронизацией губ по тексту реплики с предустановленным голосом или управляющим аудио; доступно…
Частые вопросы
Все частые вопросы →-
Какие входные данные нужны для HeyGen Avatar IV?
Одна портретная фотография и выбор способа управления: ввести текст реплики и выбрать голос либо загрузить аудиофайл. Если при использовании текста реплики не выбрать голос, будет использован голос по умолчанию Warm Pro Narrator.
-
Какие фотографии подходят лучше всего?
Наиболее надёжный результат дают одиночные фотографии анфас с чёткими, ничем не закрытыми чертами лица, равномерным освещением и естественно закрытым ртом. Фотографии в профиль, в маске, групповые снимки или снимки с очень маленьким лицом не подходят.
-
Какова длина выходного видео?
Указывать длительность не нужно. При озвучивании реплик длина определяется репликами и темпом речи; при управлении аудио она совпадает с длительностью загруженного аудио, максимум 600 секунд.
-
Какие соотношения сторон и разрешения поддерживаются?
Поддерживаются соотношения сторон 16:9, 9:16, 4:5, 5:4, 1:1 и auto (сохраняется соотношение сторон фотографии); разрешения — 720p и 1080p.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: heygen-avatar-iv
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для heygen-avatar-iv и маршрута default — см. таблицу параметров ниже.
voicestringНеобязательноПо умолчанию: "Warm Pro Narrator"minLength 1Задаёт тембр голоса, которым цифровой человек озвучивает сценарий; по умолчанию — Warm Pro Narrator. Если указан audio_url, этот параметр игнорируется.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyПоказать все (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringНеобязательноminLength 1maxLength 5000Текст сценария, который будет озвучивать цифровой человек; обязателен, если не указан audio_url.
audio_urlstringНеобязательноpattern ^https://HTTPS-адрес аудио для синхронизации губ, длительностью до 600 секунд; при его указании prompt и voice игнорируются.
image_urlstringОбязательноpattern ^https://HTTPS-адрес фотографии для анимации, должен содержать одно чёткое фронтальное лицо; поддерживаются форматы jpg, jpeg, png, webp, gif, avif, heic, heif.
backgroundobjectНеобязательно
Настройка фона, используемого для заполнения областей кадра, не занятых портретом, когда соотношение сторон вывода не совпадает с исходной фотографией; задаётся цветом или изображением, по умолчанию — белый.
typestringОбязательноСпособ заполнения фона, определяющий, как интерпретируется поле value — как цвет или как URL изображения.
colorimagevaluestringОбязательноminLength 1Конкретное значение фона: при type «цвет» передаётся шестнадцатеричный цвет #RRGGBB, при type «изображение» — HTTPS-адрес изображения.
resolutionstringНеобязательноПо умолчанию: "720p"Разрешение выходного видео, по умолчанию 720p.
720p1080paspect_ratiostringНеобязательноПо умолчанию: "16:9"Соотношение сторон выходного видео, по умолчанию 16:9; при значении auto приоритет отдаётся пропорциям исходной фотографии, а если их невозможно определить, используется 16:9.
16:99:164:55:41:1autocallbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата
-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как использовать kling-4.0/text-to-video через HiAPI API: curl, Python и рабочий пример запроса
Практическое руководство для разработчиков: кинематографичные промпты, синхронный звук, асинхронный опрос и скачивание результатов
-

Руководство
Как вызывать kling-4.0/image-to-video на HiAPI: curl, Python и опрос
-

Руководство
kandinsky-6.0-pro/image-to-video в HiAPI: руководство по curl + Python
Как выполнить рабочий запрос генерации видео из изображения в HiAPI: от загрузки первого кадра до асинхронного опроса и финальной загрузки
Похожие модели
Все модели →Тот же тип
-
 Creatify Boreal Creatify $0.015 /секунду
-
 Wan 3.0 Video Alibaba $0.040 /секунду
-
 LTX 2.5 Fast Lightricks $0.086 /секунду
-
 HappyHorse 1.1 Alibaba $0.160 /секунду
-
 Kling 3.0 Kuaishou $0.100 /секунду
-
 Veo 3.1 Google $0.290 /секунду
-
 Grok Imagine 1.5 xAI $0.011 /секунду
-
 Wan 2.7 Video Alibaba $0.100 /секунду
-
 Hailuo 2.3 MiniMax $0.270 /видео
-
 Kling 4.0 Kuaishou $0.330 /секунду
-
 FLUX 3 Max Black Forest Labs $0.061 /секунду
-
 Vidu Q4 Preview Vidu $0.051 /секунду
