
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Sube una sola foto y añade un guion para generar un vídeo de avatar parlante con sincronización labial, expresiones faciales y gestos; admite salida de 1280p o superior, ideal para presentadores digitales y contenido de locución.
Probar heygen-avatar-iv
Entrada
Creaciones
Ver todas las creacionesSalida
videoGuía visual de las capacidades de texto a video de HeyGen Avatar IV
Estilo Locución · Explicación · Video de avatar
Entradas de referencia
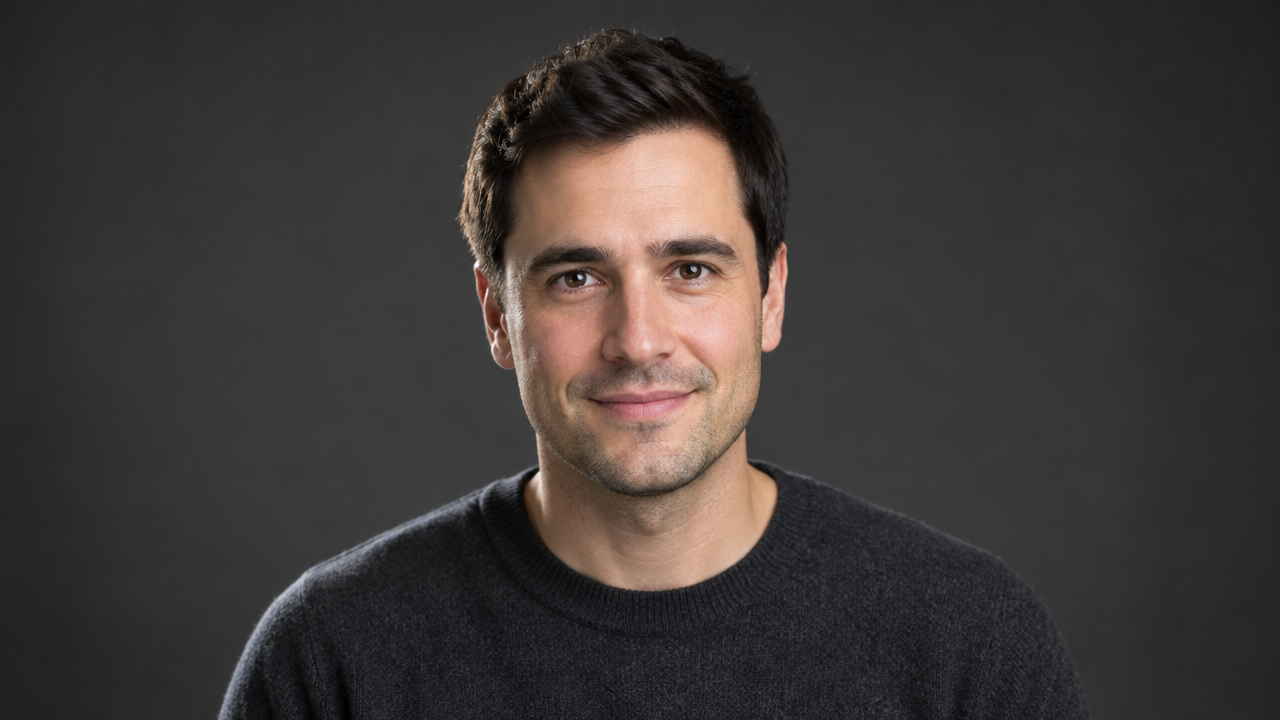
image_url
Prompt
Un presentador habla directamente a cámara en un decorado de estudio sencillo: encuadre de cabeza y hombros, orientación frontal, contacto visual estable con la cámara, ligeros movimientos de cabeza y gestos naturales acompasados con el ritmo del habla; luz principal suave desde la parte delantera izquierda con un relleno tenue, fondo continuo de gris oscuro neutro, profundidad de campo reducida, encuadre panorámico 16:9 en 1080p, estilo corporativo realista de presentación, ritmo sereno y seguro.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Tarjetas de fórmulas de prompts de HeyGen Avatar IV: guía visual de escritura estructurada
Estilo Explicación · Ingeniería de prompts · avatar parlante
Entradas de referencia
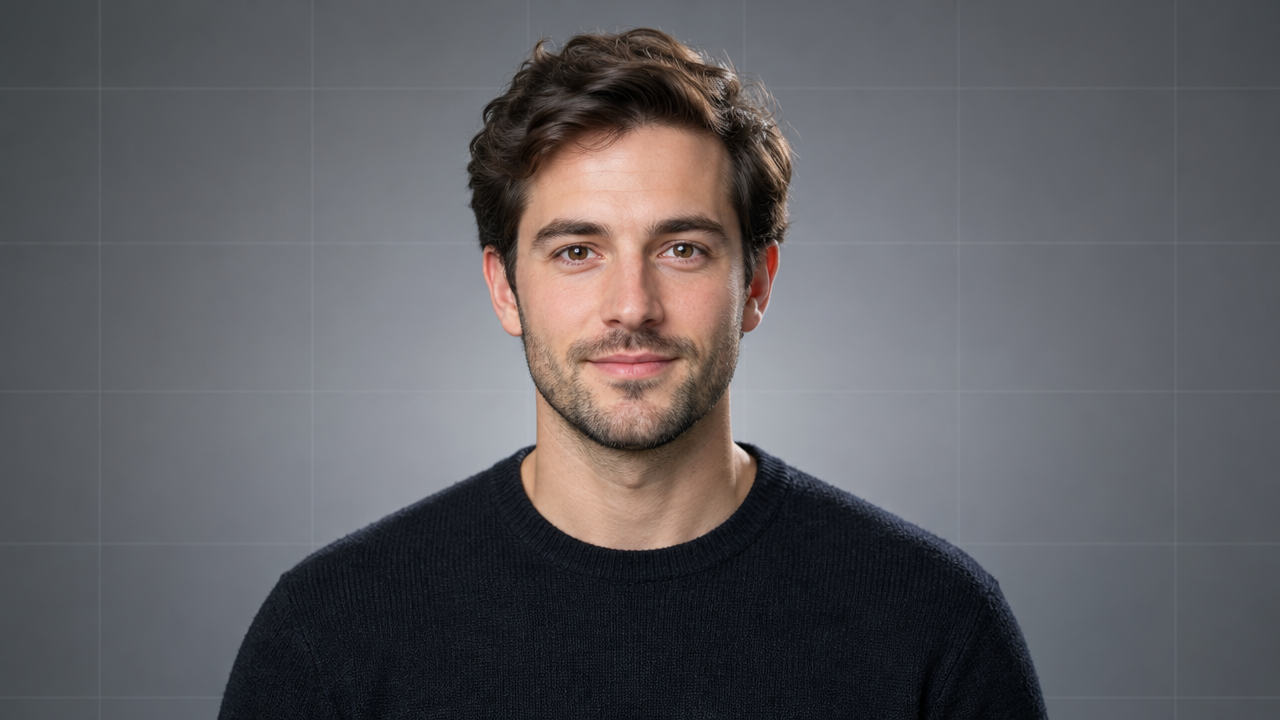
image_url
Prompt
Un presentador de frente habla directamente a cámara en un decorado de estudio pulcro y sostiene una ficha impresa con el índice de fórmulas de prompts; plano medio corto, lento y sutil acercamiento de cámara con una suave deriva de cámara en mano, luz principal suave combinada con luz de contorno para separar la figura, profundidad de campo reducida que mantiene los bordes de la tarjeta nítidos y legibles y el rostro aún afilado; ritmo pausado y con sensación didáctica, con pequeños gestos naturales señalando la tarjeta en cada sección, fondo de degradado neutro suave con tenues líneas de cuadrícula que sugieren la maquetación de un documento; imagen nítida, alto detalle, calidad 1080p.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
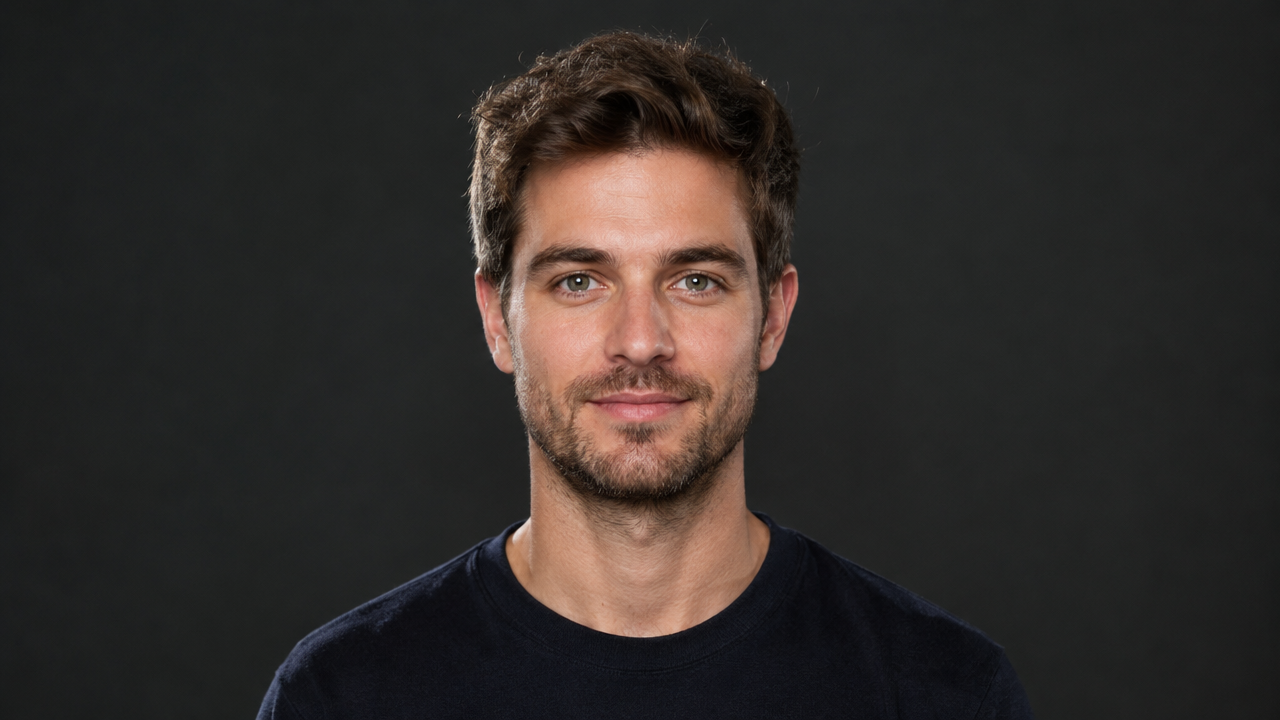
Notas visuales sobre el lenguaje de movimiento de cámara: demostración de locución con Avatar IV
Estilo lenguaje-de-cámara · avatar parlante · Explicación
Entradas de referencia
image_url
Prompt
Una persona frente a la cámara habla directamente a objetivo con un tono sereno y explicativo, como si estuviera comentando ante la cámara unas notas visuales sobre movimientos de cámara. Mantiene la mirada fija en el objetivo, con ligeros movimientos naturales de cabeza y gestos explicativos ocasionales que sugieren paneos, acercamientos y movimientos de inclinación. Composición de estudio neutra e iluminada de forma uniforme, con un fondo oscuro de baja saturación y una atmósfera general de grabación de pantalla, ritmo pausado y breves pausas entre cada término de movimiento de cámara.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
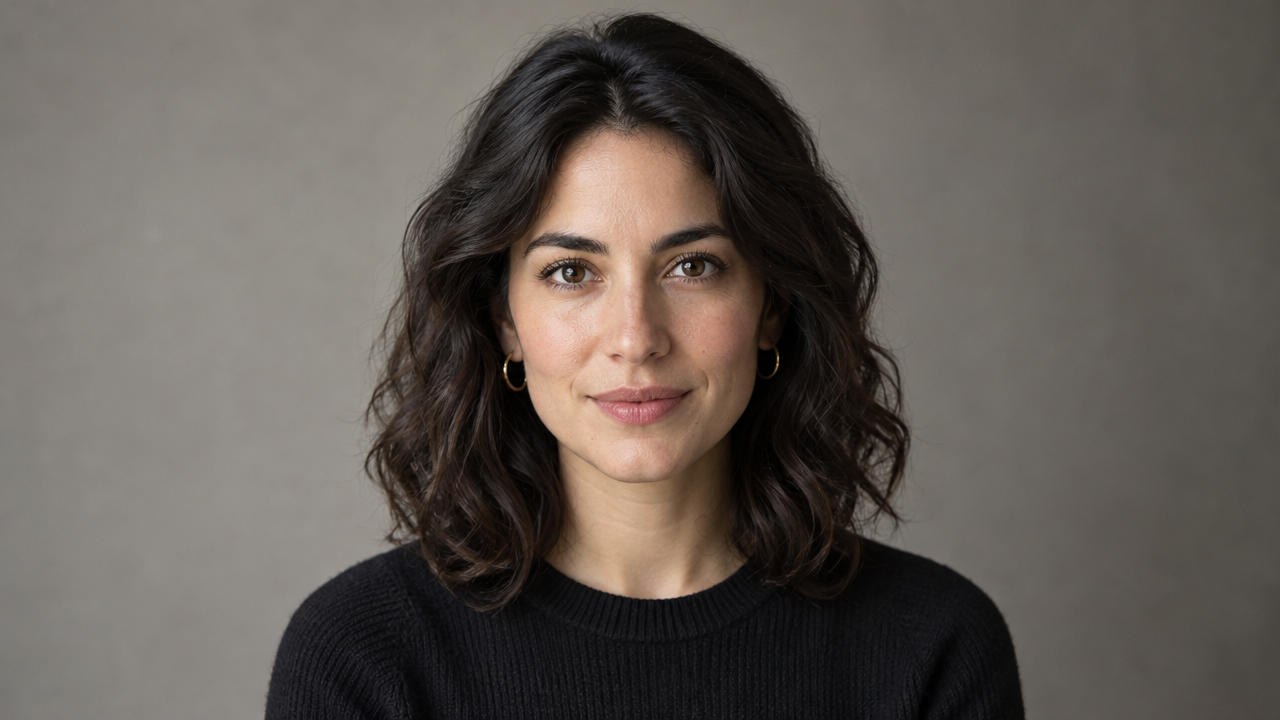
Concepto de storyboard de HeyGen Avatar IV: de texto a imagen hablada
Estilo avatar parlante · Guion gráfico · Narrativa
Entradas de referencia
image_url
Prompt
Un retrato individual frontal se convierte en un vídeo hablado: la persona narra con una sincronización labial natural un breve texto de storyboard en off, acompañado de ligeros movimientos de cabeza y gestos expresivos, en formato 16:9 con un fondo neutro y limpio, plano medio cercano estable, luz principal suave y un ritmo sereno y seguro.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
heygen-avatar-iv per second
| Precio unitario | $0.150 |
|---|
Descripción general
heygen-avatar-iv es un modelo de video de avatar parlante ofrecido por HeyGen, al que se accede mediante la interfaz unificada de HiAPI.ai. Los desarrolladores suben una foto de rostro frontal y proporcionan un guion de texto o un audio para generar un video parlante con sincronización labial, expresiones faciales y gestos. Admite salida en 720p y 1080p y varias relaciones de aspecto, lo que lo hace adecuado para desarrolladores y equipos de contenido que necesitan producir rápidamente materiales de portavoces digitales o de personajes que hablan a cámara.
Características principales
- Una sola foto impulsa todo el video parlante: basta una foto frontal junto con un guion o un audio, sin necesidad de rodaje ni de crear activos 3D para obtener el video final.
- Expresiones y gestos sincronizados con la voz: la salida no se limita a la sincronización labial; las expresiones faciales y los movimientos de cabeza varían de forma natural con la voz, acercándose a la apariencia de una persona real hablando a cámara.
- Entrada doble: guion de texto y audio: se puede escribir directamente un guion y elegir una voz, o pasar un audio HTTPS para la sincronización labial, lo que se adapta a flujos de doblaje ya existentes.
- Relación de aspecto y fondo configurables: ofrece varias proporciones como 16:9, 9:16 y 1:1, y permite especificar un fondo de color sólido o una imagen para rellenar el encuadre.
Capacidades
Generación de video parlante a partir de una foto: con una foto de rostro frontal se genera un video parlante; la salida es un archivo de video que puede usarse directamente como resultado final o para una edición posterior.
Conversión de guion a voz y sincronización labial: se escribe el texto del guion y se especifica una voz integrada; el modelo sintetiza la voz e impulsa al avatar a hablar, con un máximo de 5000 caracteres por guion.
Sincronización labial con audio: basta pasar un enlace de audio HTTPS para que la foto hable siguiendo la sincronización labial del audio, con un máximo de 600 segundos por audio; en este caso, los parámetros de guion y voz no surten efecto.
Control de especificaciones de salida: se puede elegir resolución de 720p o 1080p y establecer una relación de 16:9, 9:16, 4:5, 5:4, 1:1 o la de la imagen original, adaptándose a formatos horizontales, verticales y cuadrados.
Relleno del fondo del encuadre: cuando la relación de salida no coincide con la de la foto, se puede rellenar el área sobrante con un color sólido o una imagen de fondo para evitar bordes vacíos.
Casos de uso
- Equipos de marketing que crean videos con portavoces digitales: generar videos de locución con un guion de producto y una foto de una persona de la marca, para usarlos en el sitio web, espacios publicitarios y redes sociales sin necesidad de agendar a una persona real.
- Departamentos de formación que generan materiales de cursos explicativos: convertir los apuntes del curso en guiones y generar de forma masiva videos explicativos con una imagen uniforme, para incrustarlos en plataformas de aprendizaje o materiales didácticos.
- Creadores de video corto que producen locuciones verticales: elegir el formato 9:16 y una voz determinada para generar material de locución vertical, listo para actualizar el contenido en plataformas de video corto.
- Adaptación multilingüe de contenido con doblaje existente: pasar un audio de doblaje ya existente para la sincronización labial y generar con una foto la imagen de locución en el idioma correspondiente, para la localización de contenido.
Limitaciones y recomendaciones de selección
La foto de entrada debe ser un rostro claro y frontal; los perfiles, las obstrucciones o las fotos de grupo afectan notablemente el resultado, y la calidad de generación depende en gran medida de la imagen de origen. La salida es un video, no un texto final, por lo que es necesario preparar de antemano un guion o un audio. El audio tiene un límite de 600 segundos y el guion de 5000 caracteres; el contenido demasiado largo debe generarse por segmentos. Si solo se necesita un avatar con imagen predefinida o un clon digital de una persona real, conviene elegir la línea de otros modelos correspondiente.
Novedades
Ver el registro de cambios →- Nuevo modelo Nuevo modelo: heygen-avatar-iv, sube una foto de retrato y genera un vídeo de una persona hablando con sincronización labial usando un guion y una voz predefinida o un audio de conducción; ofrece…
Preguntas frecuentes
Ver todas las preguntas →-
¿Qué entradas requiere HeyGen Avatar IV?
Una foto de retrato y luego elegir un modo de conducción: introducir un guion y seleccionar una voz, o subir un audio. Si usas un guion sin seleccionar una voz, se utilizará la voz predeterminada Warm Pro Narrator.
-
¿Qué tipo de foto funciona mejor?
Las fotos individuales con el rostro de frente, rasgos faciales claros y sin obstrucciones, iluminación uniforme y boca cerrada de forma natural son las más fiables. Las fotos de perfil, con mascarilla, de grupo o en las que la cara es muy pequeña no son adecuadas.
-
¿Cuánto dura el video de salida?
No es necesario especificar la duración. En el doblaje de diálogos, la duración la determinan el texto y la velocidad del habla; con audio como control, coincide con la duración del audio subido, que puede ser de hasta 600 segundos.
-
¿Qué relaciones de aspecto y resoluciones se admiten?
Las relaciones de aspecto admitidas son 16:9, 9:16, 4:5, 5:4, 1:1 y auto (mantiene la relación de aspecto de la foto); las resoluciones admitidas son 720p y 1080p.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: heygen-avatar-iv
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para heygen-avatar-iv y la ruta default; consulta la tabla de parámetros a continuación.
voicestringOpcionalPredeterminado: "Warm Pro Narrator"minLength 1Especifica la voz utilizada para el guion que leerá el avatar digital; por defecto es Warm Pro Narrator. Cuando se proporciona audio_url, este parámetro se ignora.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyMostrar todo (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringOpcionalminLength 1maxLength 5000Texto del guion que leerá el avatar digital; obligatorio cuando no se proporciona audio_url.
audio_urlstringOpcionalpattern ^https://Dirección HTTPS del audio para la sincronización labial, con una duración máxima de 600 segundos; una vez proporcionada, se ignoran prompt y voice.
image_urlstringObligatoriopattern ^https://Dirección HTTPS de la foto que se va a animar; debe contener un único rostro claro y frontal, y admite los formatos jpg, jpeg, png, webp, gif, avif, heic y heif.
backgroundobjectOpcional
Configuración de fondo utilizada para rellenar las zonas de la imagen no cubiertas por el retrato cuando la relación de aspecto de salida no coincide con la de la foto original; puede especificarse mediante un color o una imagen, y por defecto es blanco.
typestringObligatorioModo de relleno del fondo, que determina si el campo value se interpreta como un color o como una URL de imagen.
colorimagevaluestringObligatoriominLength 1Valor concreto del fondo: cuando type es color, se pasa un valor hexadecimal #RRGGBB; cuando es imagen, se pasa una dirección HTTPS de imagen.
resolutionstringOpcionalPredeterminado: "720p"Resolución del vídeo de salida; por defecto es 720p.
720p1080paspect_ratiostringOpcionalPredeterminado: "16:9"Relación de aspecto del vídeo de salida; por defecto es 16:9; con el valor auto se prioriza mantener la proporción de la foto original y, si no se puede leer, se recurre a 16:9.
16:99:164:55:41:1autocallbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Kling 3.0 Kuaishou $0.100 /segundo
-
 HeyGen Avatar V HeyGen $0.150 /segundo
-
 Grok Imagine 1.5 Lite xAI $0.029 /segundo
-
 Creatify Boreal Creatify $0.015 /segundo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 PixVerse V6 PixVerse $0.036 /segundo
-
 Kling AI Avatar Kuaishou --
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Kling 4.0 Kuaishou $0.330 /segundo
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 Gemini Omni Google --
-
 HappyHorse 1.1 Alibaba $0.160 /segundo