
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Basta caricare una singola foto e uno script per generare un video di un avatar parlante con sincronizzazione labiale, espressioni facciali e gesti, con supporto per output a 1280p+, ideale per speaker digitali e contenuti di tipo talking-head
Prova heygen-avatar-iv
Input
Creazioni
Vedi tutte le creazioniOutput
videoGuida visiva alle capacità di generazione video da testo di HeyGen Avatar IV
Stile Voce fuori campo · Spiegazione · Video Avatar
Input di riferimento
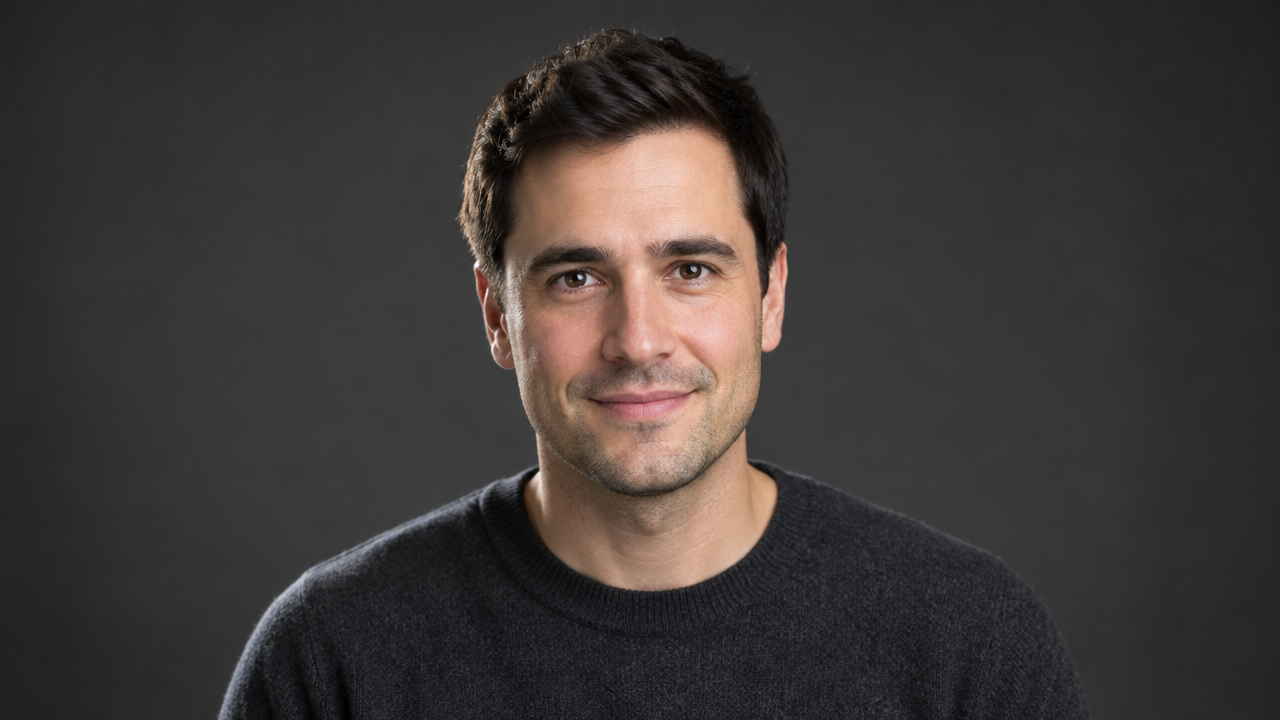
image_url
Prompt
Un relatore parla rivolto direttamente alla telecamera in un set da studio essenziale: inquadratura a mezzo busto, orientamento frontale, sguardo stabile a contatto con l'obiettivo, lievi movimenti del capo e gesti naturali che accompagnano il ritmo del parlato; luce principale morbida frontale a sinistra con luce di riempimento delicata, sfondo senza giunture grigio scuro neutro, profondità di campo ridotta, composizione widescreen 1080p 16:9, stile realistico da presentazione aziendale, ritmo calmo e sicuro.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Scheda della formula dei prompt per HeyGen Avatar IV: guida visiva alla scrittura strutturata
Stile Spiegazione · Ingegneria dei prompt · avatar parlante
Input di riferimento
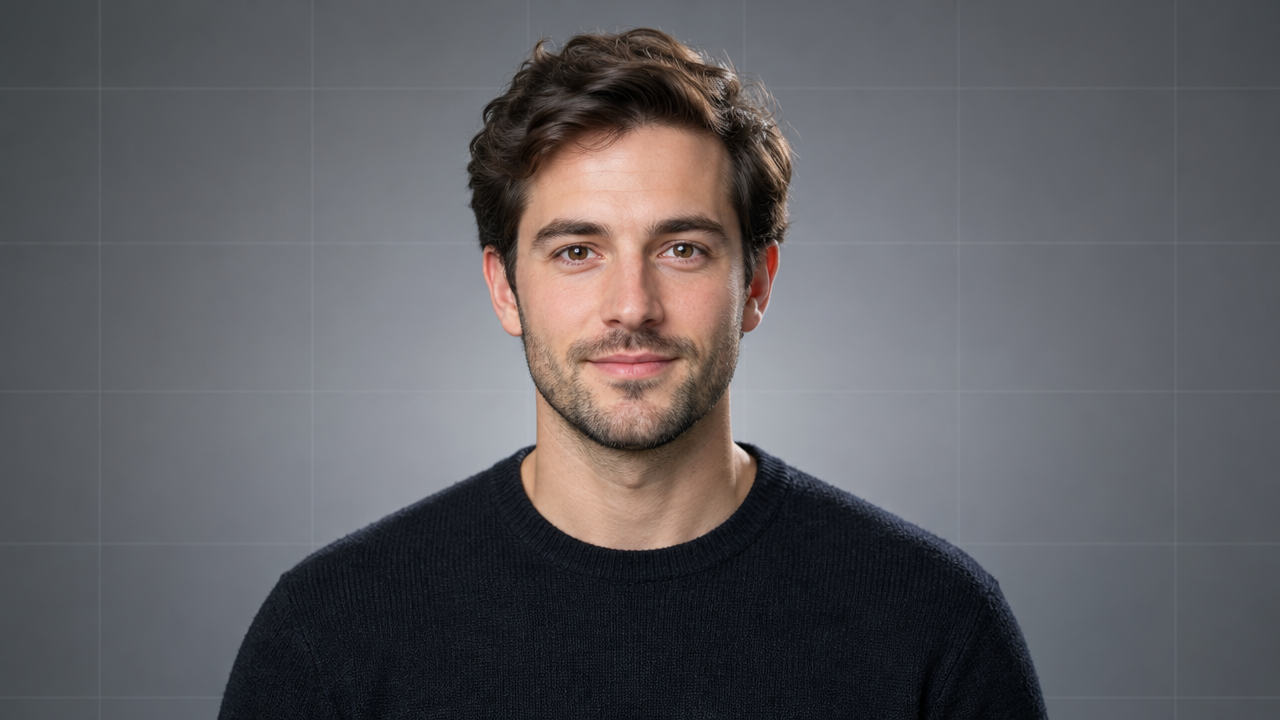
image_url
Prompt
Un presentatore inquadrato frontalmente parla direttamente alla telecamera in un set da studio ordinato, sollevando una scheda cartacea con la formula dei prompt; piano medio-ravvicinato, lento e lieve carrello in avanti con un delicato ondeggiamento a mano libera, luce principale morbida con luce di separazione sul contorno, profondità di campo ridotta che mantiene nitidi e leggibili i bordi della scheda e il volto ancora definito; ritmo calmo e didattico, con piccoli gesti naturali che indicano la scheda in ogni paragrafo, sfondo con una morbida sfumatura neutra e sottili linee a griglia che suggeriscono un'impaginazione da documento; immagine nitida, ricca di dettagli, qualità 1080p.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Appunti visivi sul linguaggio di ripresa: demo parlata di Avatar IV
Stile linguaggio-della-fotocamera · avatar parlante · Spiegazione
Input di riferimento
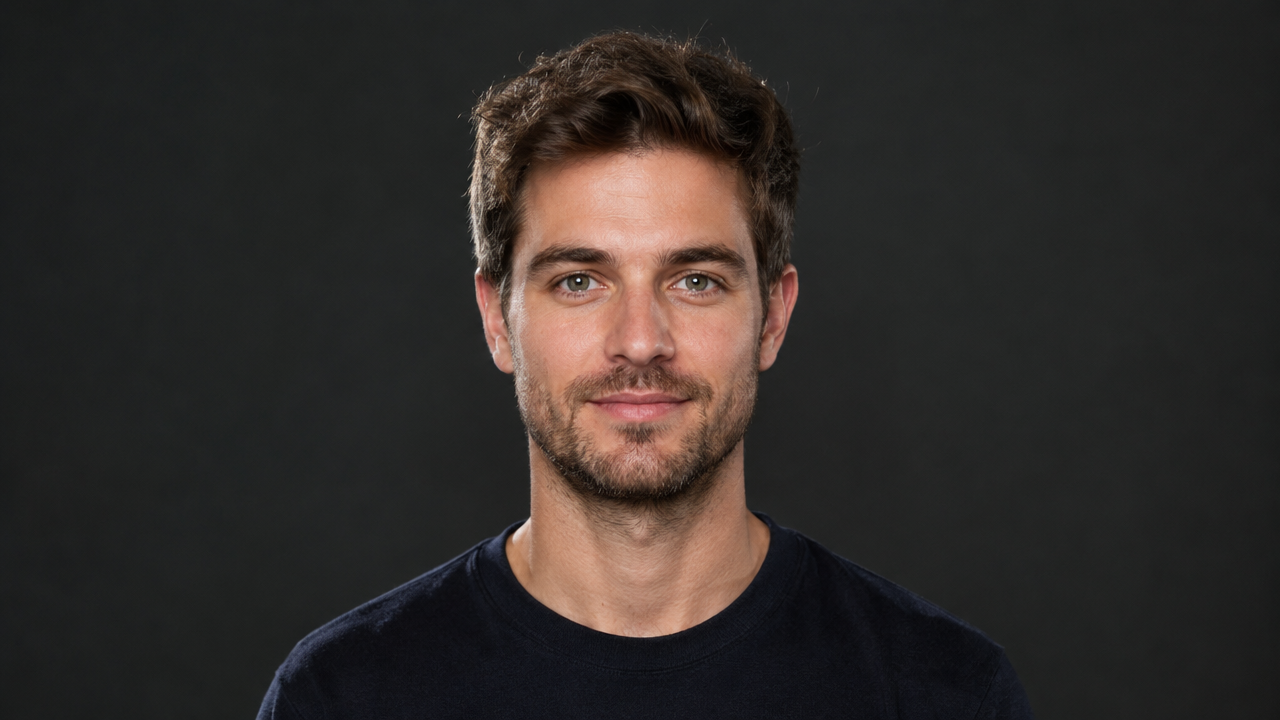
image_url
Prompt
Una persona inquadrata frontalmente verso la camera parla direttamente all'obiettivo con tono calmo e didascalico, come se stesse commentando davanti alla camera degli appunti visivi sul linguaggio di ripresa. Lo sguardo resta stabile verso l'obiettivo, la testa compie lievi movimenti naturali e occasionalmente fa gesti esplicativi, indicando panoramiche, avvicinamenti e inclinazioni verticali. Inquadratura da studio neutra e con illuminazione uniforme, sfondo scuro a bassa saturazione, atmosfera complessiva da registrazione dello schermo, ritmo misurato, con brevi pause tra un termine di movimento di macchina e l'altro.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Concetto di storyboard per HeyGen Avatar IV: dal testo all'immagine parlante
Stile avatar parlante · Storyboard · Narrativa
Input di riferimento
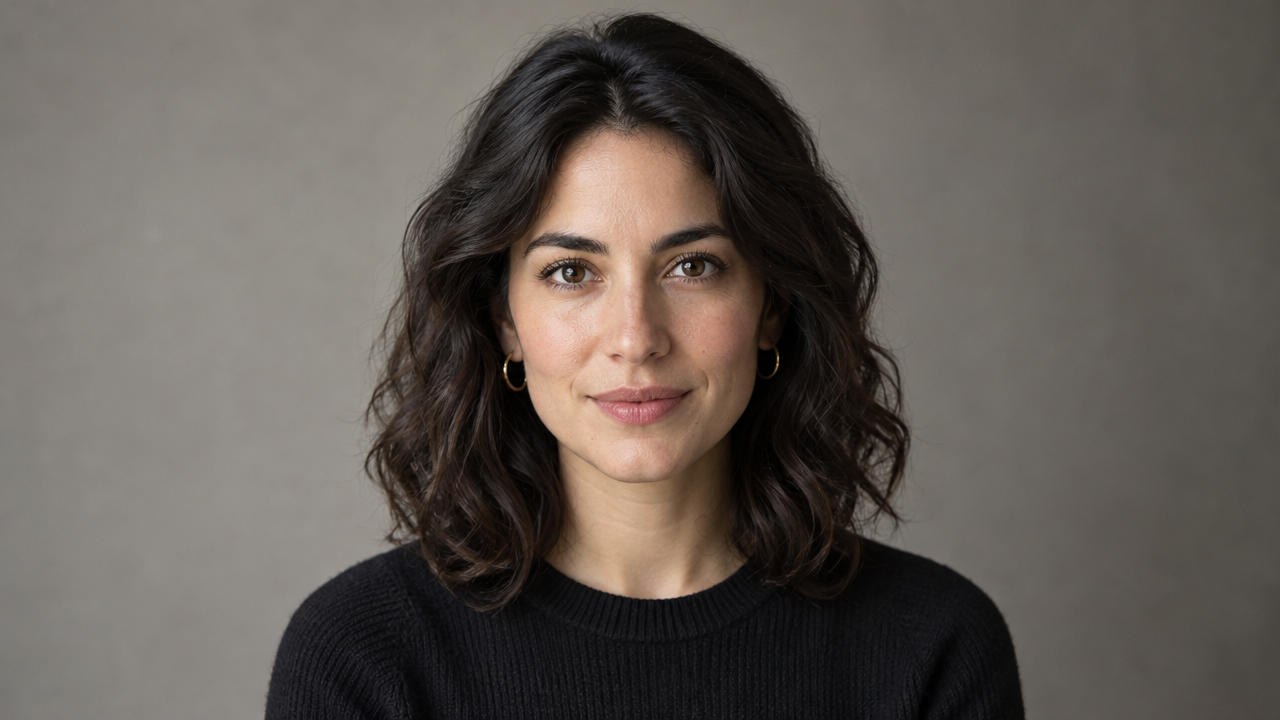
image_url
Prompt
Un ritratto singolo frontale viene trasformato in un video parlante: la persona racconta con sincronizzazione labiale naturale un breve commento fuori campo dello storyboard, con lievi movimenti della testa e gesti espressivi, in formato 16:9 con uno sfondo neutro e pulito, inquadratura stabile a medio-primo piano, luce principale morbida, ritmo calmo e sicuro.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
heygen-avatar-iv per second
| Prezzo unitario | $0.150 |
|---|
Panoramica
heygen-avatar-iv è un modello per video con avatar parlante offerto da HeyGen, richiamabile tramite l'interfaccia unificata di HiAPI.ai. Gli sviluppatori caricano una foto frontale del volto e forniscono un testo di script o un file audio per generare un video parlante con sincronizzazione labiale, espressioni facciali e gesti. Supporta output a 720p e 1080p e vari formati di proporzioni, ed è adatto a sviluppatori e team di contenuti che necessitano di produrre rapidamente portavoce digitali o materiali video con personaggi che parlano in prima persona.
Punti salienti
- Un'unica foto per l'intero video parlante — basta una foto frontale insieme a uno script o a un audio, senza bisogno di riprese o di creare asset tridimensionali, per ottenere il video finale.
- Espressioni e gesti sincronizzati con la voce — l'output non si limita all'allineamento delle labbra: le espressioni facciali e i movimenti della testa variano naturalmente con la voce, avvicinandosi alla resa di una persona reale che parla.
- Doppio input: testo di script e audio — è possibile inserire direttamente lo script e scegliere una voce, oppure passare un audio HTTPS per la sincronizzazione labiale, adattandosi ai flussi di doppiaggio già esistenti.
- Formato e sfondo configurabili — offre diverse proporzioni come 16:9, 9:16, 1:1 e altre, con la possibilità di specificare uno sfondo a tinta unita o un'immagine per riempire l'inquadratura.
Capacità
Generazione di video parlanti da foto: passando una foto frontale del volto si genera un video parlante; l'output è un file video utilizzabile direttamente come prodotto finale o per montaggi successivi.
Conversione dello script in voce e guida del labiale: inserendo il testo dello script e specificando una voce integrata, il modello sintetizza la voce e guida l'avatar nel parlato; uno script può contenere al massimo 5000 caratteri.
Sincronizzazione labiale con audio: passando un link audio HTTPS la foto parla seguendo il labiale dell'audio; un singolo audio può durare al massimo 600 secondi, e in questo caso i parametri di script e voce non hanno effetto.
Controllo delle specifiche di output: si può scegliere la risoluzione 720p o 1080p e impostare proporzioni 16:9, 9:16, 4:5, 5:4, 1:1 o seguire quella dell'immagine originale, adattandosi a posizioni di pubblicazione orizzontali, verticali e quadrate.
Riempimento dello sfondo: quando le proporzioni di output non coincidono con quelle della foto, è possibile riempire le aree vuote con un colore a tinta unita o un'immagine di sfondo, evitando bordi vuoti nell'inquadratura.
Casi d'uso
- Team di marketing che realizzano video con portavoce digitali — generano video con un portavoce partendo da uno script di prodotto e dalla foto di un personaggio del brand, da usare su siti web, spazi pubblicitari e social media, senza dover pianificare la presenza di persone reali.
- Reparti formazione che producono materiali per corsi esplicativi — trasformano i materiali didattici in script e generano in blocco video esplicativi con un'immagine coerente, da integrare in piattaforme di apprendimento o materiali didattici.
- Creatori di video brevi che producono contenuti verticali in prima persona — scelgono il formato 9:16 e una voce selezionata per generare materiali verticali con parlato, da usare direttamente per aggiornare i contenuti sulle piattaforme di video brevi.
- Adattamento multilingue di contenuti con doppiaggio esistente — passano l'audio del doppiaggio già esistente per la sincronizzazione labiale e, insieme alla foto, generano l'immagine del parlato nella lingua corrispondente, per la localizzazione dei contenuti.
Limitazioni e suggerimenti per la scelta
La foto di input deve essere un volto frontale nitido: volti di profilo, occlusioni o foto di gruppo influiscono sensibilmente sul risultato, e la qualità della generazione dipende molto dall'immagine di origine. L'output è un video e non un testo finale, quindi è necessario preparare in anticipo lo script o l'audio. Il limite per un singolo audio è di 600 secondi e per lo script di 5000 caratteri; i contenuti troppo lunghi vanno generati in segmenti. Se servono solo avatar con immagini predefinite o cloni digitali di persone reali, è opportuno scegliere le corrispondenti altre linee di modelli.
Novità
Vedi il changelog →- Nuovo modello Nuovo modello: heygen-avatar-iv, carica una foto ritratto e genera un video parlante con sincronizzazione labiale usando un copione e una voce predefinita o un audio di guida; sono disponibili…
Domande frequenti
Vedi tutte le domande →-
Quali input richiede HeyGen Avatar IV?
Una foto ritratto e la scelta di una modalità di guida: inserire il testo e selezionare una voce, oppure caricare un file audio. Se si usa il testo senza selezionare una voce, viene utilizzata la voce predefinita Warm Pro Narrator.
-
Che tipo di foto dà i risultati migliori?
Le foto di una sola persona, con il viso frontale, i tratti del volto nitidi e non coperti, un'illuminazione uniforme e la bocca naturalmente chiusa danno i risultati più affidabili. Le foto di profilo, con mascherina, con più persone o in cui il volto è molto piccolo non sono adatte.
-
Quanto dura il video generato?
Non è necessario specificare la durata. Quando si doppiano le battute, la lunghezza è determinata dalle battute e dalla velocità di parlato; con la guida audio, corrisponde alla lunghezza dell'audio caricato, che può durare al massimo 600 secondi.
-
Quali formati e risoluzioni sono supportati?
I formati supportati sono 16:9, 9:16, 4:5, 5:4, 1:1 e auto (mantiene le proporzioni della foto); le risoluzioni supportate sono 720p e 1080p.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: heygen-avatar-iv
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per heygen-avatar-iv e la route default — vedi la tabella dei parametri sotto.
voicestringOpzionalePredefinito: "Warm Pro Narrator"minLength 1Specifica la voce utilizzata dal digital human per leggere il copione; il valore predefinito è Warm Pro Narrator. Quando viene fornito audio_url, questo parametro viene ignorato.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyMostra tutto (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringOpzionaleminLength 1maxLength 5000Il testo del copione che il digital human leggerà; obbligatorio quando audio_url non viene fornito.
audio_urlstringOpzionalepattern ^https://URL HTTPS dell'audio utilizzato per la sincronizzazione labiale, con durata massima di 600 secondi; una volta fornito, prompt e voice vengono entrambi ignorati.
image_urlstringObbligatoriopattern ^https://URL HTTPS della foto da animare; deve contenere un singolo volto chiaro e frontale, nei formati jpg, jpeg, png, webp, gif, avif, heic, heif.
backgroundobjectOpzionale
Impostazione di sfondo utilizzata per riempire le aree dell'immagine non coperte dal soggetto quando le proporzioni dell'output non corrispondono a quelle della foto originale; può essere specificata tramite colore o immagine, il valore predefinito è bianco.
typestringObbligatorioModalità di riempimento dello sfondo; determina se il campo value va interpretato come colore o come URL di immagine.
colorimagevaluestringObbligatoriominLength 1Valore concreto dello sfondo: se type è colore, passare un valore esadecimale #RRGGBB; se è immagine, passare un indirizzo HTTPS dell'immagine.
resolutionstringOpzionalePredefinito: "720p"Risoluzione del video di output; il valore predefinito è 720p.
720p1080paspect_ratiostringOpzionalePredefinito: "16:9"Proporzioni del video di output; il valore predefinito è 16:9; con auto viene mantenuto prioritariamente il rapporto della foto sorgente, con fallback a 16:9 se non è possibile leggerlo.
16:99:164:55:41:1autocallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 LTX 2.5 Fast Lightricks $0.086 /secondo
-
 Kling 2.5 Kuaishou $0.060 /secondo
-
 Veo 3.1 Fast Google $0.170 /secondo
-
 Veo 3.1 Google $0.290 /secondo
-
 Grok Imagine 1.5 xAI $0.011 /secondo
-
 Veo 3.1 Lite Google $0.060 /secondo
-
 FLUX 3 Video Black Forest Labs $0.090 /secondo
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 Gemini Omni 1.1 Flash Google $0.450 /video
-
 Seedance 2.5 ByteDance $0.121 /secondo
-
 PixVerse V6 PixVerse $0.036 /secondo
