
Meta
Muse Image 1.0
muse-image-1.0/image-to-image
Модель Meta для генерации и редактирования изображений на основе рассуждений: сначала разбирает сложный запрос, затем выполняет рендеринг; может объединять несколько референсных изображений и использовать веб-поиск для обеспечения фактической точности
Попробовать muse-image-1.0/image-to-image
Ввод
Работы
Все работыВывод
image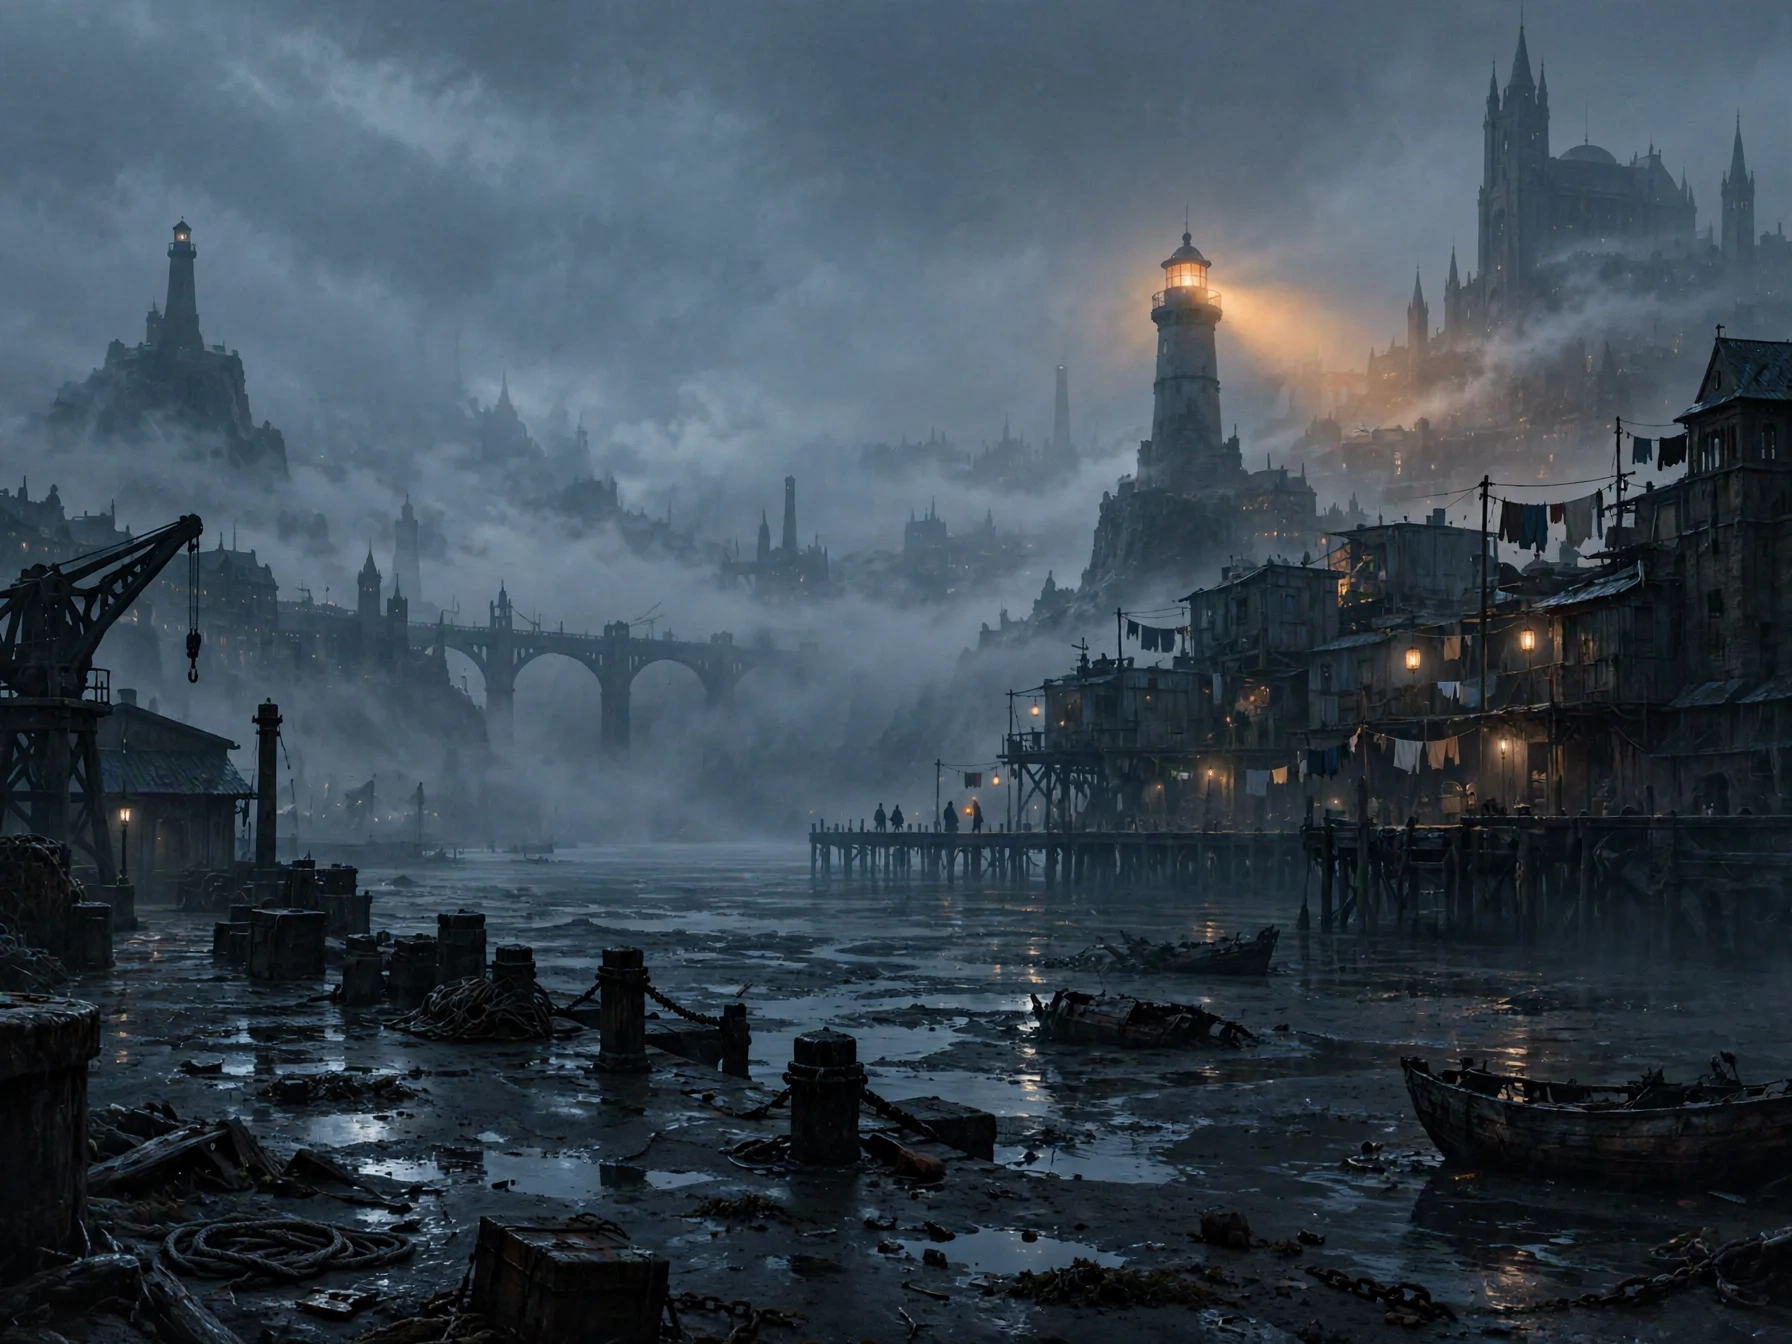
Концепт-арт мира: исследование атмосферы города Пепельного прилива
Стиль Концепт-арт · Построение мира · Мудборд
Референсные входы
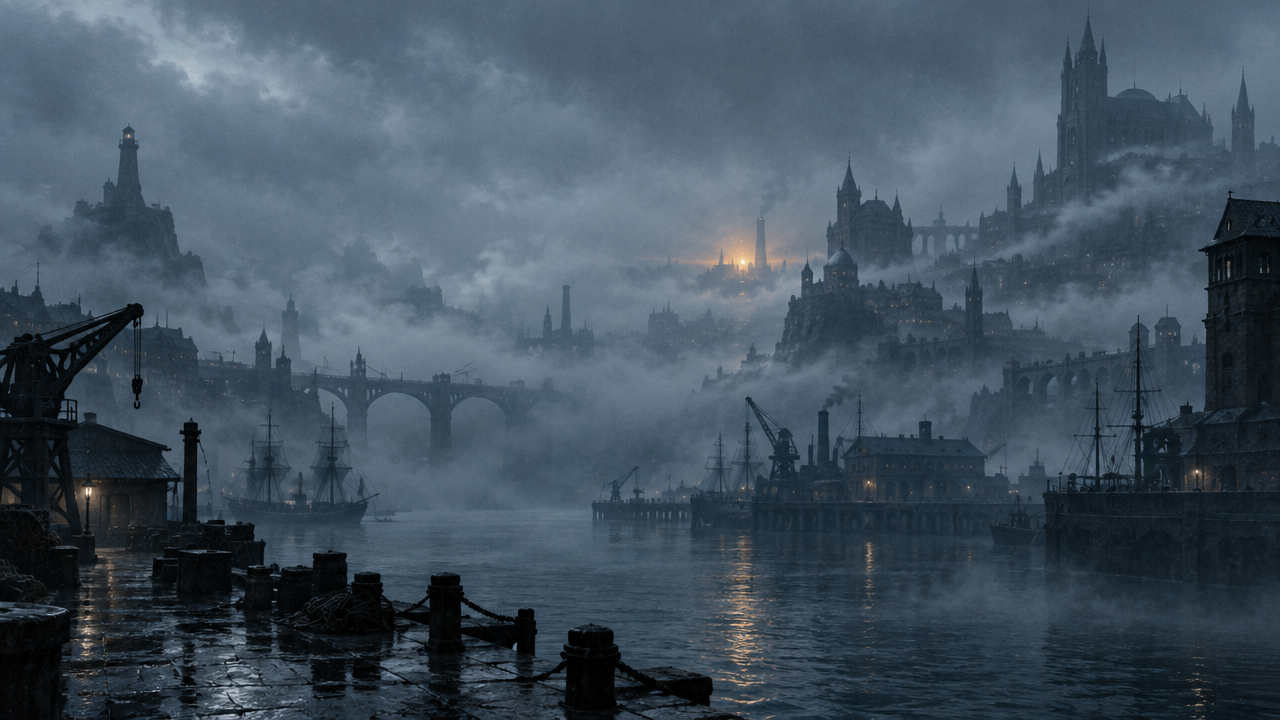
image_urls
Промпт
Кинематографичный концепт-арт прибрежного города во время отлива, широкоэкранная композиция 16:9. Передний план: обнажённые после отлива влажные улицы из чёрного песка, разбросанные корпуса лодок и канаты, покрытые соляной коркой, тонкие отражения холодного лунного света. Средний план: вытравленные солью стальные арки и многослойные модульные жилища на сваях, бельевые верёвки и висящие фонари, несколько силуэтов людей, идущих по деревянному настилу. Задний план: высокий маяк прилива, тусклый янтарный луч прорезает густой морской туман, дальние разрушенные волнорезы растворяются в тумане. Сохранить холодную сине-серую тональность референса, низкую насыщенность и плотность атмосферного тумана; продолжить тёплые янтарные акцентные огни на фонарях и луче маяка. Объёмный свет, мягкое плёночное зерно, живописная текстура цифрового матового пейзажа, сдержанная детализация, мягкий контраст, без текста, без логотипов.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
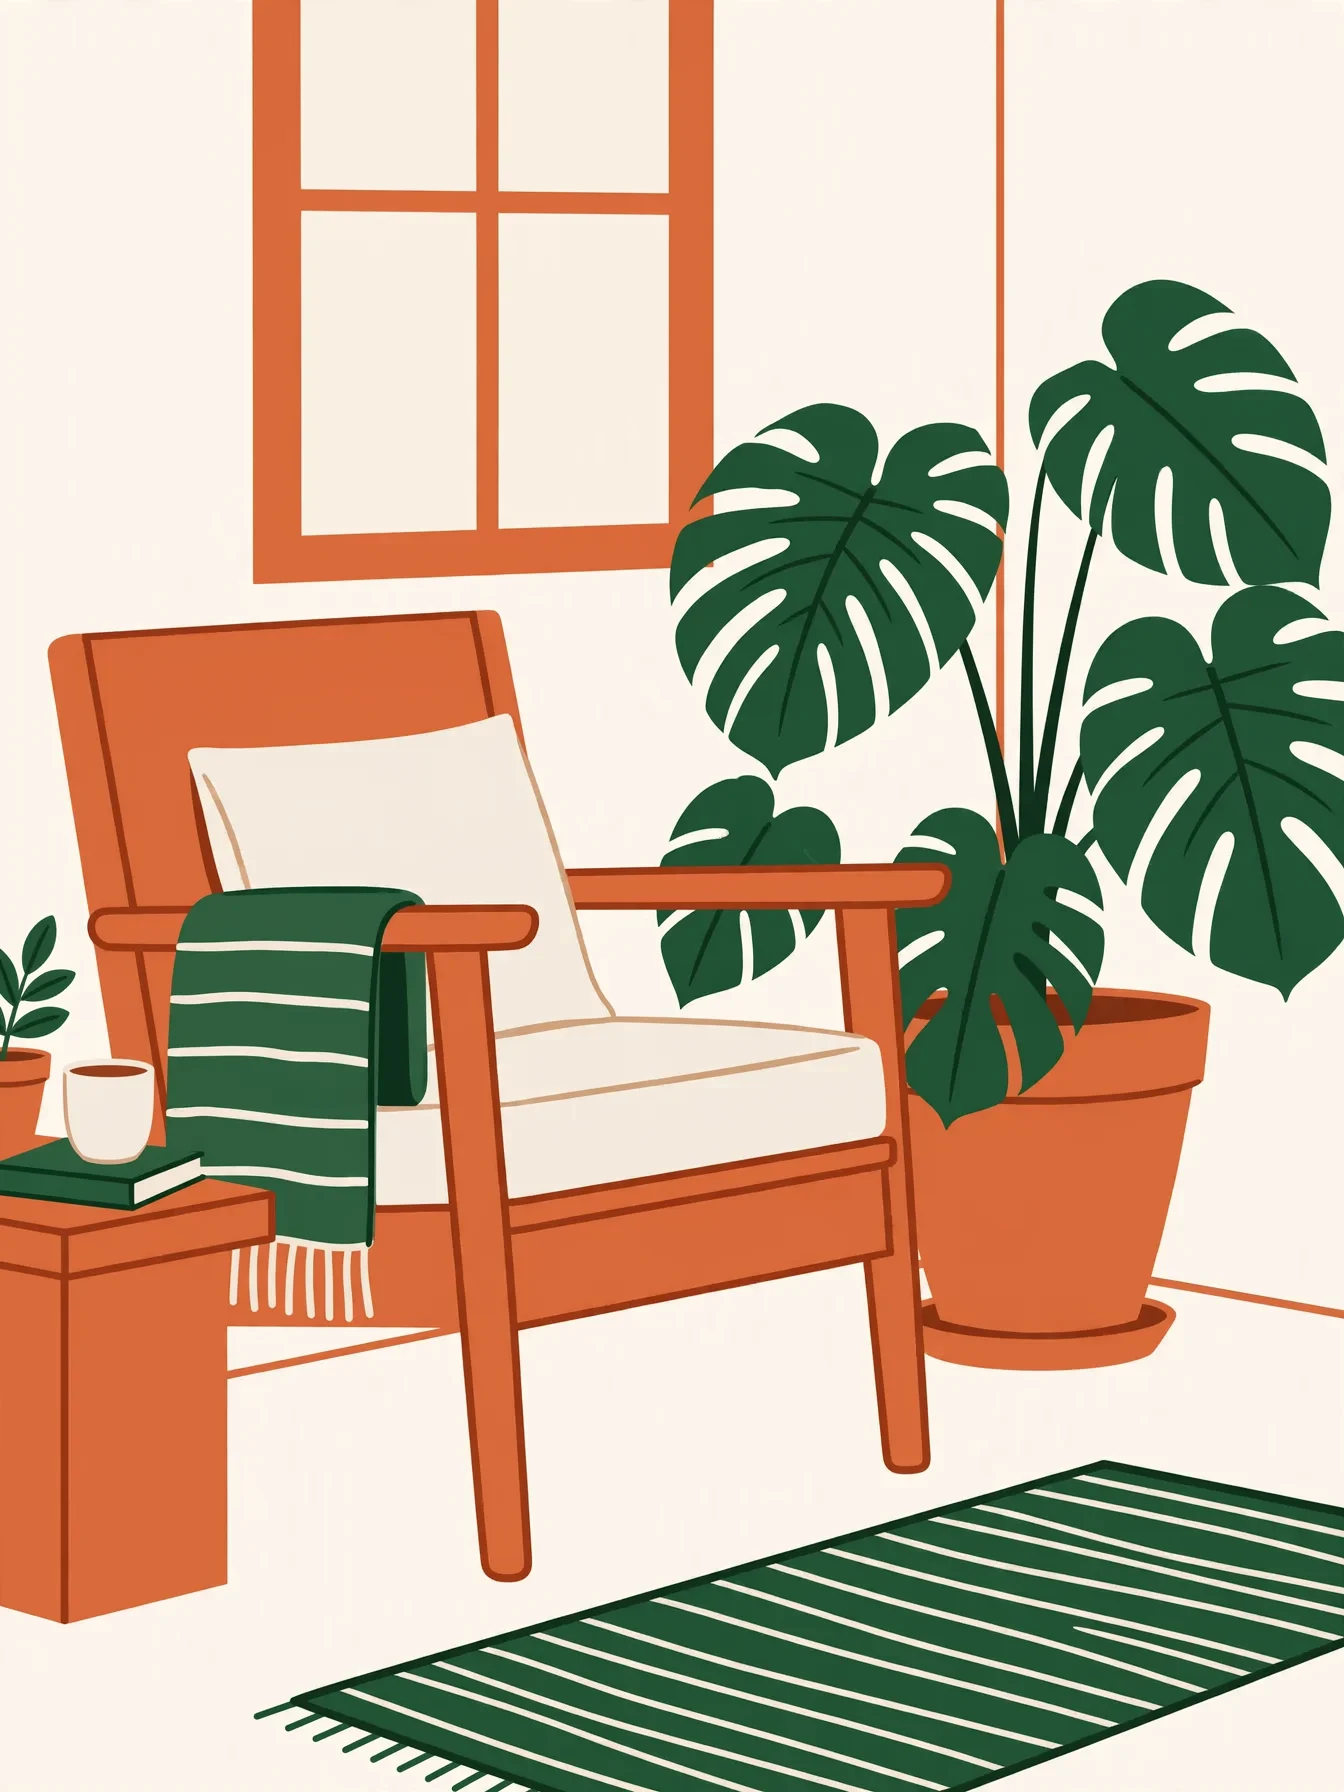
Спектр стилей: пошаговая трансляция от реалистичной фотографии к плоской иллюстрации
Стиль перенос стиля · Плоская иллюстрация · Ориентир для референса
Референсные входы
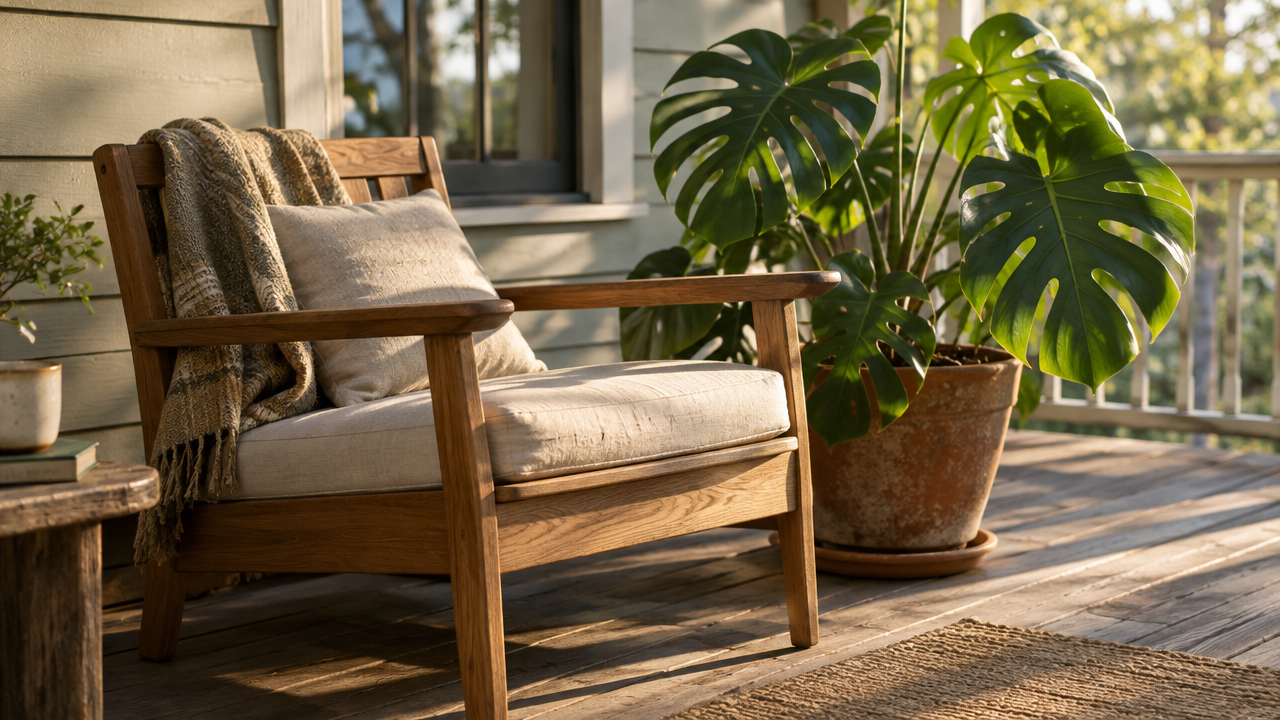
image_urls
Промпт
Плоская векторная иллюстрация, преобразованная на основе референсной фотографии: идентичность объекта, контур кресла и расположение растений в точности совпадают с референсом, но всё остальное полностью уплощено. Фотографическое освещение заменено двумя-тремя чистыми тонами, глубина резкости сжата в перекрывающиеся плоскости, текстуры и зернистость удалены, используются чистые чёткие контурные линии и сдержанная палитра из тёплого терракотового, кремово-белого и тёмно-зелёного. Без градиентов, без отбрасываемых теней, без фотографических деталей. Центрированная композиция с обильным негативным пространством, стиль редакционной иллюстрации.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
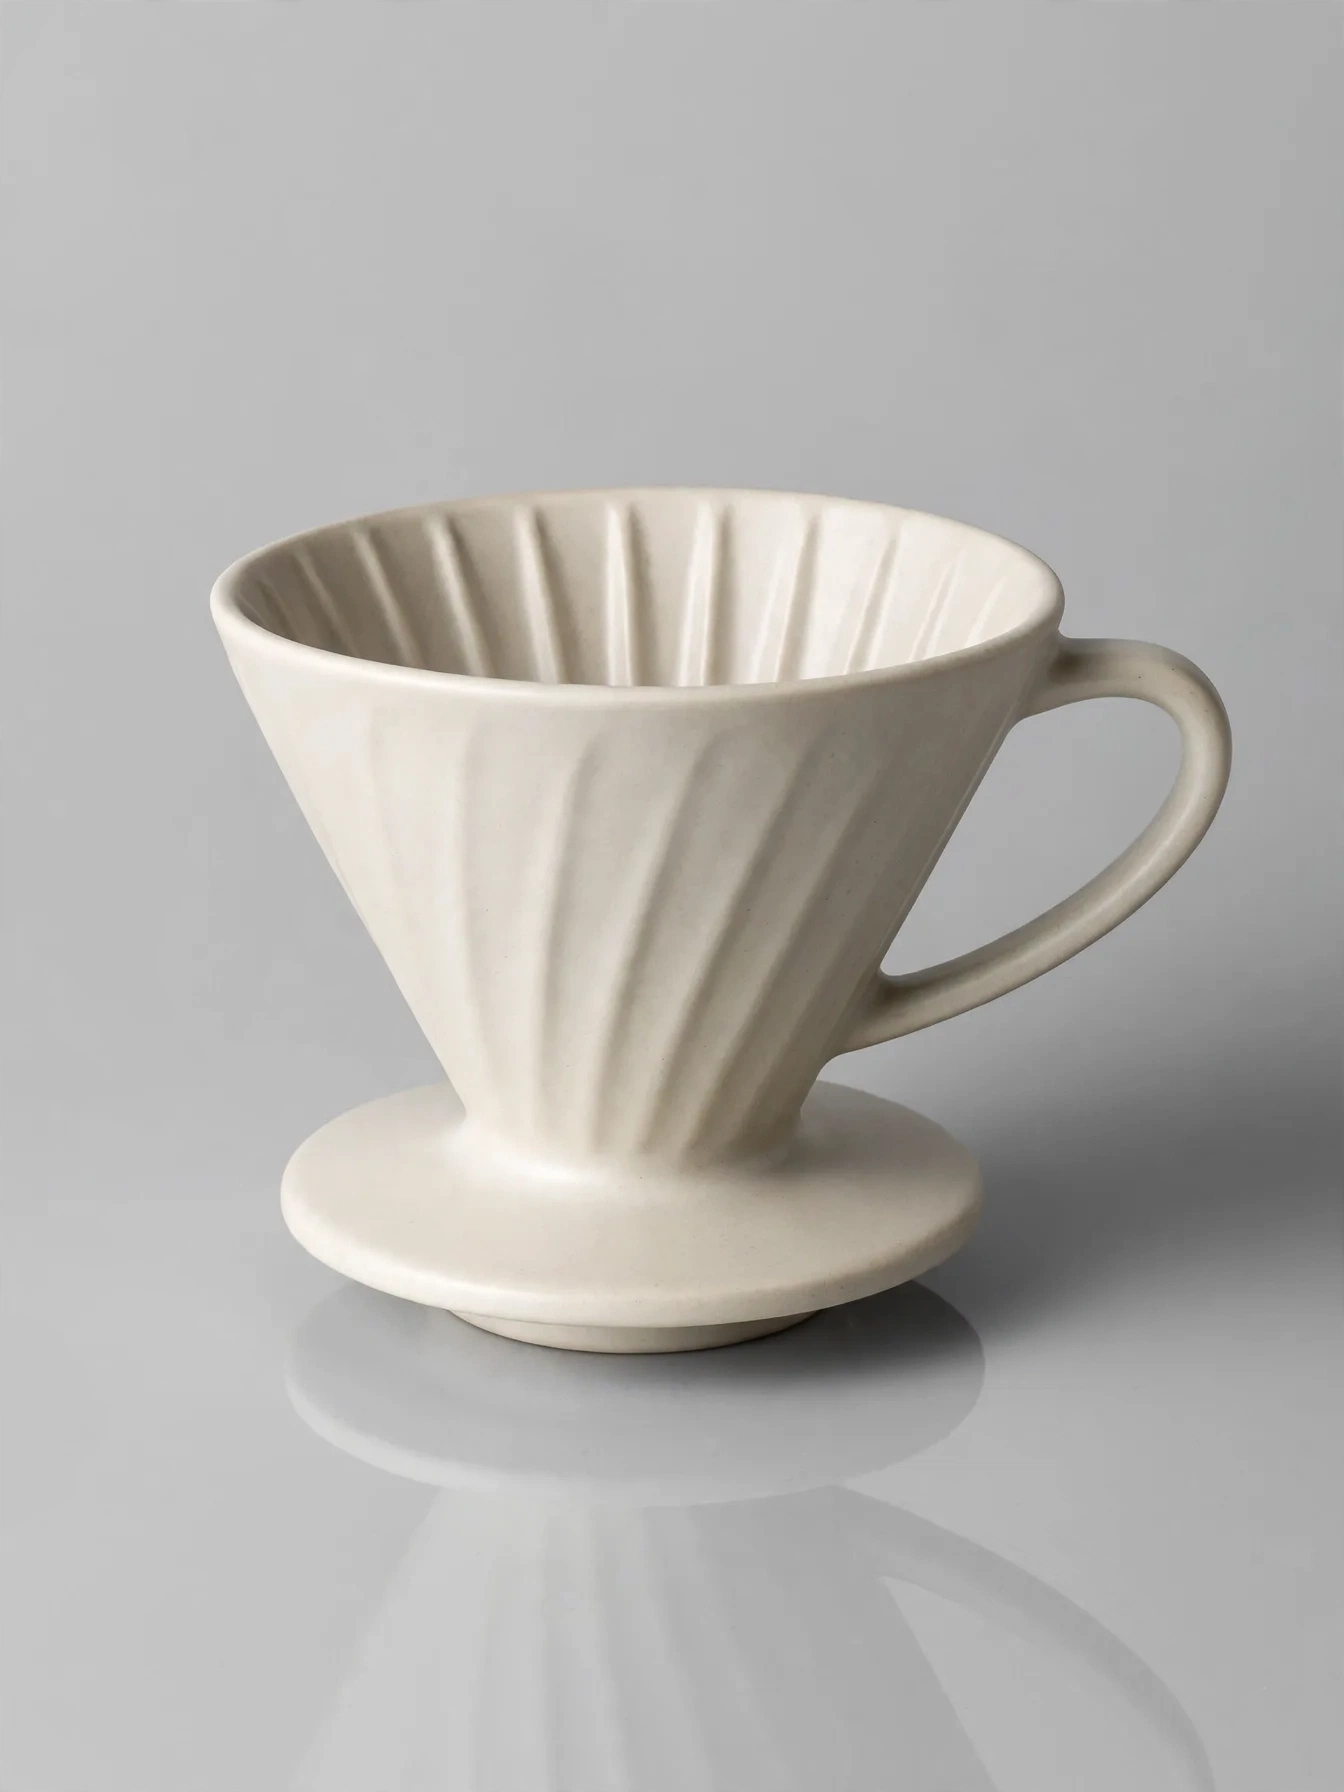
Качество продуктовой фотографии для e-commerce: из одного референсного изображения — в коммерческий результат
Стиль Изображение продукта · электронная коммерция · Студийный свет
Референсные входы
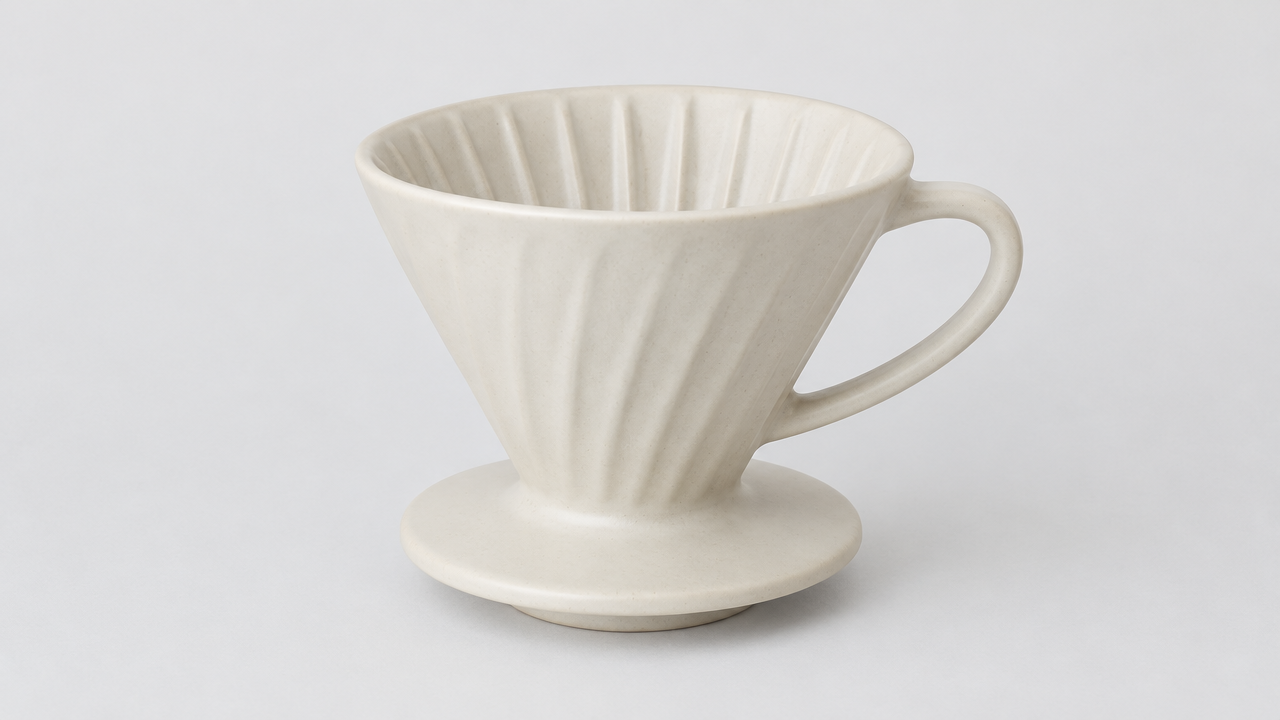
image_urls
Промпт
Перестилизуйте продукт с референсного изображения в коммерческую фотографию продукта для e-commerce. Сохраните точную форму, пропорции, цвет, расположение логотипа и детали материала продукта в полном соответствии с референсом; не добавляйте, не удаляйте и не перерабатывайте никакие признаки. Разместите его на матовом светло-сером бесшовном студийном фоне с тонким мягким отражением внизу. Освещение: крупный софтбокс в качестве основного источника света сверху слева с мягким градиентным затуханием вправо, узкий контурный свет по краям продукта для отделения от фона, без резких ярких бликов на этикетке. Камера: эквивалент 85-мм продуктового объектива, на уровне линии взгляда продукта, слегка в три четверти, глубина резкости достаточная, чтобы весь продукт был в фокусе. Композиция: продукт по центру, обильное чистое негативное пространство, горизонтальный кадр 16:9, подходит для баннера магазина. Постобработка: четкие края, нейтральный баланс белого, точная цветопередача, без пыли, без отпечатков пальцев, без реквизита, без текстовых наложений.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
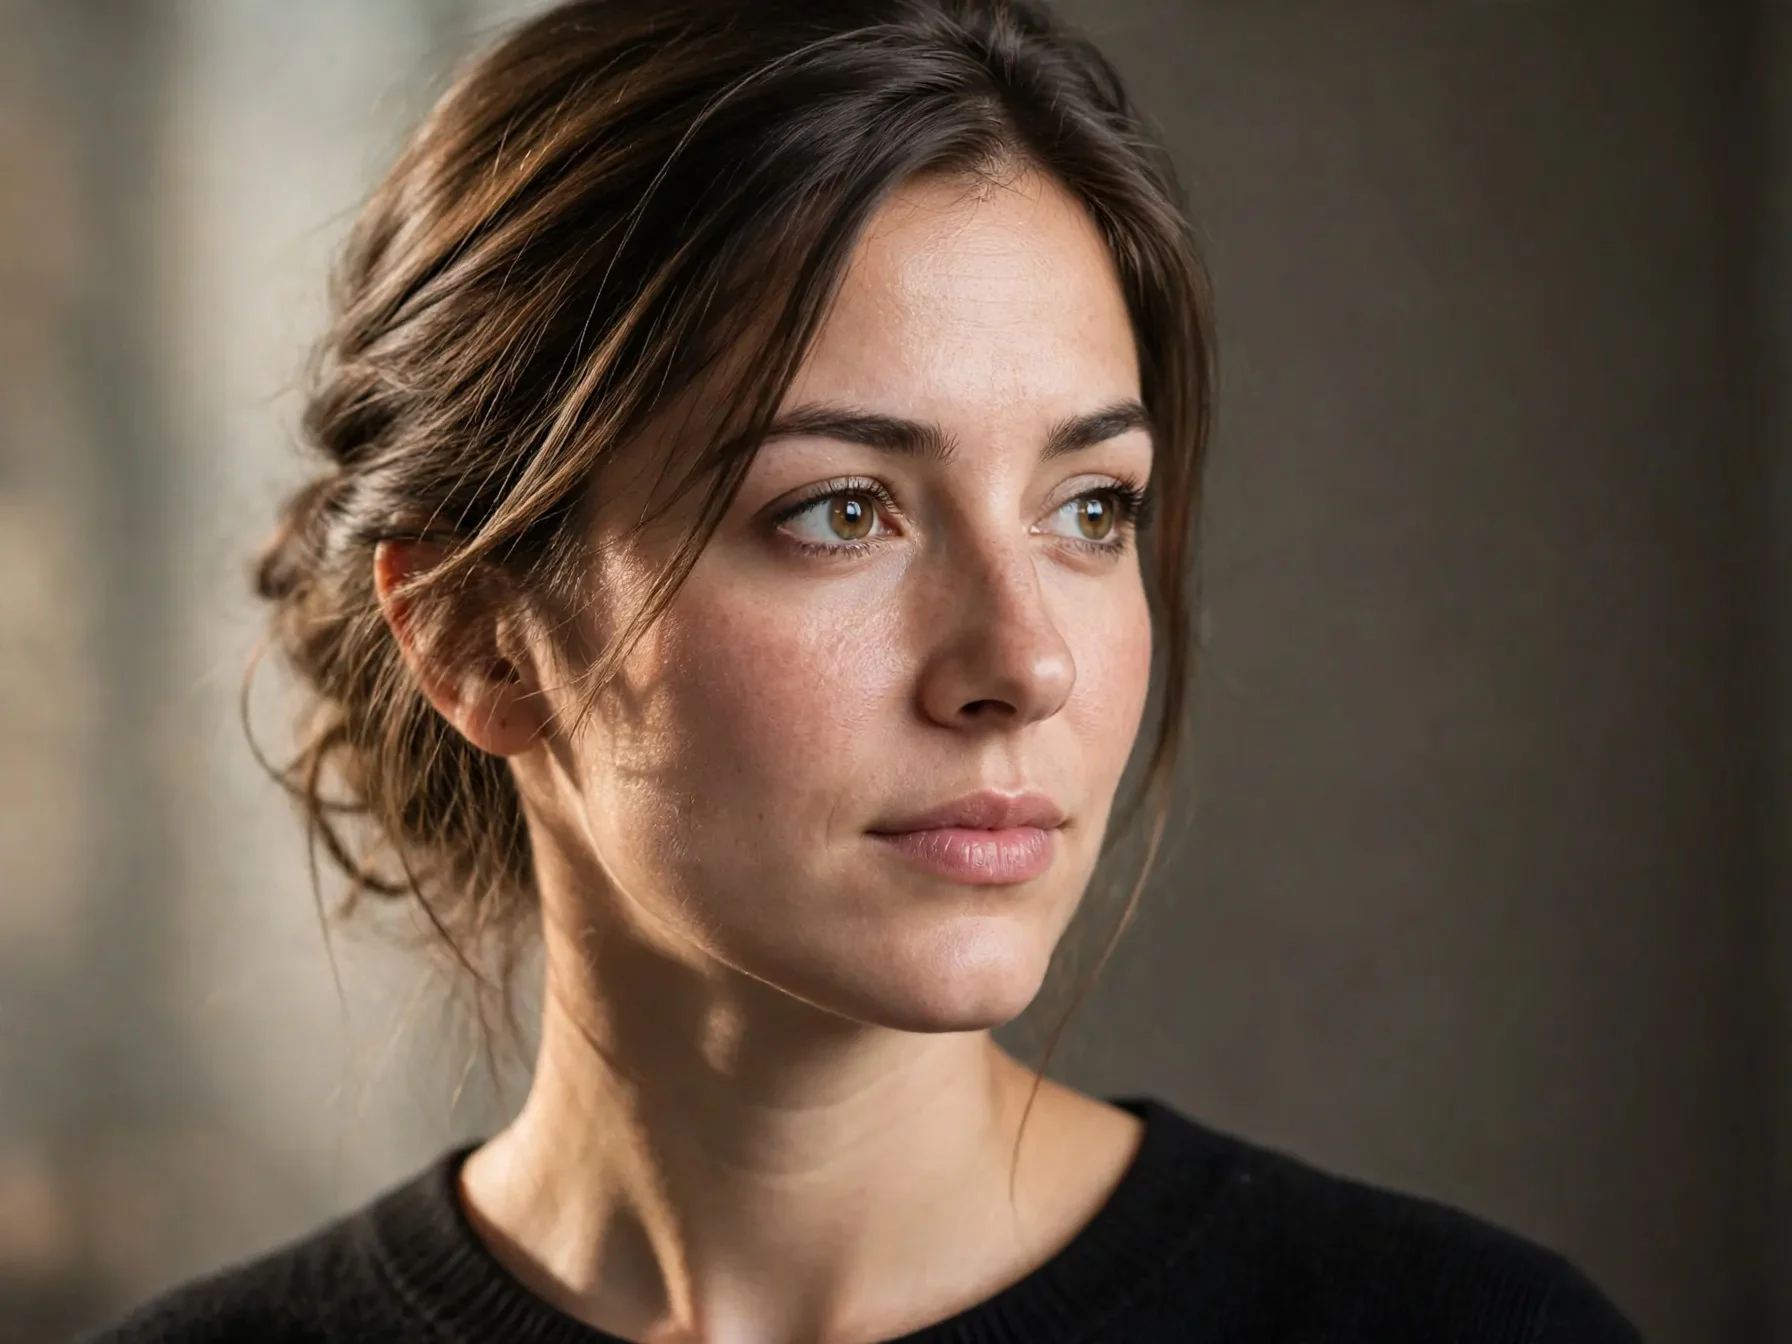
Перерисовка реалистичных и художественных портретов на основе референсного изображения
Стиль Портреты и фотография · перенос стиля · Фотореализм
Референсные входы
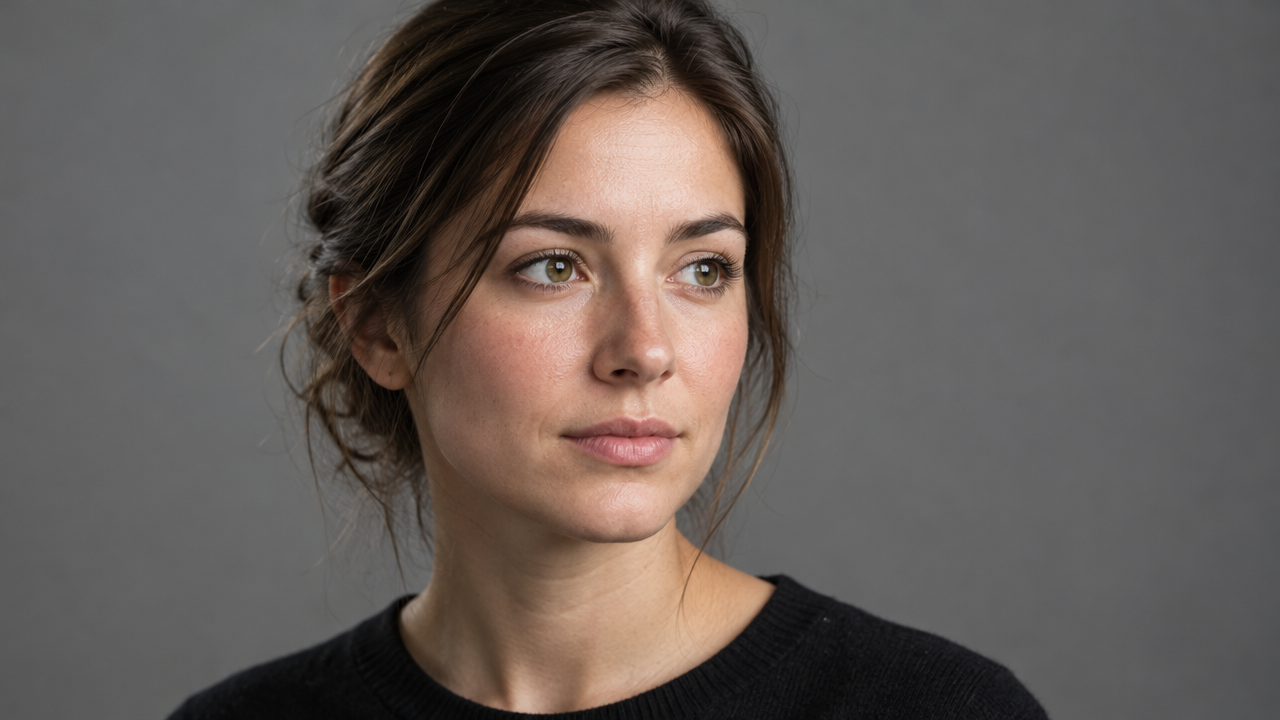
image_urls
Промпт
Стиль перерисовки портрета в режиме «изображение в изображение». Используйте предоставленное референсное фото как единственный источник идентичности персонажа и композиции: сохраните ту же структуру лица, контур причёски, наклон головы и положение плеч. Отрисуйте одиночный средне-крупный портрет в вертикальной композиции 3:4, с мягким направленным ключевым светом слева от камеры, плавно переходящим в нейтральный тёплый серый бесшовный фон. Сохраните естественную текстуру кожи с видимыми порами и тонкими волосками, лёгкие зеркальные блики на скулах и переносице, реалистичные глаза с видимыми бликами, достоверные тональные переходы. Сдержанная цветокоррекция с лёгким плёночным контрастом; без излишней стилизации, без пластиковой ретуши, без дополнительных предметов и текста. Малая глубина резкости, резкий фокус на глазах, эффект портретного объектива 85 мм.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
muse-image-1.0/image-to-image per task
| Цена за единицу | $0.015 |
|---|
Краткое описание
muse-image-1.0/image-to-image — это модель генерации и редактирования изображений на основе референсных изображений от Meta, доступная через унифицированный интерфейс HiAPI.ai. На вход она принимает одно или несколько референсных изображений и вместе с текстовым запросом выполняет генерацию сцены, замену элементов и изменение стиля, а также разбирает и планирует макет для сложных многосоставных инструкций перед рендерингом. Модель подходит разработчикам, которым нужно использовать существующие материалы как основу и при этом добиваться высокой точности следования запросу и эффективности массового производства; её можно применять для создания вариаций материалов, предметных сцен для товаров и персонализированного синтеза.
Ключевые особенности
- Генерация по принципу «сначала рассуждение, затем рендеринг» — перед рендерингом запрос разбивается на части и планируется макет, что снижает вероятность потери сложных инструкций при однопроходной генерации.
- Генерация и редактирование в рамках одной модели — слияние референсных изображений и изменение по инструкции не требуют подключения дополнительных инструментов редактирования, что сокращает число вызовов.
- Несколько референсных изображений за один запрос — принимается до 10 референсных изображений, при этом в запросе можно отдельно указать роль каждого изображения: субъект, стиль или композиция.
- Прямое управление выходными параметрами — можно задать соотношение сторон и формат вывода jpeg, png или webp, что упрощает интеграцию с последующими процессами обработки материалов.
Описание возможностей
Редактирование изображений на основе референсных изображений: на вход подаются референсные изображения и текстовый запрос; содержимое изображения изменяется или сохраняется согласно запросу. Подходит для точечной доработки существующих материалов, а не для генерации с нуля.
Слияние нескольких изображений: один запрос может содержать от 1 до 10 референсных изображений, при этом в запросе для каждого изображения можно указать роль субъекта, стиля или композиции — для задач синтеза.
Декомпозиция и выполнение сложных запросов: многосоставные описания сначала планируются, а затем рендерятся, что позволяет полнее реализовать запросы с несколькими субъектами и требованиями к макету.
Управление выходными параметрами: поддерживаются девять соотношений сторон от 1:1 до 21:9, а также форматы jpeg, png и webp — можно сразу получать результат в нужном формате для размещения или хранения.
Сценарии применения
- Рекламные и медийные команды: массовая генерация вариаций из существующих материалов — загрузите фирменное изображение и с помощью запросов измените сцену и пропорции под каждый канал, чтобы получить несколько наборов рекламных материалов для A/B-тестирования и распространения по разным каналам.
- Электронная коммерция: преобразование товарных изображений в сценовые — используйте фотографию товара как референс, меняйте фон и сцену по запросу, получая изображения для каталога или сценовые изображения для карточки товара.
- Персонализированный синтез: интеграция фотографий пользователей в новую сцену — используйте загруженные пользователем фотографии как референс для синтеза тематической сцены, создавая индивидуальные изображения для страниц мероприятий или публикации в соцсетях.
Ограничения и рекомендации по выбору
В открытых источниках не раскрываются технические детали, такие как архитектура модели и разрешение вывода; результаты генерации следует оценивать по фактическому качеству. Многошаговое рассуждение добавляет задержку, поэтому модель не подходит для сценариев, крайне чувствительных ко времени отклика; вывод ограничен изображениями и не включает видео или аудио. Если задача требует только генерации изображения с нуля по тексту без референсных изображений, можно выбрать текстово-графическую линию того же семейства; если требуется генерация видео или меньшая задержка, стоит рассмотреть другие модели.
Частые вопросы
Все частые вопросы →-
Как выбрать между генерацией изображения по тексту и редактированием изображения?
Если есть только текст и нужно начать с нуля, выбирайте генерацию изображения по тексту; если нужно сохранить существующий объект или макет, выбирайте редактирование изображения и предоставьте референсное изображение.
-
Сколько изображений можно получить за один раз?
Каждая задача возвращает одно изображение, выбора количества нет. Если нужно сравнить другую композицию, измените промпт и отправьте новую задачу.
-
Можно выбрать 1K, 2K или 4K?
В этом интерфейсе нет параметров разрешения. Соотношение сторон выбираете вы, а размер в пикселях определяет модель — обычно около 2,5 Мп; ориентируйтесь на фактические размеры скачанного файла.
-
Какие форматы файлов можно выбрать?
Можно выбрать JPEG, PNG или WebP; если ничего не выбрано, используется WebP. Выбирайте в зависимости от потребностей последующих веб-материалов или инструментов дизайна.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: muse-image-1.0/image-to-image
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для muse-image-1.0/image-to-image и маршрута default — см. таблицу параметров ниже.
promptstringОбязательноminLength 1maxLength 5000Текстовый запрос, описывающий желаемое изображение или указывающий, что нужно изменить и сохранить в референсных изображениях; при использовании референсных изображений следует указать в нём субъект, стиль или композиционную роль каждого изображения.
image_urlsarrayОбязательноminItems 1maxItems 10Массив референсных изображений; элементы — адреса изображений, предоставляющих референсы для генерации изображения по изображению; рекомендуется указать в prompt субъект, стиль или композиционную роль, соответствующую каждому изображению.
Array [ string ]
aspect_ratiostringНеобязательноСоотношение сторон выходного изображения; определяет только пропорции, но не точные размеры в пикселях.
1:14:33:416:99:163:22:321:9Показать все (1)
9:21output_formatstringНеобязательноПо умолчанию: "webp"Формат файла для скачивания изображения, по умолчанию webp.
jpegpngwebpcallbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/image-to-image",
  "input": {
    "prompt": "…",
    "image_urls": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/image-to-image",
input: {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/image-to-image",
"input": {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Как вызывать kling-4.0/image-to-video на HiAPI: curl, Python и опрос
-

Сравнительный обзор
Recraft v4.1 Flash 文生图横向对比:开发者选型与迁移指南
用每张 $0.01 的成本与纯文生图能力,判断它是否适合你的图像生成流水线
-

Руководство
Как использовать kling-4.0/text-to-video через HiAPI API: curl, Python и рабочий пример запроса
Практическое руководство для разработчиков: кинематографичные промпты, синхронный звук, асинхронный опрос и скачивание результатов
-

Руководство
Практика генерации изображений по тексту с recraft-v4.1-flash: 5 ценных бизнес-сценариев и ключевые моменты интеграции
Отталкиваясь от стоимости $0.01 за изображение, спланируйте внедрение генерации изображений в реальные бизнес-процессы
-

Сравнительный обзор
hailuo-2.3-fast/image-to-video — горизонтальное сравнение: как выбрать модель «изображение в видео» и что учесть при миграции
-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
kandinsky-6.0-pro/image-to-video в HiAPI: руководство по curl + Python
Как выполнить рабочий запрос генерации видео из изображения в HiAPI: от загрузки первого кадра до асинхронного опроса и финальной загрузки
Похожие модели
Все модели →Тот же тип
-
 Recraft V4.1 Recraft $0.010 /изображение
-
 Qwen Image 3.0 Alibaba $0.036 /изображение
-
 Google Virtual Try-On Google $0.107 /изображение
-
 Imagen 4 Google $0.030 /изображение
-
 Ideogram V3 Character Ideogram $0.090 /изображение
-
 Grok Imagine xAI $0.011 /секунду
-
 BRIA Product Shot Bria $0.058 /изображение
-
 Krea 3 Krea $0.036 /изображение
-
 Ideogram V4.5 Ideogram $0.011 /изображение
-
 Krea 2 Medium Turbo Krea $0.021 /изображение
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /изображение
-
 Seedream 5.0 ByteDance $0.025 /изображение