
教程
flux-3-max/keyframes-to-video 实战:5 个高价值 image-to-video 应用场景
从关键帧到成片:面向开发者的场景选型、接入要点与成本估算
为什么用关键帧做视频,而不是纯文本生成
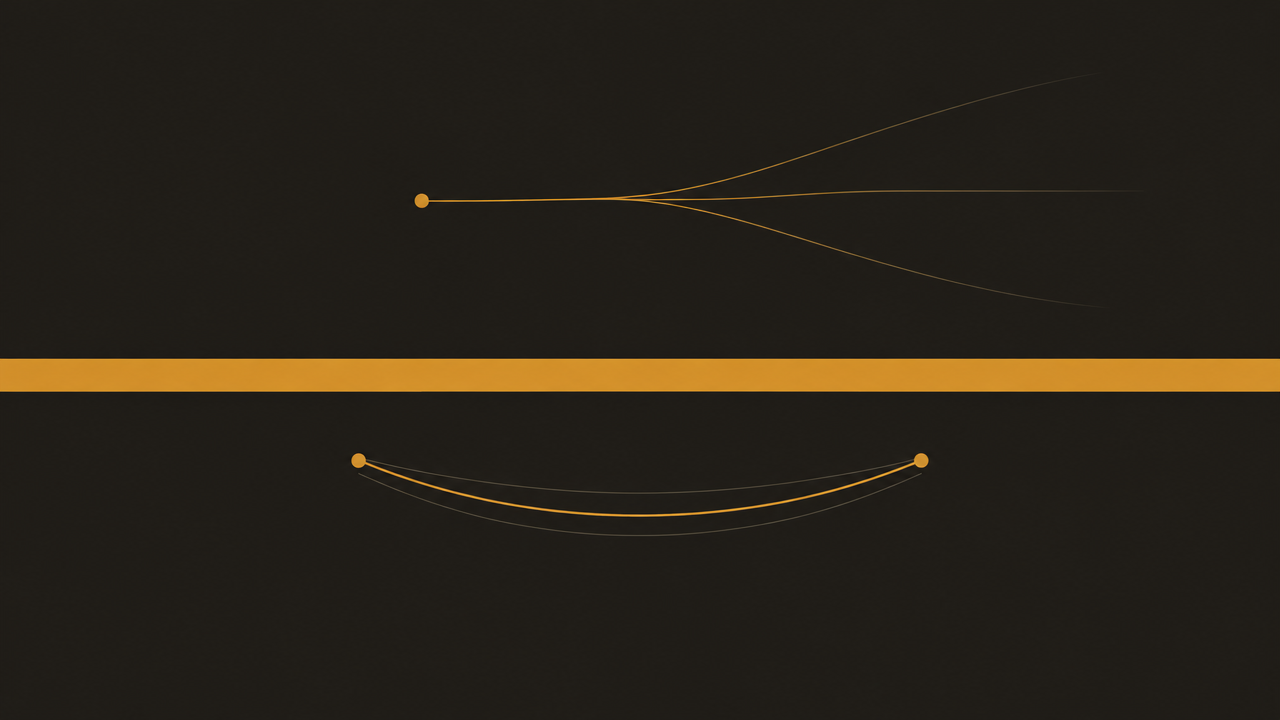
文生视频的输入只有一段文字,模型要在「什么都有可能」的空间里自由发挥;关键帧(image-to-video)则先把首帧、必要时再给出尾帧钉死,模型只需在给定的两个锚点之间补出运动。对开发者来说,这个差别直接决定了业务可控性。
纯文本生成的三个典型问题:同一提示词多次调用,构图、人物朝向、产品角度都可能漂移;画面主体与品牌素材不一致,需要人工二次筛选;一旦不满意,只能改词重跑,调试空间很窄。
关键帧方式把这部分不确定性前移到了你已经能精确控制的静态图上——图可以由设计师出、由渲染管线出、由商品图库出,视频模型负责的是「让这张图动起来」。这让交付物的下限变得可预期,也让失败排查有了明确方向:先看图对不对,再看动得对不对。
本文以 Black Forest Labs 的 flux-3-max/keyframes-to-video 为例,它在 HiAPI.ai 上的输出类型是视频,能力为 image-to-video,按输出秒数计费。接下来按 5 类场景拆解选型判断、关键帧设计思路与接入要点。
场景一:电商商品动态主图与短视频素材
最直接的用法:把商品白底图或场景图作为首帧,生成一段数秒的动态素材,用于详情页首屏、信息流素材或站内推荐位。
判断标准
- 商品本身有明确的运动语义:液体倾倒、织物垂坠、配件旋转、光影扫过表面。
- 静态图质量足够高、主体边缘干净;模糊或压缩严重的图会放大成片瑕疵。
- SKU 数量大、素材更新频繁,人工拍摄跟不上节奏。
关键帧设计
首帧决定构图,因此商品图应先按目标画幅裁切好,不要指望模型替你重新构图。如果有明确的结束状态(比如盖子合上、包装转正),把尾帧也作为锚点传进去,能显著减少运动跑偏;没有把握时宁可不给尾帧,只给首帧并要求运动幅度小。
提示词应只描述运动,不重复描述商品本身——商品信息已经由图承担,提示词越聚焦,模型越不容易「自由发挥」。
时长与成本权衡
电商素材通常只需要数秒的循环感镜头。按输出秒数计费意味着时长是成本的主开关:先确认投放位实际需要多长,再决定生成长度,而不是统一按最长时长生成后裁剪。批量场景下建议先用少量 SKU 跑通画质,再扩量。
场景二:品牌 KV 与营销物料的延展动效
品牌主视觉(KV)通常是一张精心设计的静态画面,营销团队需要它出现在开屏、短视频封面、楼宇屏、社媒多尺寸版本里,而动效版本往往是最贵的环节。
适配点
用 KV 作为首帧,可以生成轻微的镜头推移、光效流动、背景元素缓动,让同一张主视觉在不同渠道呈现出「一条片子」的观感,而不是简单贴图。
视觉一致性怎么保证
- 多尺寸分批生成,而不是一图通吃:先按每个渠道画幅裁出合适的首帧,再分别生成。强行让模型在生成阶段改画幅,构图风险更高。
- 提示词写「不动什么」:明确要求主体位置、logo 区域、文字区域保持稳定,运动只发生在背景层。
- 控制运动幅度:品牌物料追求克制,提示词里应强调缓慢、小幅、循环友好。
需要提前知道的边界
关键帧视频模型不负责排版,画面内的文字与 logo 应在生成前的静态图阶段就确定;如果动效版本需要精确的转场节奏或与音乐卡点,这类需求更适合走传统剪辑,把生成片段作为素材源使用。
场景三:游戏与动画的分镜预演
预演(previs)要解决的是「这段节奏对不对、镜头语言成不成立」,而不是最终画质。传统流程里验证这些问题需要建模、绑定、渲染,成本高、周期长;用两张关键帧生成中间过渡,就能在几分钟内拿到可讨论的动态草案。
工作方式
为镜头 A 和镜头 B 各出一张静态关键帧,把它们作为首帧与尾帧传入,生成中间的过渡片段。多个片段拼接起来,就形成一条可播放的预演时间线,用来检查剪辑点、镜头长度和动作衔接。
接入要点
- 首尾帧的构图要能衔接:前后两帧的机位、主体比例应大体连续,否则模型会生成大幅运镜来「弥合」,反而不像真实镜头。
- 一次只验证一件事:想验证节奏就固定机位,想验证运镜就减少动作元素,避免多个变量混在一起导致返工判断困难。
- 产物是过程物料:预演片段不进入最终交付,因此可以接受更低的分辨率和更短的时长来压成本。
不适用边界
需要严格符合游戏内实际可玩视角、或必须与既有骨骼动画完全一致的需求,不适合用生成模型替代;预演的价值在于快速试错,不在于替代正式制作。
场景四:社交与内容平台的模板化创作
面向 C 端或创作者工具时,image-to-video 真正的产品形态是「模板」:用户上传一张图或选一个预设,点一下就能得到一段可发布的短视频。
封装思路
- 收敛输入:只让用户提供首帧图,尾帧、提示词、时长、分辨率全部由模板预设,用户不需要理解模型。
- 固定提示词模板:每类模板对应一套经过验证的运动描述,避免用户自由输入导致成片质量方差过大。
- 即时反馈:视频任务是异步的,产品侧要设计排队、进度与完成通知,不能让用户对着空白页等待。
成本控制
模板化产品的用量不可预测,按输出秒数计费意味着单次调用成本与用户选择的时长线性相关。常见的做法是按模板档位限制可选时长,把长时长作为更高门槛的能力;同时对待生成请求做前置校验(图片尺寸、格式、内容合规),避免无效任务消耗额度。
质量兜底
用户上传的图片质量不可控,建议在生成前做基础检查,并在结果页提供重试入口。把「重新生成一次」当作产品能力而非异常处理,能显著降低客诉。
场景五:建筑、展陈与产品概念的可视化演示
建筑效果图、展陈方案、工业产品的外观渲染,通常由静态渲染产出。提案与评审沟通时,客户想看的是「走进去是什么感觉」「这个东西转起来是什么样」,而重新做动画演示的成本与周期都远超静态图。
用法
以一张静态渲染图作为首帧,生成带摄影机缓慢推进、绕行或环境光变化的短片,用于提案汇报、展会循环播放、众筹页面的概念演示。这类场景对画面里的具体细节准确度要求低于电商,但对「氛围可信」要求高。
设计要点
- 运动要符合物理直觉:建筑演示里,镜头平移的比例、视点高度应保持一致,提示词里描述摄影机行为比描述场景内容更有效。
- 多张渲染图分批生成:不同角度各生成一段,再在剪辑里串联,比让模型一口气完成多角度更可控。
- 明确标注概念属性:生成片段属于概念演示,交付文档中应与施工图、量产图区分,避免被理解为最终形态。
何时不该用
需要尺寸精确、材质参数可核验的正式评审材料,仍应以专业渲染与建模为准;生成视频适合承担沟通与想象的部分。
工程接入要点:异步任务、重试与结果管理
视频生成不是同步请求。无论哪类场景,工程侧都要按异步任务来设计。
任务生命周期
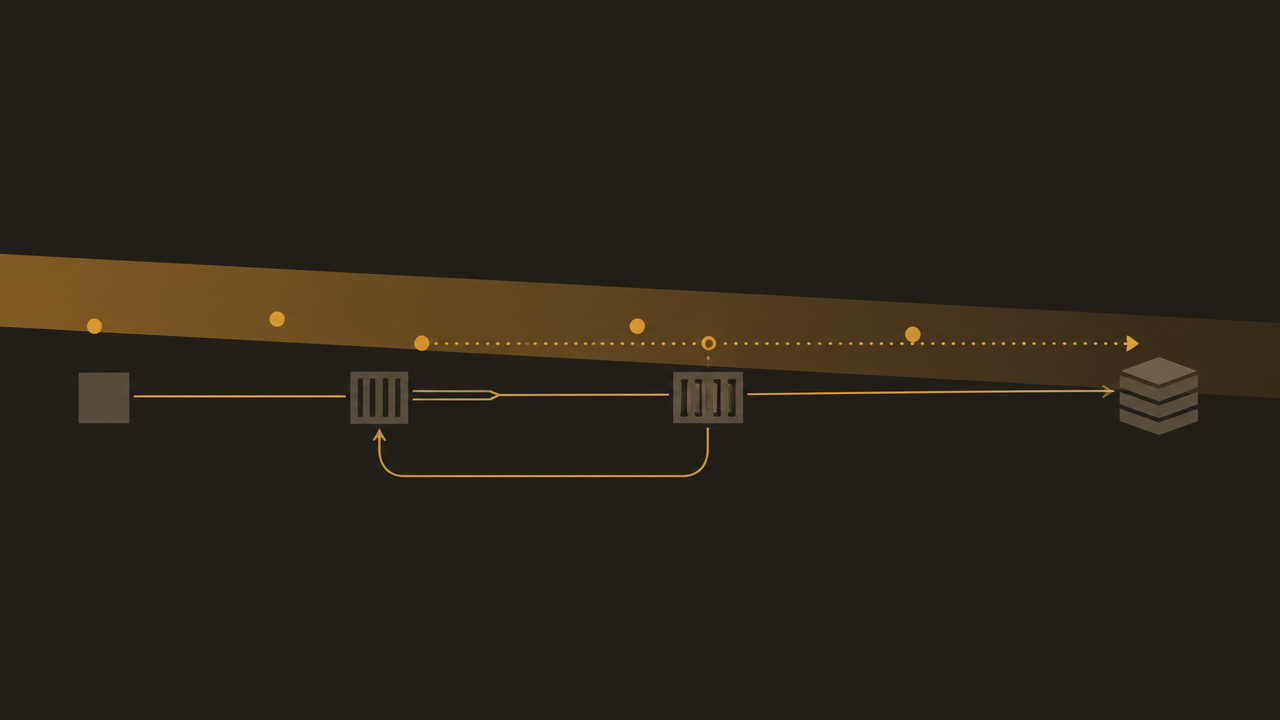
提交任务后拿到任务标识,通过轮询或回调获取状态,完成后从返回地址下载产物。把这三步拆成独立的状态机,而不是在一次请求里写死等待逻辑。
超时与重试
- 区分失败类型:参数错误、输入图不合规属于不可重试;服务端临时错误、排队超时属于可重试。
- 重试要幂等:每条任务使用自己的请求标识与业务侧 ID 关联,重试时避免重复计费与重复落库。
- 设置任务级超时上限:超过预期时长仍无结果的任务应标记为失败并进入人工核查,而不是无限轮询。
结果存储
生成结果的地址通常是临时的,务必在任务完成后第一时间转存到自有对象存储,并在数据库中记录任务 ID、输入图、提示词、时长参数与最终文件路径。这条记录既是复现依据,也是后续成本归因的基础。
并发与配额
批量场景(如电商多 SKU)应使用队列削峰,按业务优先级分配并发;给不同业务线设置独立的额度上限,避免一个批量任务挤占线上请求。同时把生成时长、分辨率作为任务参数显式记录,便于事后分析成本结构。
成本模型与上线前的验收清单
成本估算方法
flux-3-max/keyframes-to-video 按输出秒数计费。估算单条视频成本时,用「输出秒数 × 每秒单价」即可;批量场景再乘以条数。需要注意的变量有三个:
- 时长:最直接的成本开关,多数场景应先确认最短可用时长,再考虑加长。
- 重试与废片:实际成本 = 有效成片成本 + 重试成本。把失败率与重试率纳入估算,比只算单价更接近真实支出。
- 分辨率与画幅策略:按目标投放位确定画幅与清晰度,避免统一按最高规格生成后压缩。
实时价格请以 HiAPI.ai 站点价格面板为准,本文不列出具体数字口径之外的信息。
上线前验收清单
- 关键帧质量:首帧是否按目标画幅裁切、主体边缘是否干净、有无文字需在静态阶段解决。
- 运动可控性:同一输入多次生成的结果方差是否在可接受范围,失败样本是否有明确归因。
- 时长与画幅:是否按投放位最小化生成规格。
- 异步链路:轮询/回调、超时、幂等重试、结果转存是否完整。
- 成本看板:能否按业务线统计调用条数、输出秒数与失败率。
- 边界文档:明确哪些需求不进入视频模型(精确文字排版、严格物理一致、正式施工材料等)。
把关键帧当作可控输入、把时长当作成本旋钮,先小批量验证再扩量,是这类能力落地最稳妥的路径。需要查看模型能力与接入方式时,可从 HiAPI.ai 的 flux-3-max/keyframes-to-video 模型页开始。


