
Tutorial
flux-3-max/keyframes-to-video in der Praxis: 5 wertvolle Image-to-Video-Anwendungsszenarien
Von Keyframes zum fertigen Clip: Szenarioauswahl, Integrationspunkte und Kostenkalkulation für Entwickler
Warum Keyframes statt reiner Textgenerierung für Videos
Text-to-Video erhält als Eingabe nur einen Textabschnitt, und das Modell muss im Raum des „alles ist möglich“ frei improvisieren; Keyframes (Image-to-Video) hingegen legen zunächst das erste Frame und bei Bedarf auch das letzte Frame fest, sodass das Modell nur zwischen zwei vorgegebenen Ankern die Bewegung ergänzen muss. Für Entwickler entscheidet dieser Unterschied direkt über die Kontrollierbarkeit im Geschäftseinsatz.
Die drei typischen Probleme der reinen Textgenerierung: Derselbe Prompt führt bei mehreren Aufrufen zu driften in Komposition, Blickrichtung der Figuren oder Produktwinkel; das Bildsubjekt stimmt nicht mit dem Markenmaterial überein und erfordert manuelle Nachauswahl; bei Unzufriedenheit bleibt nur das Umformulieren des Prompts und ein erneuter Lauf – der Spielraum für Debugging ist gering.
Der Keyframe-Ansatz verlagert diese Unsicherheit in das statische Bild, das Sie bereits präzise kontrollieren können – das Bild kann vom Designer, aus einer Rendering-Pipeline oder aus der Produktbildbibliothek stammen, und das Videomodell sorgt dafür, „dieses Bild in Bewegung zu bringen“. Dadurch wird die Untergrenze des Lieferergebnisses planbar, und die Fehlersuche erhält eine klare Richtung: erst prüfen, ob das Bild stimmt, dann, ob die Bewegung stimmt.
Dieser Artikel nimmt flux-3-max/keyframes-to-video von Black Forest Labs als Beispiel; der Ausgabetyp auf HiAPI.ai ist Video, die Fähigkeit ist Image-to-Video, und die Abrechnung erfolgt nach Ausgabesekunden. Im Folgenden werden anhand von 5 Szenarioklassen Auswahlentscheidungen, Keyframe-Designansätze und Integrationspunkte aufgeschlüsselt.
Szenario 1: Dynamische Produkthauptbilder und Kurzvideomaterial für den E-Commerce
Die direkteste Anwendung: Ein Produktbild auf weißem Hintergrund oder ein Szenenbild dient als erstes Frame, um ein einige Sekunden langes dynamisches Material zu erzeugen, das für den ersten Bildschirm der Detailseite, für Feed-Material oder für Empfehlungsplätze innerhalb der Website verwendet wird.
Beurteilungskriterien
- Das Produkt selbst hat eine klare Bewegungssemantik: Flüssigkeit wird eingegossen, Stoff fällt, Zubehör dreht sich, Licht streift über die Oberfläche.
- Die statische Bildqualität ist ausreichend hoch und die Subjektkanten sind sauber; unscharfe oder stark komprimierte Bilder verstärken Fehler im fertigen Video.
- Die SKU-Anzahl ist groß und das Material wird häufig aktualisiert, sodass manuelle Aufnahmen nicht Schritt halten können.
Keyframe-Design
Das erste Frame bestimmt die Komposition, daher sollte das Produktbild zunächst auf das Zielformat zugeschnitten werden; verlassen Sie sich nicht darauf, dass das Modell die Komposition neu gestaltet. Wenn es einen klaren Endzustand gibt (z. B. der Deckel schließt sich, die Verpackung dreht sich in die frontale Ansicht), übergeben Sie auch das letzte Frame als Anker – das reduziert deutlich abweichende Bewegungen; im Zweifel lieber kein letztes Frame angeben und nur das erste Frame mit der Vorgabe einer geringen Bewegungsamplitude verwenden.
Der Prompt sollte nur die Bewegung beschreiben und nicht das Produkt selbst wiederholen – die Produktinformationen trägt bereits das Bild, und je fokussierter der Prompt, desto weniger neigt das Modell zu „freier Improvisation“.
Abwägung von Dauer und Kosten
E-Commerce-Material benötigt in der Regel nur eine einige Sekunden lange, loop-taugliche Aufnahme. Die Abrechnung nach Ausgabesekunden bedeutet, dass die Dauer der wichtigste Kostenhebel ist: Klären Sie zuerst, wie lang der Ausspielplatz tatsächlich benötigt, und entscheiden Sie dann über die Generierungslänge, statt einheitlich in der maximalen Länge zu generieren und anschließend zu kürzen. Bei Batch-Szenarien empfiehlt es sich, zunächst mit wenigen SKUs die Bildqualität zu validieren und dann zu skalieren.
Szenario 2: Erweiterte Bewegungseffekte für Marken-KV und Marketingmaterialien
Das Marken-Key-Visual (KV) ist in der Regel ein sorgfältig gestaltetes statisches Bild, das das Marketingteam in Splash-Screens, Kurzvideo-Covern, Gebäudedisplays und mehrgrößigen Social-Media-Versionen einsetzen möchte – und die Animationsversion ist oft der teuerste Schritt.
Eignung
Mit dem KV als erstem Frame lassen sich leichte Kamerafahrten, fließende Lichteffekte und sanfte Bewegungen von Hintergrundelementen erzeugen, sodass dasselbe Key Visual auf verschiedenen Kanälen den Eindruck „eines Films“ vermittelt statt einfach nur als Standbild eingeblendet zu werden.
Wie visuelle Konsistenz gewährleistet wird
- Mehrere Größen in separaten Durchläufen generieren statt ein Bild für alles: Schneiden Sie zunächst für jeden Kanal ein passendes erstes Frame zu und generieren Sie dann separat. Erzwingt man im Generierungsschritt eine Formatänderung, ist das Kompositionsrisiko höher.
- Im Prompt formulieren, „was sich nicht bewegt“: Explizit fordern, dass Subjektposition, Logo-Bereich und Textbereich stabil bleiben und Bewegung nur in der Hintergrundebene stattfindet.
- Bewegungsamplitude kontrollieren: Markenmaterialien streben Zurückhaltung an; im Prompt sollte langsam, mit geringer Amplitude und loop-freundlich betont werden.
Grenzen, die im Voraus bekannt sein sollten
Keyframe-Videomodelle sind nicht für das Layout zuständig; Text und Logos im Bild sollten bereits in der statischen Bildphase vor der Generierung festgelegt sein. Wenn die Animationsversion ein präzises Übergangstempo oder Synchronisation mit Musikakzenten erfordert, eignen sich solche Anforderungen besser für klassischen Schnitt, wobei die generierten Segmente als Materialquelle dienen.
Szenario 3: Storyboard-Previs für Spiele und Animation
Previs (Previsualisierung) soll klären, „ob dieser Rhythmus stimmt und ob die Bildsprache funktioniert“, nicht die endgültige Bildqualität liefern. Im traditionellen Ablauf erfordert die Validierung dieser Fragen Modellierung, Rigging und Rendering – hohe Kosten und lange Zyklen; mit zwei Keyframes zur Generierung der Zwischenübergänge erhält man in wenigen Minuten einen diskutierbaren dynamischen Entwurf.
Arbeitsweise
Erstellen Sie für Einstellung A und Einstellung B jeweils ein statisches Keyframe, übergeben Sie diese als erstes und letztes Frame und generieren Sie das Übergangssegment dazwischen. Durch Aneinanderreihen mehrerer Segmente entsteht eine abspielbare Previs-Timeline, mit der Schnittpunkte, Einstellungslängen und Bewegungsübergänge geprüft werden.
Integrationspunkte
- Die Komposition von erstem und letztem Frame muss anschlussfähig sein: Kameraposition und Subjektproportionen der beiden Frames sollten weitgehend kontinuierlich sein; andernfalls erzeugt das Modell große Kamerabewegungen, um „zu überbrücken“, was weniger wie eine echte Einstellung wirkt.
- Pro Durchlauf nur eine Sache validieren: Wer den Rhythmus prüfen will, fixiert die Kamera; wer die Kamerafahrt prüfen will, reduziert Bewegungselemente – so vermeidet man, dass mehrere Variablen sich vermischen und die Nacharbeit schwer zu beurteilen ist.
- Das Ergebnis ist Prozessmaterial: Previs-Segmente fließen nicht in die Endabgabe ein, daher sind niedrigere Auflösungen und kürzere Dauern zur Kostensenkung akzeptabel.
Ungeeignete Grenzen
Anforderungen, die streng der tatsächlich spielbaren Perspektive im Spiel entsprechen müssen oder vollständig mit bestehenden Skelettanimationen übereinstimmen müssen, eignen sich nicht für den Ersatz durch generative Modelle; der Wert von Previs liegt im schnellen Ausprobieren, nicht im Ersetzen der offiziellen Produktion.
Szenario 4: Template-basierte Kreation für Social- und Content-Plattformen
Für Endkunden oder Creator-Tools ist die eigentliche Produktform von Image-to-Video das „Template“: Nutzer laden ein Bild hoch oder wählen eine Voreinstellung, klicken einmal und erhalten ein veröffentlichungsfähiges Kurzvideo.
Kapselungsansatz
- Eingaben eingrenzen: Nutzer liefern nur das erste Frame; letztes Frame, Prompt, Dauer und Auflösung werden alle durch das Template voreingestellt, sodass Nutzer das Modell nicht verstehen müssen.
- Feste Prompt-Templates: Jede Template-Kategorie entspricht einer validierten Bewegungsbeschreibung, um zu vermeiden, dass freie Nutzereingaben eine zu große Varianz der Ergebnisqualität verursachen.
- Sofortiges Feedback: Videoaufgaben sind asynchron; die Produktseite muss Warteschlange, Fortschritt und Abschlussbenachrichtigungen gestalten, damit Nutzer nicht vor einer leeren Seite warten.
Kostenkontrolle
Die Nutzung template-basierter Produkte ist unvorhersehbar, und die Abrechnung nach Ausgabesekunden bedeutet, dass die Kosten pro Aufruf linear von der gewählten Dauer abhängen. Üblich ist, die wählbare Dauer je Template-Stufe zu begrenzen und lange Dauern als Fähigkeit mit höherer Schwelle anzubieten; zugleich sollten Generierungsanforderungen vorab validiert werden (Bildgröße, Format, Inhaltskonformität), um zu vermeiden, dass ungültige Aufgaben Kontingent verbrauchen.
Qualitätsabsicherung
Die Qualität hochgeladener Bilder ist unkontrollierbar; es empfiehlt sich, vor der Generierung Basisprüfungen durchzuführen und auf der Ergebnisseite einen Wiederholungs-Einstieg anzubieten. „Noch einmal generieren“ als Produktfunktion statt als Ausnahmebehandlung zu betrachten, senkt Kundenbeschwerden deutlich.
Szenario 5: Visualisierungsdemos für Architektur, Ausstellungen und Produktkonzepte
Architektur-Renderings, Ausstellungskonzepte und Oberflächenrenderings industrieller Produkte werden üblicherweise als statische Renderings erzeugt. Bei Angeboten und Reviews möchten Kunden sehen, „wie es sich anfühlt, hineinzugehen“ oder „wie es aussieht, wenn sich das Ding dreht“ – doch die erneute Erstellung einer Animationsdemo übersteigt Kosten und Zyklus von statischen Bildern bei Weitem.
Anwendung
Ein statisches Rendering dient als erstes Frame, um einen kurzen Clip mit langsamer Kameravorwärtsbewegung, Umrundung oder Änderungen des Umgebungslichts zu erzeugen, der für Angebotspräsentationen, Loop-Wiedergabe auf Messen oder Konzeptdemos auf Crowdfunding-Seiten verwendet wird. Solche Szenarien stellen geringere Anforderungen an die Genauigkeit konkreter Details im Bild als der E-Commerce, aber hohe Anforderungen an „glaubwürdige Atmosphäre“.
Designpunkte
- Bewegung muss der physikalischen Intuition entsprechen: Bei Architekturdemos sollten Proportionen der Kameraverschiebung und Augenhöhe konsistent bleiben; im Prompt ist die Beschreibung des Kamerverhaltens wirksamer als die Beschreibung des Szeneninhalts.
- Mehrere Renderings in separaten Durchläufen generieren: Für verschiedene Winkel jeweils ein Segment erzeugen und diese im Schnitt aneinanderreihen – kontrollierbarer, als das Modell mehrere Winkel in einem Durchgang erledigen zu lassen.
- Konzeptcharakter klar kennzeichnen: Generierte Segmente sind Konzeptdemos und sollten in Lieferdokumenten von Ausführungszeichnungen und Serienbildern unterschieden werden, damit sie nicht als endgültige Form verstanden werden.
Wann es nicht eingesetzt werden sollte
Für offizielle Review-Materialien, die maßgenau sein müssen und prüfbare Materialparameter erfordern, sollten weiterhin professionelles Rendering und Modellierung maßgeblich sein; generierte Videos eignen sich für den Teil, der Kommunikation und Vorstellungskraft dient.
Technische Integrationspunkte: asynchrone Aufgaben, Wiederholungen und Ergebnisverwaltung
Videogenerierung ist keine synchrone Anfrage. Unabhängig vom Szenario muss die technische Seite als asynchrone Aufgabe konzipiert werden.
Aufgaben-Lebenszyklus
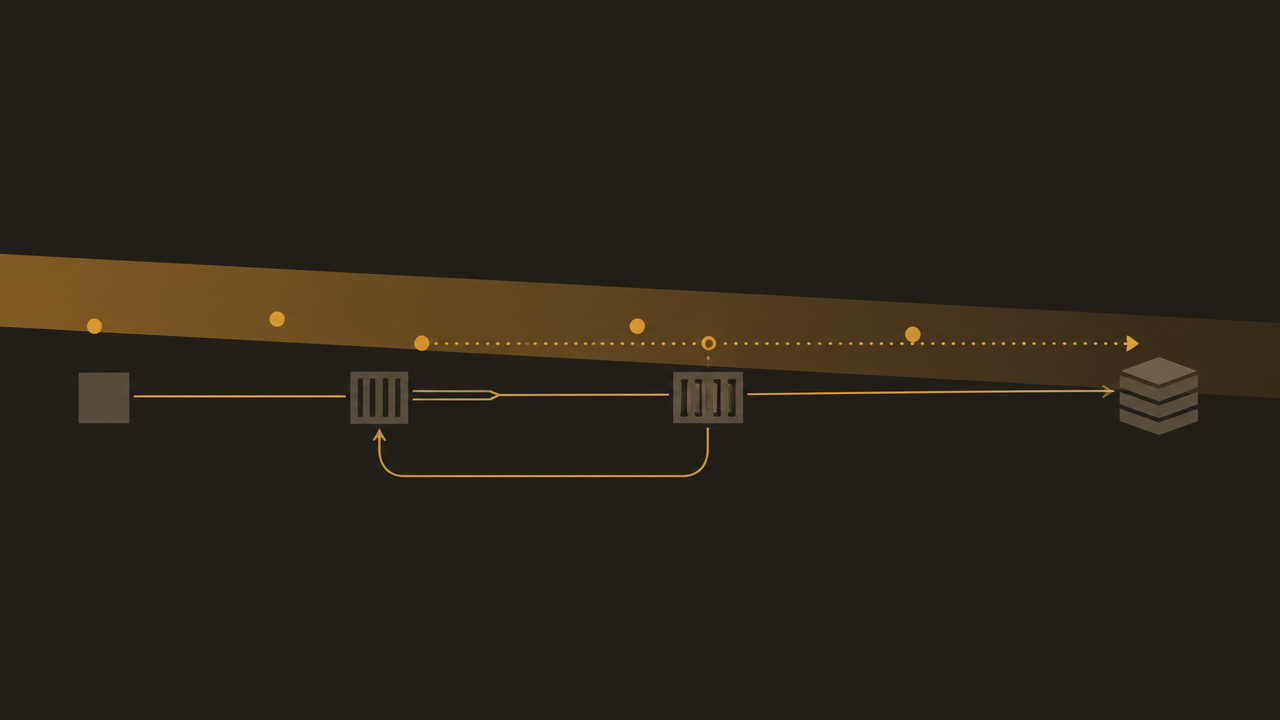
Nach dem Einreichen der Aufgabe erhält man eine Aufgabenkennung, ruft den Status per Polling oder Callback ab und lädt nach Abschluss das Ergebnis von der zurückgegebenen Adresse herunter. Teilen Sie diese drei Schritte in eine eigenständige Zustandsmaschine auf, statt die Wartelogik fest in eine Anfrage zu schreiben.
Timeouts und Wiederholungen
- Fehlertypen unterscheiden: Parameterfehler und nicht konforme Eingabebilder sind nicht wiederholbar; temporäre Serverfehler und Warteschlangen-Timeouts sind wiederholbar.
- Wiederholungen müssen idempotent sein: Jede Aufgabe verwendet ihre eigene Anfragekennung und wird mit einer geschäftsseitigen ID verknüpft, um bei Wiederholungen doppelte Abrechnung und doppelte Datenbankeinträge zu vermeiden.
- Obergrenze für Aufgaben-Timeout festlegen: Aufgaben, die nach der erwarteten Dauer noch kein Ergebnis liefern, sollten als fehlgeschlagen markiert und zur manuellen Prüfung weitergeleitet werden, statt unbegrenzt gepollt zu werden.
Ergebnisspeicherung
Die Adressen generierter Ergebnisse sind in der Regel temporär; speichern Sie sie daher unmittelbar nach Aufgabenabschluss in den eigenen Objektspeicher und protokollieren Sie in der Datenbank Aufgaben-ID, Eingabebild, Prompt, Dauerparameter und endgültigen Dateipfad. Dieser Datensatz dient sowohl als Reproduktionsgrundlage als auch als Basis für die spätere Kostenattribution.
Parallelität und Kontingente
Batch-Szenarien (z. B. viele E-Commerce-SKUs) sollten Warteschlangen zur Spitzenentlastung nutzen und Parallelität nach Geschäftspriorität verteilen; legen Sie für verschiedene Geschäftsbereiche unabhängige Obergrenzen fest, damit eine Batch-Aufgabe keine Online-Anfragen verdrängt. Zeichnen Sie zugleich Generierungsdauer und Auflösung explizit als Aufgabenparameter auf, um die Kostenstruktur später analysieren zu können.
Kostenmodell und Abnahmeprüfliste vor dem Launch
Methode zur Kostenschätzung
flux-3-max/keyframes-to-video wird nach Ausgabesekunden abgerechnet. Zur Schätzung der Kosten eines einzelnen Videos genügt „Ausgabesekunden × Preis pro Sekunde“; bei Batch-Szenarien multipliziert man mit der Anzahl. Drei Variablen sind zu beachten:
- Dauer: der direkteste Kostenhebel; in den meisten Szenarien sollte zunächst die kürzeste nutzbare Dauer ermittelt und erst dann eine Verlängerung erwogen werden.
- Wiederholungen und Ausschuss: Die tatsächlichen Kosten = Kosten für gültige Fertigvideos + Wiederholungskosten. Fehlerrate und Wiederholungsrate in die Schätzung einzubeziehen kommt den realen Ausgaben näher als nur der Stückpreis.
- Auflösungs- und Formatstrategie: Format und Schärfe anhand des Ziel-Ausspielplatzes festlegen, statt einheitlich in höchster Spezifikation zu generieren und anschließend zu komprimieren.
Für tagesaktuelle Preise ist das Preispaneel auf der HiAPI.ai-Website maßgeblich; dieser Artikel nennt keine Informationen über die konkreten Zahlen hinaus.
Abnahmeprüfliste vor dem Launch
- Keyframe-Qualität: Ist das erste Frame auf das Zielformat zugeschnitten, sind die Subjektkanten sauber, gibt es Text, der in der statischen Phase gelöst werden muss.
- Bewegungskontrollierbarkeit: Liegt die Varianz der Ergebnisse bei mehreren Generierungen mit derselben Eingabe im akzeptablen Bereich, und sind Fehlerstichproben klar zuordenbar.
- Dauer und Format: Wurden die Generierungsspezifikationen anhand des Ausspielplatzes minimiert.
- Asynchrone Kette: Sind Polling/Callback, Timeouts, idempotente Wiederholungen und Ergebnisübertragung vollständig.
- Kosten-Dashboard: Können Aufrufanzahl, Ausgabesekunden und Fehlerrate je Geschäftsbereich statistisch erfasst werden.
- Grenzdokumentation: Klar festhalten, welche Anforderungen nicht in das Videomodell gelangen (präzises Textlayout, strikte physikalische Konsistenz, offizielle Baumaterialien usw.).
Keyframes als kontrollierbare Eingabe zu behandeln, die Dauer als Kostenregler zu nutzen und zunächst in kleinen Chargen zu validieren, bevor skaliert wird – das ist der sicherste Weg, diese Fähigkeit produktiv einzusetzen. Wenn Sie die Modellfähigkeiten und Integrationswege einsehen möchten, beginnen Sie mit der Modellseite von flux-3-max/keyframes-to-video auf HiAPI.ai.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses