
使用指南
通过 HiAPI API 使用 gpt-6.1-terra 生成电商产品图片
可复用的提示词模板与一份可运行的 HiAPI 请求,实现可扩展的产品图片生成
为什么产品图片工作流适合使用 gpt-6.1-terra
产品图片是电商流水线中最后仍依赖人工制作的环节之一。集成商品列表系统的开发者最终都会遇到同一道坎:每个 SKU 都需要一张主图、一张干净的产品图,往往还需要一张场景图,而过去每张素材都意味着摄影师、修图师和一整套排期流程。通过 HiAPI 调用 gpt-6.1-terra,改变了这项工作在架构中的位置——图片不再是一次性上传的静态文件,而是由原本就负责商品目录数据的同一服务层生成的产物。
实际的变化在于:图片生成变成了代码中的一个函数,而非日历上的一次安排。你的产品记录(标题、属性、颜色、材质、使用场景)成为输入;模型调用成为变换;输出进入审核队列后才发布。这种重新定位会影响开发者关心的若干决策:
- 生成在哪里运行。 它可以放在内部端点之后、队列 worker 中,或作为新 SKU 的构建步骤。由于 HiAPI 暴露统一的接口,无论你在哪个环境之间迁移,调用的形状都不变。
- 什么保持不变(确定性)。 提示词模板、槽位校验和输出检查都是你的代码。模型负责渲染;一致性由你掌控。
- 目录如何扩展。 新增 SKU 不再需要拍摄——只需要一个有效的提示词载荷和一道通过的校验关卡。
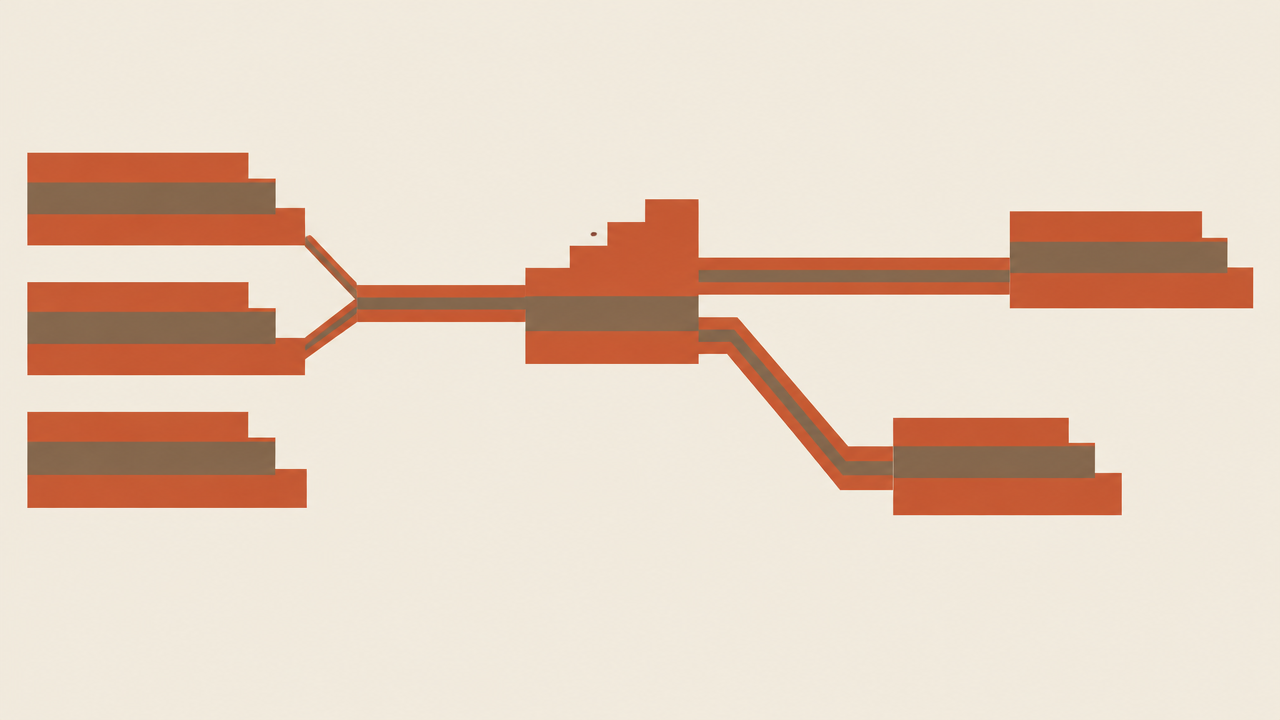
一个有用的心智模型是四阶段流水线:结构化产品数据通过 HiAPI 进入模型调用,结果进入审核队列,获批的素材被提升到店铺前台。本指南中的一切都映射到这四个阶段之一,后续章节会拆解提示词、请求及其周边的防护措施。
如果你把 gpt-6.1-terra 当作渲染依赖而非创意工具,剩下的集成工作就变成了普通的工程问题:schema 校验、重试、批处理和审核关卡。
产品图片提示词的构成
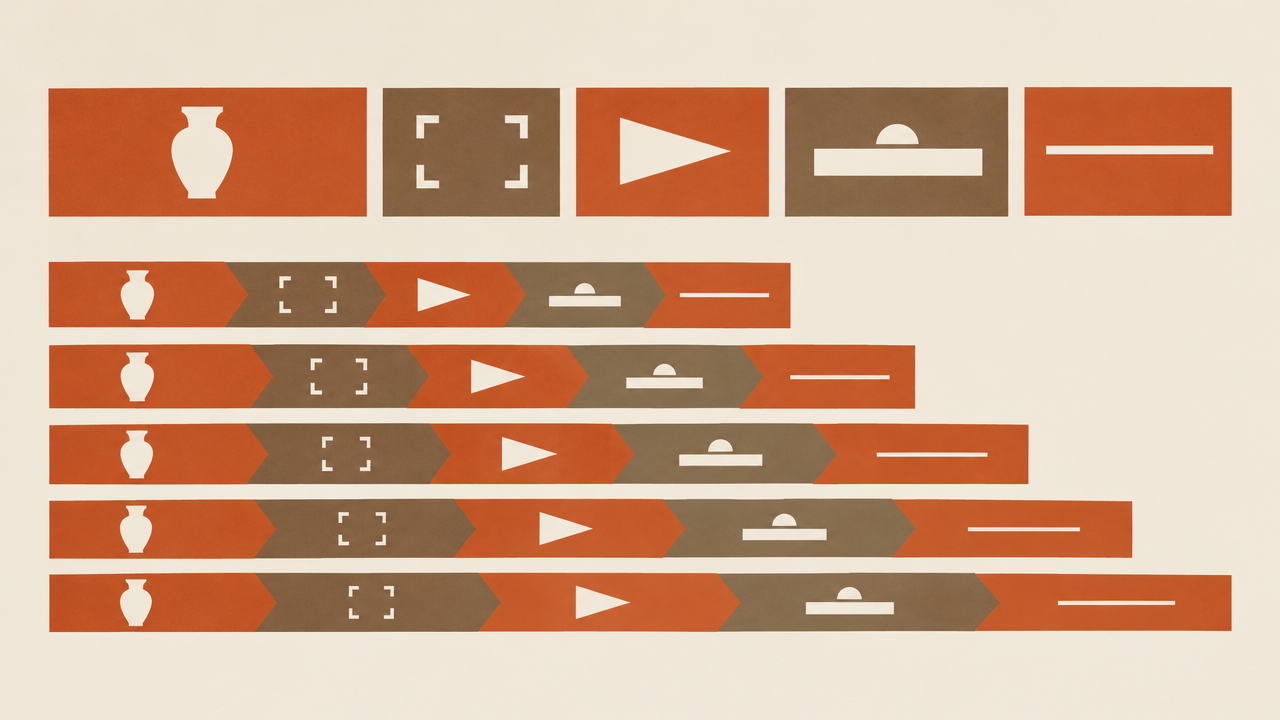
一个能在上千个 SKU 上复用的提示词,与只能用一次的提示词,区别在于结构。可用于商品目录的提示词是一组具名槽位,由应用从产品数据中填充,而不是人工输入的自由文本。将其拆成五个槽位:
主体
产品是什么,用平实、具体的名词描述。从目录属性中提取:类别、材质、颜色、尺寸、显著特征。保持事实性——模型渲染你所描述的内容,因此省略产品记录中没有的信息。
构图
产品在画面中的位置以及占据画面的比例。典型取值:居中、俯视、四分之三视角、满幅。主图与产品图的分歧就在这里。
光照
灯光布置与氛围。柔和影棚光、硬质方向光、透过窗户的自然光。光照是对主观质量影响最大的单一槽位,因此定义一套小的词汇并复用。
背景
产品周围的环境——无缝白底、浅灰渐变、具名场景语境。对于目录工作,保持背景单调一致;把场景多样性留给场景图变体。
约束
让输出可用的规则:无文字叠加、除提供外无 logo、无额外道具、产品占据中央画面、无遮挡标签的反光。约束是把一张好看的图变成可上架素材的关键。
在代码中把每个槽位当作有类型的字段。主体和约束来自产品记录与固定策略;构图、光照和背景来自按图片类型索引的小型枚举。按固定顺序组合它们——主体、构图、光照、背景、约束——这样两个提示词之间的 diff 反映的是真实变化,而非措辞噪声。当某个提示词未通过审核,你可以只调整一个槽位,而无需重写全部。
可复用的提示词模板
下面的模板遵循五槽位结构。每个模板都是一个带有 {placeholders} 的骨架,由你的代码从产品数据中填充。把它们纳入版本控制——提示词模板是一份生产配置,而不是一次性的字符串。
主图
Subject: {product_name}, {color}, {material}, {defining_feature}
Composition: centered, three-quarter angle, product occupies roughly 60% of frame
Lighting: soft studio lighting with a subtle key light from upper left
Background: light neutral gradient, no visible horizon
Constraints: no text, no logos, no extra props, label fully legible, no harsh shadows
用于类别落地页和列表主视觉。这里跨 SKU 的一致性比新颖性更重要。
产品图
Subject: {product_name}, {color}, {material}
Composition: straight-on, product centered and fully visible, even margins on all sides
Lighting: flat even studio lighting, minimal shadow
Background: pure seamless white
Constraints: no text, no logos, no props, no reflection artifacts, product edges crisp against background
产品图是约束最多的模板。不要添加氛围感——市场和对比网格更青睐统一性。
场景图
Subject: {product_name}, {color}, {material}
Composition: {placement}, product in natural use context, shallow depth of field
Lighting: {lighting_mood}, consistent with {scene_time_of_day}
Background: {scene_description}, complementary tones to product color
Constraints: product remains the focal point, no readable text, no brand logos other than supplied, no people faces in sharp focus
场景模板变化最多,因此用一个小型场景库来驱动,而不是按 SKU 撰写文案。在同一类别的产品之间复用场景,以保持一致的观感。
在三个模板中,约束块都是不可协商的。当你新增模板时,逐字复制这些约束,只改变它们上方的槽位。
一份可运行的 gpt-6.1-terra HiAPI 请求
通过 HiAPI 调用 gpt-6.1-terra 与平台上任何其他模型调用遵循相同模式:向单一端点发送请求,用你的 HiAPI 密钥认证,并收到规范化响应。序列是客户端 → HiAPI 网关 → 模型,网关负责路由并返回结果或结构化错误。
配置
把密钥和 base URL 放在环境变量中,绝不写入源码:
export HIAPI_API_KEY="your-key-here"
export HIAPI_BASE_URL="https://api.hiapi.ai"
请求形状
请求携带模型标识符、由模板组合而成的提示词,以及图片类型所需的生成参数。一个最小的 Node.js 请求如下:
const res = await fetch(`${process.env.HIAPI_BASE_URL}/v1/generate`, {
  method: "POST",
  headers: {
    "Authorization": `Bearer ${process.env.HIAPI_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    model: "gpt-6.1-terra",
    prompt: composedPrompt,
    params: { aspect_ratio: "1:1" },
    metadata: { sku: product.sku, template: "packshot-v3" }
  })
});

if (!res.ok) {
  const err = await res.json();
  throw new Error(`HiAPI ${res.status}: ${err.message}`);
}

const data = await res.json();
集成注意事项
- 发送元数据。 把 SKU 和模板版本附加到每个请求上,能大幅简化下游的调试与审核,并让你把输出与商品目录记录关联起来。
- 发送前校验。 拒绝任何模板槽位为空或缺少约束块的请求。这样能在付出代价之前拦截大多数糟糕的生成。
- 显式处理错误。 区分校验错误(你的载荷有误)与瞬时故障(重试有意义)。后续章节会介绍重试策略。
- 存储响应,而不仅是素材。 把请求载荷与生成的图片一起持久化,使审核决策可以追溯到当时究竟请求了什么。
模板所需的具体参数名取决于你的图片类型——按模板版本把这些参数固定下来,使模板变更是可复现的。
批处理、校验与人工审核
生成一张图片是演示;生成一个目录则是运营问题。可行的流程是批量生成器输入自动校验,并在任何内容进入店铺前台之前设置人工审核关卡。
批处理
由以 SKU 为键的队列驱动批次。对每个 SKU,从正确的模板渲染提示词,向 HiAPI 提交请求,并将结果写入状态为 pending_review 的暂存存储。并发应当有界——固定 worker 池加退避比无界并行更容易推理,也能缩小故障影响范围。
自动校验
在人工查看输出之前运行廉价检查:
- 请求完整性。 每个槽位都已填充,约束存在,模板版本已记录。
- 素材基本检查。 图片可解码,尺寸匹配目标槽位,宽高比正确。
- 重复检测。 对输出做哈希,使跨 SKU 的相同图片立即浮现——通常意味着模板出了问题。
- 策略检查。 标记出看似违反约束块的输出,例如意外出现的文字或道具,进入优先审核。
任何未通过校验的内容都会带着原因进入 failed_validation 桶。不要对校验失败自动重试——它们表明是模板或数据问题,而非瞬时问题。
人工审核关卡
审核者看到生成的图片、源产品记录、渲染后的提示词和模板版本,并决定批准或拒绝。批准会将素材提升到店铺前台;拒绝会记录简短原因。这些原因是你的反馈回路:针对同一模板版本的一簇拒绝,是修改该模板的信号,而不是更激进地重试。
先从小样本 SKU 开始,审核每个输出,只有在拒绝率稳定后才扩大样本。审核关卡正是让你在不发布错误的情况下扩展规模的关键。
成本、延迟与故障处理
生成既花钱又花时间,因此生产系统需要针对两者的明确策略。由于定价按请求和生成参数计量,把成本视为按 SKU 分配的预算,而不是手工计算的数字——在 HiAPI 账户的价格面板中查看当前费率,并在代码中强制执行限制。
成本控制
- 每批次预算。 为每批运行分配最大生成次数,达到后停止。
- 每个模板版本只尝试一次。 校验失败的请求不应以相同提示词触发重试;它应回到模板负责人。
- 积极缓存。 如果某个 SKU 的提示词槽位和模板版本未变,复用已批准的素材而不重新生成。
- 模板分级。 对产品图使用最便宜且足够的配置,把更重的设置留给主图或场景图变体,那里质量最重要。
延迟
生成不是瞬时的,因此要按异步结果来设计。将请求排入队列,向调用方返回任务标识符,由 worker 在结果到达时写入。超时时间应绑定到队列的租约,而不是面向用户的 HTTP 请求。
故障处理决策树
当请求失败时,先分类再行动:
- 校验错误(4xx)。 修复载荷。不要重试。
- 速率限制或瞬时服务器错误(429/5xx)。 使用指数退避加抖动重试,限制在少量尝试次数内。如果尝试耗尽,把 SKU 标记为
deferred并继续。 - 同一 SKU 反复失败。 若存在最近一次已批准素材,回退到它;否则连同错误一起转入人工审核。
- 整个批次系统性失败。 停止批次,暴露错误,不要继续排空队列——继续只会让失败翻倍。
这个模式与任何外部依赖相同:限制重试次数,优先使用已知可用的回退方案,并让故障对拥有该模板的团队可见。
全目录上线前的检查清单
在把 gpt-6.1-terra 指向整个目录之前,逐项过一遍这个列表。每一项都对应一个只会在规模化时出现的故障模式。
- 模板已版本化并存储在代码中。 每个提示词都有负责人和变更日志;每次请求都会发送版本字符串。
- 槽位校验在服务端强制执行。 空主体和缺失约束块在请求离开你的服务之前即被拒绝。
- 自动检查先于人工审核运行。 解码、尺寸、重复和策略检查均已自动化,其结果被存储。
- 审核关卡已上线并有人员值守。 拒绝会记录原因,原因簇每周按模板版本进行复核。
- 重试与回退策略已定义。 校验错误绝不重试;瞬时错误以有界退避重试;反复失败则回退到最近一次已批准素材。
- 成本护栏已就位。 每批次生成上限、已批准输出的缓存和模板分层已配置并测试。
- 元数据已持久化。 SKU、模板版本和提示词载荷与每个生成的素材一起存储。
- 可以回滚。 如果生成被禁用,店铺前台仍能提供人工图片,且切换只是一项配置变更。
- 试点批次已通过审核。 从一个类别开始,扩展到一个品牌或地区,然后全面铺开。
运行试点,观察几个周期的拒绝率和批次失败率,然后才移除人工工作流。当你准备从试点转向生产时,请求形状保持不变——只有体量发生变化。


