
Guia de uso
Gerar imagens de produtos de e-commerce com gpt-6.1-terra via API HiAPI
Modelos de prompt reutilizáveis e uma requisição HiAPI executável para geração escalável de imagens de produtos
Por que o fluxo de trabalho de imagens de produtos combina com gpt-6.1-terra
Imagens de produtos são uma das últimas etapas do pipeline de e-commerce que ainda depende de produção manual. Desenvolvedores que integram sistemas de catálogo de produtos acabam sempre encontrando o mesmo obstáculo: cada SKU precisa de uma imagem principal, uma imagem limpa do produto e, muitas vezes, uma imagem de contexto, e no passado cada peça de mídia significava um fotógrafo, um editor de imagem e todo um processo de agendamento. Chamar gpt-6.1-terra via HiAPI muda a posição desse trabalho na arquitetura — as imagens deixam de ser arquivos estáticos enviados uma única vez e passam a ser artefatos gerados pela mesma camada de serviço que já é responsável pelos dados do catálogo de produtos.
A mudança prática é esta: a geração de imagens se torna uma função no código, não um compromisso na agenda. Seu registro de produto (título, atributos, cor, material, cenário de uso) vira entrada; a chamada ao modelo vira a transformação; a saída entra numa fila de revisão antes de ser publicada. Esse reposicionamento afeta várias decisões que importam para desenvolvedores:
- Onde a geração roda. Pode ficar atrás de um endpoint interno, dentro de um worker de fila ou como etapa de build de um novo SKU. Como a HiAPI expõe uma interface unificada, o formato da chamada não muda independentemente do ambiente para o qual você migre.
- O que permanece igual (determinismo). Modelos de prompt, validação de slots e verificações de saída são seu código. O modelo é responsável pela renderização; a consistência está sob seu controle.
- Como o catálogo escala. Novos SKUs não exigem mais sessão de fotos — basta um payload de prompt válido e uma barreira de validação aprovada.
Um modelo mental útil é o pipeline de quatro estágios: dados estruturados de produto entram na chamada ao modelo via HiAPI, o resultado entra na fila de revisão e os artefatos aprovados são promovidos para a vitrine da loja. Tudo neste guia se mapeia a um desses quatro estágios, e as seções seguintes detalham os prompts, a requisição e as salvaguardas ao redor.
Se você tratar gpt-6.1-terra como uma dependência de renderização e não como uma ferramenta criativa, o restante do trabalho de integração se torna engenharia comum: validação de schema, retentativas, processamento em lote e barreiras de revisão.
A estrutura de um prompt de imagem de produto
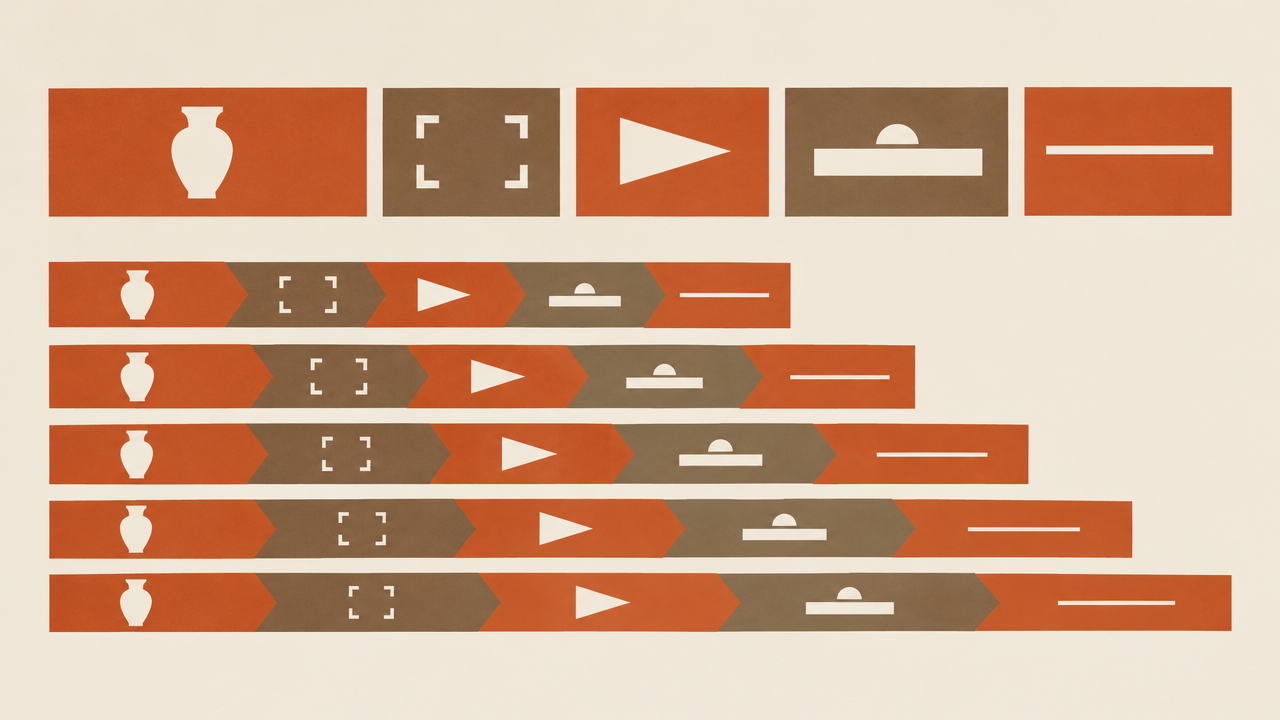
A diferença entre um prompt que pode ser reutilizado em milhares de SKUs e um prompt que só serve uma vez está na estrutura. Um prompt utilizável em catálogo de produtos é um conjunto de slots nomeados, preenchidos pela aplicação a partir dos dados de produto, e não texto livre digitado manualmente. Divida-o em cinco slots:
Sujeito
O que é o produto, descrito com substantivos simples e concretos. Extraia dos atributos do catálogo: categoria, material, cor, dimensões, características marcantes. Mantenha factual — o modelo renderiza o que você descreve, então omita informações que não estão no registro do produto.
Composição
Onde o produto está no enquadramento e que proporção da imagem ele ocupa. Valores típicos: centralizado, vista superior, ângulo de três quartos, quadro cheio. É aqui que a imagem principal e a imagem de produto se diferenciam.
Iluminação
O esquema de luz e a atmosfera. Luz suave de estúdio, luz direcional dura, luz natural através de janela. A iluminação é o slot que mais afeta a qualidade subjetiva, então defina um vocabulário pequeno e reutilize-o.
Fundo
O ambiente ao redor do produto — branco contínuo, gradiente cinza claro, contexto de cena nomeado. Para trabalho de catálogo, mantenha o fundo monótono e consistente; deixe a diversidade de cenas para as variantes de imagem de contexto.
Restrições
Regras que tornam a saída utilizável: sem sobreposição de texto, sem logos além dos fornecidos, sem adereços extras, produto ocupando o quadro central, sem reflexos que obstruam rótulos. As restrições são a chave para transformar uma imagem bonita em um artefato publicável.
Trate cada slot como um campo tipado no código. Sujeito e restrições vêm do registro de produto e de políticas fixas; composição, iluminação e fundo vêm de pequenos enums indexados por tipo de imagem. Combine-os numa ordem fixa — sujeito, composição, iluminação, fundo, restrições — para que o diff entre dois prompts reflita mudanças reais, e não ruído de redação. Quando um prompt reprovar na revisão, você pode ajustar um único slot sem reescrever tudo.
Modelos de prompt reutilizáveis
Os modelos abaixo seguem a estrutura de cinco slots. Cada modelo é um esqueleto com {placeholders}, preenchido pelo seu código a partir dos dados de produto. Mantenha-os sob controle de versão — modelos de prompt são configuração de produção, não strings descartáveis.
Imagem principal
Subject: {product_name}, {color}, {material}, {defining_feature}
Composition: centered, three-quarter angle, product occupies roughly 60% of frame
Lighting: soft studio lighting with a subtle key light from upper left
Background: light neutral gradient, no visible horizon
Constraints: no text, no logos, no extra props, label fully legible, no harsh shadows
Use para páginas de categoria e visuais principais de listagem. Aqui a consistência entre SKUs importa mais que a novidade.
Imagem de produto
Subject: {product_name}, {color}, {material}
Composition: straight-on, product centered and fully visible, even margins on all sides
Lighting: flat even studio lighting, minimal shadow
Background: pure seamless white
Constraints: no text, no logos, no props, no reflection artifacts, product edges crisp against background
A imagem de produto é o modelo com mais restrições. Não adicione atmosfera — mercados e grades de comparação preferem uniformidade.
Imagem de contexto
Subject: {product_name}, {color}, {material}
Composition: {placement}, product in natural use context, shallow depth of field
Lighting: {lighting_mood}, consistent with {scene_time_of_day}
Background: {scene_description}, complementary tones to product color
Constraints: product remains the focal point, no readable text, no brand logos other than supplied, no people faces in sharp focus
O modelo de contexto varia mais, então o alimente com uma pequena biblioteca de cenas em vez de escrever texto por SKU. Reutilize cenas entre produtos da mesma categoria para manter uma aparência consistente.
Nos três modelos, o bloco de restrições é inegociável. Ao adicionar um modelo, copie essas restrições literalmente e altere apenas os slots acima delas.
Uma requisição HiAPI executável para gpt-6.1-terra
Chamar gpt-6.1-terra via HiAPI segue o mesmo padrão de qualquer outra chamada de modelo na plataforma: envie uma requisição para um endpoint único, autentique com sua chave HiAPI e receba uma resposta normalizada. A sequência é cliente → gateway HiAPI → modelo, e o gateway cuida do roteamento e retorna o resultado ou um erro estruturado.
Configuração
Mantenha a chave e a base URL em variáveis de ambiente, nunca no código-fonte:
export HIAPI_API_KEY="your-key-here"
export HIAPI_BASE_URL="https://api.hiapi.ai"
Formato da requisição
A requisição carrega o identificador do modelo, o prompt composto pelo modelo e os parâmetros de geração exigidos pelo tipo de imagem. Uma requisição mínima em Node.js fica assim:
const res = await fetch(`${process.env.HIAPI_BASE_URL}/v1/generate`, {
  method: "POST",
  headers: {
    "Authorization": `Bearer ${process.env.HIAPI_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    model: "gpt-6.1-terra",
    prompt: composedPrompt,
    params: { aspect_ratio: "1:1" },
    metadata: { sku: product.sku, template: "packshot-v3" }
  })
});

if (!res.ok) {
  const err = await res.json();
  throw new Error(`HiAPI ${res.status}: ${err.message}`);
}

const data = await res.json();
Observações de integração
- Envie metadados. Anexar SKU e versão do modelo a cada requisição simplifica muito a depuração e a revisão a jusante, além de permitir associar saídas a registros do catálogo de produtos.
- Valide antes de enviar. Rejeite qualquer requisição com slot de modelo vazio ou sem o bloco de restrições. Isso intercepta a maioria das gerações ruins antes de você pagar por elas.
- Trate erros explicitamente. Diferencie erros de validação (seu payload está errado) de falhas transitórias (retentativa faz sentido). As seções seguintes cobrem estratégias de retentativa.
- Armazene a resposta, não apenas o artefato. Persista o payload da requisição junto com a imagem gerada, para que decisões de revisão possam ser rastreadas até o que foi realmente solicitado na época.
Os nomes específicos de parâmetros exigidos pelos modelos dependem do tipo de imagem — fixe esses parâmetros por versão de modelo, para que mudanças de modelo sejam reproduzíveis.
Processamento em lote, validação e revisão humana
Gerar uma imagem é uma demonstração; gerar um catálogo é um problema operacional. O fluxo viável é um gerador em lote alimentando validação automática, com uma barreira de revisão humana antes que qualquer coisa chegue à vitrine da loja.
Processamento em lote
Dirija lotes por uma fila com chave por SKU. Para cada SKU, renderize o prompt a partir do modelo correto, envie a requisição à HiAPI e grave o resultado num armazenamento de preparação com status pending_review. A concorrência deve ser limitada — um pool fixo de workers com backoff é mais fácil de raciocinar e reduz o raio de impacto de falhas do que paralelismo irrestrito.
Validação automática
Execute verificações baratas antes que humanos vejam a saída:
- Integridade da requisição. Todo slot preenchido, restrições presentes, versão do modelo registrada.
- Verificações básicas do artefato. Imagem decodificável, dimensões compatíveis com o slot de destino, proporção correta.
- Detecção de duplicatas. Faça hash das saídas para que imagens idênticas entre SKUs apareçam imediatamente — normalmente isso significa que há um problema no modelo.
- Verificações de política. Marque para revisão prioritária saídas que pareçam violar o bloco de restrições, como texto ou adereços inesperados.
Qualquer coisa que falhe na validação vai para o bucket failed_validation com o motivo. Não repita automaticamente falhas de validação — elas indicam problema de modelo ou de dados, não problema transitório.
Barreira de revisão humana
O revisor vê a imagem gerada, o registro de produto de origem, o prompt renderizado e a versão do modelo, e decide aprovar ou rejeitar. A aprovação promove o artefato para a vitrine da loja; a rejeição registra um motivo breve. Esses motivos são seu ciclo de feedback: um conjunto de rejeições para a mesma versão de modelo é um sinal para alterar aquele modelo, não para retentar com mais agressividade.
Comece com uma amostra pequena de SKUs, revise cada saída e só amplie a amostra depois que a taxa de rejeição estabilizar. A barreira de revisão é justamente o que permite escalar sem publicar erros.
Custo, latência e tratamento de falhas
Gerar custa dinheiro e tempo, então sistemas de produção precisam de estratégias explícitas para ambos. Como o preço é medido por requisição e parâmetros de geração, trate o custo como um orçamento alocado por SKU, não como um número calculado à mão — consulte as tarifas atuais no painel de preços da sua conta HiAPI e imponha limites no código.
Controle de custos
- Orçamento por lote. Atribua um número máximo de gerações a cada execução de lote e pare quando atingi-lo.
- Uma tentativa por versão de modelo. Uma requisição que falhou na validação não deve disparar retentativa com o mesmo prompt; ela deve voltar para o responsável pelo modelo.
- Cache agressivo. Se os slots de prompt e a versão do modelo de um SKU não mudaram, reutilize o artefato aprovado sem gerar novamente.
- Níveis de modelo. Use a configuração mais barata e suficiente para imagens de produto, e reserve ajustes mais pesados para imagens principais ou variantes de contexto, onde a qualidade é mais importante.
Latência
A geração não é instantânea, então projete para resultados assíncronos. Enfileire a requisição, devolva um identificador de tarefa ao chamador e deixe um worker gravar quando o resultado chegar. Os timeouts devem estar atrelados ao lease da fila, não à requisição HTTP voltada ao usuário.
Árvore de decisão para tratamento de falhas
Quando uma requisição falha, classifique antes de agir:
- Erro de validação (4xx). Corrija o payload. Não retente.
- Limite de taxa ou erro transitório de servidor (429/5xx). Retente com backoff exponencial e jitter, limitado a um pequeno número de tentativas. Se as tentativas se esgotarem, marque o SKU como
deferrede siga adiante. - Falha repetida no mesmo SKU. Se houver um artefato aprovado recente, volte para ele; caso contrário, encaminhe para revisão humana junto com o erro.
- Falha sistêmica em todo o lote. Interrompa o lote, exponha o erro e não continue drenando a fila — continuar só multiplica a falha.
Esse padrão é o mesmo de qualquer dependência externa: limite as retentativas, prefira fallbacks conhecidos como bons e torne as falhas visíveis para a equipe responsável pelo modelo.
Checklist antes de colocar o catálogo inteiro em produção
Antes de apontar gpt-6.1-terra para o catálogo inteiro, percorra esta lista item por item. Cada item corresponde a um modo de falha que só aparece em escala.
- Modelos versionados e armazenados no código. Cada prompt tem responsável e changelog; a string de versão é enviada em cada requisição.
- Validação de slots imposta no servidor. Sujeito vazio e bloco de restrições ausente são rejeitados antes que a requisição saia do seu serviço.
- Verificações automáticas rodam antes da revisão humana. Decodificação, dimensões, duplicatas e verificações de política são automatizadas e seus resultados armazenados.
- Barreira de revisão ativa e com pessoal designado. Rejeições registram motivos, e os agrupamentos de motivos são revisados semanalmente por versão de modelo.
- Estratégias de retentativa e fallback definidas. Erros de validação nunca são retentados; erros transitórios são retentados com backoff limitado; falhas repetidas usam fallback para o artefato aprovado mais recente.
- Proteções de custo implantadas. Limites de geração por lote, cache de saídas aprovadas e níveis de modelo configurados e testados.
- Metadados persistidos. SKU, versão do modelo e payload do prompt armazenados junto com cada artefato gerado.
- É possível reverter. Se a geração for desativada, a vitrine da loja ainda consegue servir imagens manuais, e a troca é apenas uma mudança de configuração.
- Lote piloto passou pela revisão. Comece por uma categoria, expanda para uma marca ou região e então faça o lançamento completo.
Execute o piloto, observe as taxas de rejeição e de falha de lote por alguns ciclos e só então remova o fluxo de trabalho manual. Quando você estiver pronto para passar do piloto à produção, o formato da requisição permanece o mesmo — apenas o volume muda.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores