
使用指南
gpt-6.2-sol 上手指南:能力边界、API 接入与 token 计价须知
面向工程团队的接入决策与实践要点

本页内容
gpt-6.2-sol 是什么,适合谁来用
gpt-6.2-sol 是 OpenAI 推出的文本模型,已上线 HiAPI.ai 统一接口。它是 GPT-6 系列的日常主力档,OpenAI 把它定位为从编码到大规模驱动 agent 都适用的常用模型。它的输出类型是纯文本,这是判断它是否适合你的第一道筛子,而不是把它当成「什么都能干」的通用黑盒。
它最舒服的场景是:知识问答与检索结果的整理归并、内容初稿与改写、结构化数据的抽取与归类、多轮对话中的语义判断、以及作为流程中的一环做文本决策(分诊、打标、摘要、意图识别)。这类任务的共同点是输入是文本、期望产出也是文本,模型可以被嵌进既有服务里当一个函数调用。
目标读者是工程团队:正在评估是否引入一个新文本模型,或准备把现有调用批量切到新模型上。如果你需要的是生成图像、音频,那不在它的边界内,应该在选型阶段就排除。
一个务实的判断标准:先把你要解决的任务写成一句话,问「这个任务的输入和输出都是文本吗」。如果答案是否,那这个模型最多只能承担流程中文本的那一段。
能力边界:文本输出的能与不能
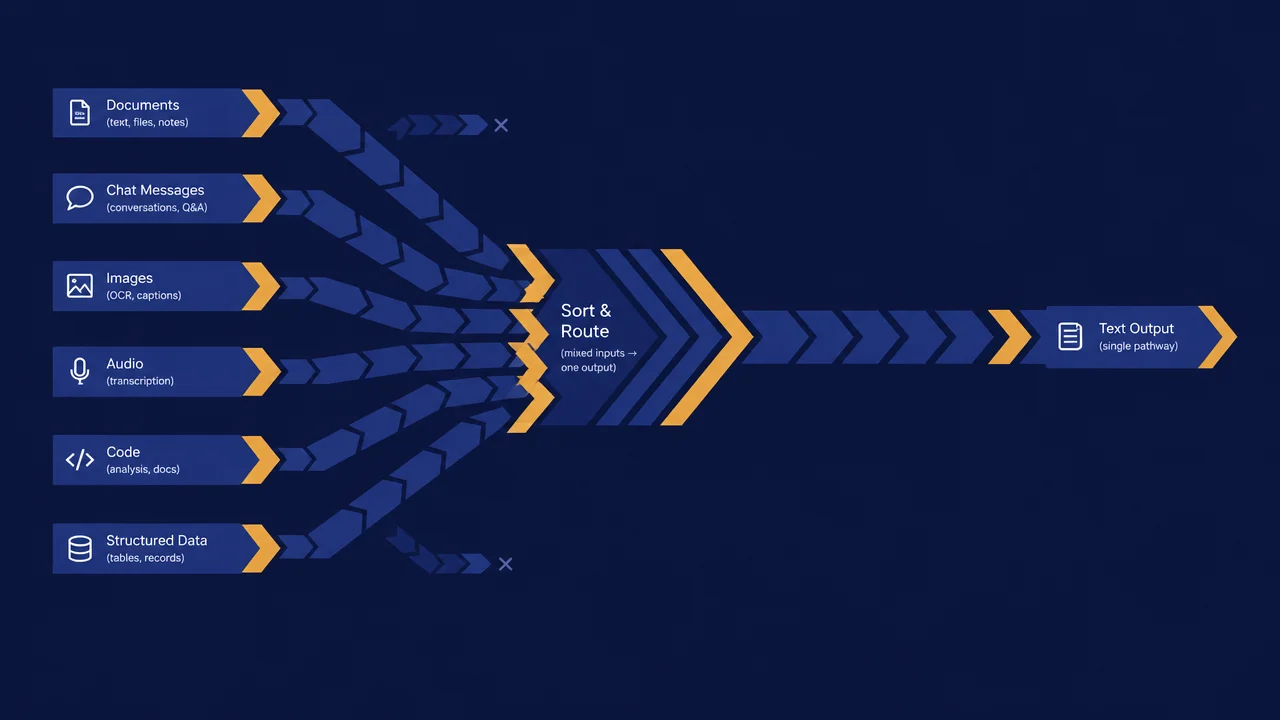
把 gpt-6.2-sol 看成一条文本进、文本出的管道。管道能做的事很清晰:给定文本上下文,产出文本结果。围绕这一点,可以直接承接的任务包括分类打标、摘要改写、信息抽取、问答生成、格式转换(例如从自由文本转成你约定的结构化文本)、以及多候选结果的排序解释。
需要额外环节补齐的部分也要提前认清:
- 需要严格结构化输出的:通过 Responses API 调用时,可以用
text.format传入 JSON Schema 并开启 strict,让返回直接按字段定义生成;走 Chat Completions 时没有这个选项,只能靠提示词约束。Chat Completions 下要靠提示词约束加服务端校验与重试,不能假设首次返回必然可解析。 - 需要时效性事实的:模型的输出不等于事实来源,涉及数据、时间、外部状态的内容应由你的检索层或数据库提供,再交给模型组织语言。
- 需要非文本产物的:图片、语音生成等不在它的输出类型内,必须另外接专门的环节。
- 需要确定性行为:同一个请求不保证逐字复现,涉及强一致逻辑的部分应放在代码里,而不是交给模型判断。
把边界写进设计文档,比事后在线上打补丁便宜得多。凡是超出文本能力的环节,都显式标注为「需要外部组件」,这样评审时就不会出现预期错位。
gpt-6.2-sol 关键参数与价格
以下是通过 HiAPI 调用 gpt-6.2-sol 时已经确定的信息,后文的接入和成本估算都以此为准。
- 定位:GPT-6 系列的日常主力档。OpenAI 把它定位为从编码到大规模驱动 agent 都适用的常用模型,相比 GPT-6.1 Sol 更聪明、更省 token。
- 上下文与输出:上下文窗口 1,050,000 token,单次输出最高 128,000 token。
- 知识截止:2026-06-01。
- 输出与能力:输出文本,支持流式输出和工具调用(
tools)。 - 调用方式:支持 Responses API(
https://api.hiapi.ai/v1/responses)和 Chat Completions(https://api.hiapi.ai/v1/chat/completions)。思考等级reasoning.effort(low / medium / high / xhigh / max,默认 medium)和 JSON 结构化输出text.format只在 Responses API 下可用。 - 价格:模型页当前标价(每百万 token)为输入 $0.500、缓存输入 $0.025、输出 $2.500、缓存写入(5 分钟)$0.625。计费以 gpt-6.2-sol 模型页 实时显示为准。
和 gpt-6.2-astra 怎么选
同系列的 gpt-6.2-astra 是旗舰档,面向最难、周期最长的项目,单价更高。建议大多数任务先用 Sol;遇到 Sol 处理不好的难题,比如复杂的跨模块重构或高要求的专业文档,再换 Astra。两者调用方式相同,切换只需改模型名。
接入前需要确认的接口信息
在 HiAPI.ai 上接入时,模型页 /models/gpt-6.2-sol 是信息入口。下列清单建议在写第一行调用代码前逐项核对,且以官方与平台文档为准,不要凭社区帖子或旧项目里的配置猜:
- 凭证与鉴权方式:密钥从哪来、放在哪里、如何在服务端安全注入,绝不下发到浏览器。
- 请求字段与必填项:模型标识、消息结构、生成长度上限等字段的准确命名与取值约束。
- 上下文与输出长度约束:gpt-6.2-sol 的上下文窗口为 1,050,000 token、单次输出最高 128,000 token,输出上限如何生效直接决定你的分块策略。
- 限流与配额口径:速率限制按什么维度计(请求数还是 token 量),触发后的响应形态是什么。
- 错误码语义:哪些错误值得重试、哪些是参数问题重试也没用,需要区分开。
- 计价口径:本模型按 token 计价,模型页分别标出输入、缓存输入、输出和缓存写入的单价。
把这些结论沉淀到团队内部的接入说明里,后续换人或换模型时可以直接复用这份核对表。任何一项还没确认的,先别写进生产分支。
API 调用与参数组织要点
调用侧的核心工作不是发一次请求,而是把请求组织成可复用、可观测、可退化的封装。先看一个最小示例:用 Responses API 拿结构化 JSON。用 OpenAI 官方 SDK 时,把 base_url 指向 HiAPI 即可:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="从工单中抽取字段,缺失的字段填 null。",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
已有 Chat Completions 客户端的,把模型名换成 gpt-6.2-sol 就能调用,但思考等级和 JSON 结构化输出在 Chat Completions 下不可用。接下来按下面的顺序落地:
请求结构
把消息分成系统约束与用户内容两层,系统层放角色、输出格式要求与禁止事项,用户层放业务数据。业务数据不要和指令混在一段里拼接,否则出问题时无法定位是数据问题还是指令问题。
输出契约
明确写清期望的输出形态(例如字段名、是否允许解释性文字)。即便写了,也要在服务端做一次解析校验:解析失败即视为一次失败调用,走重试或降级,而不是把半成品直接透传给前端。
异常与重试
重试只应该发生在可恢复的错误上,例如瞬时的网络失败或限流。参数非法、内容超长这类错误重试没有意义,应直接上报。重试要有次数上限与退避间隔,避免把一次故障放大成雪崩。
观测最小集
每次调用至少记录:耗时、输入与输出的 token 量、是否命中重试、最终是成功还是降级。这几项决定了后面能不能算清成本和定位问题。没有日志的接入,等于没有接入。
token 计价下的成本结构
gpt-6.2-sol 按 token 计价,这意味着单次成本不是一个固定值,而是随输入与输出量线性累积。工程上要建立的是成本模型,而不是记住某个数字:
- 输入侧:系统提示词、历史对话、检索到的上下文都会计入。多轮对话如果不做裁剪,输入会随轮次持续膨胀。
- 输出侧:生成越长,计费越多。要求模型长篇解释会让成本不可控地上升。
- 总成本:一次请求的成本由输入与输出共同构成,所以优化要两头看。
对应的控制手段:精简系统提示词并复用;历史对话做滑窗或摘要压缩;对长文档先切分再按需送入;给输出设置合理上限;对批量任务做去重与缓存,相同输入不必重复付费。
预算估算的正确做法是用真实样本跑一遍,统计平均输入与输出 token 量,再乘以调用量级,得到量级判断。当前标价见上文「关键参数与价格」,价格可能调整,计费以模型页实时显示为准。
用横向对比确定是否切换
选型不应该只凭一次评测或单一指标。更稳妥的方式是把 gpt-6.2-sol 和你当前的候选模型放进同一批真实业务样本里比较:
- 取样:从线上日志或标注数据里抽一批有代表性的请求,覆盖常见任务和长尾任务。
- 统一输入:同一份提示词、同一批数据,只改模型标识,排除提示词差异带来的干扰。
- 多维打分:不只看得分,还看格式合规率、失败率、平均 token 消耗与平均耗时。
- 人工抽检:机器指标看不出的表达质量与事实错误,需要人来看。
- 决策:明确切换的准入线,例如格式合规率与失败率达到什么水平才放行。
对比的目的不是证明新模型更好,而是回答「在当前任务上,切换带来的收益是否覆盖迁移与运维成本」。如果差距不显著,保持现状也是一种正确决策。同系列里,最难、周期最长的任务可以把 gpt-6.2-astra 也放进对比;大多数任务建议先用 Sol。
常见问题与排错路径
接入初期的高频问题,按下面的顺序排查通常最快:
- 超时:先看输入是否过长导致处理时间上升,再看是否为网络或服务端限流。降级方案要先于故障准备好。
- 输出被截断:检查生成长度上限是否设置过小,以及系统提示是否要求了过长的输出。截断往往不是模型的问题,而是参数的问题。
- 输出格式不符:确认提示词中的格式要求足够具体,并在服务端加了校验与重试;连续失败则考虑换更明确的示例约束。
- 鉴权失败:核对密钥是否注入正确、是否误把服务端密钥暴露到前端、是否存在环境变量缺失。
- 限流报错:确认限流维度与阈值,加入退避与队列,避免瞬时并发打满。
排错的基本纪律是:先定位是请求构造问题、还是服务端约束问题、还是业务代码解析问题,再动手改。不要靠调整参数碰运气。
上线后的监控与迭代
上线不是终点。把接入当作一条持续运转的链路,至少盯住这几类指标:调用量与成功率、格式合规率、平均输入与输出 token 量、平均耗时、降级与重试占比。它们分别对应容量、质量、成本与稳定性四个维度。
迭代节奏上,建议固定周期回看失败样本与用户反馈,把典型错误沉淀成新的评测用例,并据此调整提示词、分块策略与输出上限。当模型或平台配置发生变化时,用同一批评测样本回归一遍再决定是否放量。
一个可用的上线原则:先用小流量灰度验证真实效果,再逐步放大,任何时候都保留回退到旧模型的开关。想先看看模型详情与接入信息,可以从 /models/gpt-6.2-sol 开始。把能力边界、成本模型与监控三件事同时做扎实,gpt-6.2-sol 才能成为你系统里一个稳定可靠的文本环节。


