
使用指南
grok-4.7 上手指南:能力边界、API 接入要点与成本控制实践
面向开发者的接入决策与落地清单
grok-4.7 是什么,适合放在什么位置
grok-4.7 是由 xAI 提供的纯文本模型,输出类型为文本,计费方式为 token 计价。它不处理图像、音频等多模态输入,因此定位应放在文本生成类任务的候选池中,而不是作为多模态方案。
在典型应用架构里,它可以插在「业务逻辑」与「外部模型服务」之间:应用层把用户请求封装成消息,通过统一的 API 调用层发给模型,拿到文本结果后再交给后续的解析、存储或展示环节。这类模型适合承担对话补全、内容生成、摘要改写、结构化文本输出等职责。如果你的场景需要识别图片、转写语音或生成图像,grok-4.7 不是对应工具,应直接选用其他模型类型。
判断它是否该进入你的选型清单,可以先看三点:任务是否以文本为主、对输出格式是否有明确约束、以及团队是否已经有统一的模型调用层。前两点决定能力匹配度,第三点决定接入成本。如果现有代码里已经有一层模型适配接口,新增一个文本模型通常只是增加一个 provider 实现;如果所有调用都散落在业务代码中,建议先做封装再接入。
定位小结
- 提供方:xAI
- 输出形态:文本
- 计费口径:token 计价
- 合理位置:文本生成类任务的候选模型,置于统一调用层之后
- 不适用:需要多模态输入输出的场景
接入前必须确认的参数与限制
在写第一行业务代码之前,先把以下几类信息从官方文档或平台控制台核实清楚。公开资料没有固定下来的参数不要靠猜,缺失项要在设计上留出降级空间。
需要核实的清单
- 上下文长度:单次请求可容纳的最大 token 数,包括系统提示、对话历史与本次输入。它直接决定你能塞多少历史消息、多长的文档。
- 最大输出长度:单次响应允许生成的 token 上限,影响长文生成类任务是否要分段。
- 速率限制:每分钟请求数、每分钟 token 数或并发上限,决定是否需要客户端限流与排队。
- 计费口径:确认输入与输出 token 是否分别计价、是否有最小计费单位、失败请求是否计费。这些细节会影响成本模型的写法。
- 支持的参数:温度、top_p、停止序列、结构化输出等是否可用,以及取值范围。
- 错误码语义:限流、超时、内容拦截、参数错误分别返回什么状态,便于分类重试。
信息缺失时的设计策略
如果某项参数暂时无法确认,不要在代码里写死一个假设值。更稳妥的做法是把这些值收敛到配置层:上下文预算、输出上限、超时时间、重试次数都做成可调参数,并配一个保守的默认值。同时在调用层记录每次请求的输入长度与输出长度,等真实数据回来后再校准。
对于速率限制未知的情况,客户端先实现令牌桶或信号量限流,把并发压在一个保守水平,再根据错误率逐步放开。这样即使平台限制比预期更严,也只是触发重试而不是雪崩。
一次典型的 API 调用该怎么组织
调用组织的好坏,决定了后面排障和换模型时的成本。建议把一次调用拆成几个清晰的阶段:鉴权、请求构造、发送、响应解析、失败处理。
消息结构
文本模型通常采用消息数组的形式:系统提示放在最前面,用于设定角色与输出约束;用户消息承载本次输入;必要时追加历史消息。把系统提示与业务数据分开存放,不要拼接成一个大字符串,这样在换模型或调整提示词时更容易做 diff。
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": user_input},
]
超时与重试
为每次请求设置明确的超时,并区分两类失败:可重试的(网络抖动、限流、服务端 5xx)与不可重试的(参数错误、内容拦截)。可重试错误采用指数退避加随机抖动,并设置最大重试次数;不可重试错误直接上抛,交给业务层处理。
for attempt in range(MAX_RETRIES):
    try:
        return client.chat(messages, timeout=TIMEOUT)
    except RateLimitError:
        sleep(backoff(attempt))
    except RetryableError:
        sleep(backoff(attempt))
    except FatalError:
        raise
响应解析与错误码
拿到响应后先校验结构是否完整,再取文本内容。不要假设响应一定包含有效文本:可能为空、可能被截断、可能带有结束原因字段。把这些情况映射成业务可识别的状态,而不是让空字符串悄悄流进下游。
错误码处理建议集中在一处,用一张映射表把平台错误转成内部错误类型。这样未来接入其他模型时,业务层看到的始终是同一套错误语义。
token 计价下的成本结构与优化手段
token 计价意味着费用由输入 token 与输出 token 共同决定。理解这一点,才能判断成本到底花在哪里:长系统提示、冗长的对话历史、以及不加约束的输出长度,都会直接推高账单。
成本构成
一次请求的成本大致等于「输入 token 数 × 输入单价 + 输出 token 数 × 输出单价」。不同平台的输入输出比例不同,但工程上的抓手是一样的:减少不必要的输入,约束输出长度。
可落地的手段
- 提示词瘦身:系统提示只保留必要规则,去掉重复示例和客套话。示例能少则少,能用一个示例说清就不用三个。
- 历史裁剪:对话类场景只保留最近若干轮,或对早期消息做摘要压缩,而不是把全部历史原样带上。
- 输出长度约束:在提示中明确要求简洁回答,并设置 max_tokens 上限。结构化输出用固定字段,避免模型自由发挥。
- 缓存:对相同或高度相似的请求做结果缓存,尤其是离线批处理与固定模板类任务。
- 批处理:把多个独立小任务合并成一次请求,减少重复的系统提示开销;但要注意单次请求的上下文上限。
- 用量观测:在调用层记录每次请求的输入输出 token 数与耗时,按业务维度聚合。没有观测就没有优化。
一个常被忽略的点
重试也是成本。失败请求如果已经消耗了输入 token,重试会重复计费。因此限流与退避不仅影响稳定性,也影响账单。把重试次数控制在合理范围,并对限流错误做前置预防。
用统一调用层做多模型对比与灰度
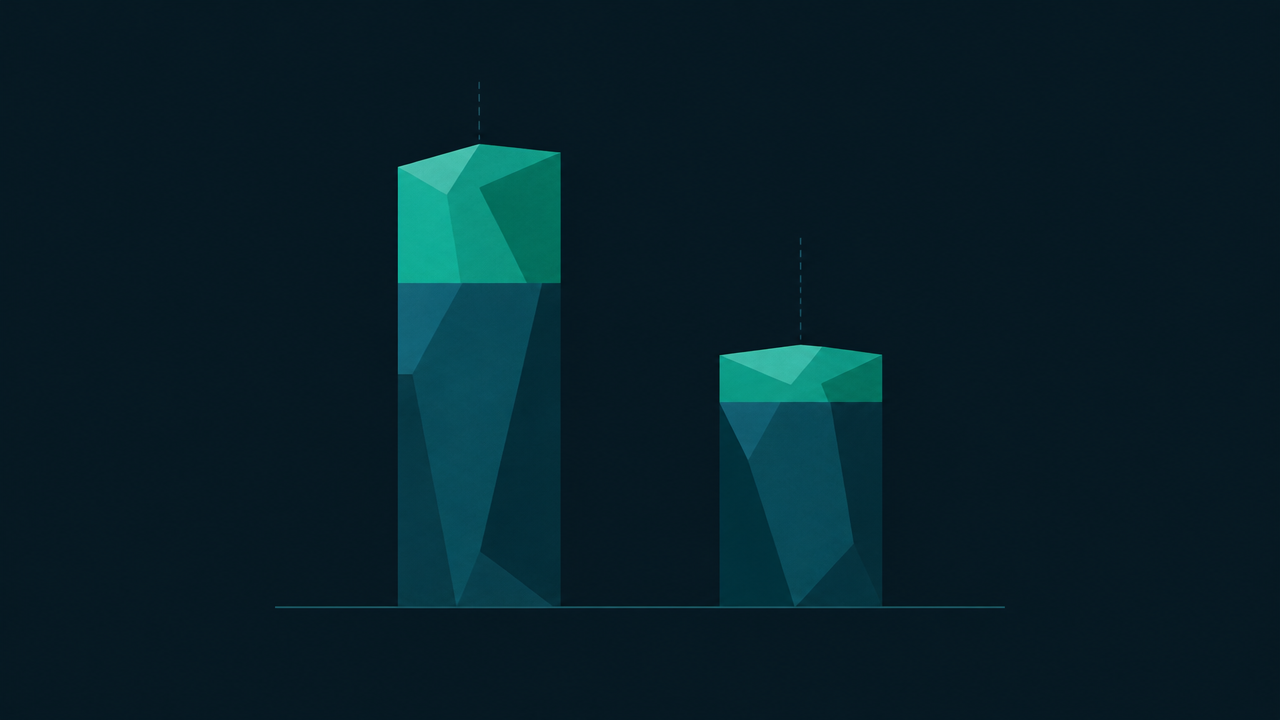
如果团队已经在用一个或多个模型,直接在各处散调 grok-4.7 会让后续对比和回退变得困难。更推荐的做法是抽象一层模型适配接口。
适配层设计
接口只暴露业务真正需要的操作,例如 generate(messages, options),返回统一的响应结构:文本内容、结束原因、用量统计、错误类型。每个模型对应一个实现,内部处理各自的消息格式与参数映射。业务代码只依赖接口,不依赖具体模型名。
class ModelAdapter:
    def generate(self, messages, options):
        raise NotImplementedError

class GrokAdapter(ModelAdapter):
    def generate(self, messages, options):
        # 映射到 grok-4.7 的调用方式
        ...
并行评测
有了统一接口,可以把同一批评测样本同时发给多个模型,比较输出质量、延迟与 token 用量。评测集应覆盖你的真实任务类型:短问答、长文档摘要、结构化抽取、边界输入。人工打分与自动指标结合,避免只看单次样例。
按比例灰度
上线阶段用流量比例控制:先给 grok-4.7 分配小比例流量,其余走原有模型,观察错误率、延迟分位数与业务指标。比例配置放在配置中心而不是代码里,出问题时能快速调到零,实现秒级回退。灰度期间保持两套模型的结果都记录,便于事后对比。
统一调用层的另一个好处是提示词可以共享。系统提示与输出约束写在一处,切换模型时只需要微调,而不是重写。
上线前的评测清单与常见坑
在把 grok-4.7 放进生产流量池之前,跑一遍可执行的自测清单,比看多少篇评测文章都有效。
评测清单
- 延迟:记录 P50 与 P99 延迟,确认在业务可接受范围内,并检查超时设置是否合理。
- 稳定性:连续压测一段时间,观察错误率与限流触发频率,验证退避策略是否生效。
- 长输入表现:用接近上下文上限的输入测试,确认输出没有被意外截断,且质量没有明显下降。
- 异常返回处理:构造空响应、超长响应、内容拦截等场景,验证业务层能正确降级而不是崩溃。
- 输出格式一致性:如果依赖结构化输出,统计解析失败率,必要时增加校验与重试。
- 成本抽样:抽取一批真实请求,统计输入输出 token 分布,估算单位业务量的成本。
常见坑
- 把系统提示当变量拼进用户消息:一旦换模型或调整提示,历史 diff 无法追溯,建议分开存放。
- 忽略结束原因:输出被长度上限截断时,模型可能返回不完整的结果,业务层却当成正常内容。
- 重试没有上限:限流时无限重试会放大负载,也会放大成本。
- 只测短输入:短对话表现好不代表长文档场景可用,评测集要覆盖长输入。
- 没有回退开关:灰度配置写死在代码里,出问题时只能发版回滚。
小流量先行
先用一个内部小流量评测集验证效果,再逐步放开。评测阶段记录每个样本的模型输出与用量,形成可复盘的基线,后续换模型时直接复用。
什么时候该选它,什么时候不该
把决策收敛成场景对照,比争论模型排名更有用。
适合的场景
- 以文本为主的生成任务:对话补全、内容起草、摘要改写。
- 需要结构化文本输出的抽取与转换类任务。
- 已有统一调用层,希望增加一个文本模型候选以做对比或分流。
- 对成本敏感、愿意在提示词与输出长度上做工程约束的团队。
不适合的场景
- 需要图像、音频等多模态输入输出的任务,grok-4.7 是纯文本模型,不在考虑范围。
- 对某个特定模型的独有能力有强依赖、短期无法迁移的系统。
- 团队还没有调用封装与用量观测,直接接入只会增加维护负担。
- 需求对延迟极其敏感,而评测结果显示延迟不达标。
建议的推进顺序
先确认能力匹配,再核实参数与限制,然后封装调用层,跑小流量评测,最后按比例灰度。每一步都有明确的检查点,任何一步不通过就停在原地,而不是硬推上线。
如果你的技术栈里已经有一层模型适配接口,接入 grok-4.7 的成本主要落在评测与观测上,而不是改造代码。从一个小流量评测集开始,用数据决定它是否值得进入生产流量池。


