
Benutzerhandbuch
grok-4.7 Einstiegsleitfaden: Fähigkeitsgrenzen, API-Anbindung und Kostenkontrolle in der Praxis
Integrationsentscheidungen und Umsetzungscheckliste für Entwickler
Was grok-4.7 ist und wo es sinnvoll eingesetzt wird
grok-4.7 ist ein reines Textmodell von xAI. Der Ausgabetyp ist Text, die Abrechnung erfolgt tokenbasiert. Es verarbeitet keine multimodalen Eingaben wie Bilder oder Audio. Seine Positionierung liegt daher im Kandidatenpool für Textgenerierungsaufgaben und nicht als multimodale Lösung.
In einer typischen Anwendungsarchitektur lässt es sich zwischen „Geschäftslogik“ und „externem Modelldienst“ einfügen: Die Anwendungsschicht verpackt Benutzeranfragen in Nachrichten, sendet sie über eine einheitliche API-Aufrufschicht an das Modell und übergibt das Text-Ergebnis anschließend an nachgelagerte Verarbeitungs-, Speicher- oder Anzeigeschritte. Solche Modelle eignen sich für Dialogvervollständigung, Inhaltsgenerierung, Zusammenfassung und Umschreibung, strukturierte Textausgabe und ähnliche Aufgaben. Wenn Ihr Szenario Bilder erkennen, Sprache transkribieren oder Bilder generieren muss, ist grok-4.7 nicht das passende Werkzeug – wählen Sie direkt einen anderen Modelltyp.
Ob es in Ihre Auswahlliste gehört, lässt sich an drei Punkten prüfen: ob die Aufgabe textbasiert ist, ob es klare Vorgaben zum Ausgabeformat gibt und ob das Team bereits über eine einheitliche Modellaufrufschicht verfügt. Die ersten beiden Punkte bestimmen die Fähigkeitspassung, der dritte die Integrationskosten. Wenn im bestehenden Code bereits eine Modelladapterschnittstelle existiert, bedeutet ein neues Textmodell meist nur eine weitere Provider-Implementierung; wenn alle Aufrufe über den Geschäftscode verstreut sind, sollte zuerst eine Kapselung erfolgen, bevor integriert wird.
Zusammenfassung der Positionierung
- Anbieter: xAI
- Ausgabeform: Text
- Abrechnungsgrundlage: tokenbasiert
- Sinnvolle Position: Kandidatenmodell für Textgenerierungsaufgaben, hinter einer einheitlichen Aufrufschicht
- Nicht geeignet: Szenarien, die multimodale Ein- und Ausgaben erfordern
Vor der Integration zu klärende Parameter und Einschränkungen
Bevor die erste Zeile Geschäftscode geschrieben wird, sollten die folgenden Informationen aus der offiziellen Dokumentation oder der Plattformkonsole verifiziert werden. Parameter, die in öffentlichen Materialien nicht feststehen, sollten nicht geraten werden; für fehlende Angaben ist im Design Raum für Degradierung vorzusehen.
Zu verifizierende Checkliste
- Kontextlänge: Die maximale Token-Anzahl pro Anfrage, einschließlich System-Prompt, Dialoghistorie und aktueller Eingabe. Sie bestimmt direkt, wie viele historische Nachrichten und wie lange Dokumente eingefügt werden können.
- Maximale Ausgabelänge: Die Obergrenze der pro Antwort generierbaren Token, die beeinflusst, ob Aufgaben zur Langtextgenerierung aufgeteilt werden müssen.
- Ratenbegrenzung: Anfragen pro Minute, Token pro Minute oder Parallelitätsobergrenze; sie bestimmt, ob clientseitige Drosselung und Warteschlangen erforderlich sind.
- Abrechnungsgrundlage: Ob Eingabe- und Ausgabe-Token getrennt abgerechnet werden, ob es eine minimale Abrechnungseinheit gibt und ob fehlgeschlagene Anfragen berechnet werden. Diese Details beeinflussen die Formulierung des Kostenmodells.
- Unterstützte Parameter: Ob Temperatur, top_p, Stoppsequenzen, strukturierte Ausgabe usw. verfügbar sind und welche Wertebereiche gelten.
- Bedeutung der Fehlercodes: Welche Status bei Ratenbegrenzung, Timeout, Inhaltsfilterung und Parameterfehlern zurückgegeben werden, um Wiederholungen zu klassifizieren.
Designstrategie bei fehlenden Informationen
Wenn ein Parameter vorübergehend nicht bestätigt werden kann, sollte im Code kein angenommener Wert fest verdrahtet werden. Robuster ist es, diese Werte in die Konfigurationsschicht zu verlagern: Kontextbudget, Ausgabeobergrenze, Timeout und Wiederholungsanzahl als anpassbare Parameter mit konservativen Standardwerten. Gleichzeitig sollte die Aufrufschicht die Eingabe- und Ausgabelänge jeder Anfrage protokollieren, um nach Erhalt echter Daten zu kalibrieren.
Bei unbekannter Ratenbegrenzung sollte der Client zunächst Token-Bucket- oder Semaphor-Drosselung implementieren, die Parallelität auf einem konservativen Niveau halten und sie dann je nach Fehlerrate schrittweise erhöhen. So führt selbst eine strengere Plattformbegrenzung als erwartet lediglich zu Wiederholungen statt zu einem Lawinenausfall.
Wie ein typischer API-Aufruf organisiert werden sollte
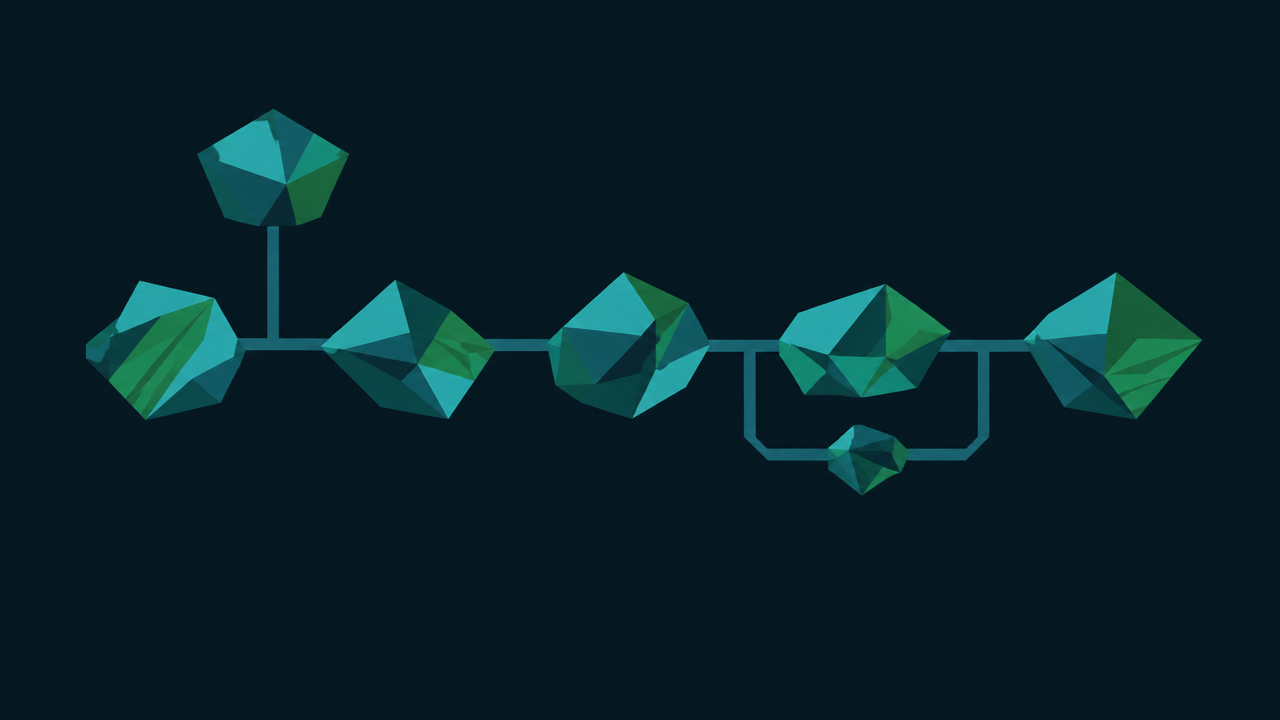
Die Qualität der Aufruforganisation bestimmt die späteren Kosten für Fehlerbehebung und Modellwechsel. Es empfiehlt sich, einen Aufruf in klare Phasen zu unterteilen: Authentifizierung, Anforderungserstellung, Senden, Antwortanalyse, Fehlerbehandlung.
Nachrichtenstruktur
Textmodelle verwenden üblicherweise ein Nachrichtenarray: Der System-Prompt steht am Anfang und legt Rolle und Ausgabebeschränkungen fest; die Benutzernachricht trägt die aktuelle Eingabe; bei Bedarf werden historische Nachrichten angehängt. System-Prompt und Geschäftsdaten sollten getrennt gespeichert und nicht zu einem großen String zusammengefügt werden, damit bei Modellwechsel oder Prompt-Anpassung einfacher ein Diff möglich ist.
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": user_input},
]
Timeout und Wiederholung
Für jede Anfrage einen eindeutigen Timeout festlegen und zwei Fehlerarten unterscheiden: wiederholbare (Netzwerkschwankungen, Ratenbegrenzung, Server-5xx) und nicht wiederholbare (Parameterfehler, Inhaltsfilterung). Bei wiederholbaren Fehlern exponentielles Backoff mit zufälligem Jitter und eine maximale Wiederholungsanzahl verwenden; nicht wiederholbare Fehler direkt weitergeben, damit die Geschäftsschicht sie behandelt.
for attempt in range(MAX_RETRIES):
    try:
        return client.chat(messages, timeout=TIMEOUT)
    except RateLimitError:
        sleep(backoff(attempt))
    except RetryableError:
        sleep(backoff(attempt))
    except FatalError:
        raise
Antwortanalyse und Fehlercodes
Nach Erhalt der Antwort zuerst prüfen, ob die Struktur vollständig ist, dann den Textinhalt entnehmen. Nicht davon ausgehen, dass die Antwort immer gültigen Text enthält: Sie kann leer sein, abgeschnitten oder ein Feld für den Beendigungsgrund enthalten. Diese Fälle in geschäftlich erkennbare Zustände abbilden, statt leere Strings unbemerkt in die nachgelagerten Systeme fließen zu lassen.
Die Fehlercode-Behandlung sollte zentral erfolgen, mit einer Zuordnungstabelle, die Plattformfehler in interne Fehlertypen übersetzt. So sieht die Geschäftsschicht bei der künftigen Integration anderer Modelle stets dieselbe Fehlersemantik.
Kostenstruktur und Optimierungsmaßnahmen bei tokenbasierter Abrechnung
Tokenbasierte Abrechnung bedeutet, dass die Kosten durch Eingabe- und Ausgabe-Token gemeinsam bestimmt werden. Nur wenn dies verstanden ist, lässt sich beurteilen, wo die Kosten tatsächlich entstehen: lange System-Prompts, ausführliche Dialoghistorien und ungebremste Ausgabelängen treiben die Rechnung direkt in die Höhe.
Kostenbestandteile
Die Kosten einer Anfrage entsprechen ungefähr „Anzahl Eingabe-Token × Eingabepreis + Anzahl Ausgabe-Token × Ausgabepreis“. Die Anteile von Eingabe und Ausgabe unterscheiden sich je nach Plattform, aber die technischen Ansatzpunkte sind dieselben: unnötige Eingaben reduzieren, Ausgabelänge begrenzen.
Praktisch umsetzbare Maßnahmen
- Prompt-Verschlankung: Im System-Prompt nur notwendige Regeln behalten, doppelte Beispiele und Höflichkeitsfloskeln entfernen. Beispiele so knapp wie möglich; wenn ein Beispiel genügt, nicht drei verwenden.
- Historienkürzung: In Dialogszenarien nur die letzten N Runden behalten oder frühe Nachrichten zusammenfassen und komprimieren, statt die gesamte Historie unverändert mitzusenden.
- Begrenzung der Ausgabelänge: Im Prompt explizit eine prägnante Antwort verlangen und ein max_tokens-Limit setzen. Strukturierte Ausgabe mit festen Feldern, um freie Formulierungen des Modells zu vermeiden.
- Caching: Ergebnisse für identische oder sehr ähnliche Anfragen zwischenspeichern, insbesondere bei Offline-Stapelverarbeitung und Aufgaben mit festen Vorlagen.
- Stapelverarbeitung: Mehrere unabhängige kleine Aufgaben zu einer Anfrage zusammenfassen, um wiederholten System-Prompt-Overhead zu reduzieren; dabei die Kontextobergrenze einer einzelnen Anfrage beachten.
- Nutzungsbeobachtung: In der Aufrufschicht die Eingabe- und Ausgabe-Token sowie die Dauer jeder Anfrage protokollieren und nach Geschäftsdimensionen aggregieren. Ohne Beobachtung gibt es keine Optimierung.
Ein häufig übersehener Punkt
Auch Wiederholungen verursachen Kosten. Wenn fehlgeschlagene Anfragen bereits Eingabe-Token verbraucht haben, werden bei der Wiederholung erneut Kosten berechnet. Drosselung und Backoff beeinflussen daher nicht nur die Stabilität, sondern auch die Rechnung. Die Wiederholungsanzahl in einem sinnvollen Bereich halten und Ratenbegrenzungsfehler vorbeugend vermeiden.
Multi-Modell-Vergleich und Canary-Rollout mit einer einheitlichen Aufrufschicht
Wenn das Team bereits ein oder mehrere Modelle verwendet, führt der direkte verstreute Aufruf von grok-4.7 dazu, dass späterer Vergleich und Rückfall schwierig werden. Besser ist die Abstraktion einer Modelladapterschnittstelle.
Design der Adapterschicht
Die Schnittstelle sollte nur die vom Geschäft tatsächlich benötigten Operationen bereitstellen, z. B. generate(messages, options), mit einer einheitlichen Antwortstruktur: Textinhalt, Beendigungsgrund, Nutzungsstatistik, Fehlertyp. Jedes Modell erhält eine Implementierung, die intern das jeweilige Nachrichtenformat und die Parametenzuordnung behandelt. Der Geschäftscode hängt nur von der Schnittstelle ab, nicht von konkreten Modellnamen.
class ModelAdapter:
    def generate(self, messages, options):
        raise NotImplementedError

class GrokAdapter(ModelAdapter):
    def generate(self, messages, options):
        # Mapping auf die Aufrufweise von grok-4.7
        ...
Parallele Evaluierung
Mit einer einheitlichen Schnittstelle kann derselbe Satz von Evaluierungsproben gleichzeitig an mehrere Modelle gesendet werden, um Ausgabequalität, Latenz und Token-Verbrauch zu vergleichen. Das Evaluierungsset sollte die realen Aufgabentypen abdecken: kurze Frage-Antwort, Zusammenfassung langer Dokumente, strukturierte Extraktion, Grenzfälle. Manuelle Bewertung mit automatischen Metriken kombinieren, um nicht nur einzelne Beispiele zu betrachten.
Proportionaler Canary-Rollout
In der Einführungsphase über den Traffic-Anteil steuern: grok-4.7 zunächst einen kleinen Teil des Traffics zuweisen, der Rest läuft über das bisherige Modell; dabei Fehlerrate, Latenz-Perzentile und Geschäftsmetriken beobachten. Die Konfiguration des Anteils gehört ins Konfigurationszentrum und nicht in den Code, damit bei Problemen schnell auf null gestellt und ein sekundenschneller Rückfall ermöglicht wird. Während des Canary-Rollouts die Ergebnisse beider Modelle protokollieren, um später vergleichen zu können.
Ein weiterer Vorteil der einheitlichen Aufrufschicht ist die gemeinsame Nutzung von Prompts. System-Prompt und Ausgabebeschränkungen stehen an einer Stelle; bei einem Modellwechsel sind nur Feinjustierungen nötig, kein Neuschreiben.
Evaluierungscheckliste vor dem Go-live und häufige Fallstricke
Bevor grok-4.7 in den Produktions-Traffic-Pool aufgenommen wird, ist das Durchlaufen einer umsetzbaren Selbsttest-Checkliste wirksamer als das Lesen zahlreicher Testberichte.
Evaluierungscheckliste
- Latenz: P50- und P99-Latenz protokollieren, sicherstellen, dass sie im geschäftlich akzeptablen Bereich liegt, und die Timeout-Einstellungen prüfen.
- Stabilität: Über einen längeren Zeitraum kontinuierlich Lasttest durchführen, Fehlerrate und Häufigkeit der Ratenbegrenzung beobachten und prüfen, ob die Backoff-Strategie greift.
- Verhalten bei langen Eingaben: Mit Eingaben nahe der Kontextobergrenze testen, um sicherzustellen, dass die Ausgabe nicht unerwartet abgeschnitten wird und die Qualität nicht merkbar nachlässt.
- Behandlung abnormaler Rückgaben: Szenarien wie leere Antworten, überlange Antworten und Inhaltsfilterung konstruieren, um zu prüfen, ob die Geschäftsschicht korrekt degradiert statt abzustürzen.
- Konsistenz des Ausgabeformats: Wenn strukturierte Ausgaben vorausgesetzt werden, die Parse-Fehlerrate erfassen und bei Bedarf Validierung und Wiederholung ergänzen.
- Kostenstichprobe: Eine Reihe realer Anfragen entnehmen, die Verteilung der Eingabe- und Ausgabe-Token erfassen und die Kosten pro Geschäftsvolumeneinheit schätzen.
Häufige Fallstricke
- System-Prompt als Variable in die Benutzernachricht einfügen: Bei einem Modellwechsel oder einer Prompt-Anpassung ist der historische Diff nicht mehr nachvollziehbar; getrennte Speicherung empfiehlt sich.
- Beendigungsgrund ignorieren: Wenn die Ausgabe durch die Längenobergrenze abgeschnitten wird, kann das Modell ein unvollständiges Ergebnis zurückgeben, das die Geschäftsschicht jedoch als normalen Inhalt behandelt.
- Wiederholung ohne Obergrenze: Bei Ratenbegrenzung verstärkt endloses Wiederholen die Last und erhöht auch die Kosten.
- Nur kurze Eingaben testen: Gute Leistung bei kurzen Dialogen bedeutet nicht, dass das Langdokument-Szenario nutzbar ist; das Evaluierungsset muss lange Eingaben abdecken.
- Kein Rückfallschalter: Canary-Konfiguration im Code fest verdrahtet; bei Problemen bleibt nur ein Release-Rollback.
Kleiner Traffic zuerst
Zunächst mit einem internen Evaluierungsset mit kleinem Traffic die Wirkung überprüfen und dann schrittweise erweitern. In der Evaluierungsphase die Modellausgabe und den Verbrauch jeder Probe protokollieren, um eine reproduzierbare Baseline zu schaffen, die bei künftigen Modellwechseln direkt wiederverwendet werden kann.
Wann man es wählen sollte und wann nicht
Die Entscheidung in eine Szenario-Gegenüberstellung zu fassen ist nützlicher, als über Modellrankings zu streiten.
Geeignete Szenarien
- Textbasierte Generierungsaufgaben: Dialogvervollständigung, Inhaltsentwurf, Zusammenfassung und Umschreibung.
- Extraktions- und Konvertierungsaufgaben, die strukturierte Textausgabe erfordern.
- Eine einheitliche Aufrufschicht ist vorhanden, und ein zusätzliches Textmodell als Kandidat für Vergleich oder Lastverteilung wird gewünscht.
- Kostensensible Teams, die bereit sind, bei Prompt und Ausgabelänge technische Beschränkungen umzusetzen.
Ungeeignete Szenarien
- Aufgaben, die multimodale Ein- und Ausgaben wie Bilder oder Audio erfordern – grok-4.7 ist ein reines Textmodell und kommt nicht in Betracht.
- Systeme mit starker Abhängigkeit von einzigartigen Fähigkeiten eines bestimmten Modells, die kurzfristig nicht migriert werden können.
- Teams ohne Aufrufkapselung und Nutzungsbeobachtung; eine direkte Integration erhöht nur den Wartungsaufwand.
- Anforderungen mit extrem hoher Latenzempfindlichkeit, bei denen die Evaluierungsergebnisse die Latenz als unzureichend ausweisen.
Empfohlene Vorgehensreihenfolge
Zuerst die Fähigkeitspassung bestätigen, dann Parameter und Einschränkungen verifizieren, anschließend die Aufrufschicht kapseln, eine Evaluierung mit kleinem Traffic durchführen und schließlich proportional als Canary ausrollen. Jeder Schritt hat einen klaren Prüfpunkt; wenn ein Schritt nicht bestanden wird, bleibt man an dieser Stelle stehen, statt die Einführung mit Gewalt voranzutreiben.
Wenn in Ihrem Technologie-Stack bereits eine Modelladapterschnittstelle existiert, entfallen die Integrationskosten für grok-4.7 hauptsächlich auf Evaluierung und Beobachtung statt auf Code-Umbau. Beginnen Sie mit einem Evaluierungsset mit kleinem Traffic und entscheiden Sie anhand der Daten, ob es den Weg in den Produktions-Traffic-Pool verdient.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte