
Guia de uso
Guia de introdução ao grok-4.7: limites de capacidade, pontos essenciais de integração via API e práticas de controle de custos
Decisões de integração e checklist de implementação para desenvolvedores
O que é o grok-4.7 e onde ele se encaixa
O grok-4.7 é um modelo puramente textual fornecido pela xAI, com saída do tipo texto e cobrança por token. Ele não processa entradas multimodais como imagens ou áudio, portanto deve ser posicionado no conjunto de candidatos para tarefas de geração de texto, e não como uma solução multimodal.
Em uma arquitetura de aplicação típica, ele pode ser inserido entre a «lógica de negócio» e o «serviço de modelo externo»: a camada de aplicação empacota a requisição do usuário em mensagens, envia ao modelo através de uma camada unificada de chamadas de API e, após receber o resultado textual, o encaminha para as etapas seguintes de parsing, armazenamento ou exibição. Esse tipo de modelo é adequado para assumir responsabilidades como completude de diálogo, geração de conteúdo, resumo e reescrita, e saída de texto estruturado. Se o seu cenário exige reconhecimento de imagens, transcrição de fala ou geração de imagens, o grok-4.7 não é a ferramenta adequada e você deve optar diretamente por outro tipo de modelo.
Para decidir se ele deve entrar na sua lista de seleção, comece observando três pontos: se a tarefa é predominantemente textual, se há restrições claras sobre o formato de saída e se a equipe já possui uma camada unificada de chamadas de modelo. Os dois primeiros pontos determinam a adequação de capacidade; o terceiro determina o custo de integração. Se o código existente já possui uma camada de interface de adaptação de modelos, adicionar um modelo textual geralmente significa apenas incluir uma implementação de provider; se todas as chamadas estão dispersas pelo código de negócio, recomenda-se primeiro fazer o encapsulamento e depois integrar.
Resumo de posicionamento
- Fornecedor: xAI
- Formato de saída: texto
- Critério de cobrança: cobrança por token
- Posição razoável: modelo candidato para tarefas de geração de texto, posicionado após a camada unificada de chamadas
- Não aplicável: cenários que exigem entrada e saída multimodais
Parâmetros e limites que devem ser confirmados antes da integração
Antes de escrever a primeira linha de código de negócio, verifique com clareza nos documentos oficiais ou no console da plataforma as seguintes categorias de informação. Não adivinhe parâmetros que não estão fixados em materiais públicos; para itens ausentes, deixe espaço para degradação no design.
Checklist a verificar
- Comprimento de contexto: número máximo de tokens que uma única requisição pode conter, incluindo prompt de sistema, histórico de conversa e entrada atual. Isso determina diretamente quantas mensagens históricas e qual o tamanho de documento você pode incluir.
- Comprimento máximo de saída: limite de tokens que uma única resposta pode gerar, afetando se tarefas de geração de textos longos precisam ser segmentadas.
- Limites de taxa: requisições por minuto, tokens por minuto ou limite de concorrência, determinando a necessidade de limitação de taxa e filas no cliente.
- Critério de cobrança: confirme se tokens de entrada e saída são cobrados separadamente, se há unidade mínima de cobrança e se requisições com falha são cobradas. Esses detalhes afetam a forma de escrever o modelo de custos.
- Parâmetros suportados: disponibilidade de temperature, top_p, sequências de parada, saída estruturada, etc., e seus intervalos de valores.
- Semântica de códigos de erro: quais status são retornados para limitação de taxa, timeout, bloqueio de conteúdo e erro de parâmetro, facilitando a classificação para retentativas.
Estratégia de design quando faltam informações
Se algum parâmetro não puder ser confirmado temporariamente, não fixe um valor suposto no código. A abordagem mais segura é concentrar esses valores na camada de configuração: orçamento de contexto, limite de saída, timeout e número de retentativas devem ser parâmetros ajustáveis, com valores padrão conservadores. Ao mesmo tempo, registre na camada de chamadas o comprimento de entrada e saída de cada requisição e calibre quando os dados reais chegarem.
Para casos em que o limite de taxa é desconhecido, implemente primeiro no cliente limitação por token bucket ou semáforo, mantendo a concorrência em um nível conservador e liberando gradualmente conforme a taxa de erro. Assim, mesmo que o limite da plataforma seja mais restritivo que o esperado, isso apenas acionará retentativas em vez de uma avalanche.
Como organizar uma chamada típica de API
A qualidade da organização das chamadas determina o custo futuro de solução de problemas e troca de modelos. Recomenda-se dividir uma chamada em etapas claras: autenticação, construção da requisição, envio, parsing da resposta e tratamento de falhas.
Estrutura de mensagens
Modelos textuais geralmente adotam o formato de array de mensagens: o prompt de sistema fica no início, definindo papel e restrições de saída; a mensagem do usuário carrega a entrada atual; mensagens históricas são anexadas quando necessário. Armazene o prompt de sistema e os dados de negócio separadamente, sem concatená-los em uma grande string, pois isso facilita o diff ao trocar de modelo ou ajustar prompts.
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": user_input},
]
Timeout e retentativas
Defina um timeout explícito para cada requisição e distinga dois tipos de falha: retentáveis (oscilação de rede, limitação de taxa, 5xx do servidor) e não retentáveis (erro de parâmetro, bloqueio de conteúdo). Erros retentáveis usam backoff exponencial com jitter aleatório e um número máximo de retentativas; erros não retentáveis são propagados diretamente para tratamento na camada de negócio.
for attempt in range(MAX_RETRIES):
    try:
        return client.chat(messages, timeout=TIMEOUT)
    except RateLimitError:
        sleep(backoff(attempt))
    except RetryableError:
        sleep(backoff(attempt))
    except FatalError:
        raise
Parsing de resposta e códigos de erro
Após receber a resposta, valide primeiro se a estrutura está completa e depois extraia o conteúdo textual. Não presuma que a resposta sempre contenha texto válido: ela pode estar vazia, truncada ou trazer um campo de motivo de encerramento. Mapeie esses casos para estados reconhecíveis pelo negócio, em vez de deixar uma string vazia fluir silenciosamente para o downstream.
Recomenda-se centralizar o tratamento de códigos de erro em um único local, usando uma tabela de mapeamento que converta erros da plataforma em tipos internos de erro. Assim, ao integrar outros modelos no futuro, a camada de negócio continuará vendo o mesmo conjunto de semânticas de erro.
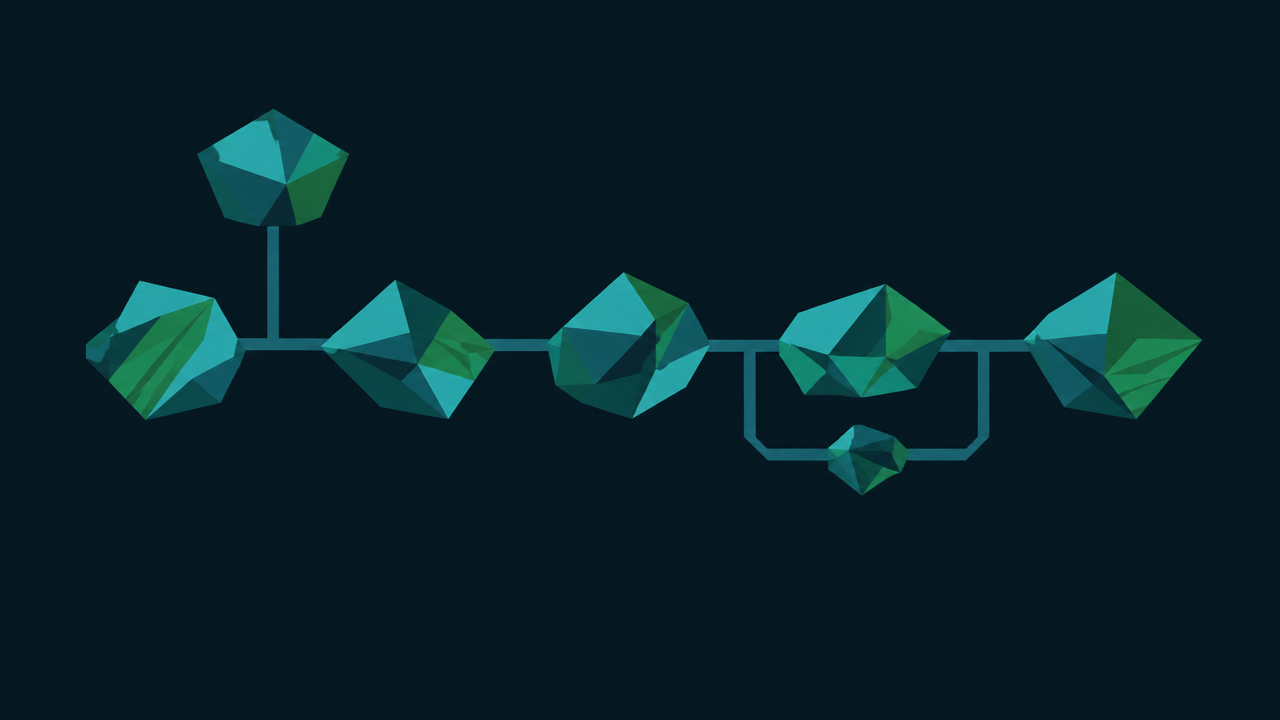
Estrutura de custos e técnicas de otimização sob cobrança por token
A cobrança por token significa que o custo é determinado conjuntamente pelos tokens de entrada e de saída. Entender isso permite identificar onde o custo realmente é gasto: prompts de sistema longos, históricos de conversa prolixos e comprimentos de saída sem restrição elevam diretamente a fatura.
Composição do custo
O custo de uma requisição é aproximadamente «número de tokens de entrada × preço unitário de entrada + número de tokens de saída × preço unitário de saída». A proporção entre entrada e saída varia por plataforma, mas as alavancas de engenharia são as mesmas: reduzir entradas desnecessárias e restringir o comprimento da saída.
Medidas aplicáveis
- Enxugamento de prompts: mantenha no prompt de sistema apenas as regras necessárias e remova exemplos repetidos e cortesias. Use o mínimo de exemplos possível; se um exemplo basta, não use três.
- Corte de histórico: em cenários de conversa, mantenha apenas as últimas rodadas ou faça resumo compressivo de mensagens antigas, em vez de carregar todo o histórico integralmente.
- Restrição de comprimento de saída: exija explicitamente respostas concisas no prompt e defina um limite de max_tokens. Para saída estruturada, use campos fixos para evitar que o modelo divague.
- Cache: faça cache de resultados para requisições iguais ou altamente similares, especialmente em processamento em lote offline e tarefas com templates fixos.
- Processamento em lote: combine várias pequenas tarefas independentes em uma única requisição para reduzir a sobrecarga repetitiva do prompt de sistema; mas atenção ao limite de contexto por requisição.
- Observação de uso: registre na camada de chamadas o número de tokens de entrada e saída e o tempo de cada requisição, agregando por dimensão de negócio. Sem observação não há otimização.
Um ponto frequentemente ignorado
Retentativas também são custo. Se uma requisição com falha já consumiu tokens de entrada, a retentativa gerará cobrança duplicada. Portanto, limitação de taxa e backoff não afetam apenas a estabilidade, mas também a fatura. Mantenha o número de retentativas em uma faixa razoável e faça prevenção prévia de erros de limitação de taxa.
Usar uma camada unificada de chamadas para comparação multi-modelo e implantação gradual
Se a equipe já usa um ou mais modelos, chamar o grok-4.7 diretamente em vários pontos tornará comparações e reversões futuras difíceis. A abordagem mais recomendada é abstrair uma camada de interface de adaptação de modelos.
Design da camada de adaptação
A interface expõe apenas as operações realmente necessárias ao negócio, como generate(messages, options), retornando uma estrutura de resposta unificada: conteúdo textual, motivo de encerramento, estatísticas de uso e tipo de erro. Cada modelo corresponde a uma implementação, tratando internamente seus próprios formatos de mensagem e mapeamentos de parâmetros. O código de negócio depende apenas da interface, não de nomes específicos de modelos.
class ModelAdapter:
    def generate(self, messages, options):
        raise NotImplementedError

class GrokAdapter(ModelAdapter):
    def generate(self, messages, options):
        # 映射到 grok-4.7 的调用方式
        ...
Avaliação paralela
Com a interface unificada, é possível enviar o mesmo lote de amostras de avaliação para vários modelos simultaneamente, comparando qualidade de saída, latência e uso de tokens. O conjunto de avaliação deve cobrir seus tipos reais de tarefa: perguntas e respostas curtas, resumo de documentos longos, extração estruturada e entradas de borda. Combine pontuação humana com métricas automáticas para evitar olhar apenas para amostras isoladas.
Implantação gradual por proporção
Na fase de lançamento, use controle por proporção de tráfego: primeiro direcione uma pequena porcentagem de tráfego para o grok-4.7 e o restante para os modelos existentes, observando taxa de erro, percentis de latência e métricas de negócio. A configuração de proporção deve ficar no centro de configuração e não no código, permitindo ajustar rapidamente para zero em caso de problema e obter reversão em segundos. Durante a implantação gradual, mantenha os resultados dos dois conjuntos de modelos registrados para comparação posterior.
Outra vantagem da camada unificada de chamadas é o compartilhamento de prompts. O prompt de sistema e as restrições de saída ficam em um único local, bastando ajustes finos ao trocar de modelo, em vez de reescrever.
Checklist de avaliação antes do lançamento e armadilhas comuns
Antes de colocar o grok-4.7 no pool de tráfego de produção, executar uma lista de autotestes executáveis é mais eficaz do que ler dezenas de artigos de avaliação.
Checklist de avaliação
- Latência: registre latência P50 e P99, confirme se está dentro do aceitável para o negócio e verifique se as configurações de timeout são razoáveis.
- Estabilidade: execute testes de carga contínuos por um período, observe taxa de erro e frequência de acionamento de limitação de taxa, validando se a estratégia de backoff está funcionando.
- Desempenho com entradas longas: teste com entradas próximas ao limite de contexto, confirmando que a saída não foi truncada inesperadamente e que a qualidade não caiu significativamente.
- Tratamento de retornos anômalos: construa cenários como resposta vazia, resposta excessivamente longa e bloqueio de conteúdo, validando que a camada de negócio degrada corretamente em vez de quebrar.
- Consistência do formato de saída: se depender de saída estruturada, estatize a taxa de falha de parsing e, se necessário, adicione validação e retentativa.
- Amostragem de custo: extraia um lote de requisições reais, estatize a distribuição de tokens de entrada e saída e estime o custo por unidade de volume de negócio.
Armadilhas comuns
- Concatenar o prompt de sistema como variável na mensagem do usuário: ao trocar de modelo ou ajustar o prompt, o diff histórico fica impossível de rastrear; recomenda-se armazenar separadamente.
- Ignorar o motivo de encerramento: quando a saída é truncada pelo limite de comprimento, o modelo pode retornar um resultado incompleto, mas a camada de negócio o trata como conteúdo normal.
- Retentativas sem limite: retentativas infinitas sob limitação de taxa amplificam a carga e também o custo.
- Testar apenas entradas curtas: bom desempenho em conversas curtas não significa que o cenário de documentos longos seja viável; o conjunto de avaliação deve cobrir entradas longas.
- Sem chave de reversão: configurações de implantação gradual fixadas no código exigem recompilar e implantar para reverter em caso de problema.
Pequeno tráfego primeiro
Primeiro valide o efeito com um pequeno conjunto interno de avaliação de tráfego e depois libere gradualmente. Na fase de avaliação, registre a saída do modelo e o uso para cada amostra, formando uma linha de base reprodutível que pode ser reutilizada diretamente ao trocar de modelo no futuro.
Quando escolhê-lo e quando não escolhê-lo
Convergir a decisão em uma comparação por cenário é mais útil do que discutir rankings de modelos.
Cenários adequados
- Tarefas de geração predominantemente textuais: completude de diálogo, redação de conteúdo, resumo e reescrita.
- Tarefas de extração e transformação que exigem saída de texto estruturado.
- Equipes que já possuem uma camada unificada de chamadas e desejam adicionar um modelo textual candidato para comparação ou distribuição de tráfego.
- Equipes sensíveis a custo e dispostas a fazer restrições de engenharia em prompts e comprimento de saída.
Cenários inadequados
- Tarefas que exigem entrada e saída multimodais como imagens e áudio; o grok-4.7 é um modelo puramente textual e não se aplica.
- Sistemas com forte dependência de capacidades exclusivas de um modelo específico e que não podem migrar no curto prazo.
- Equipes que ainda não possuem encapsulamento de chamadas e observação de uso; a integração direta só aumentará a carga de manutenção.
- Requisitos extremamente sensíveis a latência, em que os resultados de avaliação mostram latência fora do alvo.
Sequência sugerida de avanço
Primeiro confirme a adequação de capacidade, depois verifique parâmetros e limites, em seguida encapsule a camada de chamadas, execute avaliação com pequeno tráfego e, por fim, faça implantação gradual por proporção. Cada etapa tem pontos de verificação claros; se qualquer etapa não passar, pare ali em vez de forçar o lançamento.
Se a sua pilha tecnológica já possui uma camada de interface de adaptação de modelos, o custo de integração do grok-4.7 recai principalmente sobre avaliação e observação, e não sobre refatoração de código. Comece com um pequeno conjunto de avaliação de tráfego e use dados para decidir se ele merece entrar no pool de tráfego de produção.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores