
使用指南
MiniMax H3 Max 图生视频提示词:可直接复制的完整方案与真实输出
三个可直接复制的 MiniMax H3 Max 图生视频提示词,在 hiapi 上运行,每个都附有确切的输入帧以及我们用它渲染出的真实片段——一个电影感揭示镜头、一个氛围感推镜,以及一个首帧到末帧的变形,另外还附上请求结构和每秒价格。
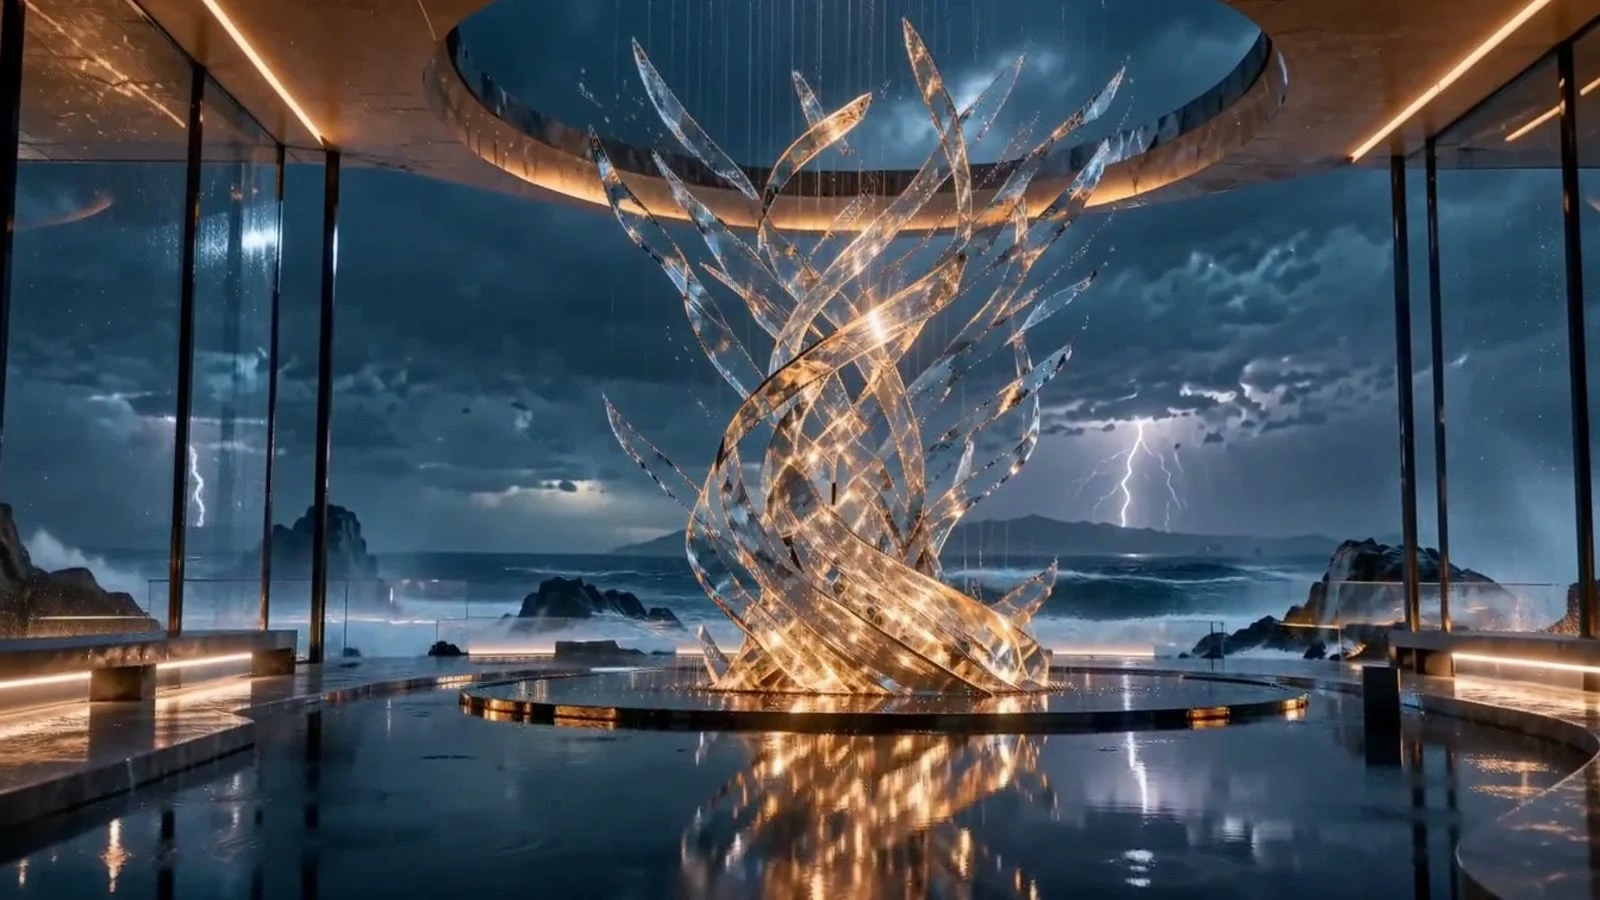
MiniMax H3 Max 是一个能把静态图像动画化为短片并同步生成环境音轨的视频模型。你给它一个结束帧,描述镜头运动、动态和想要的声音,它就会渲染出一段 5–15 秒的镜头,最终落到那一帧上。你还可以选择性地提供一个起始帧,模型会在起始和结束之间插值出一条确定性的变形动画。
本指南给出三条用于图生视频路线的可直接复制的提示词方案,每条都附有确切的输入帧、完整提示词,以及我们用它渲染出的真实片段——这里没有任何模拟内容。下面每一段提示词和图像都是我们在 hiapi 上编写并生成的,你可以直接套用其结构。
MiniMax H3 Max 图生视频的实际工作方式
它是一次异步任务调用。你向 https://api.hiapi.ai/v1/tasks 发送 POST 请求,轮询返回的 taskId 直到状态变为 success,然后从输出 URL 下载视频(该链接有时间限制,所以要立刻保存文件)。
容易让人困惑的是:在图生视频路线中,last_frame_image 是必填字段——它是片段最终落到的镜头。first_frame_image 是可选的,当你想完全控制开头到结尾时可以固定起始帧。在写提示词之前,还有几条规则值得了解:
- 帧图像决定宽高比。 当你传入帧图像时,不要再发送
aspect_ratio——API 会拒绝同时传入这两者。请把输入图像裁剪成你想要的视频形状。 resolution可选480P、768P或1080P。duration是 5 到 15 之间的整数秒。- 音频由提示词驱动。 描述环境声(“soft rain on glass, distant city hum”),模型就会添加匹配的音轨;如果不想要对白,就说 “no speech”。
一个最小请求体如下:
{
  "model": "minimax-h3-max/image-to-video",
  "input": {
    "prompt": "Slow push-in toward the sign; neon reflections ripple on wet pavement. Ambient rain, no speech.",
    "last_frame_image": "https://your-cdn.example.com/ending-frame.jpg",
    "resolution": "480P",
    "duration": 5
  }
}
当你也想控制开场镜头时,添加 "first_frame_image": "https://.../start.jpg"(方案 3)。下面其余内容都是关于如何编写 prompt,让运动、构图和声音真正读得出来。
方案 1 — 从单张主视觉帧生成电影感揭示镜头
当你有一张“杀手镜头”并想让镜头抵达它时使用这个方案。你只提供结束帧,让提示词编排通向它的运动。
输入帧(用作 last_frame_image):
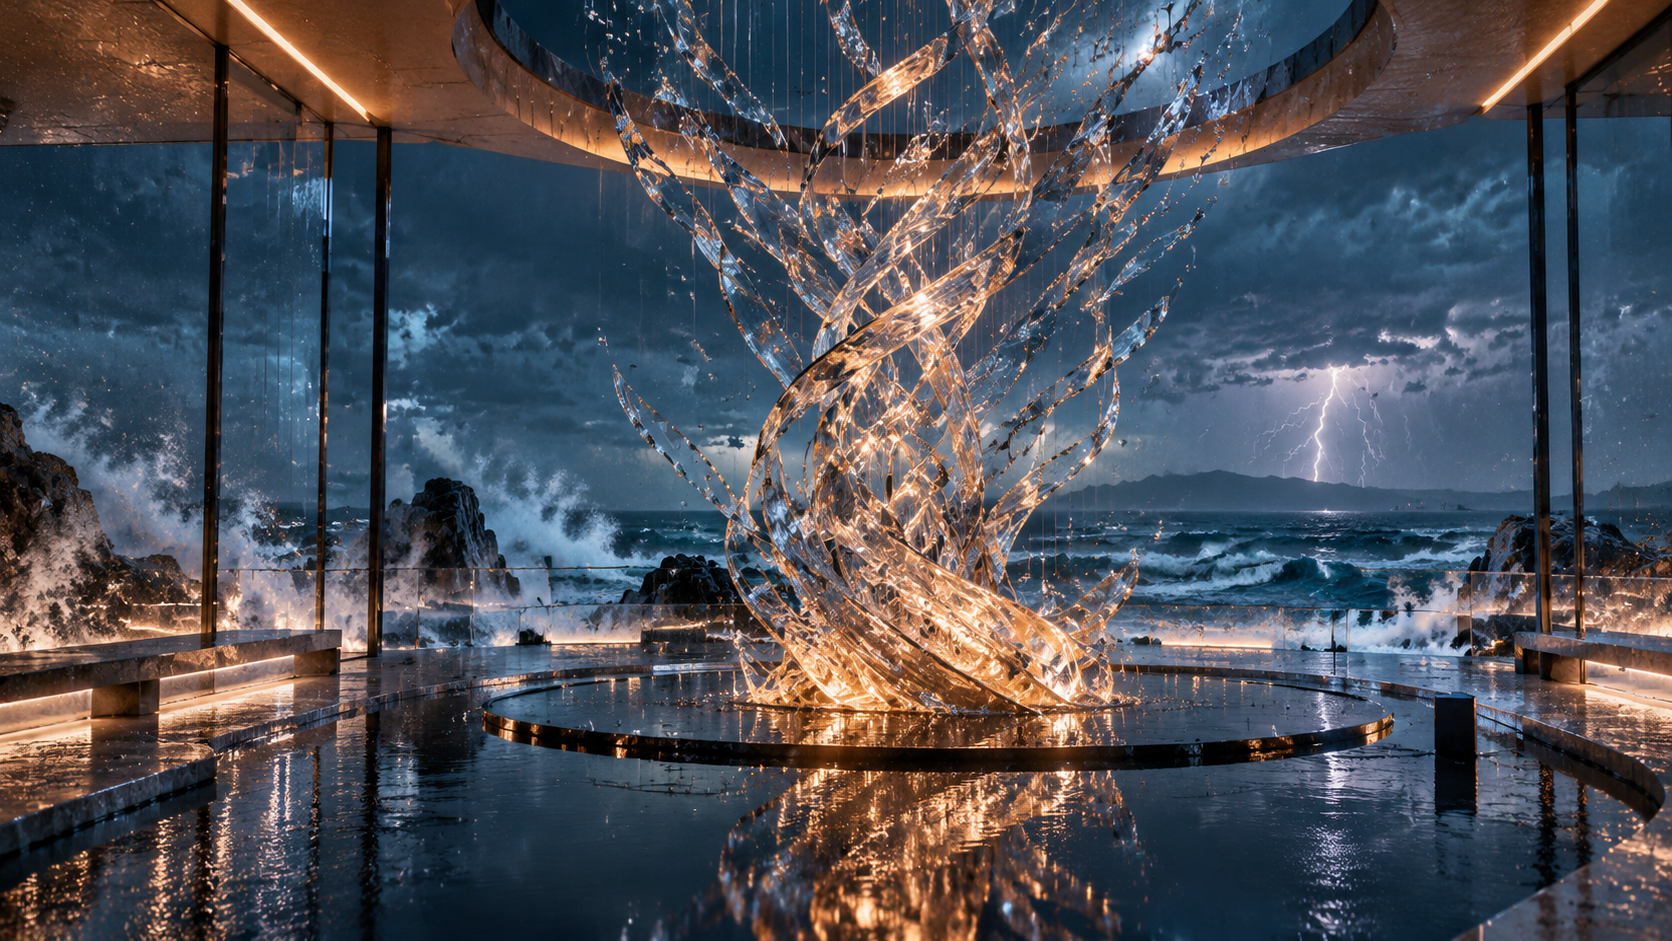
渲染片段(768P,5 秒):
提示词(可直接复制):
从低处开始,位于镜面般漆黑的水池上方几英寸,然后向前滑行并向上摇升,进入一个缓慢的宽幅环绕揭示镜头:蓝调时刻,一座玻璃展亭悬浮在暴风雨的海面上。一件动态水晶雕塑以平缓的螺旋展开,将温暖的琥珀色光线折射穿过冷青色雾气;雨水在玻璃上留下条纹,远处的闪电在地平线上闪烁。物理上准确的反射与折射,体积光,受控的自然运动,稳定的几何结构,无缝的时间一致性,高端商业质感,微妙的胶片颗粒,无人,无标志,无文字,无剪辑,无闪烁。环境声:低沉的海浪轰鸣,雨点轻打玻璃,水晶的细微共鸣,无对白。
为什么有效:
- 一句连续的镜头描述。 “从低处开始……向前滑行……向上摇升,进入一个缓慢的宽幅环绕揭示镜头”给模型一条单一、明确的路径,而不是相互竞争的运动。
- 结束帧是锚点,所以提示词只需描述通往它的旅程——雕塑可以“展开”,这正是在模型自创的起始状态与你提供的帧之间产生可见运动的原因。
- 紧凑的负面清单(“无剪辑、无闪烁、无文字”)能防止 768P 的奢华质感退化成蒙太奇。
- 以 768P 渲染,因为这是主视觉镜头;本文封面就是直接从其中截取的一帧。
方案 2 — 带环境声的氛围感推镜
日常主力方案:一个缓慢的推轨镜头,让静态场景活起来,音轨和运动同样重要。同样只需要一个结束帧。
输入帧(用作 last_frame_image):
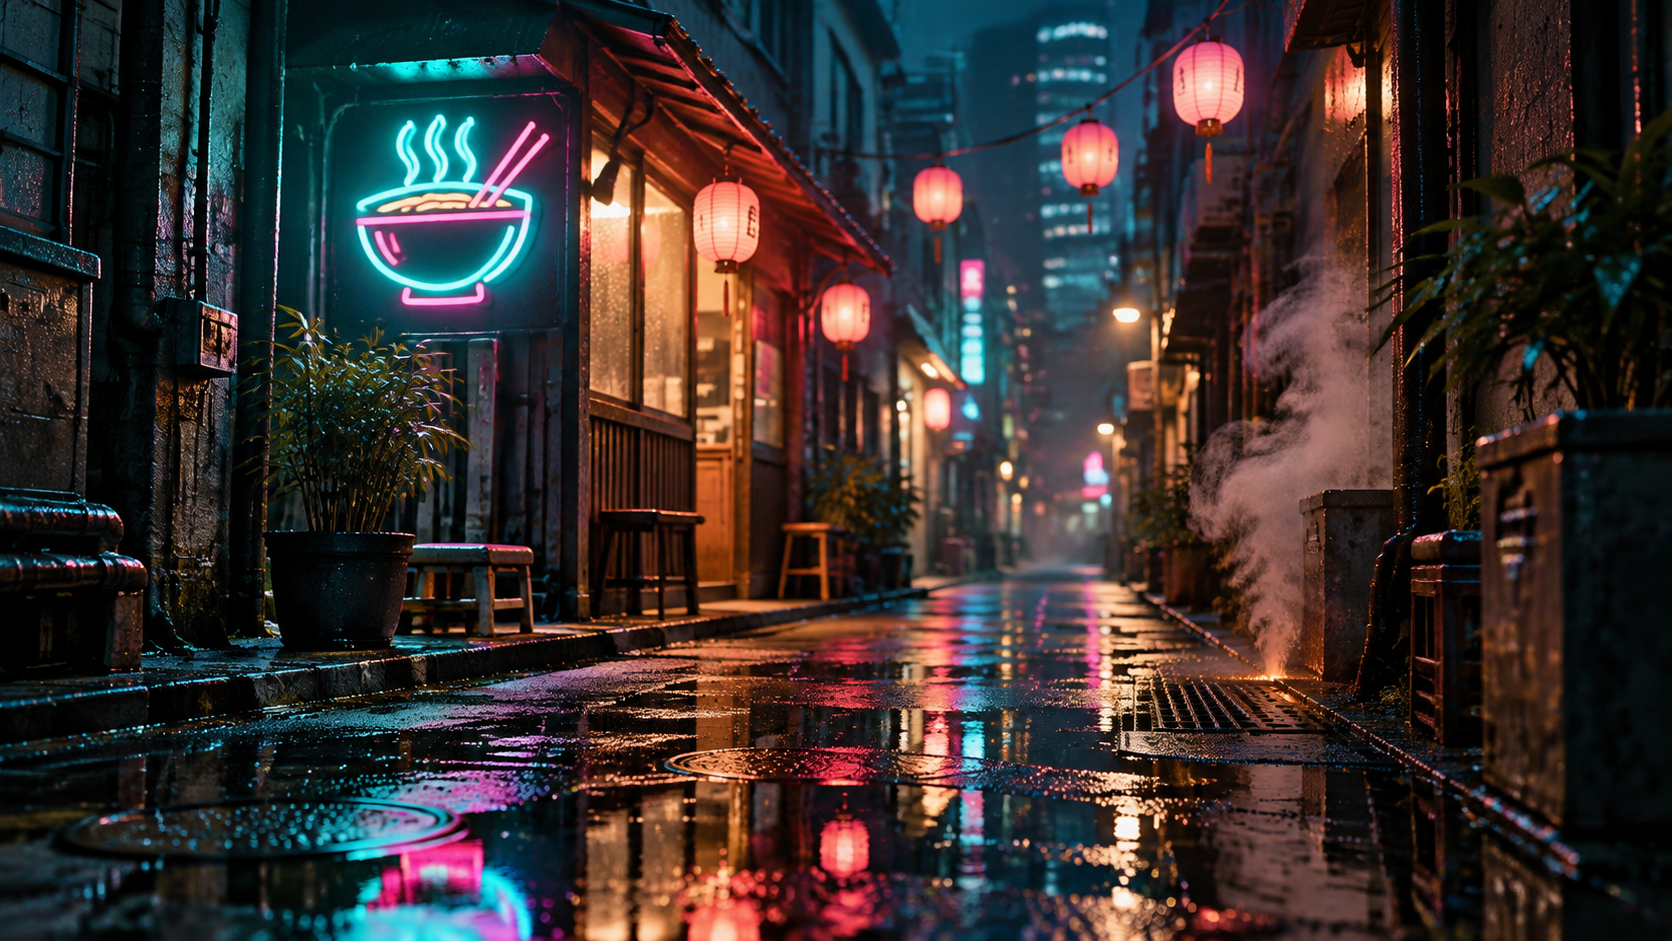
渲染片段(480P,5 秒):
提示词(可直接复制):
午夜,一个缓慢、稳定的推轨镜头沿被雨水浸透的霓虹小巷向前,脚下的水洼泛起涟漪,镜头缓缓飘向一块发着青绿色与品红色光的拉面店招牌。蒸汽从街边通风口卷起,纸灯笼轻轻摇曳,霓虹倒影在湿漉漉的路面上闪烁。电影感青橙调色,浅景深,轻微薄雾,逼真的 35mm 质感,受控的运动,稳定的几何结构,无人,无可读文字,无剪辑。环境声:稳定的雨声,远处的城市嗡鸣,隐约的蒸汽嘶嘶声,无对白。
为什么有效:
- 一个缓慢运动 + 许多微小运动。 镜头只做一件事(向前推轨),而泛起涟漪的水洼、卷起的蒸汽和摇曳的灯笼提供微观运动,在不使画面漂移的情况下营造真实感。
- 音频描述在真正发挥作用。 “稳定的雨声,远处的城市嗡鸣,隐约的蒸汽嘶嘶声”正是把湿街渲染变成一个地点的关键。这是相比图像模型最大的升级。
- 迭代时 480P 是合适的默认值——按 $0.072/秒计算,5 秒测试约 36 美分,所以你可以在决定用 768P 或 1080P 出成品之前低成本地调整措辞。
方案 3 — 首帧 + 末帧插值(标志性控制)
这正是 H3 Max 区别于“让我的照片动起来”模型的地方:给它同时提供首帧和末帧,它就会在两者之间渲染出受控的变形。非常适合需要精确开始和精确结束的前后对比变换。
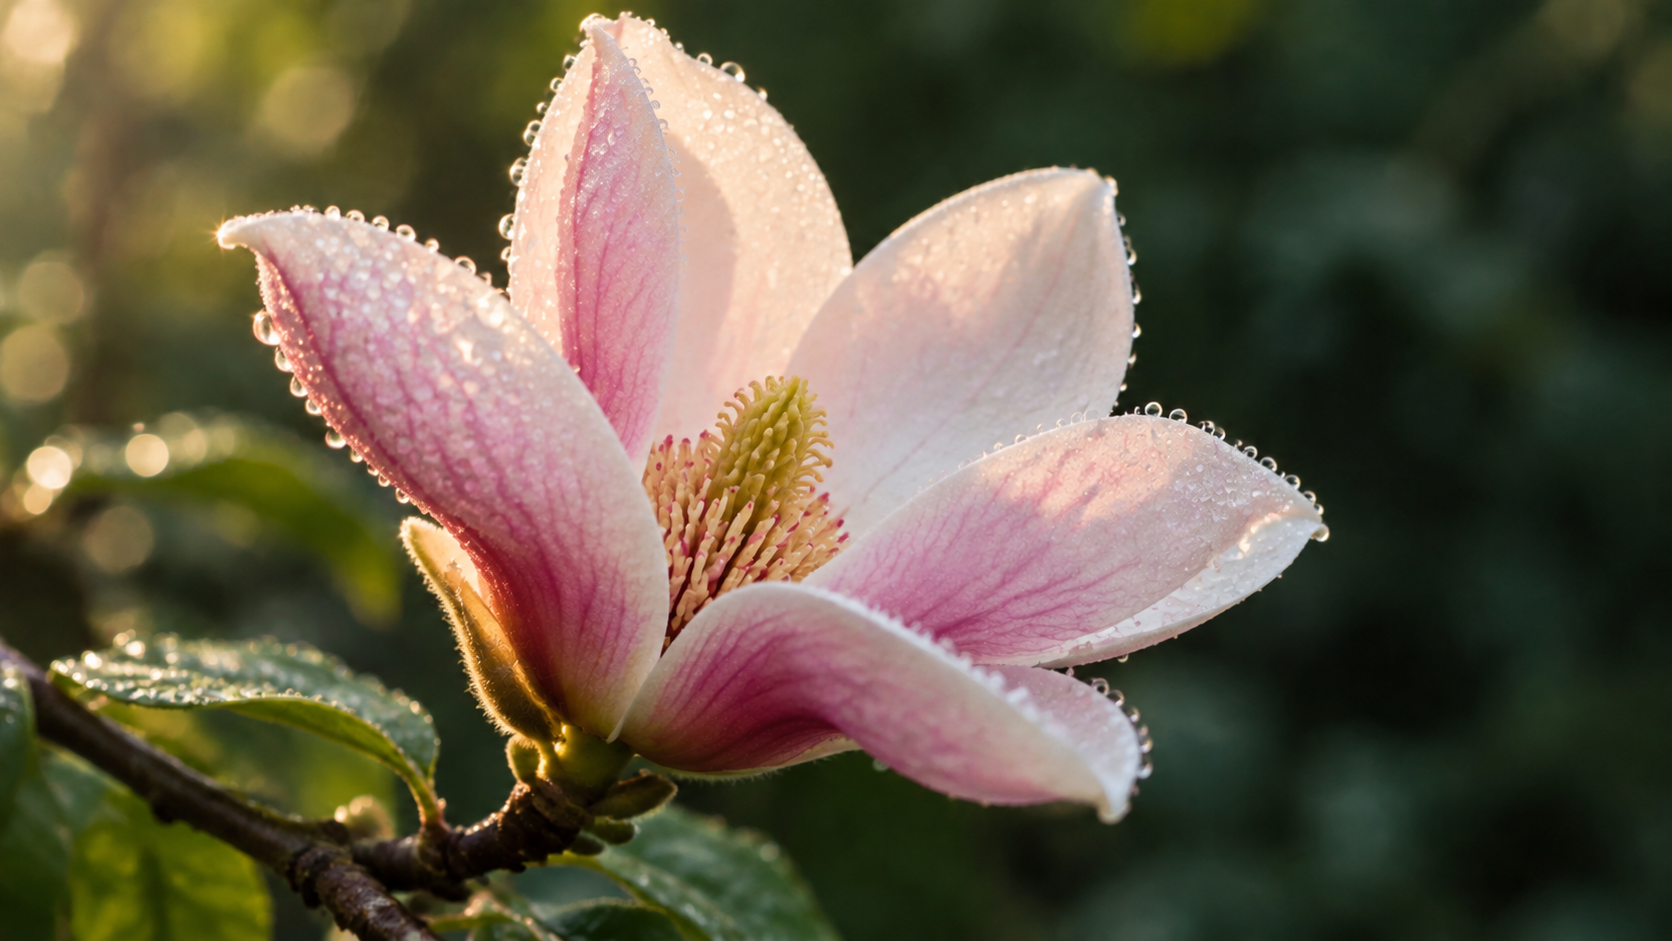
我们生成了开场帧,然后把同一帧编辑成它的“之后”状态,使构图、光线和背景保持完全一致——唯一改变的是主体。
首帧(first_frame_image)→ 末帧(last_frame_image):
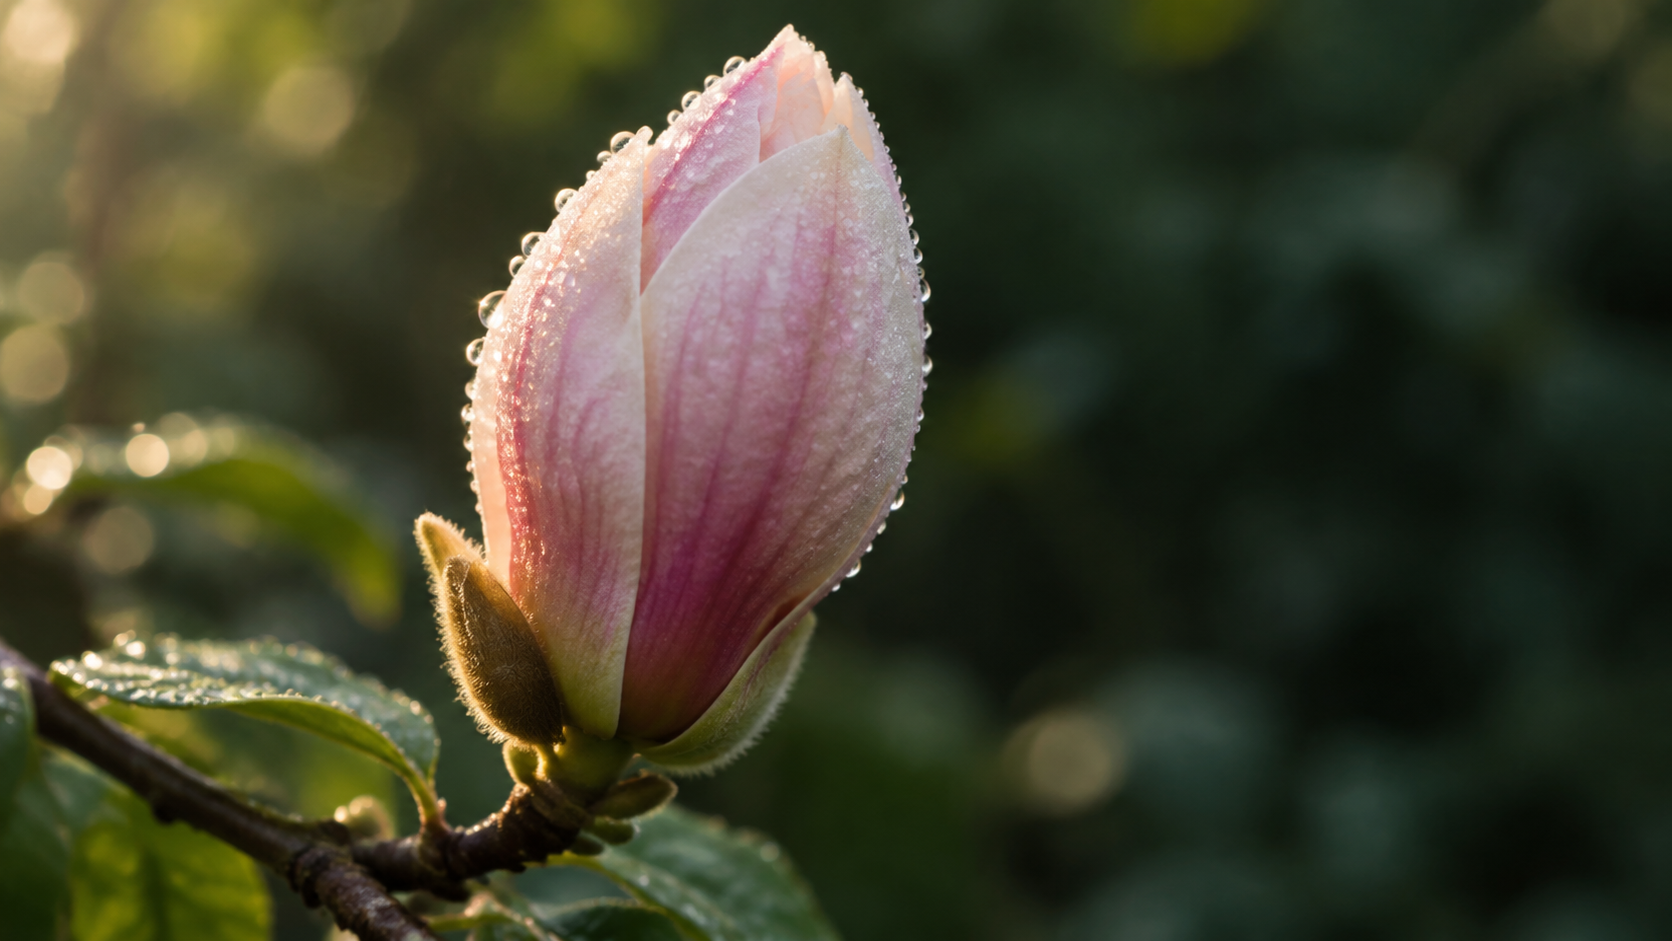
渲染片段(480P,5 秒):
提示词(可直接复制):
一朵玉兰在黎明绽放的微距延时:布满露珠的花瓣从紧致的花苞缓慢展开成完全盛开的花朵,露出淡色的花蕊中心,柔和的晨间轮廓光温暖整个场景,枝条在微风中几乎不可察觉地轻摆。全程保持相同的构图和背景,逼真的植物细节,平滑连续的运动,稳定的焦点,无人,无文字,无剪辑。环境声:柔和的黎明鸟鸣,微风穿过树叶,无对白。
为什么有效:
- 两帧 = 确定性端点。 你不必指望模型落到某个合理的位置;你已经明确告诉它从哪里开始、在哪里停止。提示词只需描述如何在两者之间行进(“缓慢展开……平滑连续的运动”)。
- 保持帧的一致性。 因为我们的末帧是首帧的编辑版(同一枝条、角度、光线),插值看起来就像一朵花在绽放,而不是两张照片之间的剪辑。不匹配的帧会产生刺眼的变形。
- “全程保持相同的构图和背景”告诉模型唯一允许改变的是花——这能防止镜头游移。
微调要点
- 写镜头,而不是写图注。 按顺序写出镜头运动、主体运动、光线和声音。图注(“一朵绽放的花”)无法给模型提供任何可动画化的内容。
- 按分辨率做预算,在 480P 下迭代。 提示词措辞很少需要高于 480P 来评估;锁定措辞后,再用 768P 或 1080P 重新渲染成品。
- 调整时保持时长为 5 秒。 更长的片段成本线性增加,也给了运动更多漂移空间。只有当运动和音频读起来正确后,才扩展到 10–15 秒。
- 不要和宽高比较劲。 在上传之前把输入帧裁剪成 16:9、9:16 或 1:1;片段会继承该形状,而在传入帧的同时发送
aspect_ratio会报错。 - 负面提示词对精致度很重要。 “无剪辑、无闪烁、无文字、无人”能可靠地去除让 AI 视频看起来像 AI 的伪影。
价格
MiniMax H3 Max 图生视频按请求的视频秒数计费,按分辨率区分(截至 2026-10):
| 分辨率 | 每秒价格 | 5 秒片段 |
|---|---|---|
| 480P | $0.072 | $0.36 |
| 768P | $0.115 | $0.575 |
| 1080P | $0.229 | $1.145 |
所以本指南中的三个片段——一个 768P 和两个 480P,都是 5 秒——合计约 $1.30 的视频成本。在批量预算前,请到 hiapi 价格页面查看实时数字;每秒费率才是会变动的数字。
常见问题
我必须同时提供两帧吗?
不需要。在图生视频路线中,last_frame_image 是必填的,first_frame_image 是可选的。仅用末帧(方案 1 和 2)适合“抵达这个镜头”,而需要受控的从头到尾变形时(方案 3)则用两帧。
支持哪些分辨率和时长?
resolution 为 480P、768P 或 1080P;duration 为 5 到 15 之间的整数秒。
它会生成声音吗? 会——在提示词中描述环境声,模型就会添加匹配的音轨。加上 “no speech” 可以保持无对白。这里的三个片段都自带环境音轨。
如何设置宽高比?
由输入帧决定。把帧裁剪成你想要的形状;不要同时发送 aspect_ratio 字段和帧图像。
我只想要文生视频,不传输入图像。 请改用 MiniMax H3 Max 文生视频路线——同样的提示词纪律,不需要帧。如果你在把 H3 Max 和其他视频 API 做比较,我们的 Seedance 2.5 与 2.0 对比会讲如何选择按秒计费的视频模型。
开始生成
拿一张主视觉帧,把它写成带有镜头运动和音频描述的镜头,然后发送到 MiniMax H3 Max 图生视频 API。从 480P 开始调整措辞,然后用更高分辨率重新渲染你的成品。完整的请求和轮询详情见 hiapi 文档。


